-
做数字人形象不用录视频了,一张自拍就行。语音合成参数改到生成时微调、任务调度补上兜底,也都在这一版里。
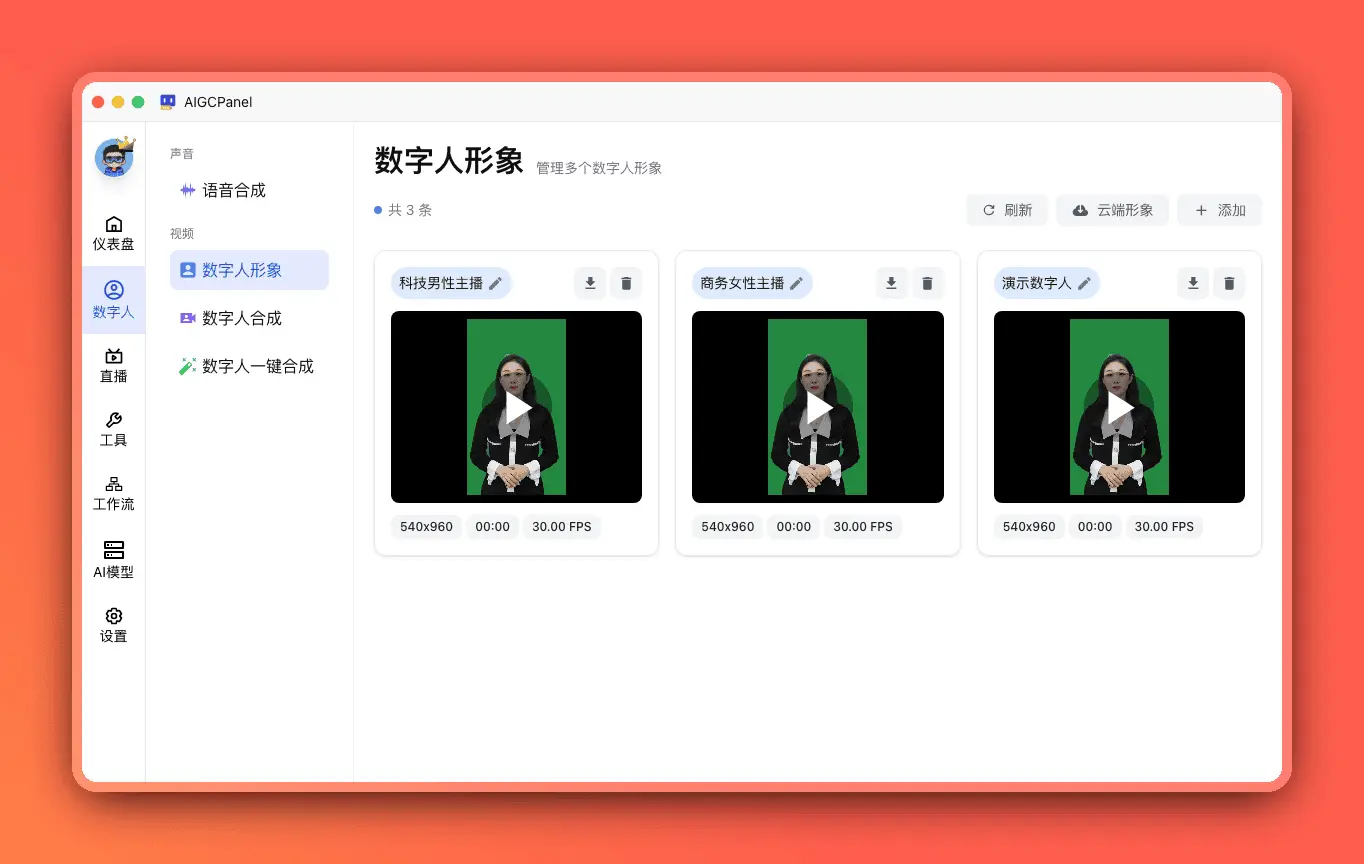
📷 一张照片,就是一个数字人形象
-
过去建形象要录一段 10 到 30 秒的视频: 全程正脸、光线稳定、表情别太夸张。不少人卡在第一步。现在弹窗里切到「图片形象」,传一张高清正脸自拍就能继续。
-
先说清楚边界: 照片要求和过去录视频的要求本质相同,正面、清晰、五官无遮挡的成功率最高;侧脸、逆光、多人入镜的图会失败,弹窗里给了正脸自拍、可张口闭口、面部有干扰三组示例对照。第 4 条要求写得直白:「图片会自动生成 5 秒视频用于口型合成」。也就是说,降的是拍摄成本,不是物理规律。
-
技术上的做法一句话能说完: 把静态照片转成 5 秒标准视频片段,再走原来那条跑熟了的合成管线,模型侧不用改。
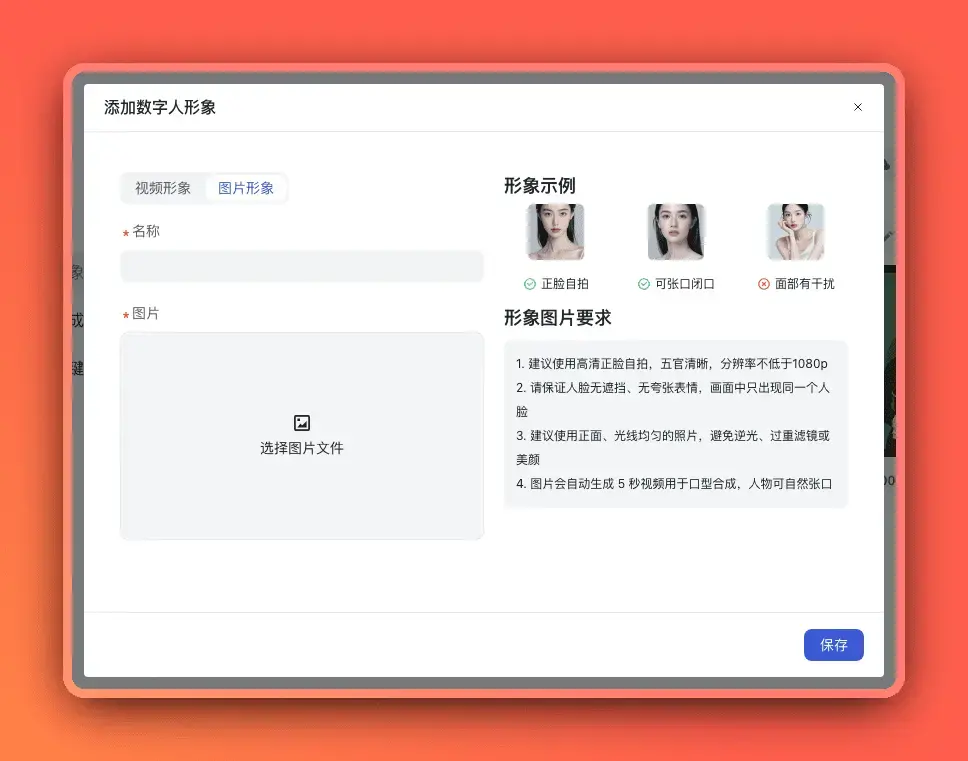
录视频的门槛没了,素材就看你相册里有哪张。
🎚️ 参数留给这一次,音色留给长期
-
以前想给某句话换个语速,只能去音色管理里编辑音色本身,改完之后其他任务也跟着变。v2.6.0 把这两件事拆开了:选完音色,旁边多了「调整参数」按钮,点开是按次生效的面板,语速、音量、音调随手改,音色和它绑定的模型不动。默认值就是音色的存档参数,不改就和原来完全一样。
-
对实现感兴趣的可以记一笔: 参数定义和存档值都是异步取回的,回填要等表单挂载完成之后才写入,否则面板会闪一下空值。
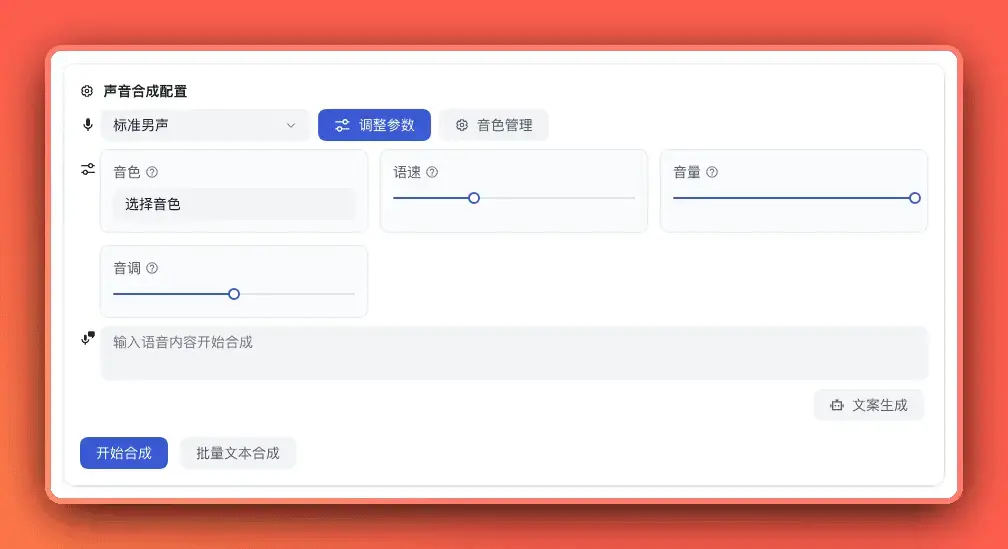
参数属于这一次合成,音色属于长期积累。
🔧 调度链断了会自己接上
-
「提交后一直排队中」是个老毛病。根因在调度链: 驱动队列的那条链子一旦因异常中断,队列里的任务就永远没人拾取。v2.5.0 把调度改成单链轮询后更稳了,但风险也集中到一处,这一版补齐了兜底:调度每轮自查,断了就重新拉起,中断任务重新入队;任务入库后若调度失败(如任务类型未注册),立即标记失败并写明原因,不再干等。
-
配套的体验修复有三个: 失败任务卡片补上了重试按钮(多步骤任务保留已成功步骤续跑,单步任务整体重来);本地声音文件被删或移动的场景,提交前就校验路径,不再先进队列再报「文件不存在」;升级时旧的「声音克隆」音色库自动迁移为「语音音色」,参考音频和文本原样保留,找不到音色的老用户无需重新录入。
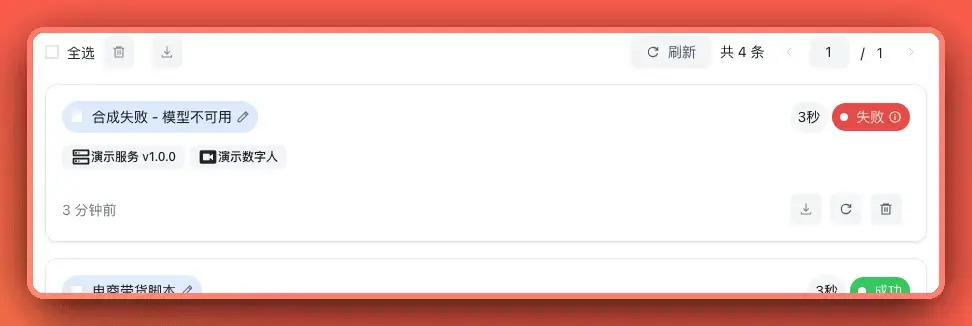
队列不怕断,怕的是断了没人接。这版把接力棒交回了调度器。
🩺 白屏和卡死,有现场记录可查了
-
偶发白屏、界面卡死,过去只能靠用户回忆「当时点了什么」。新版内置运行时诊断日志:渲染进程崩溃、界面无响应、GPU 子进程崩溃都会记录在案,外加每 5 分钟一次的内存快照。下次再有人报「打开就白屏」,翻日志定位,不用猜。
其他更新
-
「声音克隆」正式更名为「声音复刻」,界面与文档同步改名,老用户看到新词不要找不到北
-
文件下载接口
POST /api/file/download:Bearer Token 校验,路径白名单限定在数据目录与已安装模型目录内,跨局域网调用方可取回结果文件 -
修复声音复刻参考音频被降采样重编码导致音质变差的问题:原文件直接保存,录音与裁剪按原始采样率编码
-
修复编辑音色时「声音复刻」类型参数不显示、不回填的问题
-
修复简易接入模型把
functions定义在 config.json 顶层时读取为空的问题 -
Windows 应用图标逻辑优化
版本回顾
-
近期三个版本各有侧重,新读者可以快速对齐进度:
-
云端语音模型接入(v2.5.0):AI 模型页填个 API Key 就能接火山引擎豆包、阿里云百炼,本地没显卡也能跑语音合成
-
绿幕换背景与歌曲翻唱(v2.4.0):上传绿幕视频加背景图片完成抠像替换,也能把歌曲人声换成指定音色
-
API 服务上线(v2.3.0):本地 HTTP 服务提供文件上传与模型参数查询,可以把 AIGCPanel 接进自己的自动化流水线
近期版本回顾 -
v2.5.0 — 云端语音模型接入,直播控制与音色管理升级
-
v2.4.0 — 绿幕视频替换背景、歌曲翻唱上线,任务调度更稳更快
-
v2.3.0 — API 服务与接口正式上线,全工具多语言支持全覆盖
升级后先试「添加数字人形象 → 图片形象」,翻张自拍传上去看效果。你打算拿哪张照片做数字人?评论区晒出来。工具把复杂留给自己,创意才轮得到你。