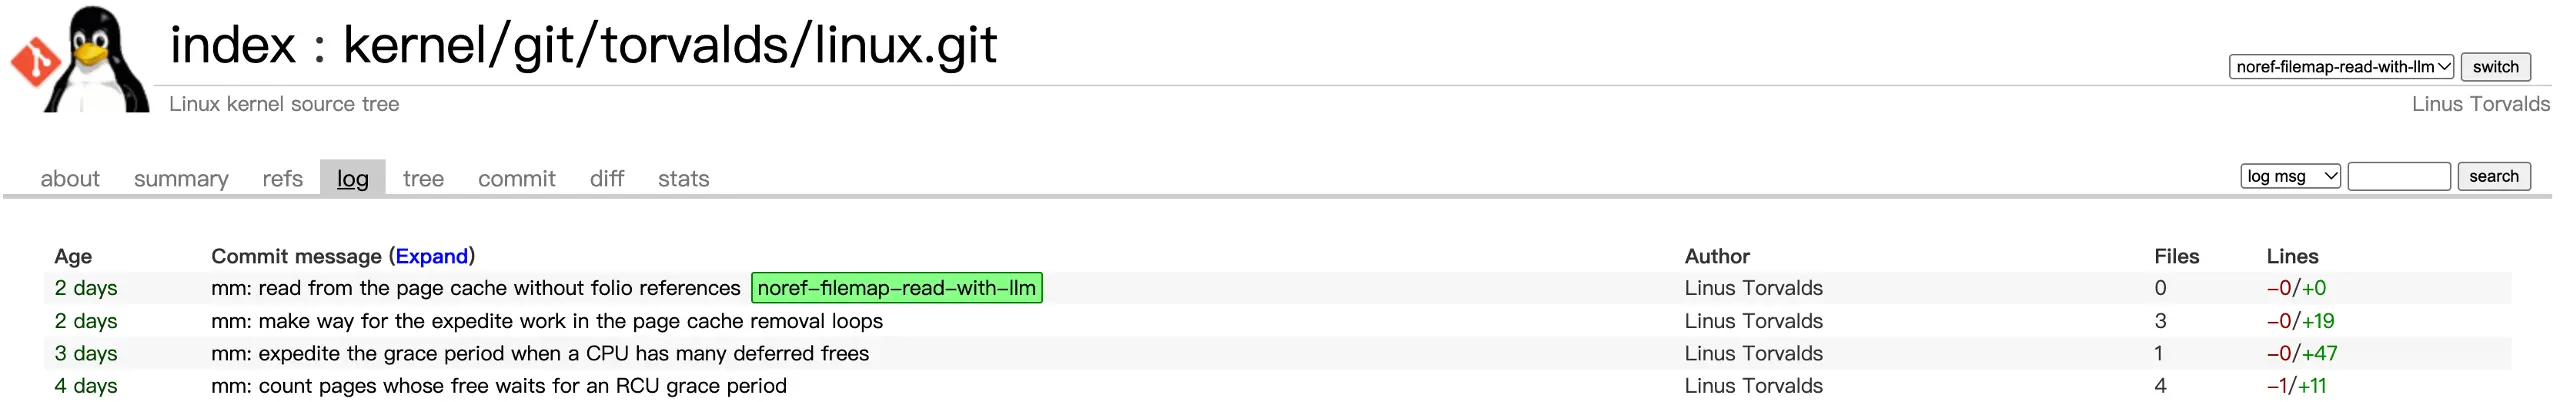
Linus Torvalds 在自己 Linux 仓库里推了一个叫 noref-filemap-read-with-llm 的分支,后缀不是开玩笑。Torvalds 表示:『代码、测试程序、上面清单背后的审阅和这封信的初稿,都由一个 LLM 编程助手(Claude Code)在我的指导下完成。测试是在我自己的机器上跑的。』
这个分支不只是一次 AI 写代码的表演,它对着的是一个真实的扩展性问题:很多线程同时小读同一个文件时,page cache 每次都要对承载该页的 folio 做一次原子引用计数增减,两次原子写落在同一 struct page 的缓存行上,导致缓存行在核间反复弹跳(cache line bouncing)。这个问题 2024 年由 Matthew Wilcox 从客户工作负载中提出。在 Torvalds 那台 Core i7-8565U 笔记本上,8 个线程对同一页做 16 字节 pread,这一条缓存行占到了跨核 load HITM 的 99.92%。
早前尝试的做法是不持引用就把数据拷贝进栈缓冲、事后校验,但卡在那些校验看不到的竞争上——比如一页被释放后又插回同一索引。Torvalds 反着来:不是去检测这些竞争,而是把竞争整个移除。folio 离开 page cache 后要等一个 RCU grace period 才还给页分配器,让 RCU 读侧临界区里的读者可以直接从页拷进用户缓冲——无引用、无弹跳缓冲、读大小不限。八个补丁里有两个做了安全阀:单个 CPU 排队等待释放的页超过 1024 个就强制跑一次 expedited grace period,避免内存无限堆积。

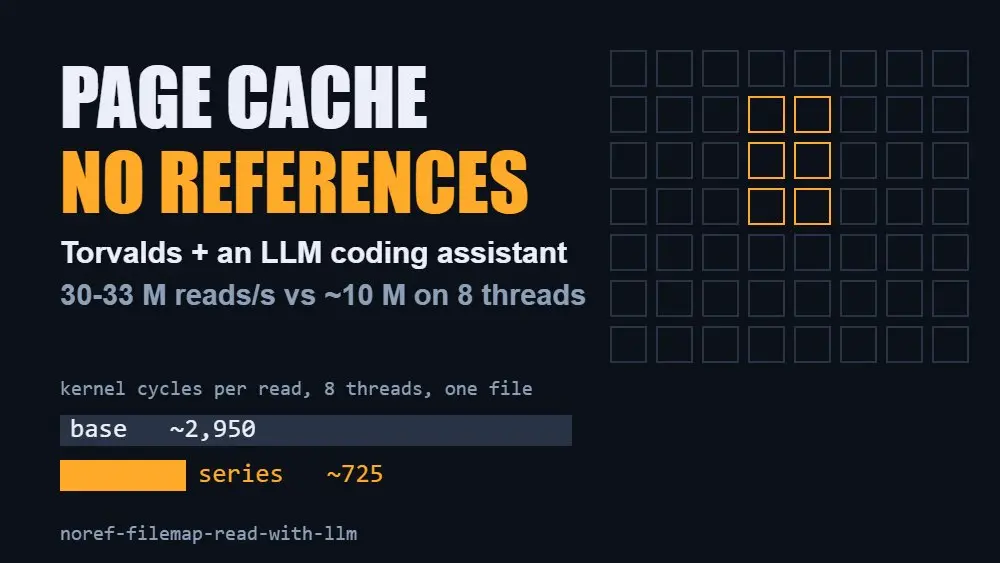
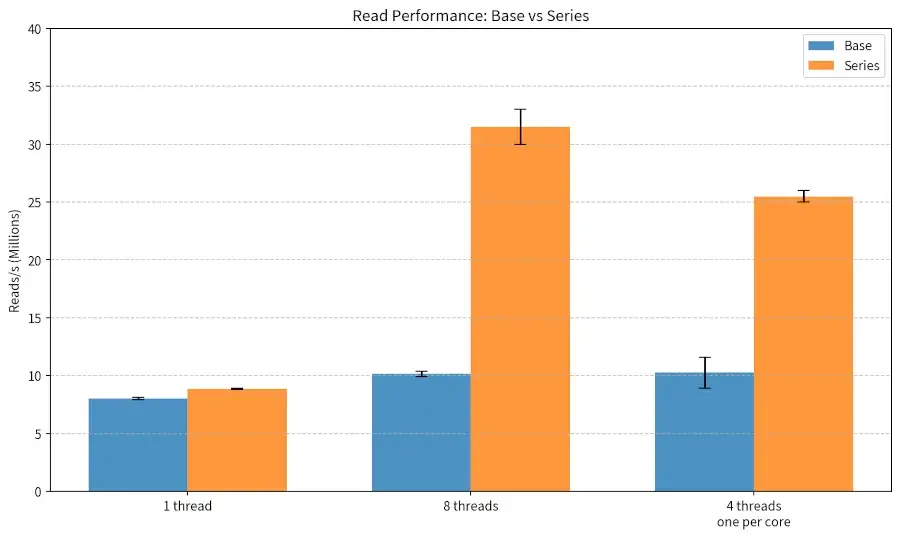
数据全部来自那台禁用了缓解措施的 4 核 8 线程笔记本。8 线程读同一文件:每读内核周期从约 2950 掉到约 725,吞吐从每秒 990 万–1040 万次涨到 3000 万–3300 万次,整整三倍。单线程每读从 452–454 周期降到 408–409,便宜约 10%。perf c2c 测得的负载 HITM 从 30,538 掉到 101。代价也存在:读取一个尚未映射的用户页时多一次失败的异常再回退旧路径,16 字节单线程读从约 4150 周期涨到 6550。2 GiB VM 压力测试里,只有六补丁的版本会在 4/8 CPU 上触发 OOM killer,完整系列则在 1/2/4/8 CPU 上都跑完。
这不是 Torvalds 第一次用 AI 做内核调试,但让一个智能体以『内存管理系列』的名义进自己主树,姿态比过去明显靠前。他 2024 年 10 月还说过 90% 的 AI 话都是营销炒作;2026 年 7 月 15 日却在内核邮件列表公开捍卫 AI 工具,来源是批评者该闭嘴或者『做开源该做的事,fork 它,或者直接走人』。催化因素之一是 Google 三月开源的 AI 代码审查系统 Sashiko,测试中据说抓了约 53% 的 bug。但他对 AI 的下半场态度依然分明——2026 年 5 月他抱怨 AI 生成的 bug 报告把内核安全邮件列表搞得『几乎无法管理』。他自己划了一条线:他指挥工具、拿真机测量验证结果、把名字签在成果上;这和一条没人要的 AI 模糊 CVE 报告是两回事。
这系列还没合入,堆在 7.3-rc6 之上,只在一台笔记本上测过,Torvalds 也如实标注了设计里他拿不准的部分。他预计大机器和多插槽会获益更多,但也承认还没测过更大的。最终能否落地取决于内存管理维护者的态度,以及有没有多核服务器用户愿意把他的数字重跑一遍。真正值得注意的或许不是三倍吞吐,而是这段话出现在 cover letter 里这件事本身。
来源: