POSETTE 2026 上,ClickHouse 产品负责人 Sai Srirampur 发表了主题为‹Postgres Isn't Slow. Your Storage Is.›的演讲——Postgres 不慢,是你的存储慢。为了证明这一点,他跑了组对比:同一份 PostgreSQL 负载,放在本地 NVMe 和 EBS 上各跑一遍,NVMe 拿到 16,030 TPS,EBS 只有 1,734 TPS,9.24 倍的差距,事务延迟中位数从 36.9 毫秒掉到 4.0 毫秒。这不是 Postgres 引擎在 EBS 上干了更多活,而是它把时间都耗在等存储上了。
演讲先铺了五个规模上来常见的症状:大量 UPDATE/UPSERT 的摄入管线从几秒拖到几分钟;大多数查询快但少数慢,P95 延迟从毫秒级变成秒级;autovacuum 跟不上,表膨胀积累到 TB 级;checkpoint 变慢还和业务抢 I/O、抢 CPU;逻辑复制把数据流到 Kafka、ClickHouse 时 WAL 解码卡顿、replication slot 越来越深。五个症状看上去各自独立,实际可能是同一个根因:当工作集超出数据库内存和 OS 页缓存,越来越多的读要落物理 I/O,而堆写入、WAL 同步、checkpoint、VACUUM、逻辑解码溢出全都抢同一份存储预算,带宽、IOPS、队列容量一撞限,操作就开始互相耽搁。
基准实验本身做到了只把存储当变量。八套完全一致的 PostgreSQL 集群,四套用实例本地 NVMe、四套用 baseline gp3 EBS(3000 IOPS),跑在 m6id.4xlarge(16 vCPU、64 GiB 内存、16 GiB shared_buffers)上,多实例互相归一化跑分波动。数据集是 482 GiB、33 亿行的 pgbench_accounts 堆表,两边跑同样的高并发随机 UPDATE,5 分钟、64 个客户端、16 个工作线程。
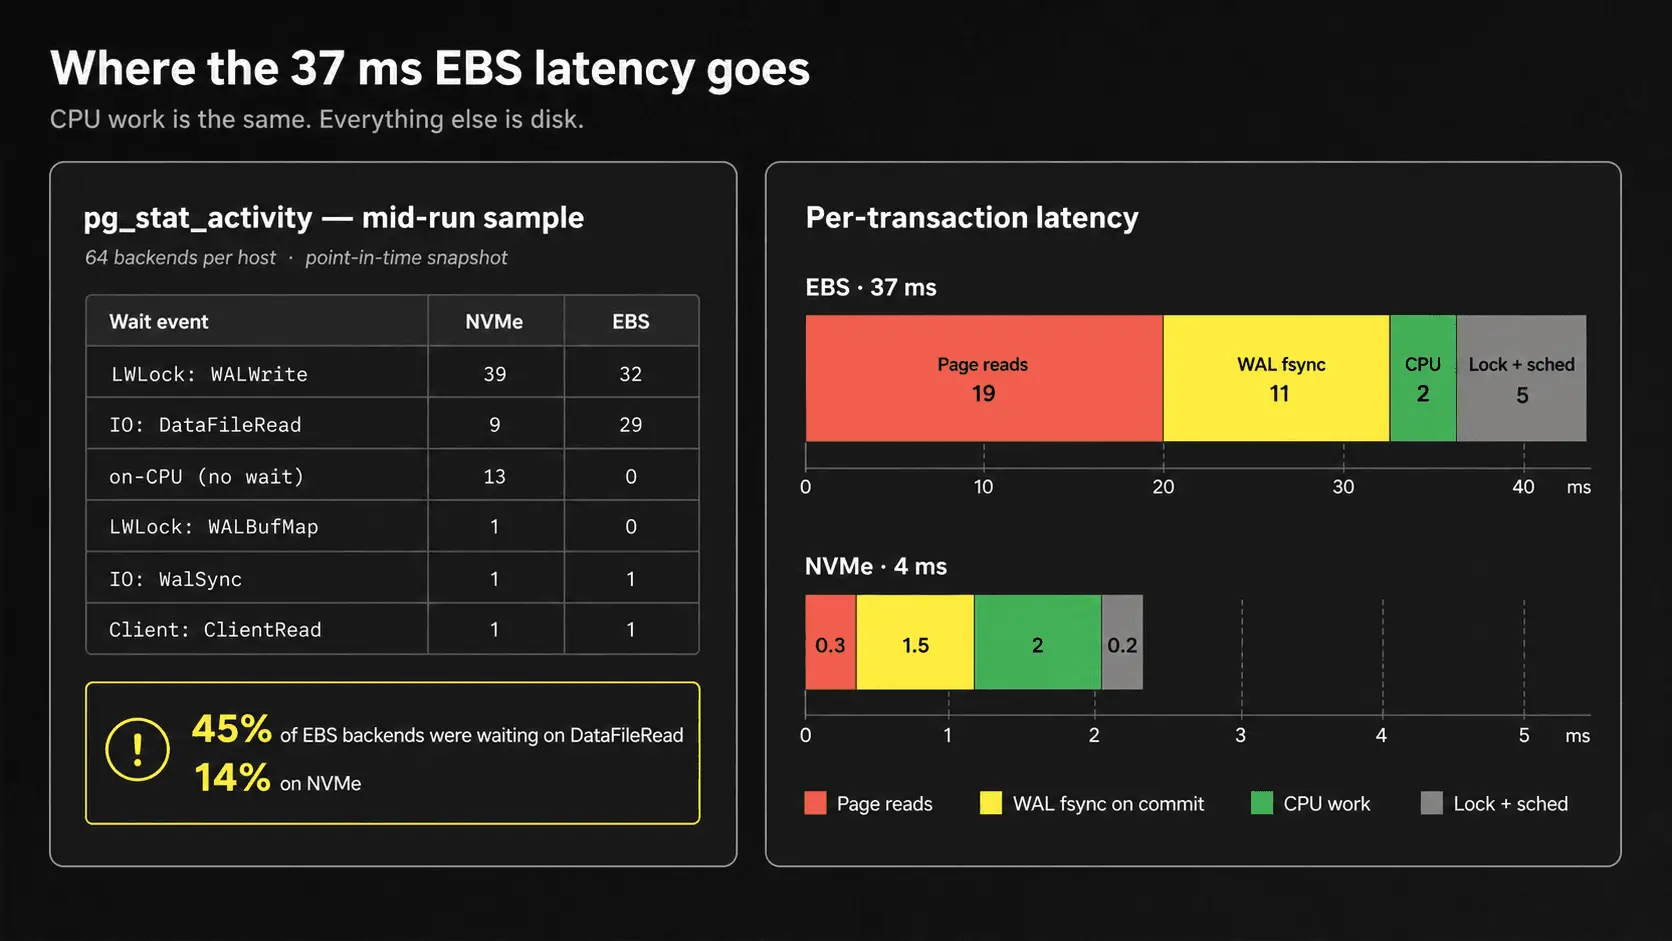
把 37 毫秒的 EBS 事务延迟拆开看,钱花在哪一目了然。页读取 EBS 约 19 毫秒、NVMe 只有 0.3 毫秒;提交时 WAL fsync 分别是 11 毫秒和 1.5 毫秒;锁和调度开销约 5 毫秒对 0.2 毫秒;而纯粹的 CPU 工作两边都只有约 2 毫秒。也就是说,EBS 多出来的延迟几乎全在等存储,Postgres 自己并没有多算。中途一次的 pg_stat_activity 快照更直观:64 个后端里 EBS 有 29 个卡在 IO:DataFileRead(约 45%),NVMe 只有 9 个(14%)。
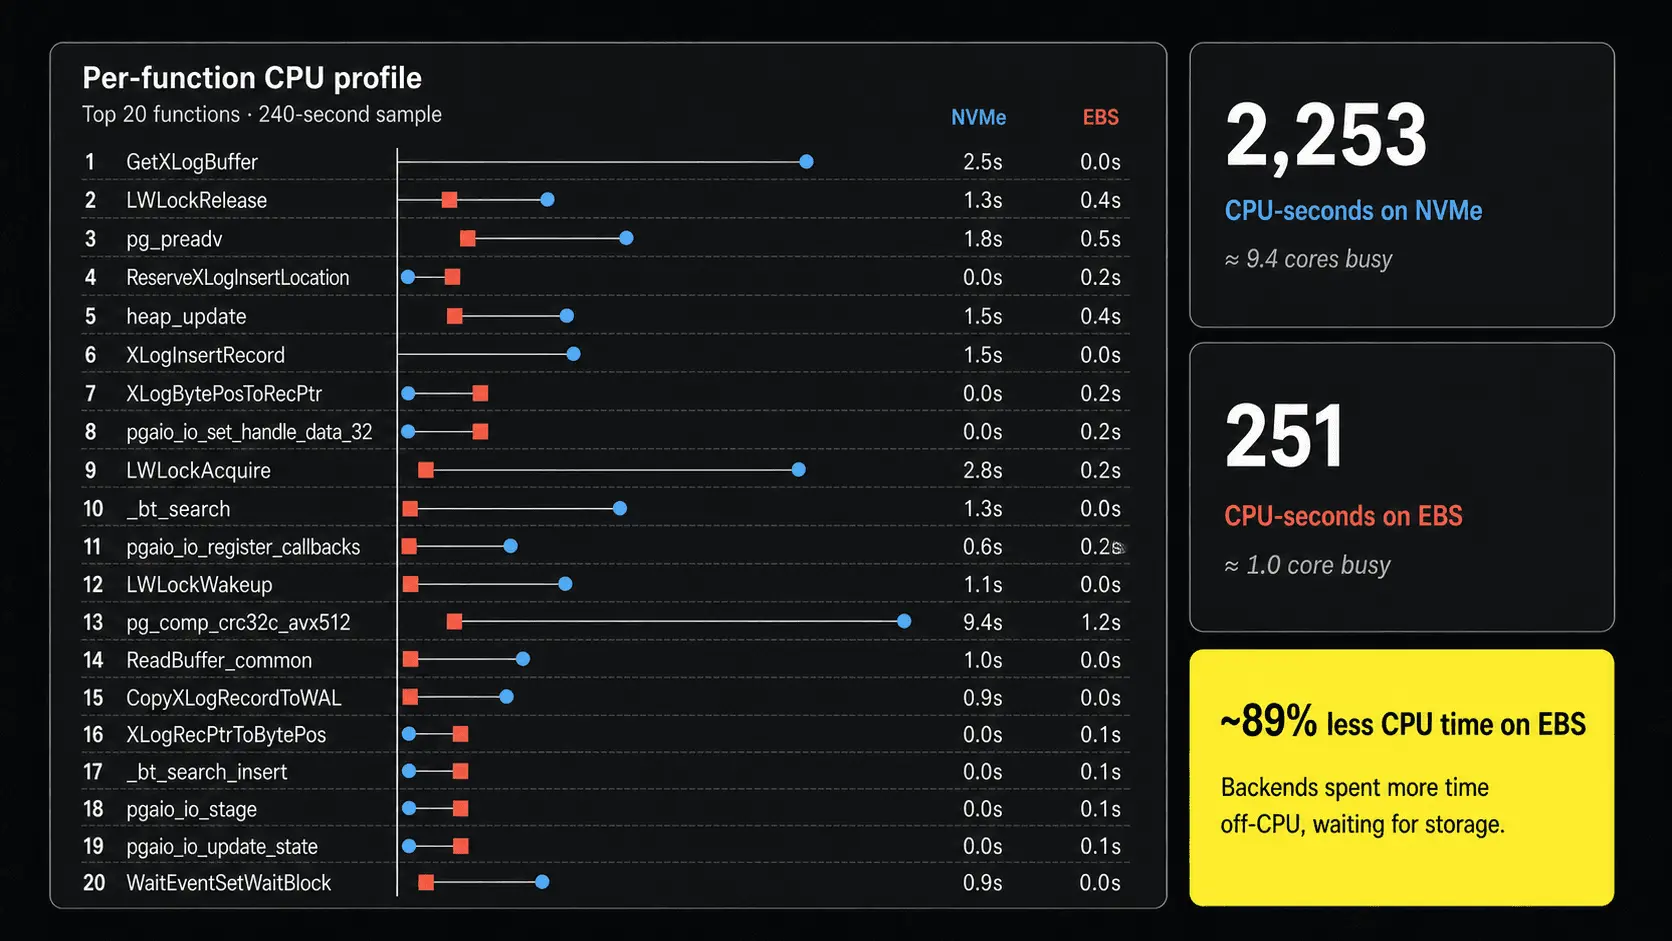
CPU profile 还给出一个反直觉的发现:约 240 秒的采样窗口里,NVMe 主机累计 2,253 CPU-秒(约 9.4 个核忙),EBS 主机只有 251 CPU-秒(约 1 个核忙)——EBS 上那些进程不是不干活,是大量时间在 off-CPU 等存储,核都闲在那儿。
数字之外,VACUUM 和复制排障也有对比:清 10 GB 膨胀,NVMe 366 秒、EBS 964 秒;排 10 GB 逻辑复制积压,NVMe 139 秒、EBS 238 秒。演讲也给了限定条件:EBS 侧是 3000 IOPS 的 baseline gp3,换个 EBS 配置结果大概率不同。
本地 NVMe 的真正代价是耐久性:实例存储和机器同生共死,节点没了本地的数据也跟着没,EBS API 还无法对它做快照。演讲给出的答案是放弃单节点耐久,把耐用性做到集群层——quorum 同步复制配两个 standby,ANY 1 配置下任一 standby 确认 WAL 即可提交,跨可用区摆放防 AZ 故障;同时用 WAL-G 这类开源工具做物理基础备份 + 持续 WAL 归档到对象存储,秒级 RPO、支持按时间点恢复,备份和 WAL 还要放独立故障域、必要时再加跨区域副本。standby 保快速故障切换,备份防损坏、误操作和集群级灾难。这套模式不是纸上谈兵:演讲举了 Instacart 在 NVMe 上跑延迟敏感搜索负载、Datadog 用本地 NVMe 实例跑需要它的工作负载作为公开先例。
来源: