在很多人的印象里,大模型接入数据库(Data Agent / Text-to-SQL)往往等同于企业级只读 ChatBI:在电脑前问一句“上个月华东区销售额是多少”,模型生成一条 SELECT 查询,吐出一个图表。
但如果数据库接入方式本身支持受控的写操作(CRUD)与业务语义沉淀,Agent 的能力边界会被彻底打开——它不再只是被动的查数工具,而是可以直接演进为一个具备持久化存储、按需交付的业务轻应用。
今年国庆假期(10.01 – 10.06),我做了一次尝试:利用自己开发的开源数据库语义网关 DatI (Data Intelligence),给 Agent 挂接了一个专属的 MySQL 数据库,做了一个“伴侣日记”轻应用。
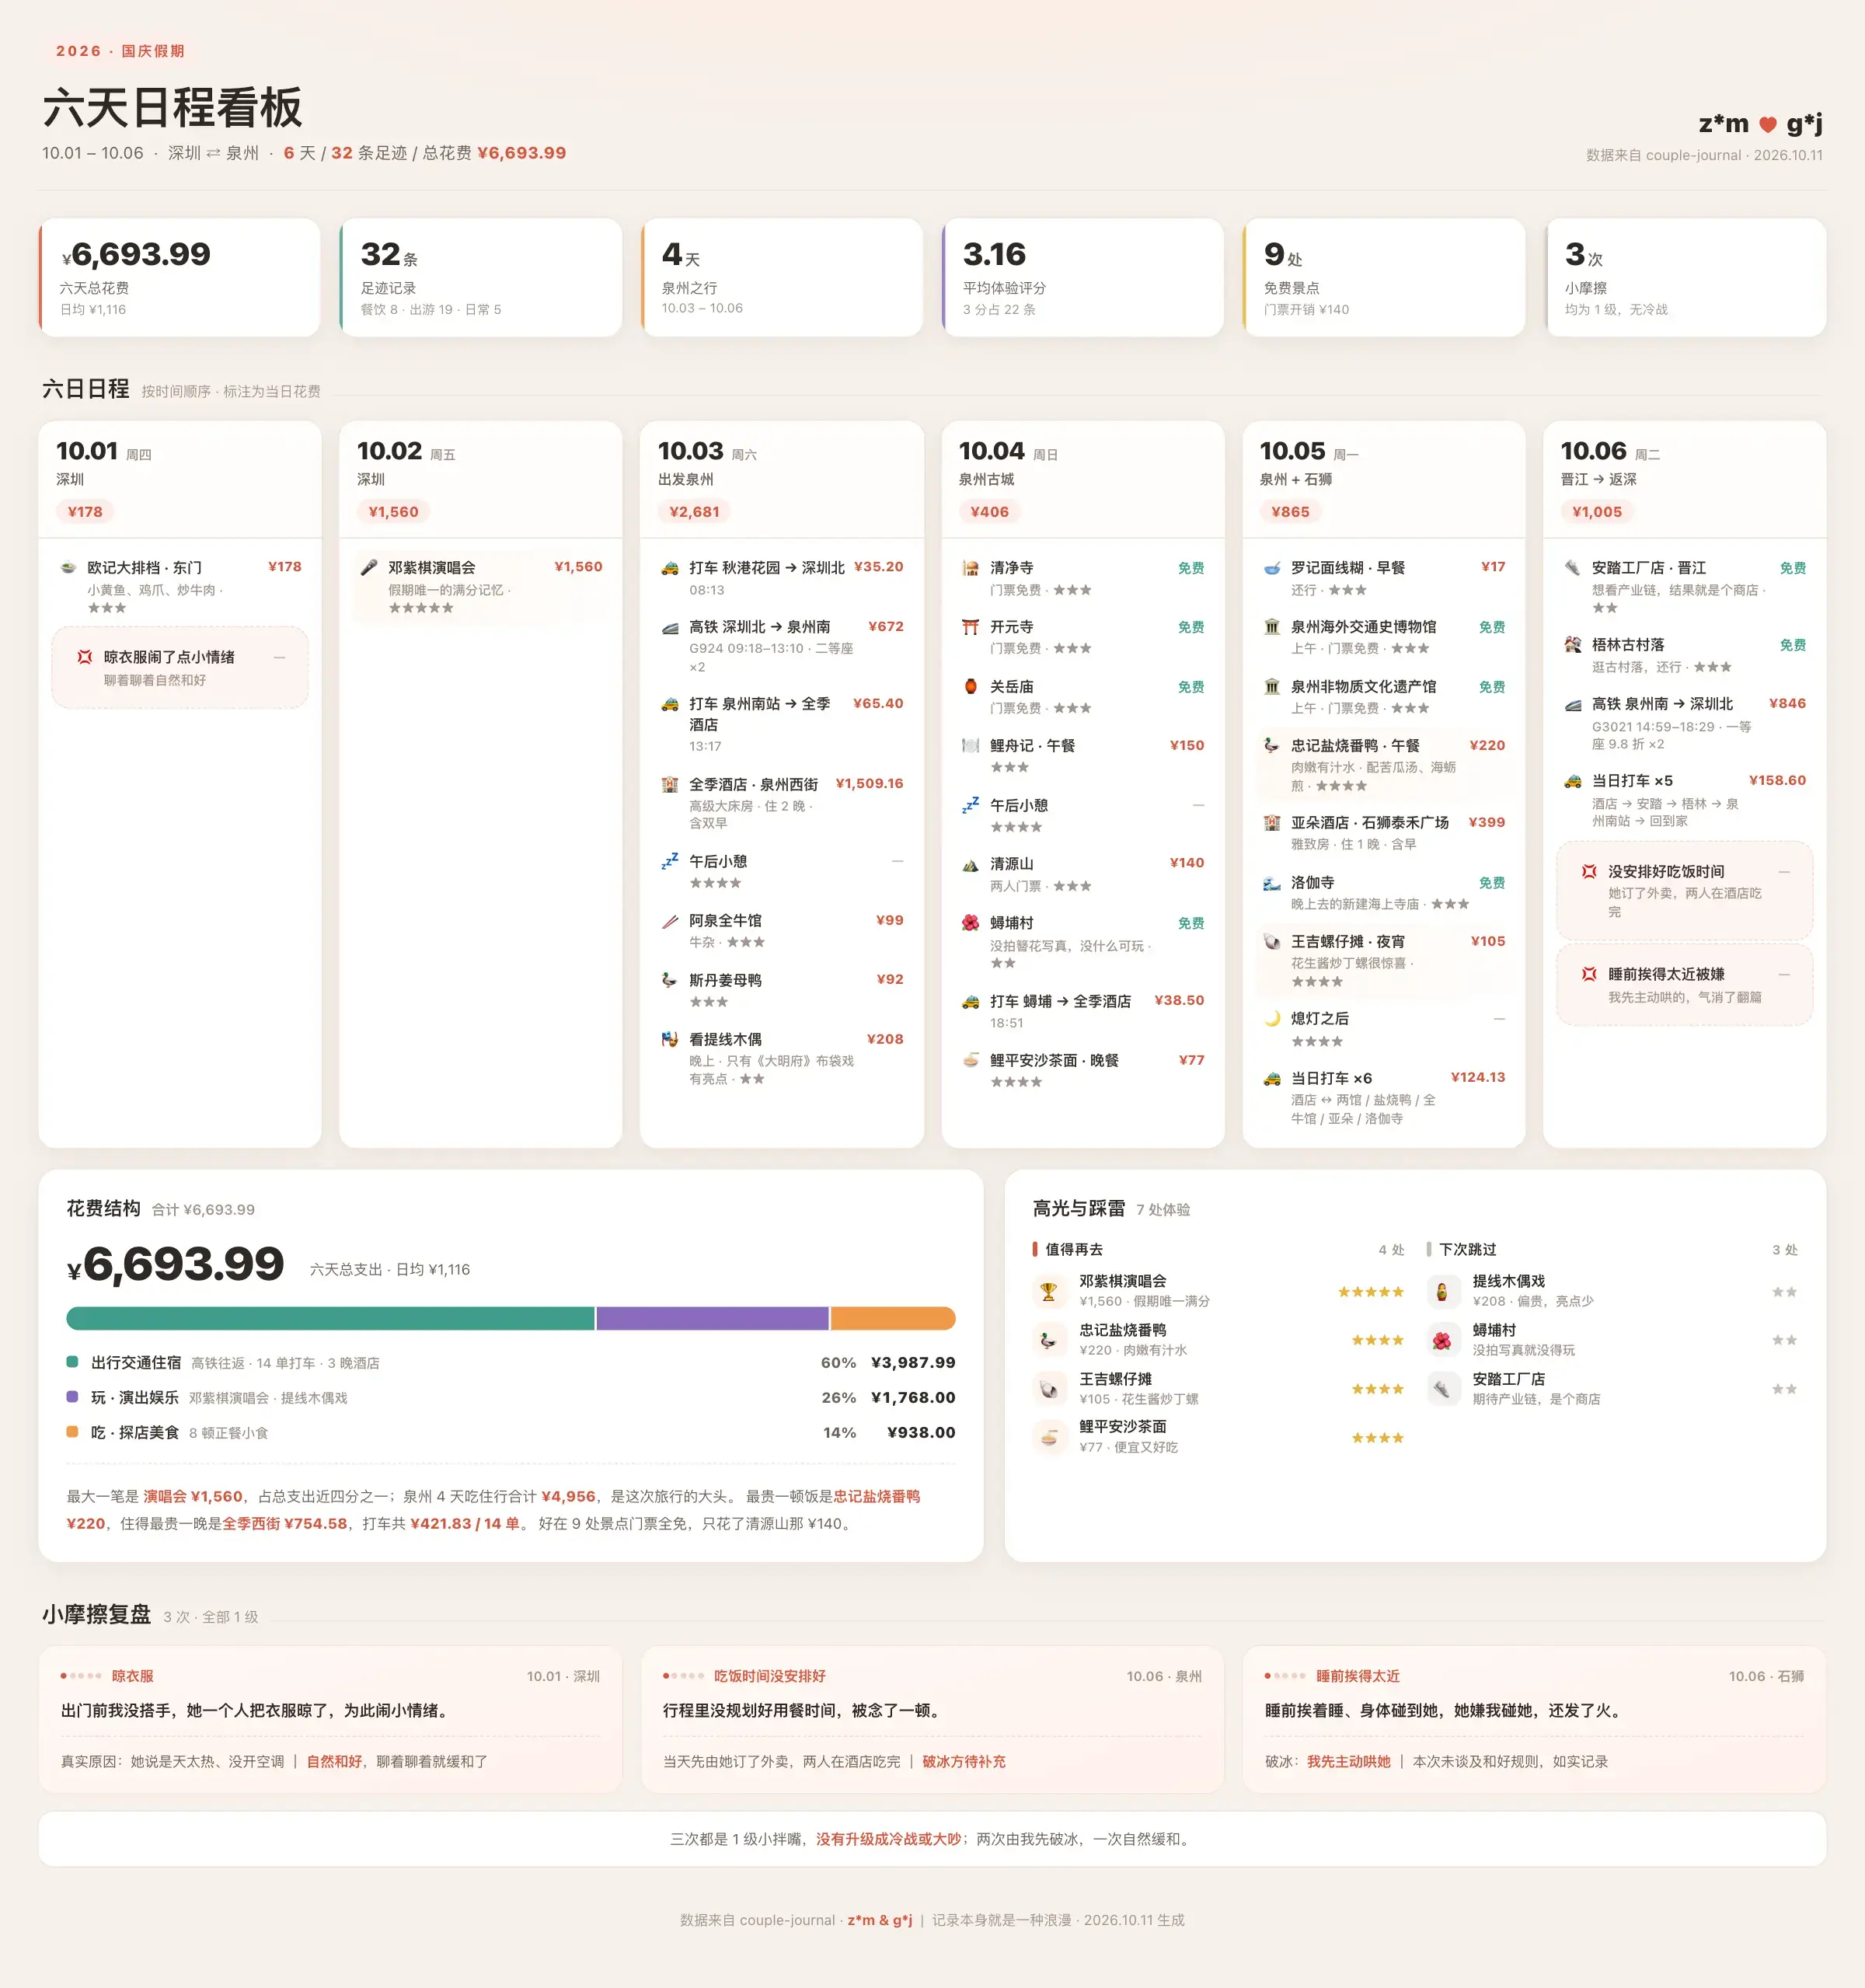
整个假期中,我只在微信小程序里通过 WorkBuddy 发发文字或订单截图;假期结束后,Agent 直接汇总 6 天行程、32 条足迹与 6,600 多元账单,并一键生成了一个交互式国庆复盘日程看板。
期间没有写一行后端 API,没有做任何管理后台前端。这篇文章从技术实现角度,聊聊这种轻应用范式是如何跑通的。
一、效果:最终交付的国庆日程看板
先看最终交付物:假期结束后,让 Agent 基于数据库中的记录进行复盘分析,Agent 直接生成了一个完整的单页响应式 HTML 看板。
二、架构设计:数据库是后端,DatI 是语义网关
传统实现这样一个日记/记账应用,常规技术选型通常是:
数据库设计 → Spring Boot / FastAPI 编写增删改查 REST 接口 → 鉴权与参数校验 → 移动端或 Web 管理页面开发 → 统计报表接口编写。
而在 Agent 时代,架构被高度精简为三层:
[ 用户端 ]
   │  微信小程序 (随时发文字描述、发账单/订单截图)
   ▼
[ Agent 宿主:WorkBuddy ]
   │  多模态意图识别、OCR、参数提取、即席分析
   ▼  标准 Streamable HTTP (配置 Endpoint + Token)
[ 语义网关:DatI (Data Intelligence) ]
   ├── 元数据沉淀 (表/字段别名、枚举字典、业务术语倒排检索)
   ├── 参数化 SQL 模板 (安全隔离的写操作:add_moment, add_conflict)
   └── 只读 SQL 即席查询执行器 (超时控制、熔断与高危语法拦截)
   │
   ▼
[ 生产存储:MySQL (couple_journal) ]
1. 底层存储模型设计
在 MySQL 中仅建了两张核心表,专注于实体本身的建模:
-
couple_moment(生活足迹表):-
id,start_date,end_date(起止时间) -
title(事项名称/餐厅名/地点/电影名) -
category(枚举:DINING美食,MOVIE观影,TRAVEL旅游,DAILY日常) -
cost(花费金额,0 表示免费) -
rating(体验满意度 1~5 分) -
content(详细感受、评价与备注细节) -
recorder(记录人)
-
-
conflict_record(争吵与和解复盘表):-
id,moment_id(关联特定足迹,如旅游中吵架) -
incident_date(发生日期) -
reason(矛盾起因与核心分歧) -
peacemaker(谁主动破冰/求和) -
severity(激烈程度 1~5 级) -
agreement(和解共识与经验约定)
-
2. 为什么不能让大模型“裸连”数据库写 SQL?
很多人尝试给 Agent 接数据库时,第一反应往往是直接给 Agent 暴露一个 execute_sql 工具,让大模型自己写 INSERT 或 UPDATE。
但实践中这会带来三个确定性的工程灾难:
-
写入数据脏乱、格式漂移:大模型自由生成的日期格式、枚举大小写极易不统一(如把
DINING写成food,金额带上¥符号导致类型错误)。 -
高危越权与数据覆盖:一旦写出带缺陷的
UPDATE或DELETE,可能误伤整个表。 -
幻觉与表结构遗忘:长上下文衰减后,模型极易遗漏外键或必要约束。
3. DatI 的解法:语义层 + 参数化 SQL 模板
DatI 的核心职责,就是把底层的数据库表结构,安全、结构化地转译给 Agent:
-
元数据与别名增强: 在 DatI 后台为字段配置人类语言别名(如
cost别名配置为“花销/账单/金额”,category枚举映射为中文),DatI 会自动构建倒排索引。当 Agent 想要查询或记录时,能秒级命中正确的字段。 -
参数化 SQL 模板沉淀为原子写工具: 通过参数化模板,将高频写操作封装为固定函数(如
add_moment、add_conflict):INSERT INTO couple_moment (title, category, cost, rating, start_date, end_date, content, recorder)VALUES (:title, :category, COALESCE(:cost, 0), COALESCE(:rating, 3), :start_date, COALESCE(:end_date, :start_date), :content, :_user.name);这样暴露给 Agent 的是一个结构严谨的 JSON Schema 工具:大模型只需要根据用户输入提取字段做“填槽(Slot Filling)”,底层的 SQL 骨架、类型转换和安全注入(如
recorder强制注入当前用户身份)全部由 DatI 兜底。 -
一键发布为标准 Streamable HTTP MCP 服务: 无需本地写 Node.js 或 Python MCP 脚本,在 DatI 界面点击发布,就会生成一个对外标准的 Streamable HTTP 端点。在 WorkBuddy 等任意支持 MCP 的 Agent 中填入 URL 与 Token,两分钟完成集成。
三、真实交互链路:采集、分析与交付
在实际运行中,整个应用呈现为三阶段闭环:
阶段一:移动端随手记(自然语言与多模态采集)
在旅途中,打开电脑操作管理系统是反人性的。通过微信小程序连接 WorkBuddy,记录变得轻量且自然:
-
场景 A:文字随手记
用户:“中午在全牛馆吃了99块,牛杂味道一般,打了3星。”
Agent:识别意图 → 调用 DatIadd_moment(title='阿泉全牛馆', category='DINING', cost=99, rating=3, content='牛杂', start_date='2026-10-03')→ 写入 MySQL。 -
场景 B:订单截图与票据记账
用户:发送一张高铁购票截图或外卖账单。
Agent:多模态 OCR 识别始发站、终到站、车次与实付金额 → 自动归类为TRAVEL→ 调用add_moment完成记录。
阶段二:即席多维聚合
假期结束时,不需要 IT 人员提前预置报表逻辑,直接给 Agent 一句 Prompt:
“汇总国庆 10.01 到 10.06 期间所有的足迹、消费和吵架记录,按天梳理,统计花费结构、高光踩雷项目和小摩擦原因。”
Agent 此时通过 DatI 的语义检索发现数据源,调用只读执行能力生成 SQL 进行聚合分析:
-
按日期分组统计每日事件数与支出总额;
-
按
category计算不同大类的消费占比; -
过滤
rating >= 4作为高光体验,rating <= 2作为踩雷预警; -
关联查询
conflict_record进行情绪与破冰方式统计。
四、DatI 的应用场景延展:从个人轻应用到企业敏捷交付
这个国庆伴侣日记的例子看似是一个个人生活趣味场景,但在技术本质上,它验证了 Agent + 数据库语义网关 在构建轻量级业务系统上的通用能力:
|
维度 |
传统业务系统构建 |
DatI + Agent 模式 |
|---|---|---|
|
开发周期 |
表设计 + 接口开发 + 前端页面,耗时数天至数周 |
只需表设计 + DatI 配置语义/模板,数分钟生效 |
|
交互入口 |
固定的表单、列表页与后台管理系统 |
移动端聊天窗口(语音、文字、图片/OCR) |
|
写操作保障 |
后端手写校验与事务代码 |
DatI 参数化 SQL 模板强约束与用户上下文物理隔离 |
|
需求变更 |
增加字段需改接口、改 DTO、改前端表单 |
仅需 ALTER TABLE,在 DatI 刷新元数据,Agent 自动适应 |
|
数据洞察 |
依赖 IT 预置的固定看板,即席分析响应慢 |
自由自然语言即席下钻,随时生成独立可视化交付物 |
五、结语
当数据能够被Agent安全地写进去、准确地查出来时,开发一个业务系统可能真的只需要几张表和几条语义配置。不过当前Agent应用最大局限是性能较慢,以后一定AI应用的大规模发展一定需要有性能极快的模型(甚至智能程度可以有妥协)以及工具的高效调用(尽量少轮次的调用工具)。