Anthropic 拿出了目前最快的小模型,同时一口气砍了两刀价格。10 月 7 日发布的 Claude Haiku 5.5 是 Haiku 系列第一个支持可调节 effort 设置的型号,用户可以根据场景在速度和智能之间做取舍。
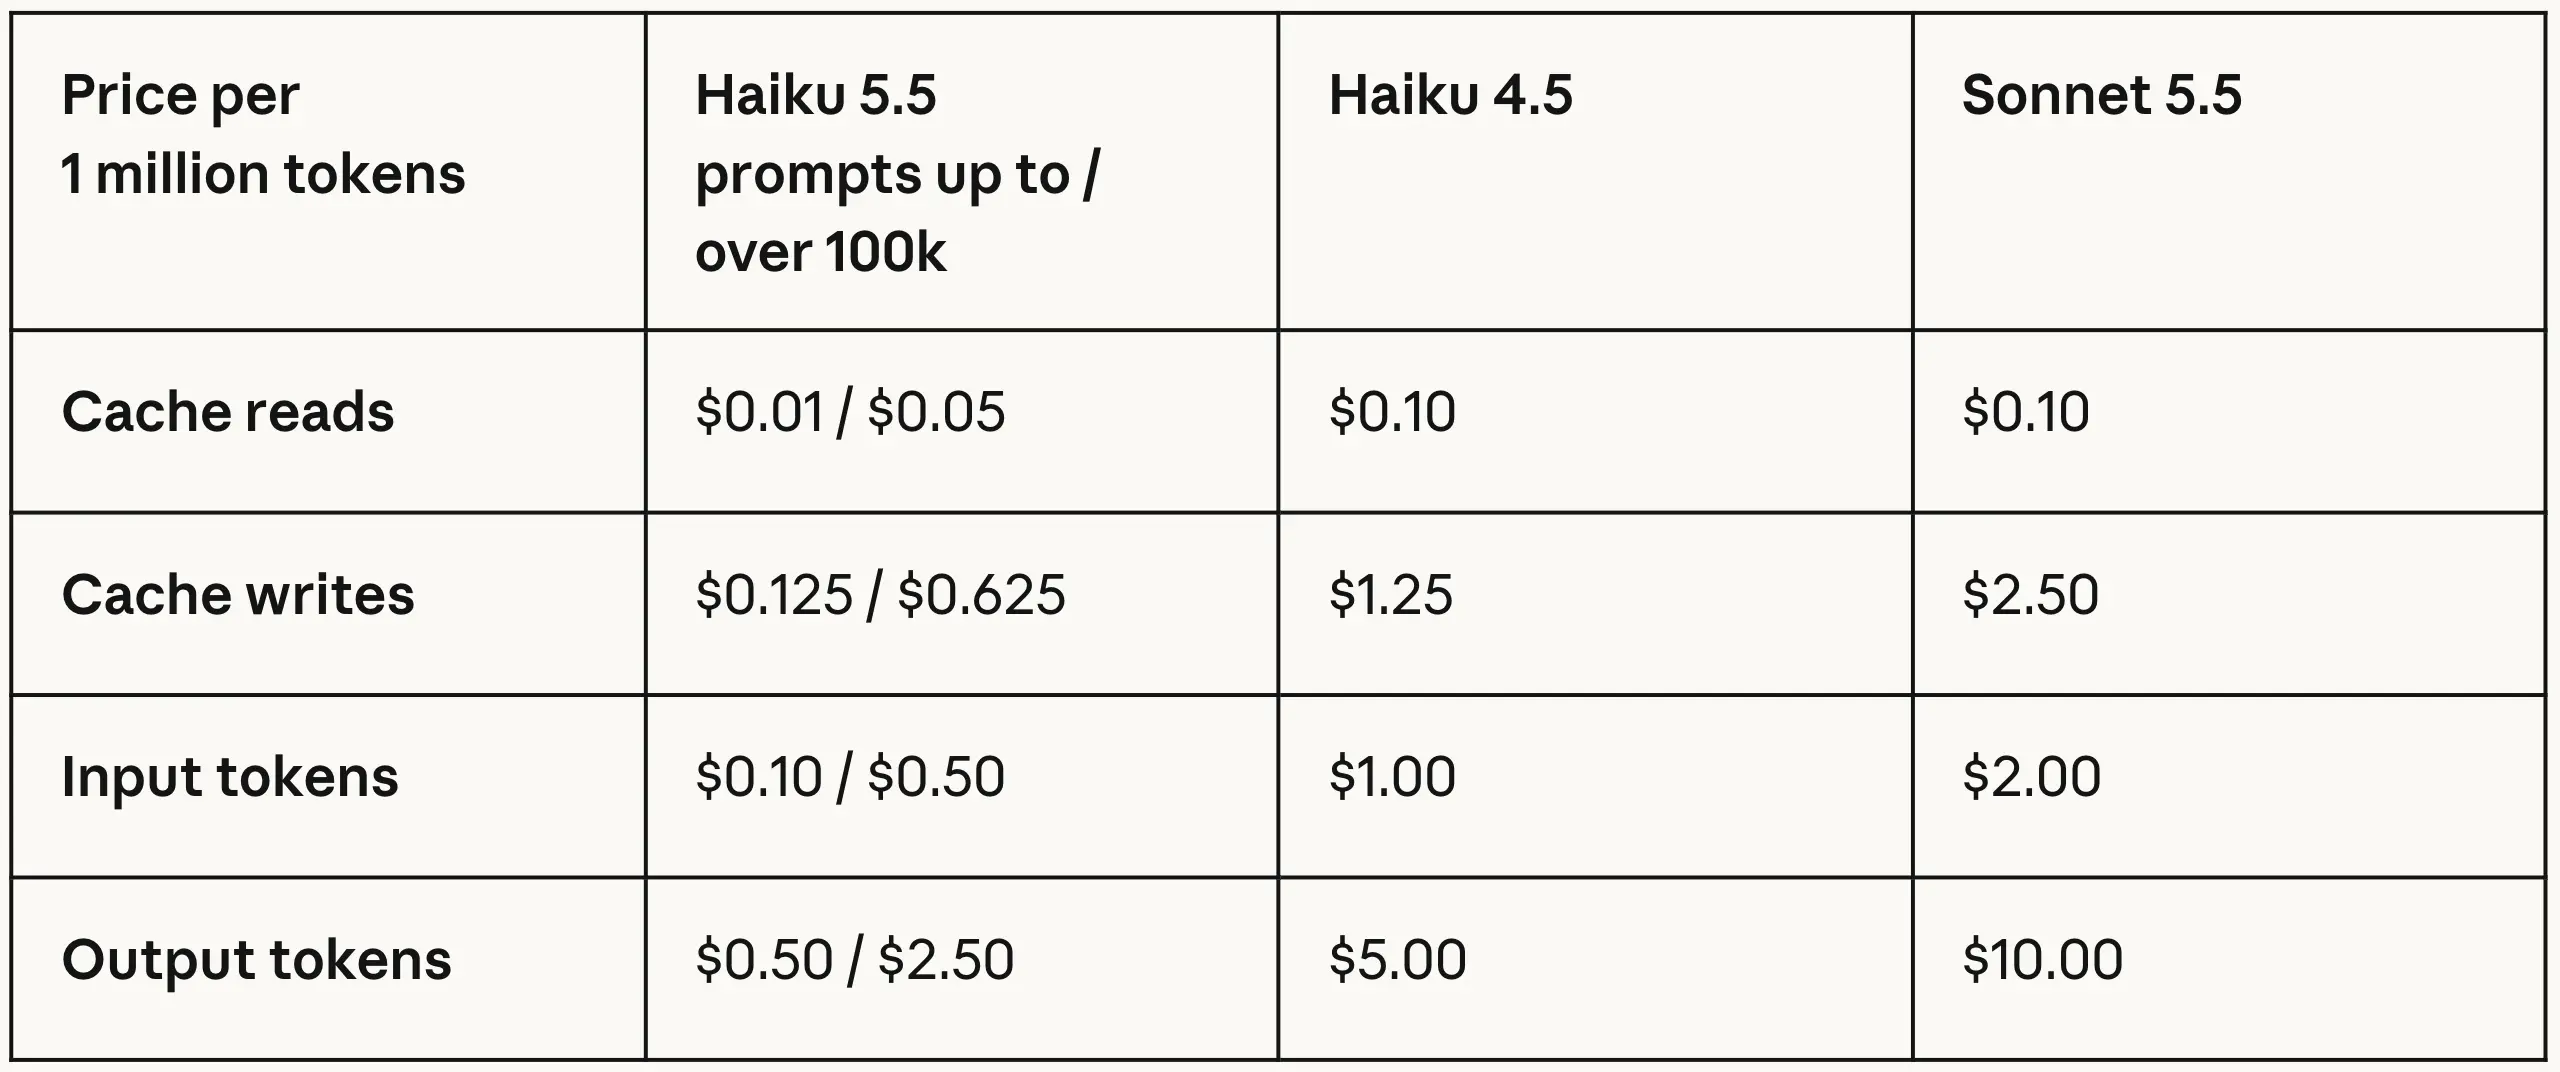
价格直接跌到 Haiku 4.5 的约四分之一——输入每百万 token 0.10 美元、输出 0.50 美元(不超过 10 万 token 的提示),缓存读取更是低到 0.01 美元/百万 token。在短提示占 Haiku 约 90% 用量的大盘上,这是一次非常有针对性的降价。顺便,Sonnet 5.5 的缓存读取也跟着砍了一半,从 0.20 降到 0.10 美元/百万 token,按 Anthropic 的说法这意味着 agent 类任务成本再降约 20%。
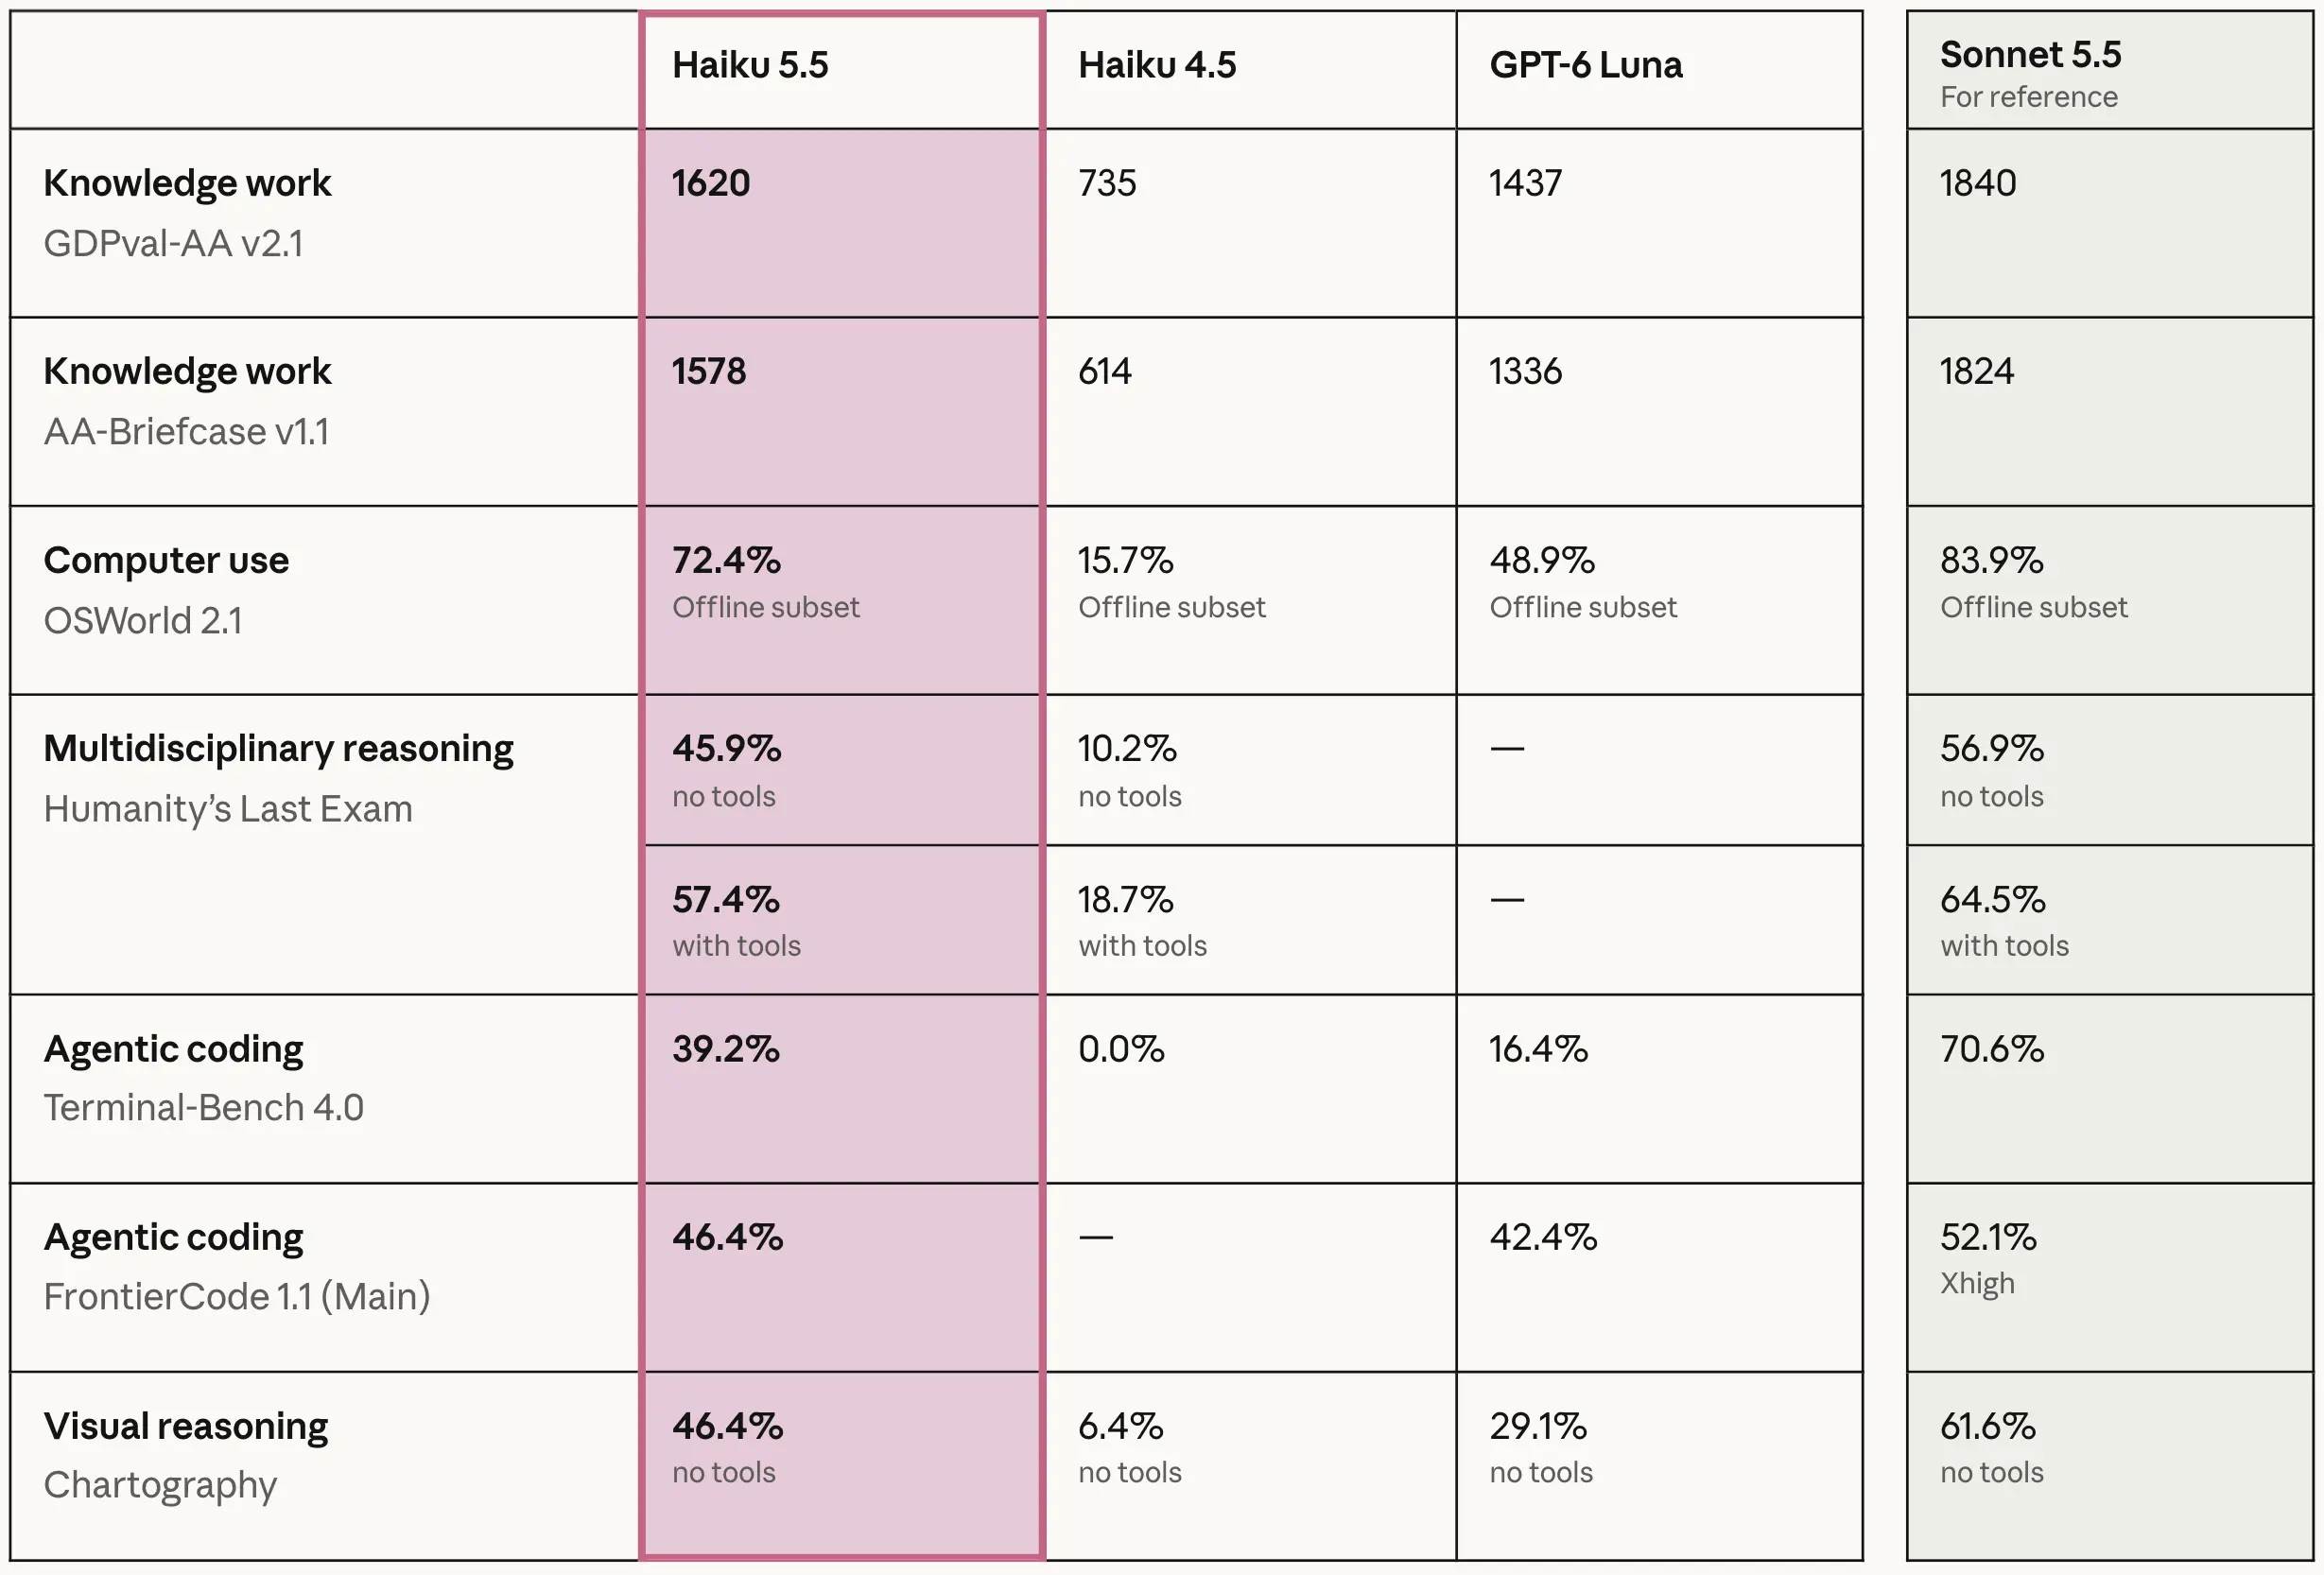
Haiku 4.5 在 agent 类任务上几乎是个盲区——OSWorld 2.1 离线子集得分 15.7%、Terminal-Bench 4.0 是 0.0%。换到 5.5,这两个数字跳到了 72.4% 和 39.2%。知识工作方面 AA-Briefcase v1.1 从 614 飙升到 1578 的 Elo;推理上 Humanity's Last Exam(无工具)从 10.2% 到 45.9%,带工具 57.4%。与直接竞品 GPT-6 Luna 比起来,Haiku 5.5 在几乎所有已公布基准上都明显领先。多模态视觉推理 Chartography 同样翻了七倍(6.4% → 46.4%),考虑到早期 Haiku 的多模态能力几乎可以忽略不计,这个跨度的意义比单看数字更大。
随之而来的还有产品层面的一个小变化:Anthropic 在 Max 和 Team 订阅计划中,各给了一笔新的月度 API 额度。直接官方说辞是「为了支持用户构建新的 agent 和应用」,可以理解为想推着免费/付费用户在 Claude Platform 生态里跑更多的代理和自动化——毕竟要让受控的推理集中在自己的平台上,才有后续的粘性。
企业客户的早期反馈也在公布页上高亮展示了。Asana 报告任务 completion 延迟降低超 30%、每个 agent 轮次推理速度提升至 2.5 倍;HubSpot 在 CRM 任务评测套件上 Haiku 5.5 拿到了 92.8% 的均分,是测试过所有模型里的最高分;AlphaSense 在每周 800 万次的 Document QA 生产流量上测了 400 个查询,质量有统计学意义的提升(0.84 vs 0.76)。速度和精度一起提了。
综合考虑价格和性能,这个更新的定位很明确:把过去只能靠 Opus/Sonnet 干的那些需要反复调用的小任务(分类、提取、摘要、数据库查询、subagent 辅助),用一种足够便宜又足够快的方式下放给 Haiku。它不试图替代 Opus 处理复杂推理,但显著挤压了 GPT-6 Luna 和 Qwen 在这个价位带上的生存空间。
来源: