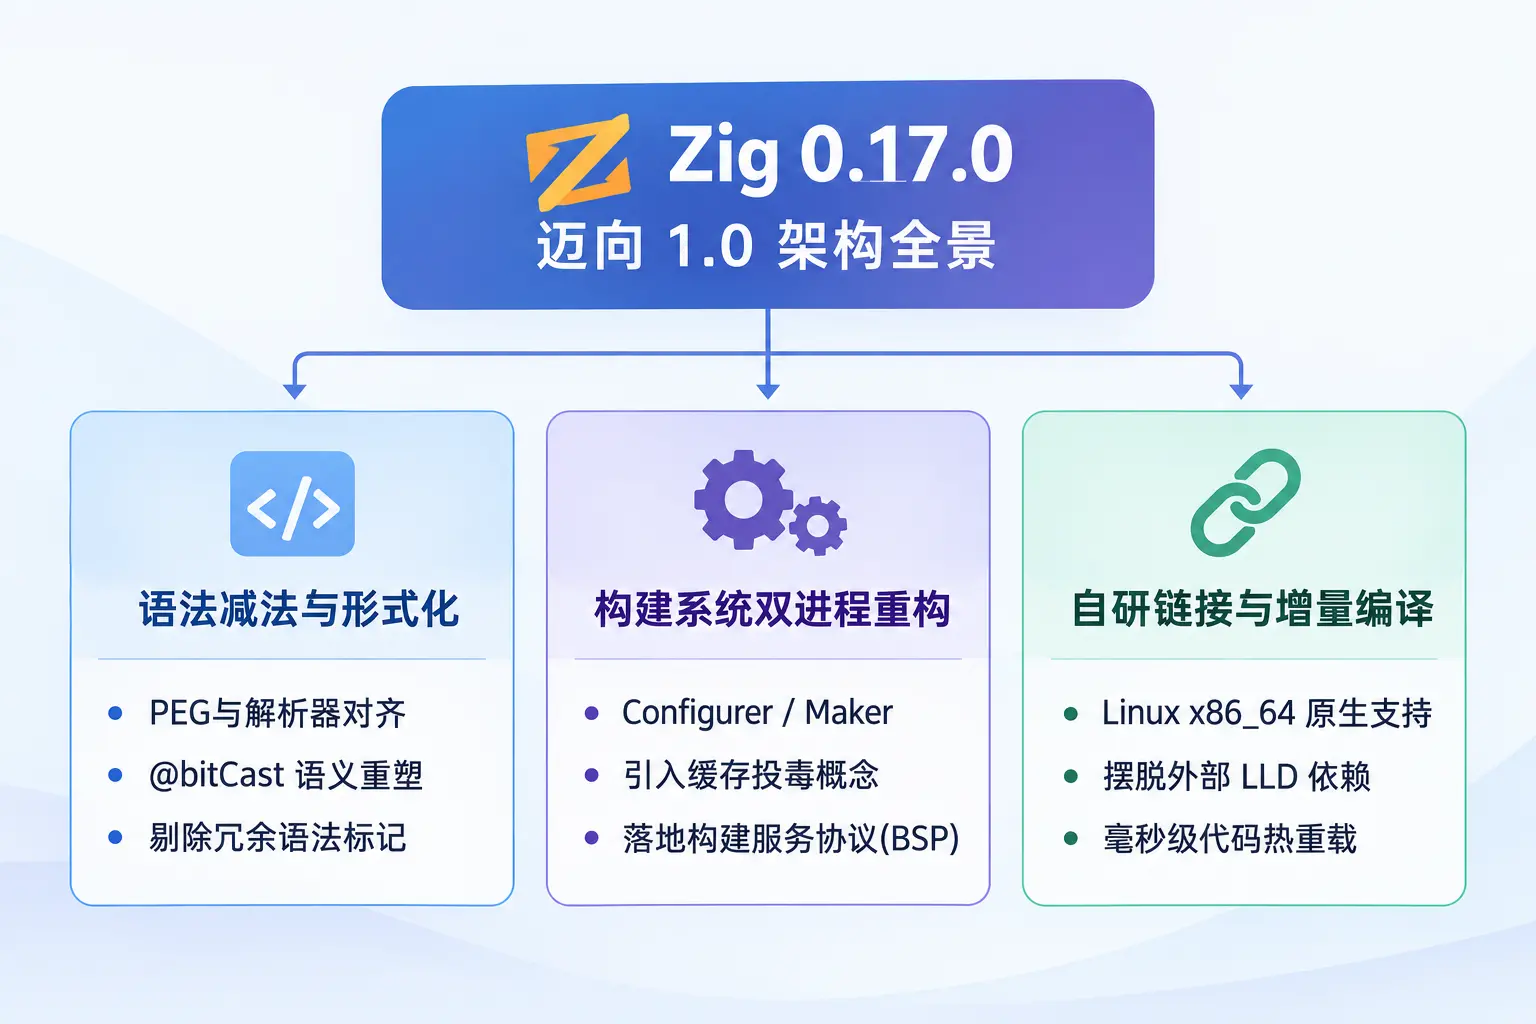
经过 5 个月的密集迭代,汇集全球 206 位贡献者的 925 次代码提交,底层系统编程语言 Zig 迎来了关键的里程碑版本——Zig 0.17.0。对于关注现代编译器技术与底层软件架构的开发者而言,这并不是一次按部就班的常规升级,而是一场伴随着巨大技术阵痛与工程决断的底层洗礼。在这份沉甸甸的更新中,Zig 团队对构建系统进行了体系结构级别的重构,首次通过形式化语法和模糊测试拉齐了编译前端,并在自研 ELF 链接器的加持下,使 Linux 平台的增量编译真正走向实用。
在知名开发者社区 Hacker News 上,0.17.0 的发布迅速登顶技术讨论榜单。作为一门被寄予厚望、旨在替代 C 语言并挑战现代系统编程版图的新星,Zig 在社区中收获了狂热的赞誉,也遭遇了尖锐的审视。有资深工程师在讨论中感叹,在历经 JavaScript、C、Pascal 和 Go 等多种语言的淬炼后,Zig 是目前“专为人类心智模型设计的最佳系统级语言”;但与此同时,构建系统的推倒重来、上游 LLVM 导致的性能回退、以及项目组对人工智能生成内容的严苛治理态度,也让这场围绕 0.17.0 的讨论演变为一场关于现代开源哲学与工程取舍的大思辨。
语法的“减法哲学”:形式化对齐与设计收敛
实现语言稳定并发布 1.0 版本,是 Zig 基金会当前最重要的长线目标。在 0.17.0 的开发周期中,核心团队展现出了近乎苛刻的“减法决断力”。面对庞大的历史积压提案,团队集中处理了 150 余项核心设计讨论,最终果断拒绝了约 125 项,仅吸纳了 25 项关键改进。这种克制的设计取向,传递出一个极其明确的信号:Zig 正在收紧语言的表达外延,加速进入语法冻结期。
长期以来,Zig 代码库中的形式化语法定义文件与编译器手写的递归下降解析器之间存在着细微的分歧。为了终结这种“定义与实现脱节”的状态,0.17.0 引入了一套严密的验证闭环:工具链能够将形式化语法文件直接编译为一个极简的递归下降解析器,并将其作为“黄金参考标准”,对标准库中的手写语法解析器进行高强度的模糊测试。这一举措扫清了大量隐蔽的边界解析缺陷,为后续出台正式的语言工业规范扫清了障碍。
在具体的语法清理上,0.17.0 毫不留情地废除了一批历史包袱。广受讨论的数组重复语法被彻底移除,原本的乘法符号赋值全面让位于语义更加单一明确的 @splat 内建函数;0 位的有符号整数类型以及空结构体初始化的冗余标记被清理出类型系统;针对错误处理中的延迟捕获,语言不再允许直接捕获错误值,以此促使开发者将复杂的错误分支逻辑抽离成结构更清晰的内部函数。此外,标识符内省函数 @hasDecl 的行为被修正为严格仅对公有声明生效,彻底消除了反射机制穿透私有封装的隐患。
对于需要与底层内存直接打交道的系统开发者,新版本彻底重塑了 @bitCast 内建函数的语义。旧版的位转换不仅依赖目标平台的字节序,还允许开发者在外部结构体之间进行未经检查的内存双关操作。0.17.0 将其重新定义为纯粹的“逻辑位表示重释”,使操作在不同端序架构下保持绝对的一致性;如果开发者确实需要进行底层的内存视图重释,则必须显式使用指针转换或外部联合体表达意图。与此同时,新引入的 @backingInt 与 @fromBackingInt 彻底取代了原有的枚举数值互转内建函数,不仅语法更加统一,还顺理成章地将紧凑型位包和带标签联合体的底层整数操作纳入了同一套范式中。
// 0.17.0 中类型转换的严谨化演进
// 针对枚举与底层整数转换,使用统一的 @backingInt 体系:
const generated_index = @fromBackingInt(@intCast(graph.generated_files.items.len - 1));
const raw_value = @backingInt(generated_index);

// 数组重复全面拥抱 @splat,消除原本的  乘法语法:
var buffer: [1024]u8 = @splat(0);
在社区讨论中,这种近乎冷酷的语法收敛引发了截然不同的反应。有开发者在 Hacker News 上表达了忧虑,认为部分元编程和底层操作的写法变得更加繁琐,甚至隐隐显露出向 C++ 复杂化倾斜的苗头,并因此开始将目光投向更为小巧直接的 Odin 或 C3 语言;但更多的系统级老手则对此表示赞赏,他们认为底层系统语言绝不应该纵容歧义语法与隐式行为的存在,Zig 在走向 1.0 前夜主动承担破坏兼容性的代价,正是为了换取数十年后的架构纯粹与可维护性。
构建系统与工具链重构:双进程解耦与缓存纯度
构建系统一直是 Zig 最具野心的特性之一。它摈弃了传统的外部 Makefile 或 CMake 胶水层,坚持全流程使用 Zig 语言编写项目构建逻辑。然而,伴随着项目规模的膨胀,原有的构建模型在编译速度与工具链集成上遇到了瓶颈。在 0.17.0 中,构建引擎迎来了一场伤筋动骨的大手术:构建运行过程被彻底拆解为独立的“配置进程”与“构建执行进程”。
在全新架构下,负责解析项目构建脚本的“配置进程”在执行完成后,会将庞大的构建任务图序列化为一种紧凑的私有二进制数据格式。随后,一个完全预先构建好、启用了最高级别安全优化的“执行进程”将直接读取该二进制数据,并负责后续的任务编排与编译执行。由于执行进程本身在开发者修改构建脚本时无需重新编译,再加上二进制配置省去了原先文本解析的巨大开销,整个构建系统的响应延迟被压缩到了极致。
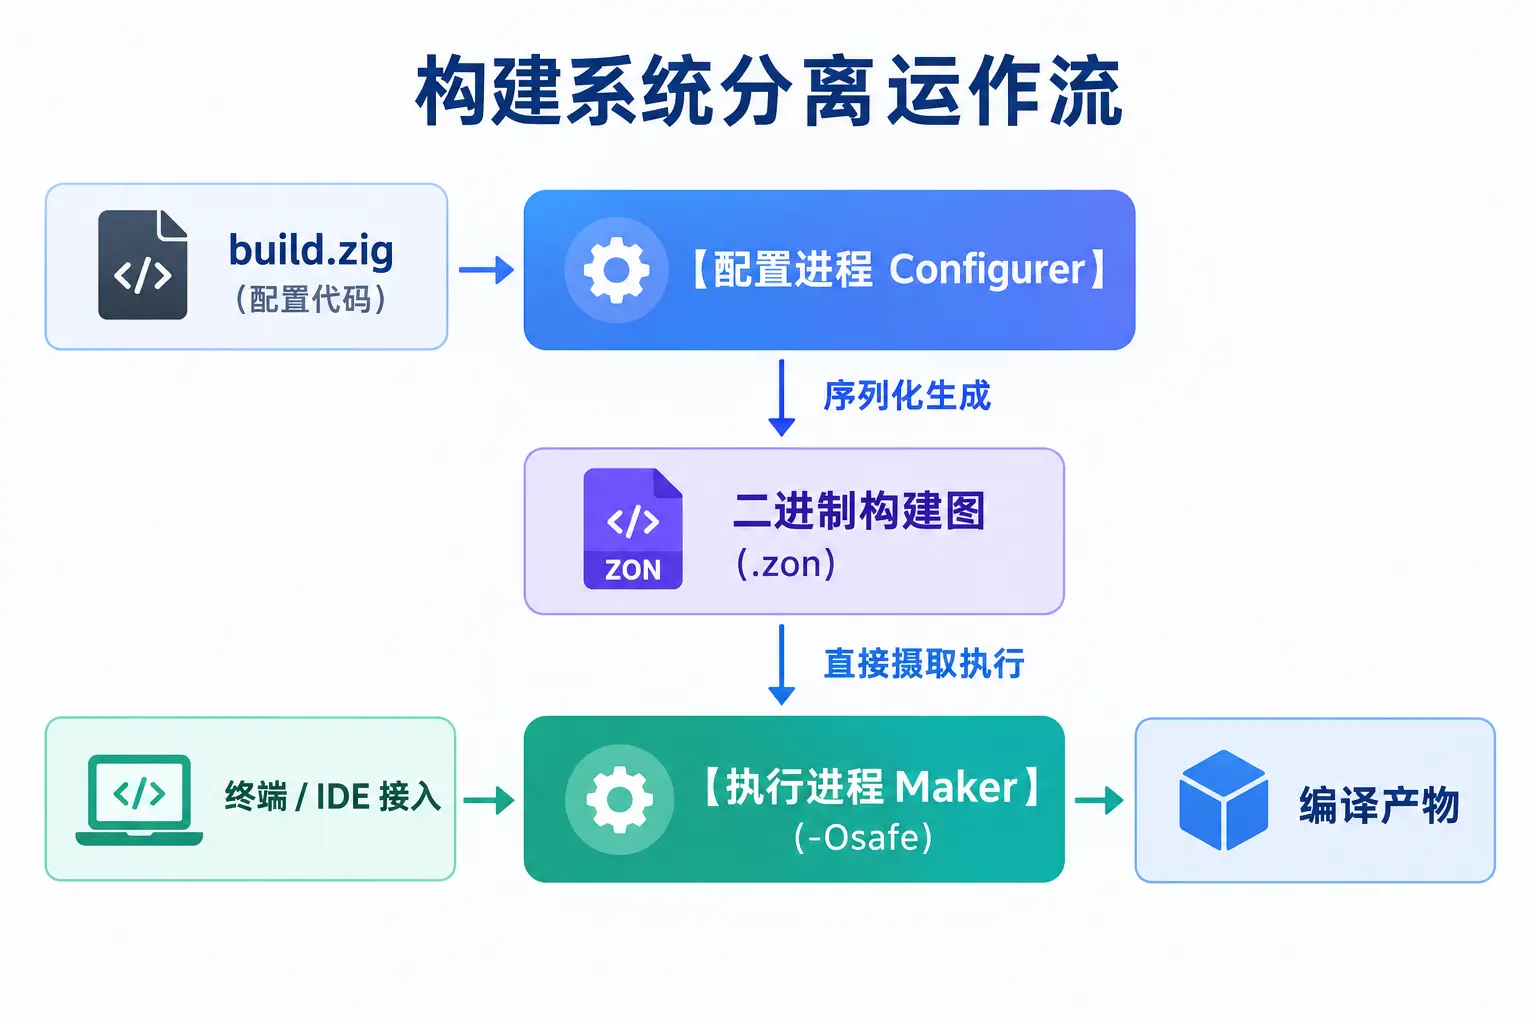
配合这一变革,Zig 首次在构建领域系统化地提出了“配置缓存投毒”的概念。由于配置进程的目标是生成可确定性复用的构建图,一旦构建脚本在配置阶段执行了任何无法被系统追踪的非纯操作——例如直接扫描宿主机环境或动态寻找全局命令——该构建缓存就会被立即标记为“受污染”,并在使用后即刻销毁,以杜绝潜伏的状态不一致隐患。为了引导开发者写出纯正且高度可缓存的构建逻辑,标准库提供了一系列细粒度的显式依赖声明接口,让开发者能够精确描述代码对于文件内容、元数据或目录变更的具体依赖关系。
构建系统的底层大翻修不可避免地波及了下游开发工具链。为了给现代 IDE 提供原生支持,新版本正式推出了构建服务器协议,开发工具只需追加指令即可直接监听构建图的执行事件并捕获编译错误。然而,由于彻底废除了旧版的构建运行驱动注入机制,知名社区项目如 Zig 语言服务器(ZLS)等在 0.17.0 发布初期遭遇了严重的适配阻碍。在社区跟帖中,不少工具链开发者感叹“追随 Zig 的演进就像追赶一列没有刹车的火车”,但核心团队与 ZLS 维护者目前正通力协作,利用新协议提供的结构化通信通道,重构更为稳固、性能更高的现代开发环境支持。
增量编译落地与链接器突破:破除外部依赖的远征
让大型项目在修改代码后实现毫秒级快速重编译,是现代工业级编译器的核心竞争力,而链接阶段往往是阻碍这一愿景的最大瓶颈。Zig 0.17.0 在自研工具链上取得了突破性进展:针对 Linux x86_64 平台,全新的自研 ELF 链接器正式达到了实用阶段,并借此在该平台上全面激活了增量编译功能。
开发者在开发调试时,只需在构建命令后追加监听与增量参数,编译器便会驻留内存监听源码改动。由于自研 ELF 链接器已经完全支持了 DWARF 调试信息、符号版本控制以及重定位就地修复,它在绝大多数场景下已经能够取代外部的 LLD 链接器。当代码发生局部变动时,编译器仅对受影响的函数块进行编译,并由链接器在原目标文件上直接“打补丁”,从而彻底跳过了漫长耗时的全量重新链接。这标志着 Zig 在摆脱对臃肿 LLVM 工具链深度依赖的道路上,迈出了决定性的一步。与此呼应,自研的 COFF 链接器也在 Windows 平台大幅强化了对原生调试格式和导入导出表的处理能力,甚至内置了一套专用的代码比对诊断工具,用于对二进制产物进行严密的回归验证。
但在自研组件高歌猛进的同时,底层编译器与上游生态的磨合却暴露出了一丝无奈的现实。0.17.0 将底层代码生成器升级至 LLVM 22.1.8,而正是在这一版本中,上游 LLVM 的循环自动向量化优化通道出现了一处严重的错误编译缺陷。为了保证生成代码的绝对正确,Zig 团队不得不在这期发布中强制全局禁用了循环向量化功能。
这一技术妥协迅速在性能敏感的社区圈子里引发了连锁反应。多位在 Hacker News 上参与讨论的开发者反馈,在将涉及大规模整数位运算和密集文件 I/O 的项目迁移到新版本后,程序运行性能出现了 10% 到 15% 的异常回落。面对社区的困惑与质疑,核心开发者现身进行了坦诚的技术溯源:由于上游修复补丁破坏了 LLVM 核心库的底层接口规范,无法向后移植至当前的发行分支中;而直接跳级升级至未稳定的最新开发分支又会给各大 Linux 发行版的打包维护者带来灾难性的混乱。因此,团队只能选择在当前版本中承受优化降级的阵痛,并承诺在随后的 0.18.0 版本中伴随底层编译器的大版本更新彻底解决这一隐患。这种发生在工业级底层工程中的两难抉择,生动地展现了自研生态在羽翼未丰前受制于庞大历史遗产的真实困局。
内存安全的实证突围:SafeAllocator 的设计与表现
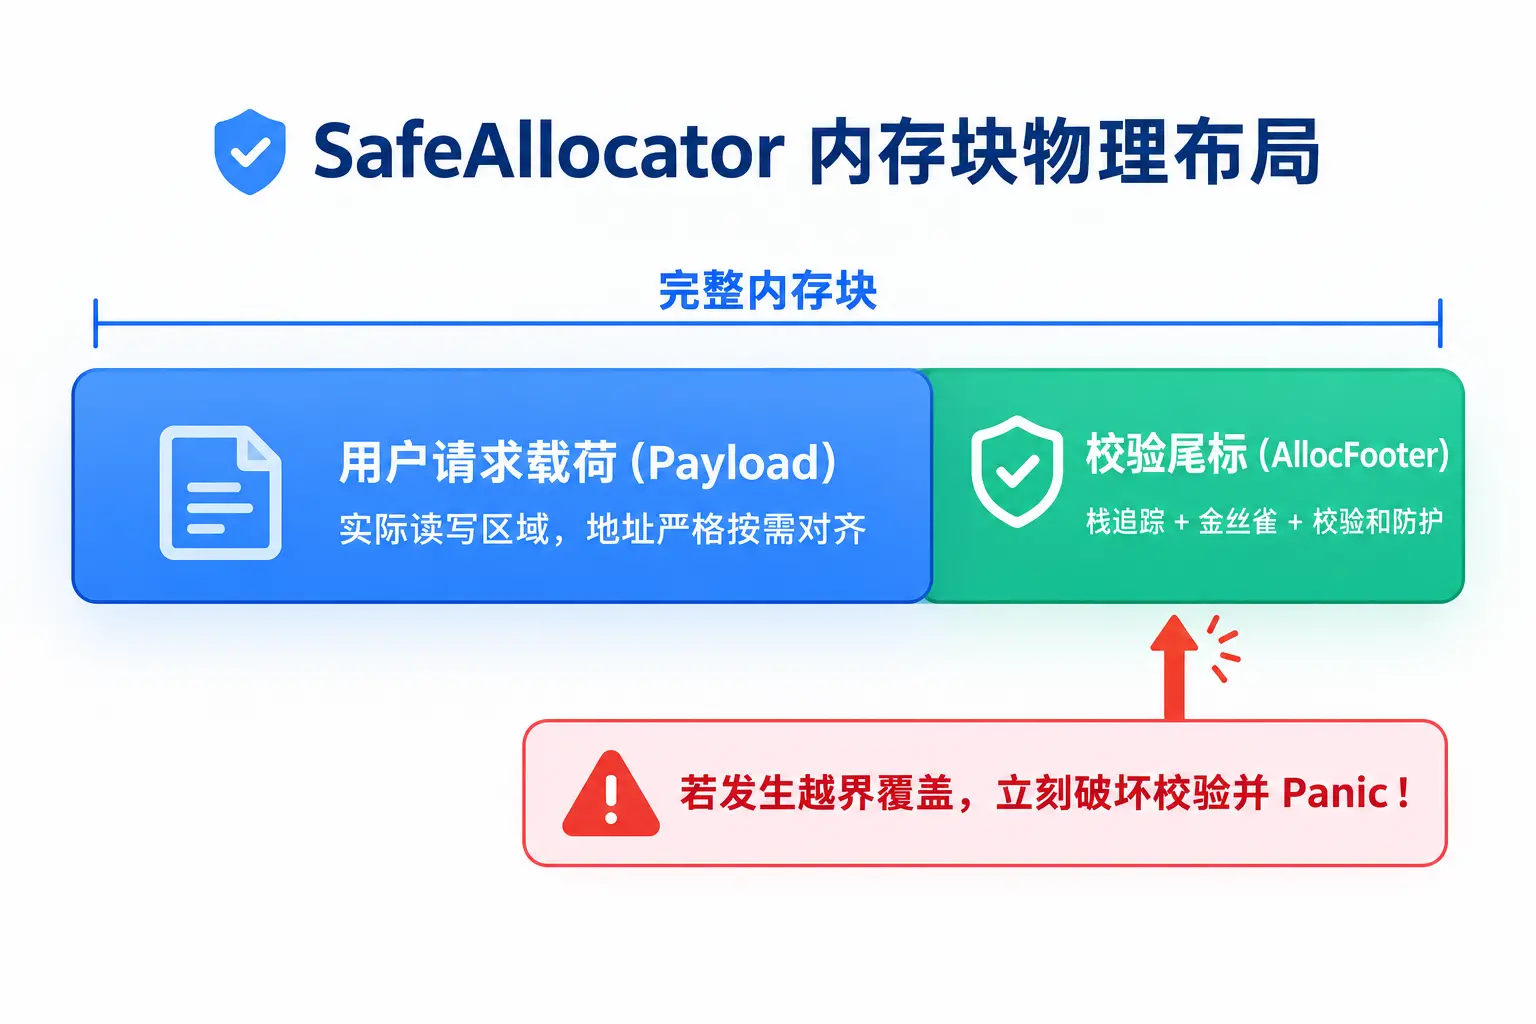
虽然 Zig 在语言层面上并未引入类似 Rust 那样基于生命周期和所有权的高门槛静态类型系统,但它始终坚持通过高精度的运行时探测与可组合的内存分配器,向开发者提供极致的确定性。在 0.17.0 中,服务社区多年的调试分配器正式退役,取而代之的是全新设计的安全验证分配器 SafeAllocator。
这套崭新的分配机制在体系设计上将防御能力推向了新的高度。在多线程并发场景下,它彻底摒弃了传统低效的全局粗粒度锁,转而采用各线程独立的分配追踪与无锁分段链表机制;而在每一个被分配的内存对象尾部,系统都会强制追加一段受校验和严密保护的元数据尾标,用于记录精确的调用栈轨迹和金丝雀校验值。更关键的是,该分配器在内存释放后绝不会轻易复用地址空间,一旦程序发生二次释放、跨分配器释放或经典的释放后使用(UAF)错误,系统将立即触发精确的系统级缺页异常或段错误中断执行,彻底杜绝了内存静默破坏的安全隐患。
更为难得的是,严密的安全性检查并没有带来灾难性的性能开销。在针对标准库庞大测试套件的基准性能测试中,由于内部内存碎片和元数据追踪结构的精心重构,新版运行时的峰值物理内存占用从原先的 2.24 GB 直降至 1.11 GB,整整削减了 50.3% 的内存足迹;与此同时,端到端测试耗时也由 29.4 秒缩短至 22.1 秒,实现了逆势的性能与资源双重跨越。
这种扎实的底层工程能力在社区中赢得了极高的信任票。面对经常出现的“缺乏编译期强力检查是否安全”的论调,不少工程师在社区讨论中搬出了诸如高性能金融级分布式数据库 TigerBeetle,以及近期备受关注的终端模拟器 Ghostty 作为例证。这些用纯 Zig 编写的重量级项目表明,只要配合确定性的无隐藏分配策略、精细的分配器控制以及 SafeAllocator 这类强悍的验证武器,开发者完全能够在不牺牲极限吞吐与底层控制力的前提下,构建出坚不可摧的严肃系统软件。
治理哲学碰撞:AI 时代的开源底线与 1.0 远景
除了技术维度的剧烈变革,伴随 0.17.0 发布的,还有一场关于开源治理伦理的激烈交锋。这源于一名开发者在社区中的遭遇:该用户在花费数小时排查出一处涉及底层 DWARF 调试符号生成的深层编译器缺陷后向官方提交了缺陷报告,仅仅因为在描述中随口提及“该问题已经过大语言模型辅助推演确认”,整个工单便被项目维护者基于社区行为准则直接关闭并拒绝受理。
这一事件迅速在 Hacker News 上引发了一场轩然大波,直接将 Zig 官方近乎极端的“反 AI”治理政策推向了风口浪尖。根据 Zig 官方的项目行为准则,社区严厉禁止任何利用聊天机器人提交建议、排查 Bug 或提供代码片段的行为。批评者认为,在生成式 AI 已普遍融入工程实践的当下,这种教条式的“一刀切”禁令显得过于傲慢与封闭,将一个经过验证的真实系统 Bug 拒之门外,无疑是一种因噎废食;然而,大量疲于奔命的开源项目维护者却站在了 Zig 这一边,他们指出,面对由 LLM 批量生成的看似专业实则漏洞百出的海量“AI 垃圾(AI Slop)”,小规模的开源核心团队如果不在入口处构筑绝对的防护铁幕,仅存的人工代码审查带宽将瞬间被消磨殆尽。
面对舆论发酵,Zig 核心开发团队在讨论中给出了冷静而坚定的回应。他们明确澄清,项目唯一的底线是要求提交给 Zig 的技术反馈必须“由人类撰写,且专为人类阅读而设计”;维护者无意干涉开发者在个人项目中如何使用 AI 工具,但公共缺陷追踪系统绝不能成为不可控生成内容的测试场。颇具讽刺意味却又合乎理性的是,就在不久前的技术分享中,Zig 创始人 Andrew Kelley 还曾公开探讨过在编译器内部测试中借鉴先进方案、探索利用自动化技术挖掘逻辑漏洞的可能性。这种对内探索技术潜力、对外严防无效噪音的双轨策略,折射出的正是当前纯粹技术型开源社区在面对生成式浪潮冲击时的清醒防卫与现实困境。
在这场轰轰烈烈的发布尾声,Zig 团队依然保持着一贯的冷峻与坦诚。在官方发布文档的显要位置,他们毫不掩饰地设立了“本版本包含错误”的专门章节,直白地告诫所有开发者,如果要在生产中落地当前的 Zig,必须做好参与底层编译器共建与踩坑的心理准备。
依照官方公布的演进路线,在接下来的版本中,Zig 将继续推进构建服务器协议与语言服务的全面融合、让基于自研后端的 Windows 与 AArch64 调试编译进入默认状态、加速剔除一切对外部 LLD 链接器的依赖,并全力推进语言核心规范的最终冻结。在软件工程日趋庞杂、概念不断层叠包装的时代,Zig 0.17.0 如同当代系统编程领域的一位苦修者。它宁可在频繁的断舍离与打破兼容性中承受争议,也绝不在技术纯粹度与透明性上作半步退让。这场破釜沉舟奔向 1.0 的征途或许注定布满荆棘,但它所爆发出的原始工程生命力,足以让每一个深爱底层技术的极客为之驻足凝望。