Linux 内核里的 LZ4 压缩实现,终于要停止维护自己的那份「fork」了。三星的 Michal Wilczynski 提交了一个 RFC 补丁系列(9 个 patch),把内核里的 LZ4 从「手工维护的分叉」改成「原样同步 vendor 源码、构建时再适配」,这样以后同步上游就演变成一次目录拷贝。
fork 的代价是实打实的。内核里的解压器最后一次跟上游对齐是 2018 年的 v1.8.3,压缩器更早,2017 年的 v1.7.3,之后全靠一个接一个手工 cherry-pick 维持——而这两年上游 lib/ 目录已经攒下 488 个提交。差距累积出了真 bug:fork 版 LZ4_decompress_fast() 根本没有边界检查,损坏的输入会同时朝输出缓冲区的两个方向跑飞。
方案是把上游源码逐字节搬进内核(upstream/lz4.c、lz4.h 等),再用一层内核胶水(lz4_deps.h、freestanding/ 头文件)在构建期适配,布局参照 lib/zstd。导入的是 v1.10.0 发布标签,唯一偏离是为满足内核的 -Wmissing-prototypes 警告 backport 了一个上游提交。代价是体积:lib/lz4 的 text 在 x86_64 上从 45K 涨到 89K,主要是以前 fork 里根本没有的上游代码。
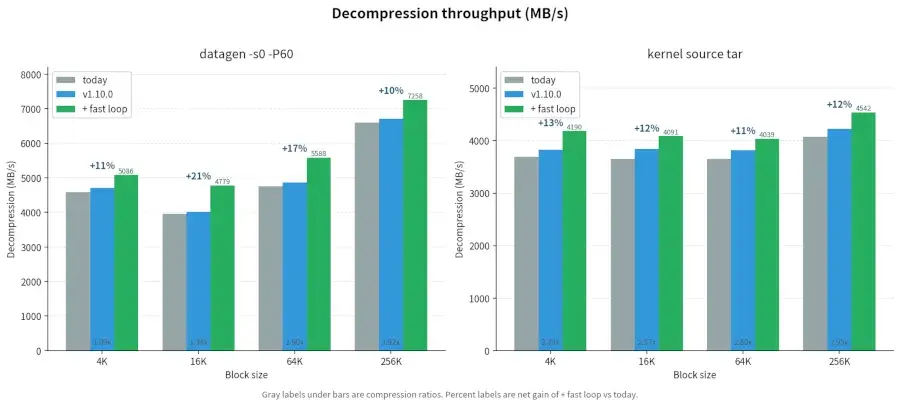
有真金白银的收益。实测 21 次中位数、每次读 1.3GB LZ4 erofs 内核源码镜像:erofs 4K cluster 从 2363 MB/s 提到 2630(+11%),64K 从 2788 到 3168(+14%);库级解压在 datagen 和内核源码 tarball 两个语料上各档 block 普遍 +10% 到 +21%。新的快速解码回路是上游 v1.9.0 加的,fork 一直没跟上。性能外还有个修复:LZ4_decompress_fast() 现在是走有边界检查的解压路径,不会再把数据写飞出缓冲区。
这个系列也让 LZ4 在 MAINTAINERS 里第一次有了自己的条目——之前它一直没人照看。线程里 Eric Biggers、Sergey Senozhatsky 等已经在 review,三星(f2fs、erofs、zram 都牵扯在内)的维护者也在跟进。
来源:
- [PATCH RFC 0/9] lib/lz4: stop forking upstream LZ4, vendor it instead (lore.kernel.org / LKML)](https://lore.kernel.org/lkml/20260925-lz4-vendor-upstream-v1-0-1c7ffbe21c4b@samsung.com/)