当AI从内容生成走向运动预测、碰撞分析,乃至驱动机器人行动,对客观世界的理解才真正进入物理层面。物理感知帮助模型捕捉关键对象与状态,物理参数则将这些信息转化为可计算、可验证并可用于决策的依据。可靠的物理理解要求模型综合图像、视频、声音与语言,不仅识别物体,还要判断它们如何接触、发生了哪些变化,以及变化背后的物理原因。
近日,飞捷科思(Fysics AI)联合复旦大学认知与智能技术实验室(CITLab,原智能感知与无人系统实验室)共同开源全模态物理 AI 基础模型OmniFysics系列的两款新模型:面向物理过程理解的全模态视频描述模型OmniFysics-Captioner,以及采用4B参数规模的全模态物理理解基础模型OmniFysics-Nano-V2。前者将物理过程与因果信息融入视频描述,提升描述的深度与准确性;后者将物理属性和动态变化纳入跨模态判断,增强模型的物理感知与推理能力。在今年二月首次开源的基础上,两款新模型分别从“描述物理过程”和“理解物理规律”出发,共同推动更可靠的物理世界认知。
两个模型在国际权威的测评基准中一共取得了24项世界第一的优异性能:
OmniFysics-Captioner:在主流音视频描述基准上取得7项世界第一
OmniFysics-Nano-V2:在多模态与物理理解基准上(8B模型内)取得17项世界第一

OmniFysics-Captioner:为万物打上物理标签
普通视频描述往往围绕主要动作展开。但要理解物理过程,还需要知道哪个物体在运动、什么时候发生接触、声音是否和动作对应以及物体之后发生了什么变化。一段有价值的描述,应当让读者能够据此追问:发生变化的是谁,变化发生在何时,有什么观察支持这个判断。
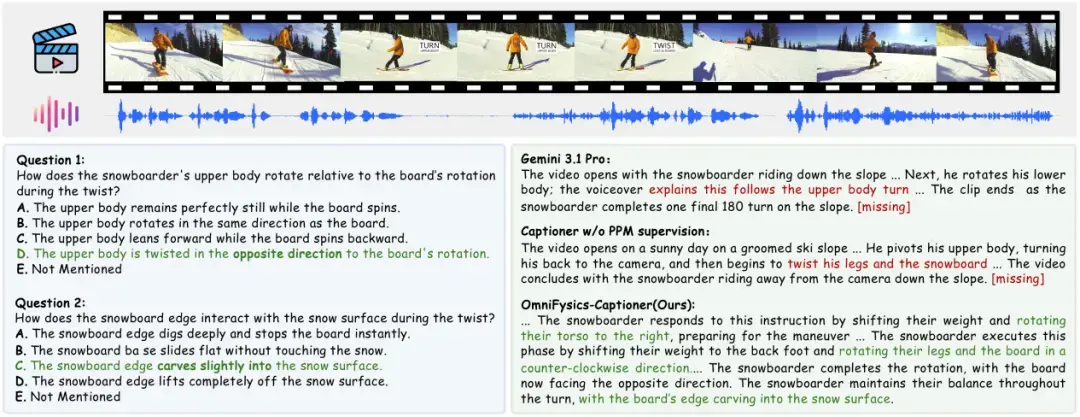
同一段音视频,描述是否保留运动关系与接触细节,会直接影响后续问题能否得到回答
作为一个能够理解物理过程的全模态视频描述模型,OmniFysics-Captioner直接读取原始视频和声音,把对象、动作、材料、接触关系、声音和状态变化组织成一段细致而连贯的描述。这样生成的文字不只是字幕,也是一份可以被追问、检索和继续学习的物理记录。“为万物打上物理标签”,把容易被忽略的关系写清楚,让现实视频成为更丰富的 AI 学习材料。

训练数据覆盖多类日常物理现象,记录物体交互、材料响应和状态变化等日常物理现象
复杂的专家观察被压缩成了一个可以直接工作的端到端模型,研发团队在数据构建阶段使用了OmniFysics-Agent,一套离线的“教师系统”:先找到视频中真正重要的物理片段,再分别调用声音、视觉和物理感知工具,核对关键时刻的证据。物理感知模型PPM会进一步判断对象、材料、接触、形变和状态变化,帮助生成更可靠的训练描述。经过训练后,OmniFysics-Captioner在被使用时不需要再调用这些工具,就能直接从音视频生成物理感知描述。
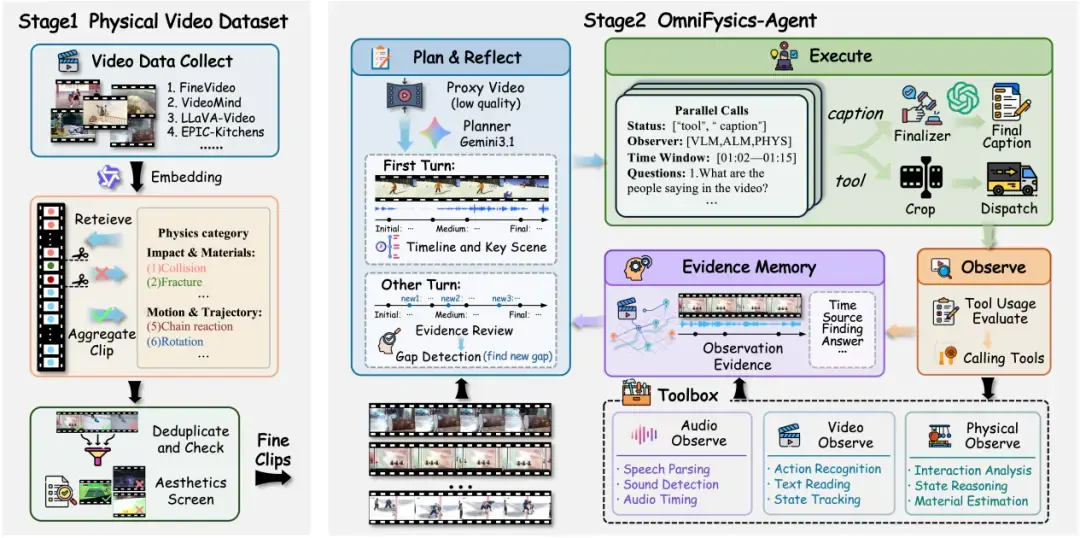
Agent 通过多专家观察生成高质量描述,用于训练最终的 Captioner 模型
在详细视频描述测试VDC Detailed上,OmniFysics-Captioner以57.9%的准确率领先全部对比方法。在三项利用描述回答问题的测试中,它均领先所比较的开源方法;其中Daily-Omni的成绩超过了最强对比基线 Gemini 3.1 Pro。团队还设计了专门检验物理信息的OmniPhysCap(OPC)基准测试,用1,000 段视频、8,000个问题检查描述中的事实。在其中的物理问题上,OmniFysics-Captioner 达到57.7%的准确率,相比最强对比基线高出9.9个百分点;普通音画问题的表现同样领先。进一步对照发现,仅改变训练描述是否包含物理感知工具提供的信息,就能让最终模型的物理问题成绩从53.1%提升至57.7%。这些结果表明,物理感知能够同时提升物理细节的表达与整体音画信息的保留,是增强全模态理解的重要能力。OmniFysics-Captioner的价值也由从生成视频描述,延伸到为模型积累更丰富的世界经验。
OmniFysics-Nano-V2:让全模态 AI 真正理解物理世界
如果说 OmniFysics-Captioner能够“看懂并讲清物理过程”,那么OmniFysics-Nano-V2则进一步回答了一个更关键的问题:如何从多模态观察中理解物理规律,并据此作出可靠判断。
OmniFysics-Nano-V2以4B参数构建统一的全模态推理框架,可综合处理图像、视频、音频和文本共4种模态信息,并支持文字与语音输出。它不仅能够识别场景中的物体与事件,还能感知质量、密度、材质、摩擦和恢复系数等静态物理属性,理解碰撞、滑动、反弹和形变等动态物理过程。更重要的是,模型估计的物理参数可以进一步通过物理仿真引擎进行联合优化与校准,这使AI从“描述物理世界”迈向“建模、预测并作用于物理世界”,为物理仿真、机器人操作和下一代Physical AI提供可落地的感知基础。
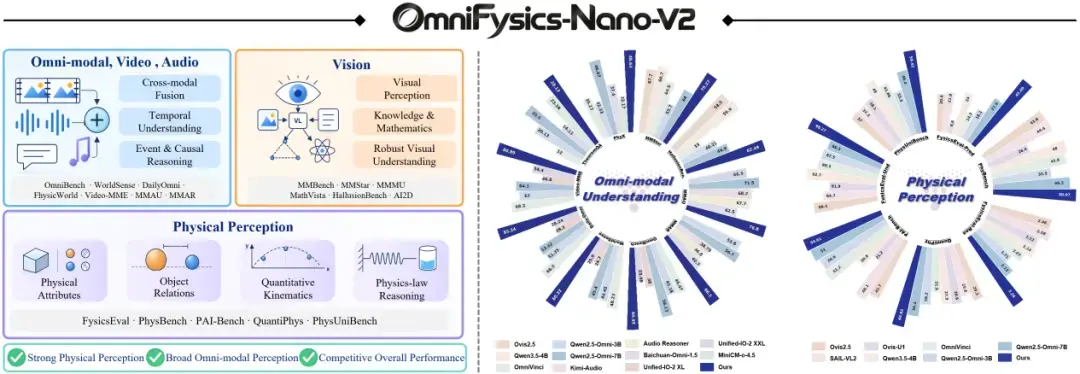
OmniFysics-Nano-V2在21项国际基准中,与8B以下模型对比取得17项SOTA
OmniFysics-Nano-V2的训练数据由静态物理属性与动态物理事件两部分构成。静态数据刻画材料、质量、密度和刚度等相对稳定的物体属性;动态数据则覆盖碰撞、摩擦、旋转、破裂与形变等交互过程。通过关联不同模态中的物体表征、运动变化和事件结果,模型逐步建立起从“物体是什么”到“具有哪些物理属性”,再到“在真实交互中将如何运动、受力和响应”的完整认知链路。

静态属性与动态事件共同构成 Nano-V2 的物理学习数据
在训练层面,OmniFysics-Nano-V2首先通过阶段化学习完成图像、视频、音频与文本的跨模态对齐,随后采用两阶段GRPO渐进式训练策略:第一阶段强化通用任务的答案准确性,第二阶段进一步引入细粒度物理感知与格式奖励,使模型不仅关注“答案是否正确”,还关注“是否捕捉到正确的物理属性、状态变化和推理依据”,推动训练目标从答案级优化迈向物理证据级对齐。在此基础上,OmniFysics-Nano-V2进一步与自研可微分物理引擎Fysics实现联动。模型估计的物理属性与参数被注入仿真环境,物理引擎通过状态推演和偏差计算生成反馈,并据此持续修正参数,形成“感知—估计—仿真—校准”闭环,让模型对物理世界的判断能够真正进入计算、验证与优化过程。
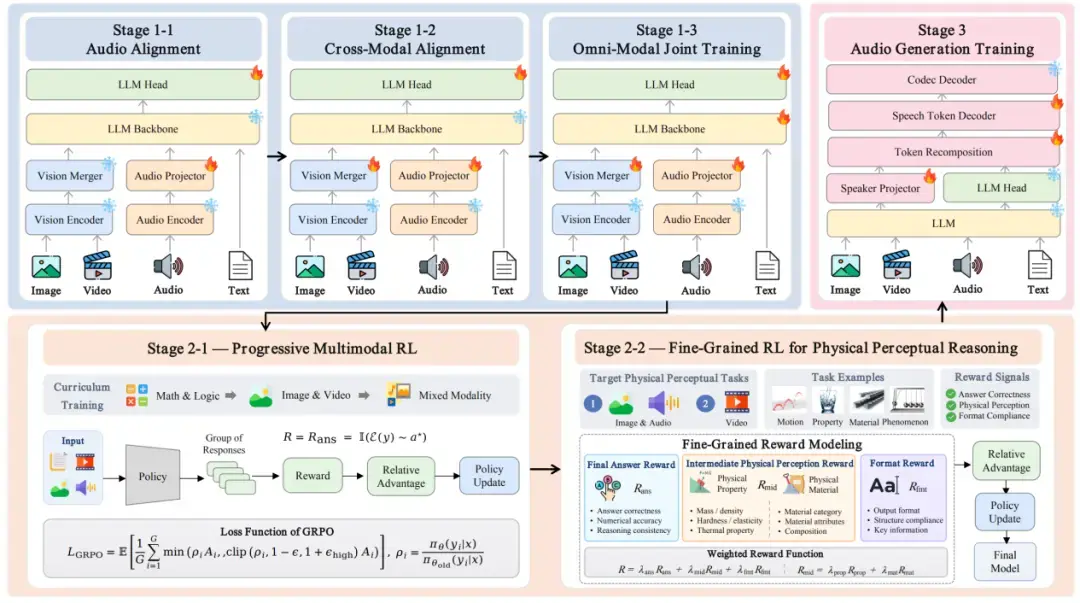
细粒度训练信号同时关注最终答案和支撑答案的物理信息
OmniFysics-Nano-V2 模型在国际通用多模态感知与物理理解的21项测评基准中与8B尺寸以下模型进行了充分对比,取得了17项第一的优异成绩:在聚焦物理理解的FysicsEval Understanding基准中,OmniFysics-Nano-V2取得98.27分,领先第二名5.57分;在PhysUniBench物理评测基准中取得了59.42分,领先第二名11.42分。在强化物理能力的同时,模型依然保持了广泛的全模态理解能力,在Daily-Omni和Video-MME上分别取得85.24分和80.89分,并在两项音频理解测试中超越部分7B全模态模型。
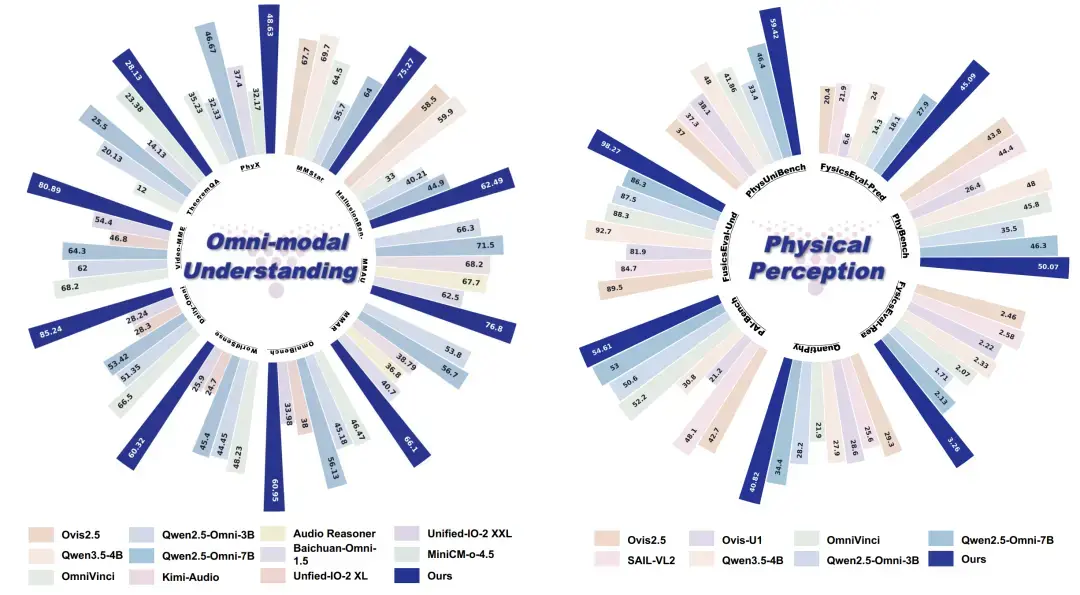
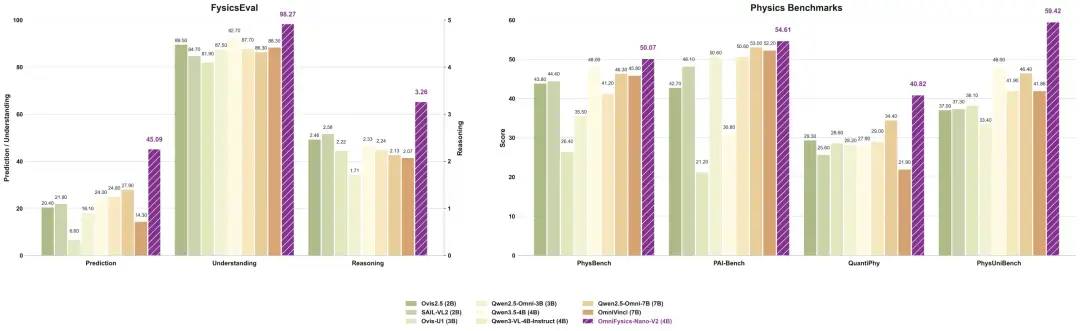

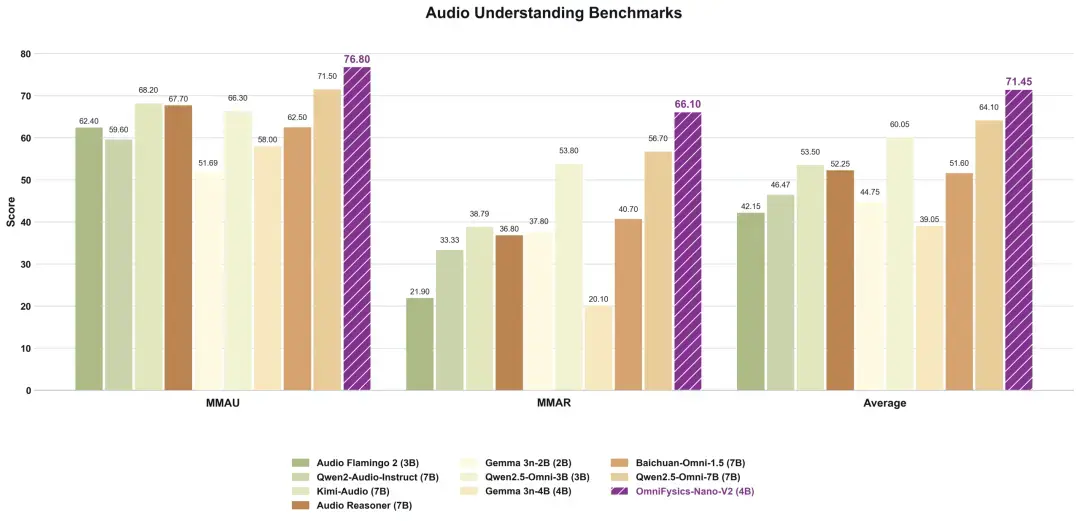
OmniFysics-Nano-V2多模态感知与物理理解能力测评结果
项目网页:
https://github.com/Fysics-AI/OmniFysics-Nano-V2
模型权重:
https://huggingface.co/Fysics-AI/OmniFysics-Nano-V2
共同铸就物理智能体的基石
OmniFysics-Captioner和OmniFysics-Nano-V2分别解决了物理智能中的两个关键问题:如何把现实世界中的物理证据保留下来,以及如何让模型利用这些证据进行判断。通过将上述能力与自研物理引擎Fysics以及具身机器人实现深度联动,模型可以从真实场景中估计关键物理属性,之后将其注入物理引擎实现高保真场景重建。基于重建后的可探索环境,具身模型开展仿真交互与策略学习,系统构建起从“环境感知—物理建模—仿真训练—真实交互—反馈更新”的完整闭环,推动具身智能持续自进化,使物理认知真正转化为具身智能的决策与行动能力。
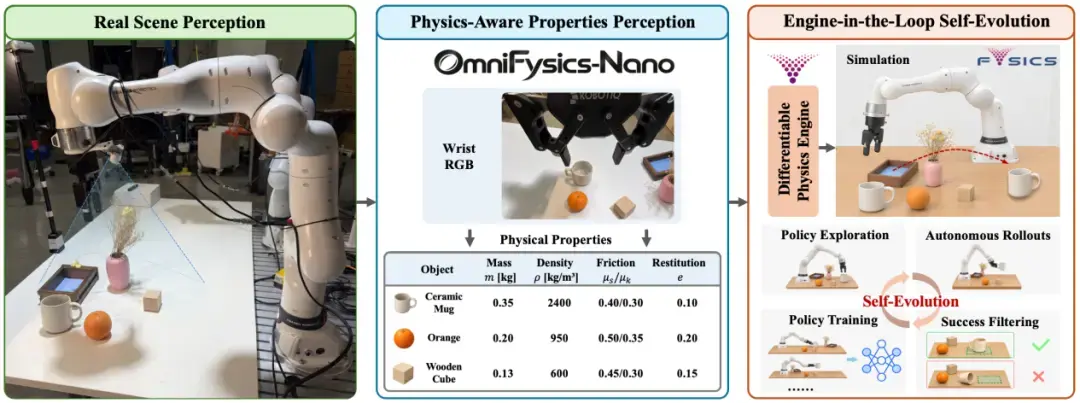
物理引擎在环:将模型的物理理解连接到仿真、策略学习和真实交互
在真实世界中进行观察,在物理引擎中进行扩展,模型将在不断的交互和对比中校准判断。作为专注于物理AI核心技术研发的科技创新企业,飞捷科思将逐步开放其自主研发生态技术体系中的重要模块,推动物理感知、重建、仿真和决策之间形成更完整的技术链条,为机器人、数字孪生、自动驾驶和智能制造等各类场景提供开放、可信的物理智能基础设施。从视频描述,到参数估计,再到仿真验证和真实行动,OmniFysics将逐步建立起一条通往物理智能的完整路径。
面向未来,飞捷科思将继续坚持关键技术自主创新,持续完善以自研Fysics可微分物理引擎、Fysiverse物理世界模型、OmniFysics全模态物理AI基础模型等为核心的物理 AI 基础支撑底座,深度聚焦具身智能与物理 AI产业化落地,推动具身智能与机器人在真实物理世界中的感知、推理与执行能力跃升,为产业上下游合作伙伴持续贡献物理AI核心技术与中国方案。