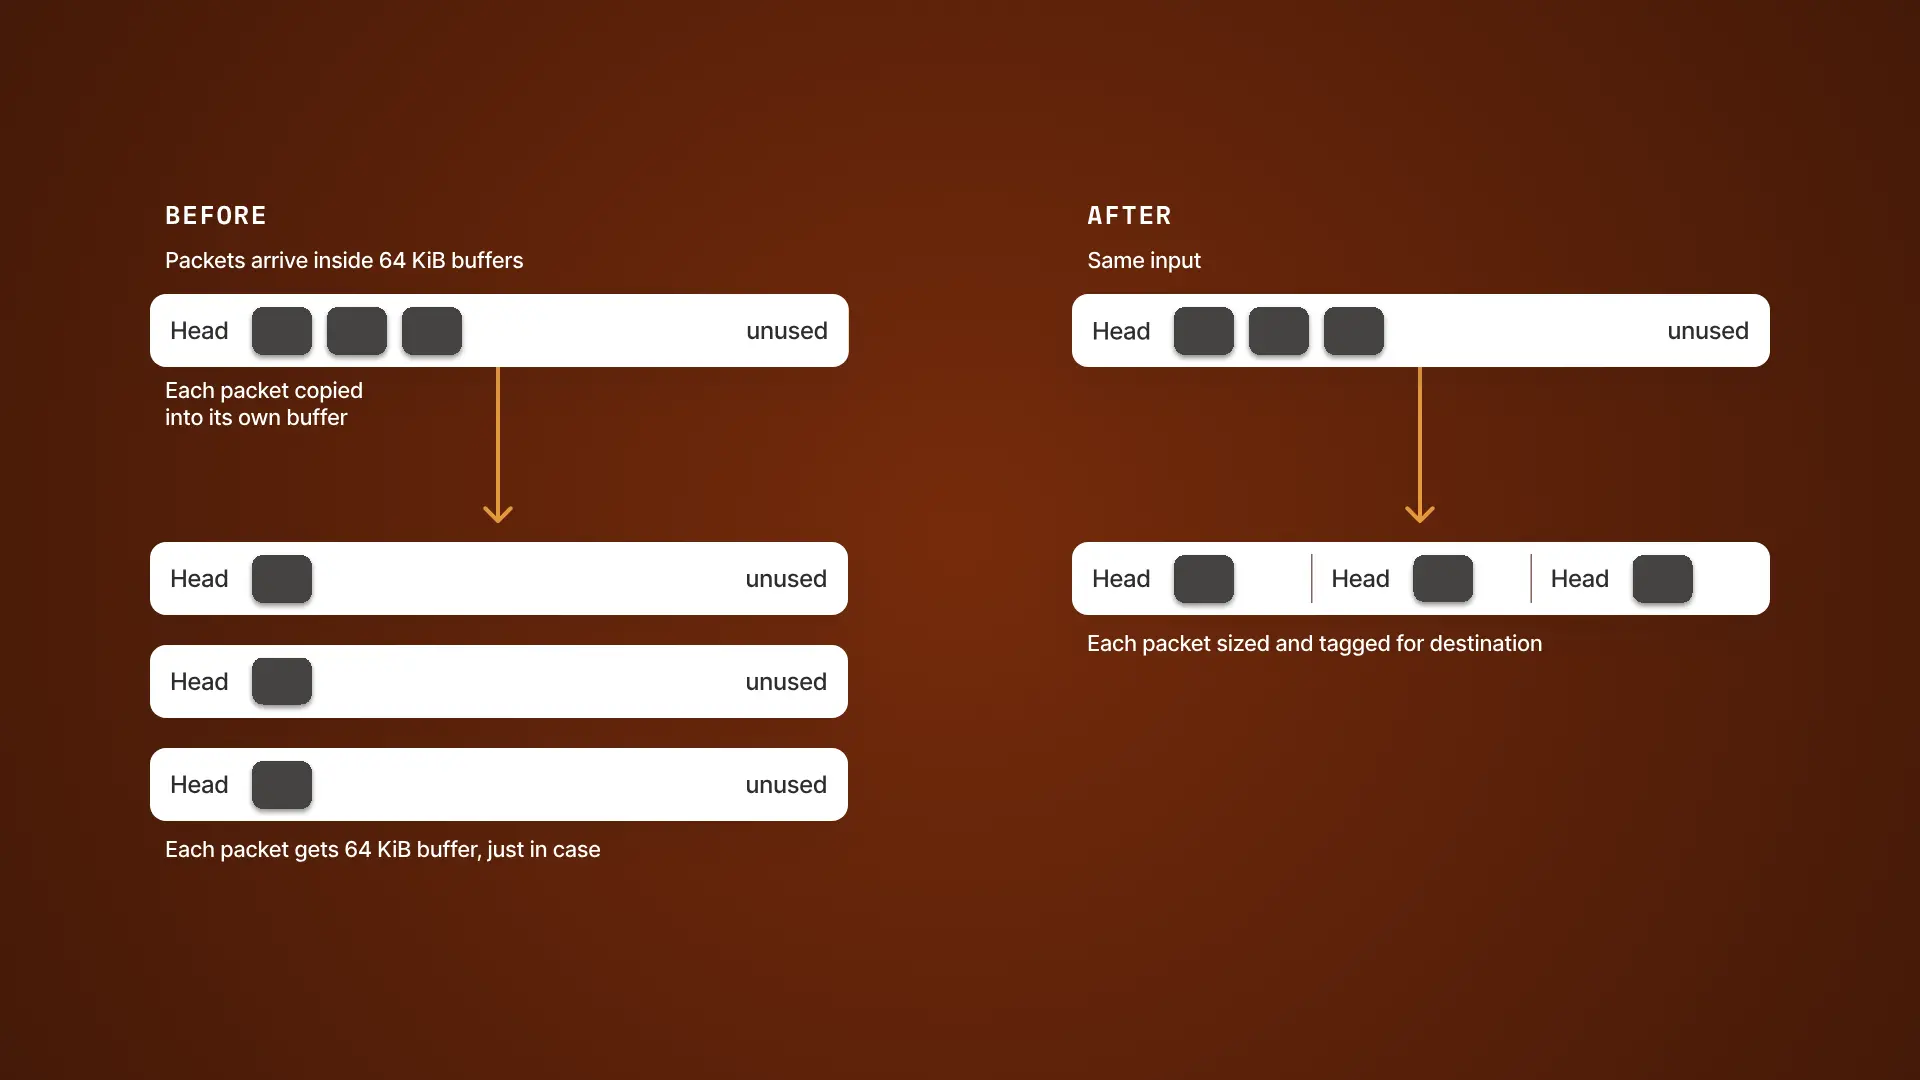
Tailscale 发了一篇性能工程博客,核心是一个挺反直觉的优化:大多数网络包只有 1 KiB,但为了用上 Linux 最高效的收包工具 GRO,Tailscale 得随时准备一次性接 64 KiB 的流量。问题出在 wireguard-go 只提供一种 64 KiB 的缓冲区来拆包——于是每个 1 KiB 的小包都得被复制进一个 64 KiB 的缓冲区,一次一拷贝。作者用集装箱海运打比方:港口、轮船、卡车都按一种箱型造,不管装多满。
解法不是继续在拷贝上修修补补,而是干脆不拷了。在 Linux 和 Android 上,现在让包留在它们落地的位置,只记录每个包在一大片读缓冲里的起止位置,而不是搬到新地方。小包在内存里保持小,多个包共享一次分配,还省了拷贝时间——仅此一项在很多网络配置下带来约 5% 提速。此外还缩短了包队列:测试显示队列本来预留的深度大部分用不上,队列短了意味着等待时间和内存开销都下来。省下的内存,转手贴给了最辛苦的节点——子网路由器和应用连接器。
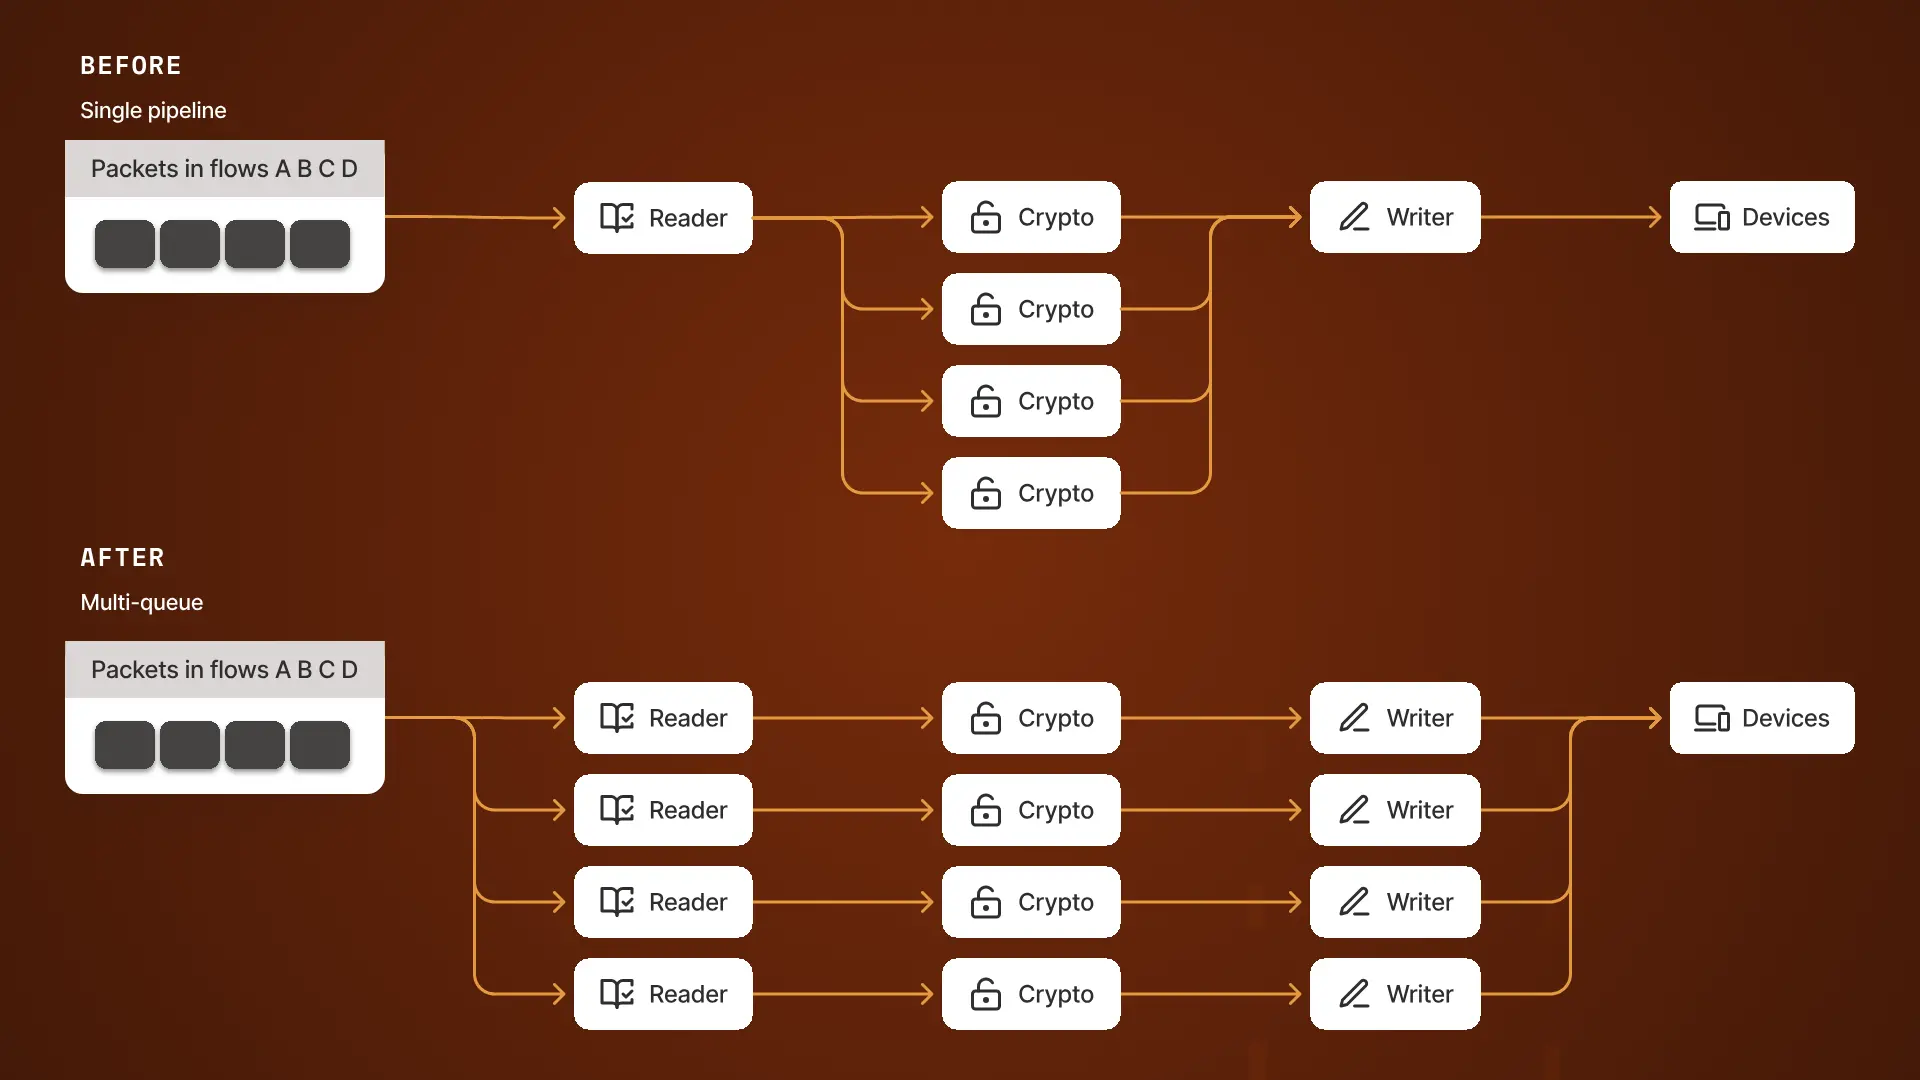
真正的大头是给子网路由器、应用连接器和出口节点上了多队列。以前这些节点把多条独立连接塞进一条有序的单线程流水线,因为接收端应用绝不能看到自己的包乱序,所以所有连接共享一条单车道。内存压力降下来后有余力实现多队列:一条流占一条车道,车道按机器资源而不是按 peer 数量来扩,并行跑满 CPU 核心。结果是聚合吞吐更高、收包到转发的延迟更低。App 连接器和出口节点服务的是大量短连接用户,提升尤其明显。Tailscale 工程师的原话是:这意味着更低的延迟,从网线上读到数据到交给内核,每一步都更快。
writev 和 netmap 缓存是另外两条。writev 让客户端一次把多段包数据描述给内核、不用先拷贝拼接,省拷贝省系统调用、吞吐更高。netmap 缓存则对付启动场景:设备启动通常先连控制平面拿网络地图(netmap),在烂 Wi-Fi 或过滤严格的酒店网络里这步可能卡很久甚至连不上。启用后每个设备在磁盘缓存一份 netmap,启动时先用缓存跟同网设备直连建隧道,再等控制平面。在控制平面差的环境里,热缓存启动比冷启动快一到两个数量级,对远离 DERP 服务器或控制平面的设备尤其值。不过它只在设备之前连过一次网、且有持久盘空间时可用,超大 tailnet 会因为更新缓存产生大量磁盘流量,SD 卡这类不耐写的存储最好别开。
时间表也给了:减少缓冲内存占用的改动(Linux/Android)预期进 v1.104 客户端;多队列、writev 的进一步吞吐收益在 v1.104 之后;netmap 缓存现在就是 feature flag,v1.104 预计默认开启,移动端在其后。博客末尾还抛了个开放问题——他们想做一个 Tailscale 原生的性能测试诊断工具箱,但认为现有性能工具普遍有「分发税」(测两端都得装软件)、工作流僵化、对 QUIC/HTTP3 支持差、也不懂 DERP 与直连的区别。这部分在征求社区意见。
来源: