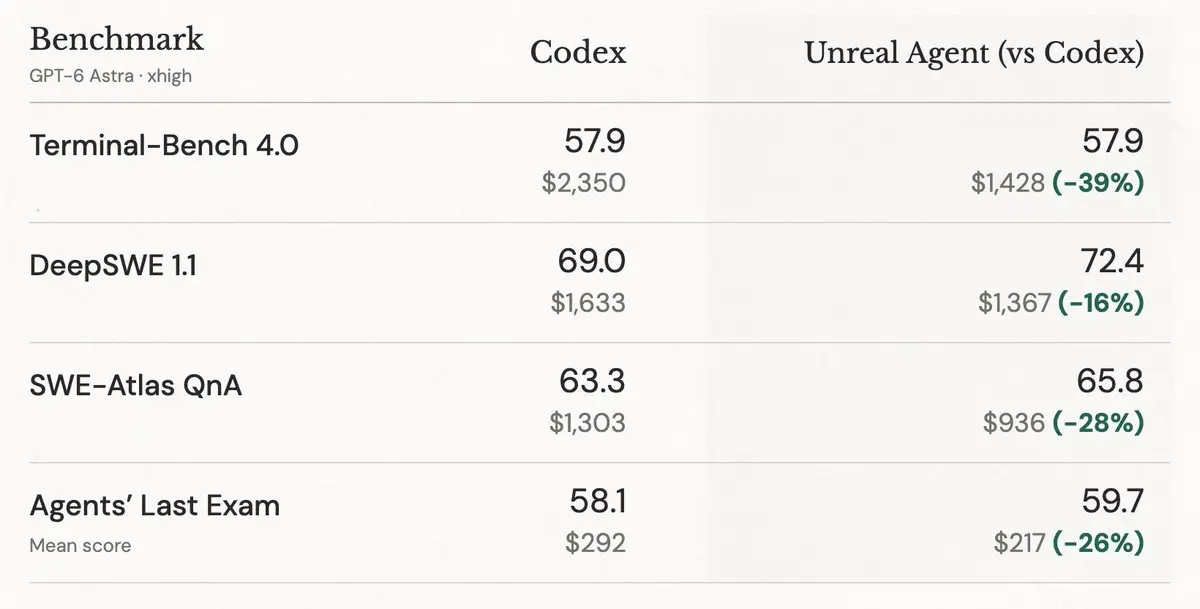
Unreal Labs 开源了自己的 agent 运行框架(harness),叫 Unreal Agent。核心卖点一句话:在真实生产工作负载和 coding/science 基准上,比 Codex 最多省 40% 成本,比 Pi 省 20%,性能没有任何下降。这家公司由 Sequoia 和 First Round 投资,创始团队来自 CERN、Meta、Snap、Bloomberg 和 DeepMind。
省钱的原理不是模型变小了,而是把常见的工具调用开销从模型身上挪走。他们在部署 agent 时发现,模型花了大量时间和 token 去管理工具调用——等结果、轮询、发心跳。Unreal Agent 的做法是把工具调用改成完全异步:每次给 LLM 发一个'工具已返回 in-progress'的事件日志,工具在后台继续跑,真正结束后再把结果追加进 session log,这时才调一次模型。
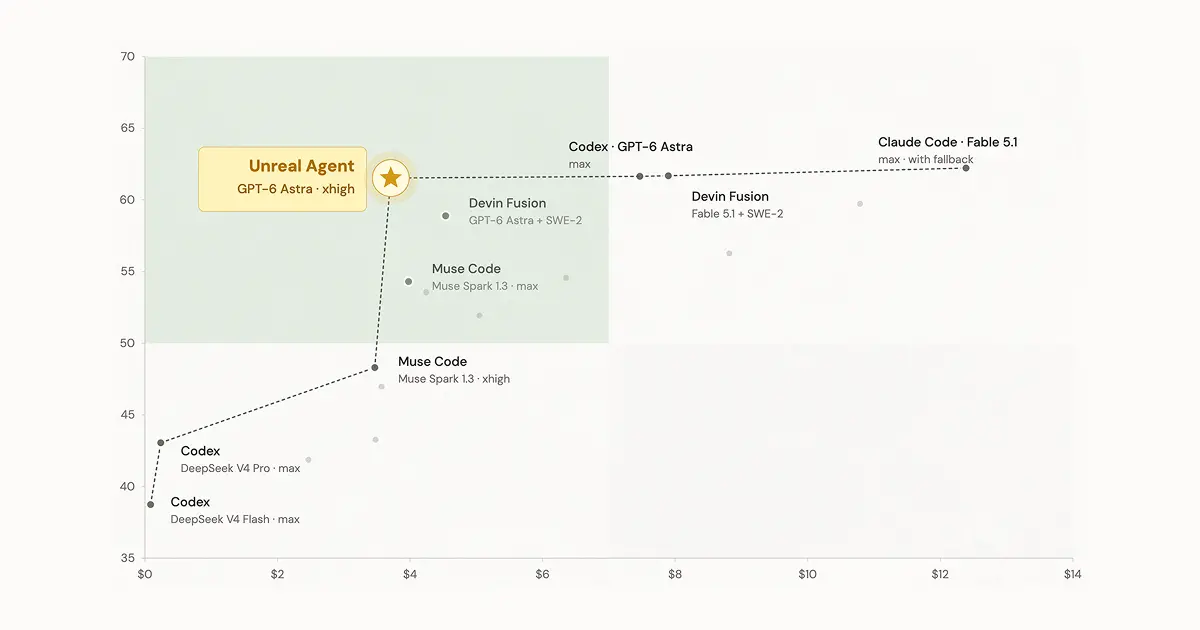
这个改动带来两个直接的好处。一是用户可以随时打断 agent 给它新的指令,不用干等工具跑完;二是模型两次调用之间能塞进更多的工具活儿,输入 token 就更省。他们特别提到,让'in-progress + final 两个工具结果出现在同一段上下文'这件事在 Responses API 里其实是欠规范的——在部分非 OpenAI 的推理供应商上会遇到拒绝,但这个模式一旦被接受,模型是能理解从运行中到最终结果的推进的。
他们引用的一个研究是 Matei Zaharia 等人(HarnessTax 团队)的《How Much Does Harness Matter for Coding Agents?》,核心观点正落在这里:对于 coding agent 而言,harness 本身的工程细节对成本和表现的影响可能跟模型选型一样大。他们也顺着这个概念把 harness 设计当成独立研究方向——除了那套异步模型,缓存友好是关键工程点,每次发日志都不能轻易破坏 prompt cache,这本身是个有趣的工程挑战。
基准成绩他们自己说'边际差异属于 benchmark 方差'——拿 GPT-6 Astra xhigh 跟 Codex 和 Pi 对比,Terminal-Bench 4.0、SWE-Atlas Codebase QnA、DeepSWE 1.1、ALE-CLI 都跑了,完整的通过率和均分在博文里可查,跑分用的 Harbor 平台方便复现验证。注意:这些用例没有挂在 Harbor 上面,是附在博客底下的链接。
目前 SDK 提供 Go 库(可直接集成进代码库)、类似 claude -p / codex exec 的 runner 可执行文件,以及兼容 Harbor 的 benchmark runner,GitHub 仓库已公开。背景信息:Unreal Labs 是一个 AI 原生产品工作室,之前做过 Agent Sales 这类 agentic 产品,还运营着一个研究博客,9 月初刚发过一篇讲 KV cache 经济性的文章《(KV) Cache Rules Everything Around Me》。
来源: