Interconnects 的 Nathan Lambert 最近被请去给美国国会议员做了个简报,主题是开源权重模型的现状——放在中美竞争的语境下。他把讲稿整理成文发表了,这大概是目前对"开源模型权力版图"最系统的一份第三方评估。一句话结论:中国实验室已经稳坐开源权重生态的头部,美国开源权重模型全线落后,而这还叠加了经济价值拐点的到来。
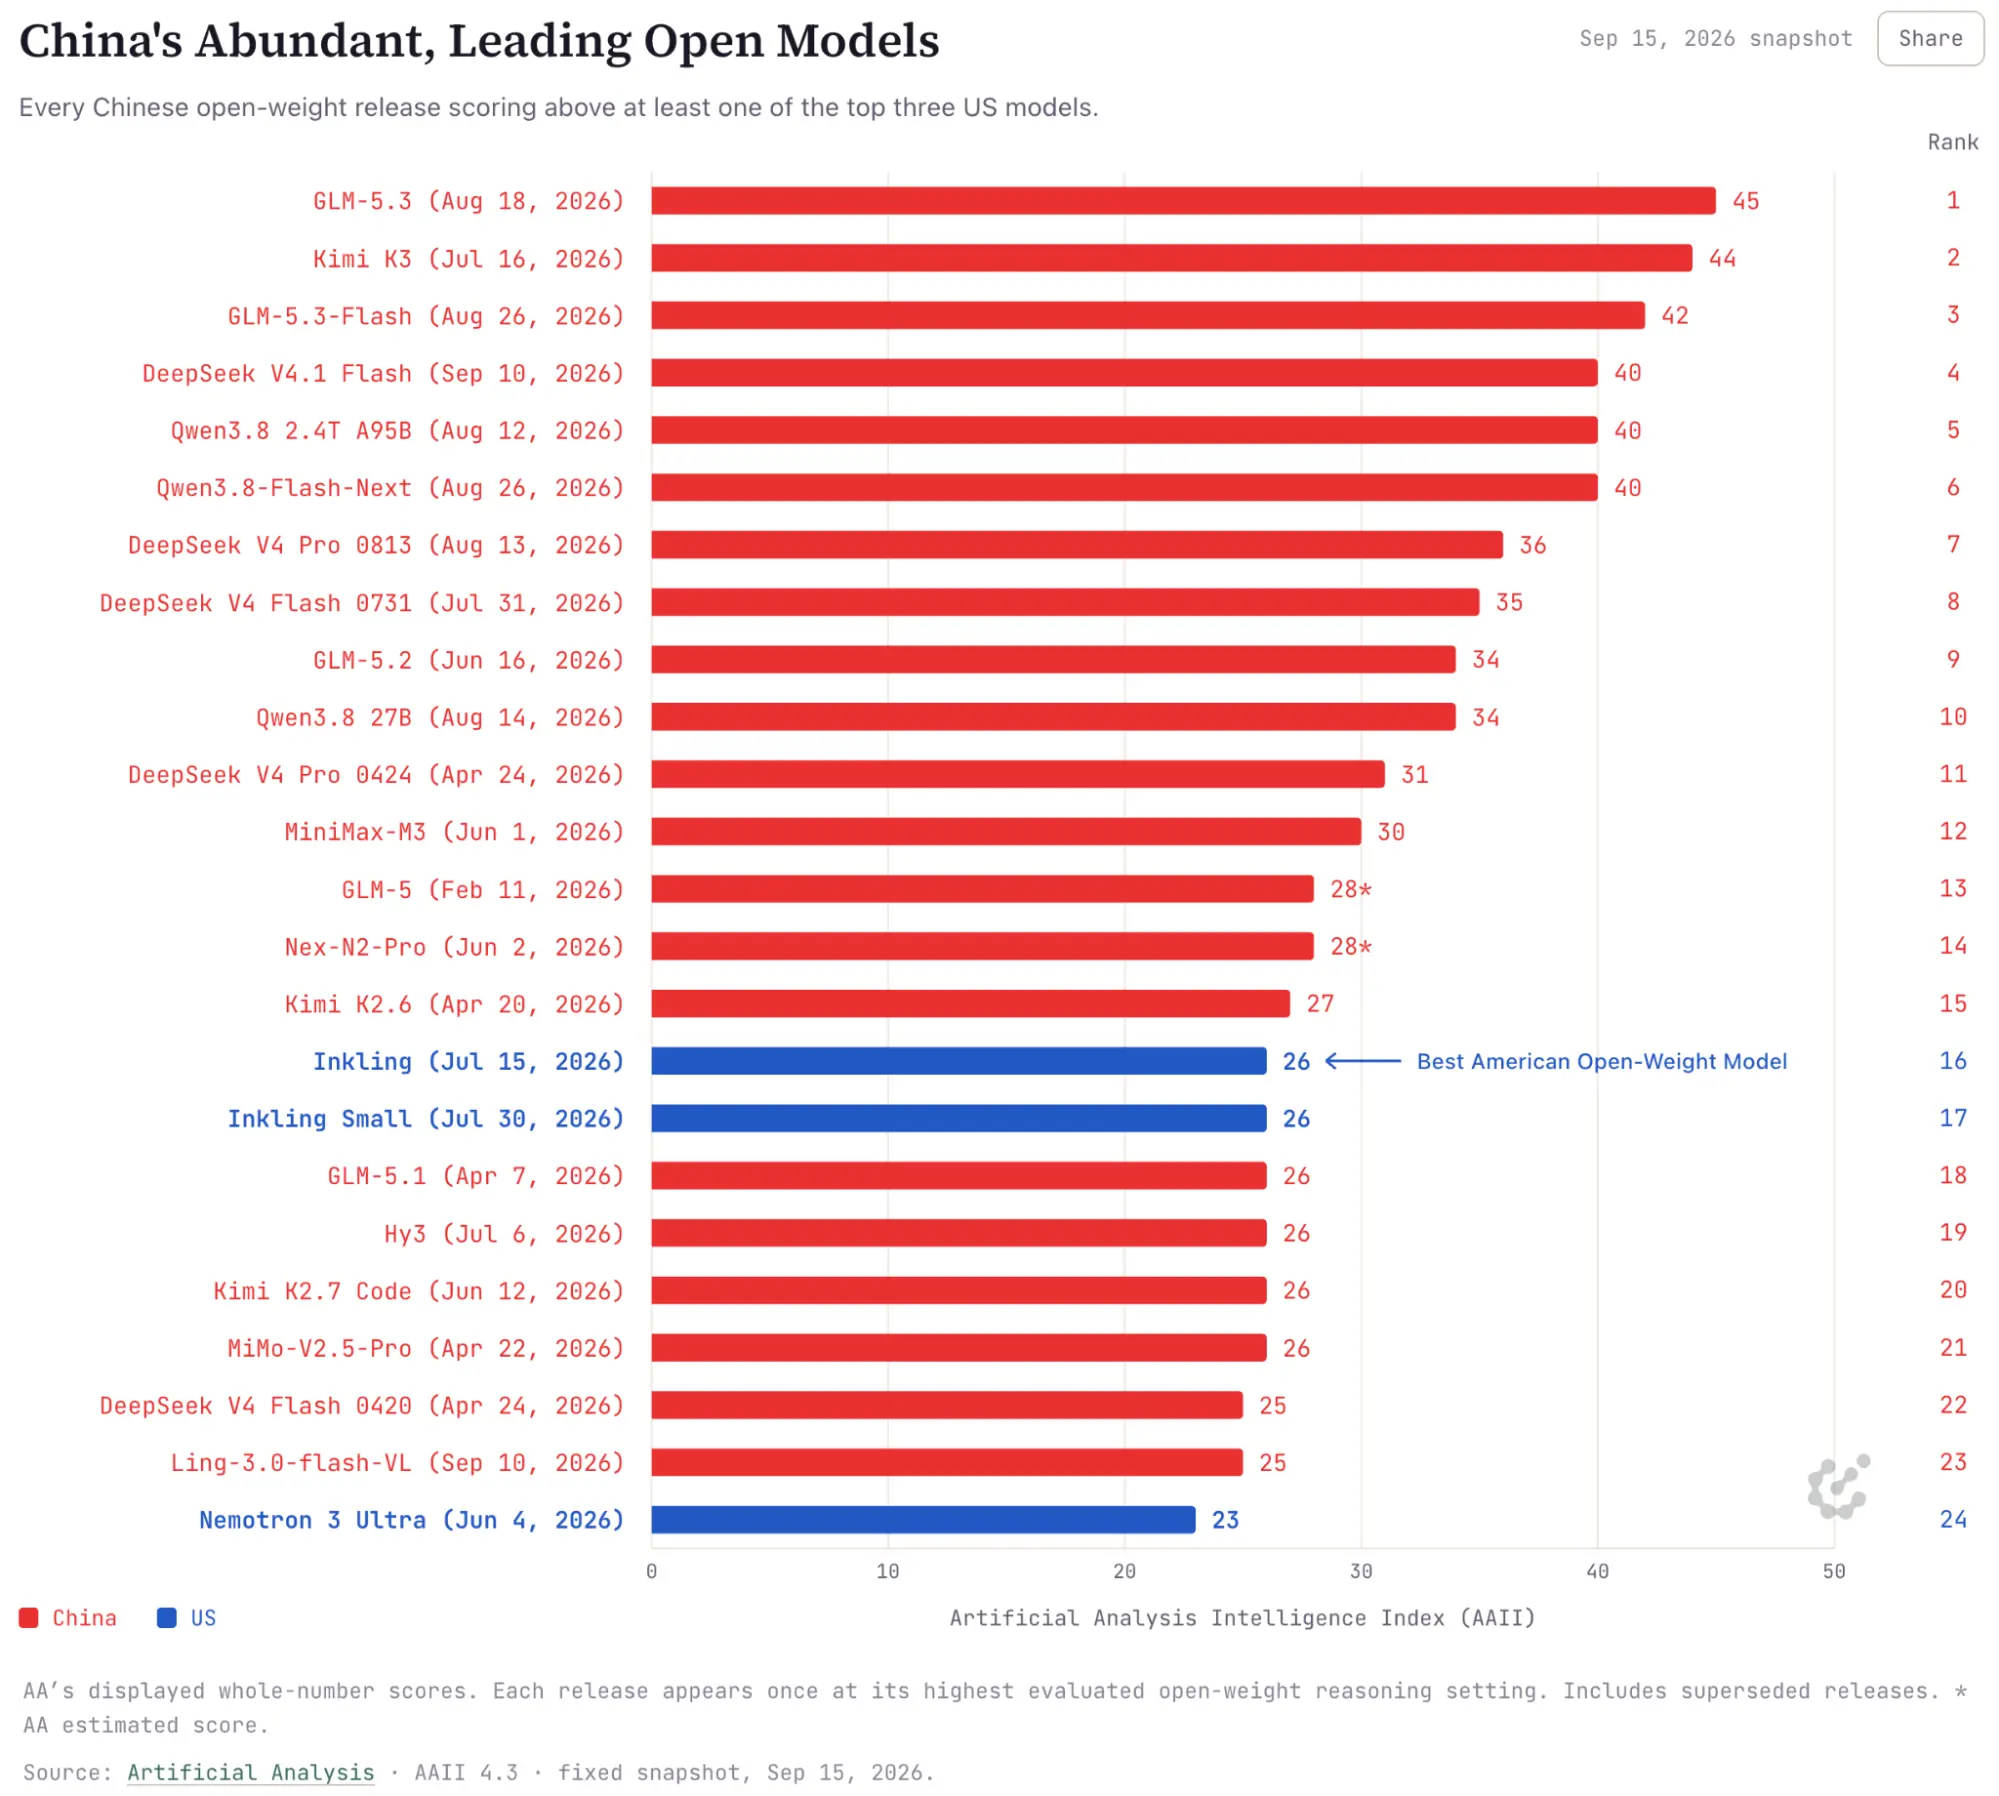
数据从三个维度看。第一是下载量。Hugging Face 下载数里,中国自 2025 年 7 月靠 Qwen 登顶后一路拉开差距,如今累计 32 亿次下载、是美国的整整两倍,领先约 16 亿。第二是能力基准。Artificial Analysis Intelligence Index(AAII)上,截至 2026 年 9 月 14 日,得分前三全是中国的:Z.ai 的 GLM-5.3 和 GLM-5.3-Flash、月之暗面的 Kimi K3。美国最好的开源模型——Thinking Machines 的 Inkling——排在中国至少 15 个模型之后。
换算成跟闭源前沿的差距更直观:中国开源权重模型大约落后美国闭源前沿 2-5 个月;美国开源权重模型自己却要落后 OpenAI、Anthropic 大约 6-9 个月。差距在 agentic 编码这类需求明确的领域最近,在物理、生物这类开放式科学任务上最远。Lambert 认为 GLM-5.2 和 Kimi K3 已经把开源模型的商业可用性推进了一个台阶——agentic 能力越过了 Anthropic 的 Claude Code 在 2025 年 12 月跨过的那道门槛。
学术圈是更隐蔽但更深远的第一战场。他扫了 arXiv 五个最热门 ML 分类的全部论文:提到任意开源模型的论文占比从 2023 年 1 月的 2% 涨到 2026 年 9 月的 50%,LLM 事实上成了 ML 研究的基础层。而这个基础层的"地基"是阿里的 Qwen——目前提到中国开源模型的论文超 40%,高于美国的 30%,其中 Qwen 独占 30%(Llama 掉到 21%),且中国份额还在快速增长。他当过 Olmo 的核心开发者,这个观察很有分量。
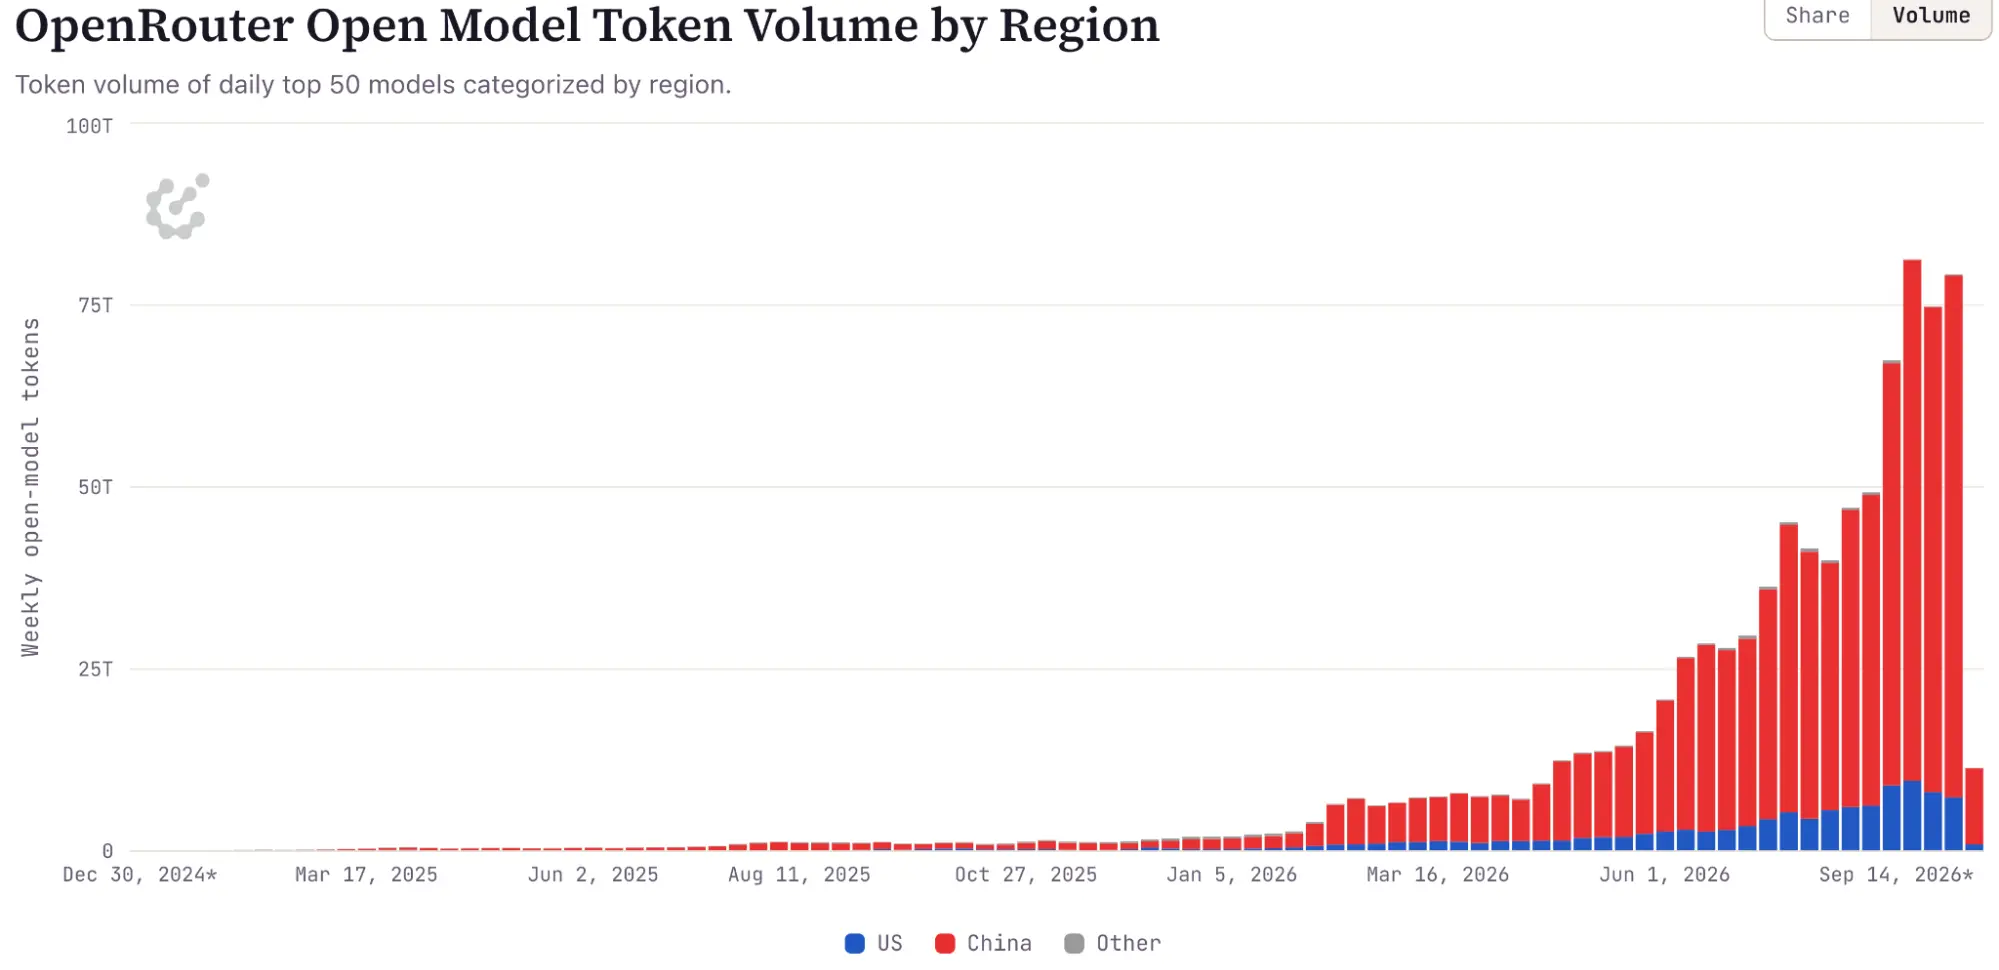
下面是商业落地。OpenRouter 上开源模型单周处理量从 2025 年 9 月的约 1T token 涨到今天的约 80T token,其中中国模型从约 70% 一路占到 80% 以上。Harvey、Cursor、DoorDash 用 Kimi,Airbnb 用 Qwen,Perplexity 用 DeepSeek——这些名字只是冰山一角,更多硅谷创业公司为了低成本、高灵活度接中国模型。他说这是一种过去职业生涯里没见过的新型跨境技术合作:美国创业公司直接和中国模型实验室签企业协议。
关于蒸馏,他明确泼了冷水:中国实验室蒸馏美国模型解释不了全部故事。蒸馏在全新领域最有效,但做不出一个全能强的成品模型。他估算就算彻底禁止蒸馏(比如 OpenAI、Anthropic 上 KYC 工具),中美差距也只会扩大 1-2 个月。真正的原因更像工作文化差异加迭代速度——中国实验室发得更勤、聚焦的任务分布更窄,而所有实验室都在进步,发得晚本身就占便宜。
最值得琢磨的是他给美国提出的建议。开源权重模型几乎无法阻止落入坏人手里,但真要限制对中国最强模型的访问,受挫的反而是美国企业——他举的例子很讽刺:Hugging Face 当时分析那场网络攻击,靠的正是中国开源模型,因为闭源模型拒绝回答。所以他的结论是:与其想堵,不如继续投入美国本地开源生态,让美国自家握有开源模型的"所有权",才能在全球层面协调和准备风险。这话在美国政治语境里相当敢说。
来源: