GitHub 上有人把 TypeSafe 创始人 Diogo Almeida 的那份《Jev 工程学》设计笔记做了完整中文翻译,连原结构带七张插图一起保留。翻译者自称与 TypeSafe 无隶属关系,是独立汇编。对国内开发者来说,这大概是第一次能无障碍读 Jev 那套"为 coding agent 而作"的完整蓝图。

整份笔记从一个问题开场:如果语言模型没有 KV cache,你会怎么设计 coding agent?这不是个无聊的脑筋急转弯——KV cache 正是当前 agent 被建成"只追加对话记录"的根本原因。复用已缓存的上下文前缀很便宜,但只要改动上下文靠前的东西,缓存就失效,模型被迫重新处理之后的一切。笔记管这叫"KV cache 的暴政",而这个单一的经济事实,塑造了当今几乎所有 agent 的设计决策。
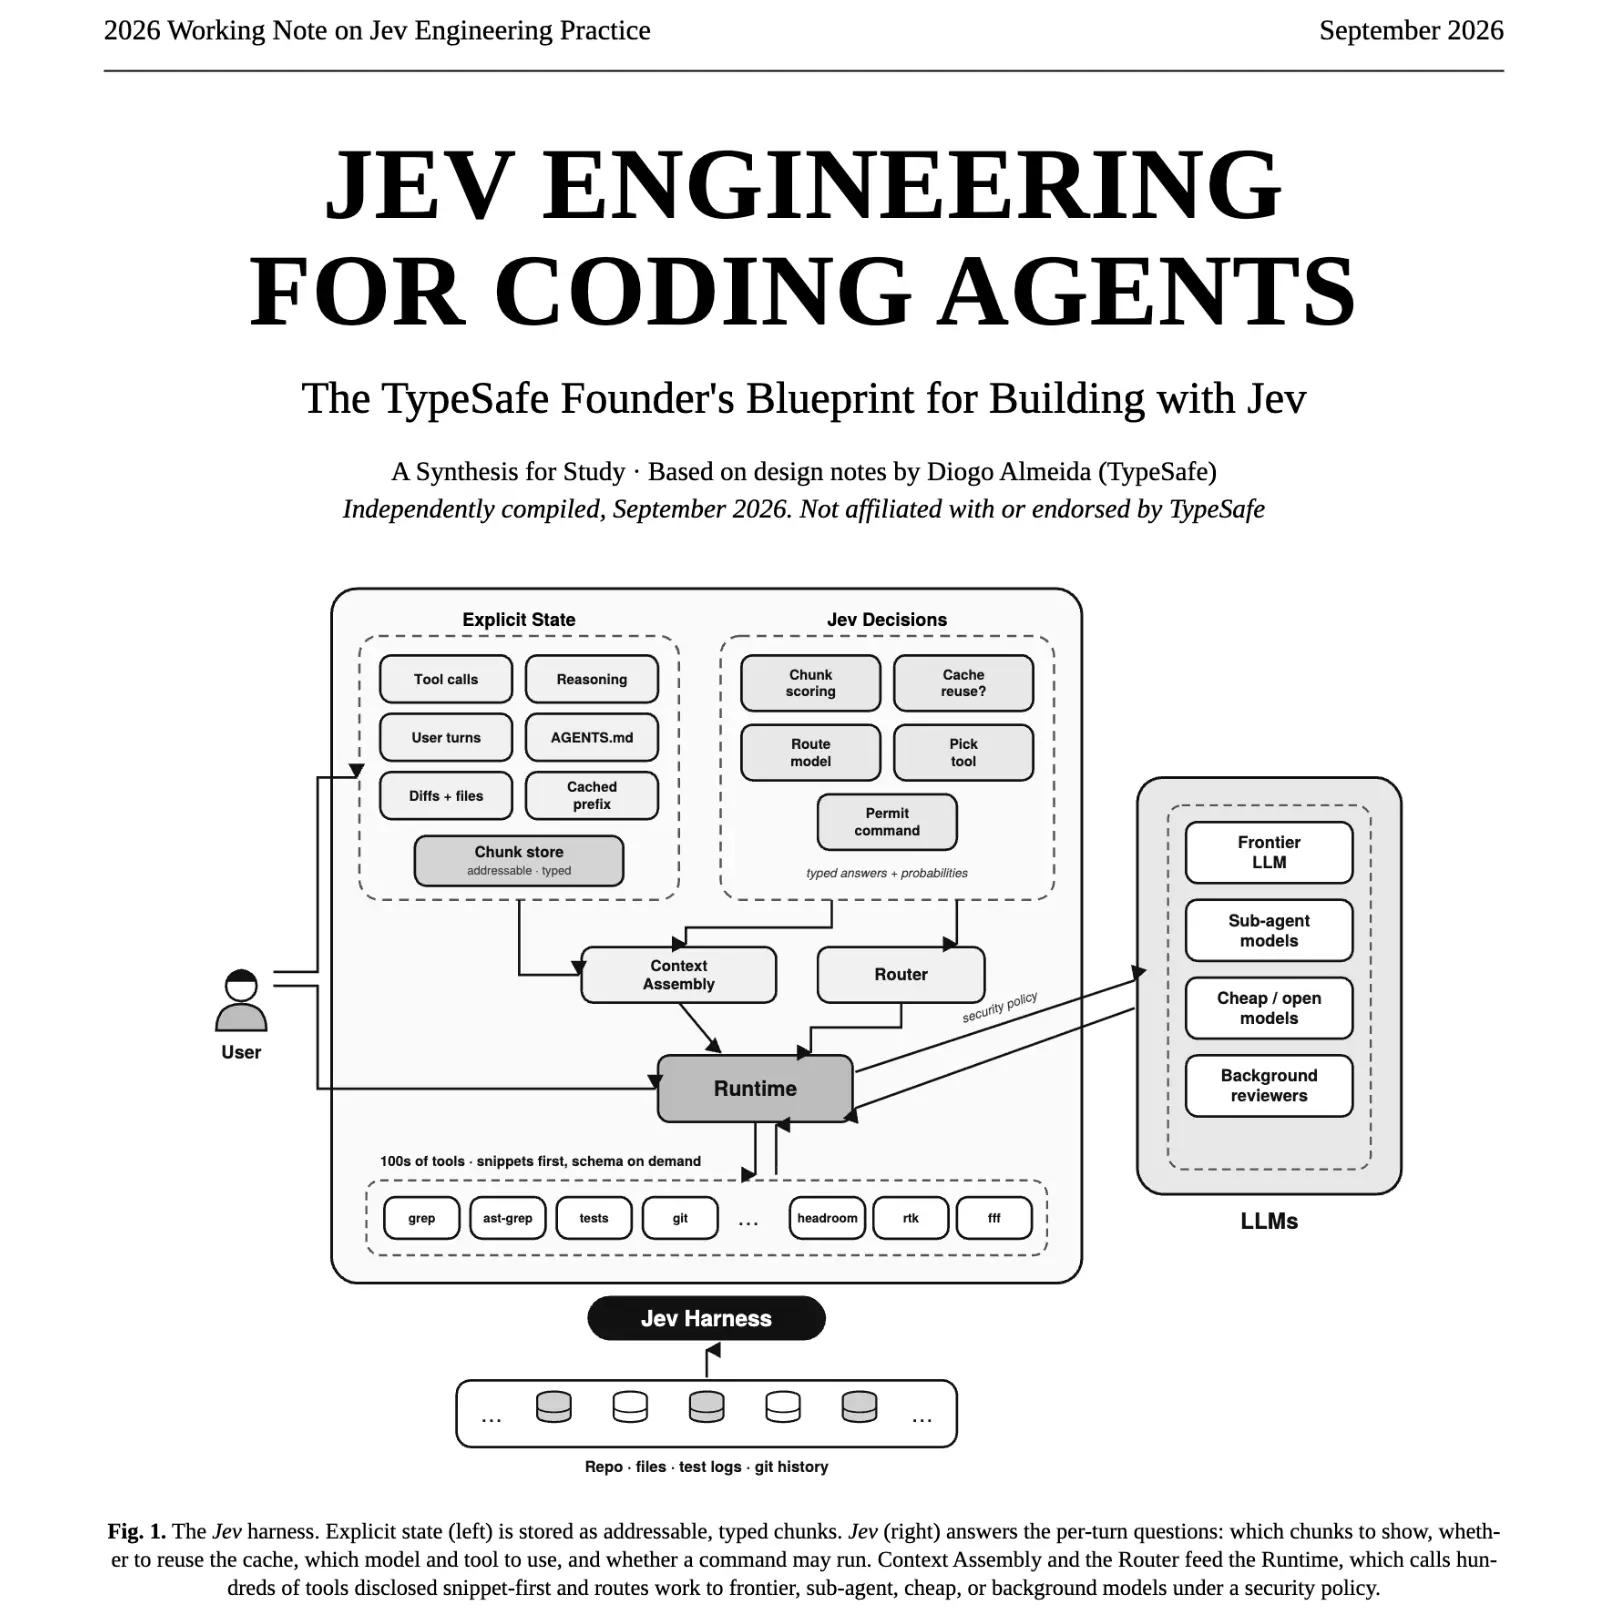
把缓存拿掉,暴政的六个症状就一览无余:
- 交还给大模型的混合路由反而更贵;
- 工具 schema 必须常驻系统消息挤占上下文;
- compaction 在"不知道下一个问题"时就盲压缩,丢的常常是后面需要的;
- 子 agent 因为上下文传递的决策又贵又易错而几乎不用;
- 重启把坏状态和好状态一起扔掉;
- 每个内置"电池"都永久消耗上下文,逼你在易用和强大之间二选一。
笔记最扎眼的一个数据点关于 token 到底花在哪。它估算典型 CLI coding agent 会话里,读文件占 30–40%,搜索 10–18%,命令输出 10–20%——写和编辑代码只占 4–10%,是众多开支里最小的一项之一。换句话说,coding agent 存在的理由,恰恰是最便宜的。微软 fastcontext 项目的独立数据也指向同一方向:在 GPT-5.4 轨迹里,读取和搜索占了所有工具调用轮次的 56.2%。如果这能推广,编码 agent 最大的效率收益不在更好的模型或 diff 格式,而在更聪明的检索。
Jev 在架构里的位置是关键:它不是写代码的模型,而是旁边那层决策层。harness 把当前应用状态(目标、上下文、规则、可用动作、之前的动作)和一个预定义问题交给 Jev,Jev 返回类型化答案——choice、score 或 noul,各带概率。因为输出是类型化的而非自由文本,harness 能验证它、施加阈值、基于它分支,而不必解析散文。每个会话被问上千次,那些小决策才是杠杆所在。
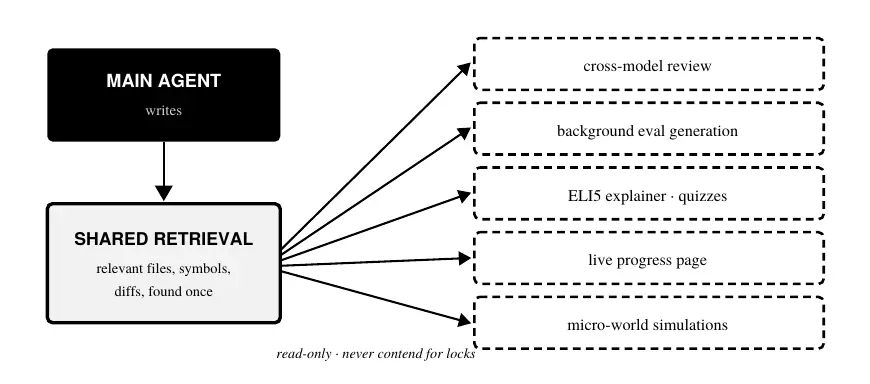
由此展开的替代架构处处反着现有思路来:上下文块按查询逐个打分而非一路累积;路由把"重新处理的成本"计入定价,按 token 定价而非按上下文重建定价;工具用"三级披露"——先给一张廉价的全局地图,只为选中的东西付细节的钱,用完即丢;AGENTS.md 从全量加载改成按条件加载,改前端就加载风格指南,进子目录就加载那个目录的坑文件。
对正在亲手搭 coding agent 的人来说,这份笔记的价值在它把"上下文工程"拆成了可操作的设计决策,而不是抽象的口号。翻译版在 yibie/jev-engineering-zh,源目录里还保留了作者原始的手记笔记,和汇编版对照读,能看到从灵感碎片到成型架构的加工过程。
来源:
- 《Jev 工程学:为 coding agent 而作》完整中文翻译 - https://github.com/yibie/jev-engineering-zh