SpaceXAI(改名的 xAI)发布了 Grok 4.7,官方口径是"最擅长编码和知识工作的模型"——比同级模型快两倍、便宜一半。这句话与其说是技术宣言,不如说是价格战的开场白:它和 Grok 4.6 同价同步,直接对标的就是 Claude 那几家。
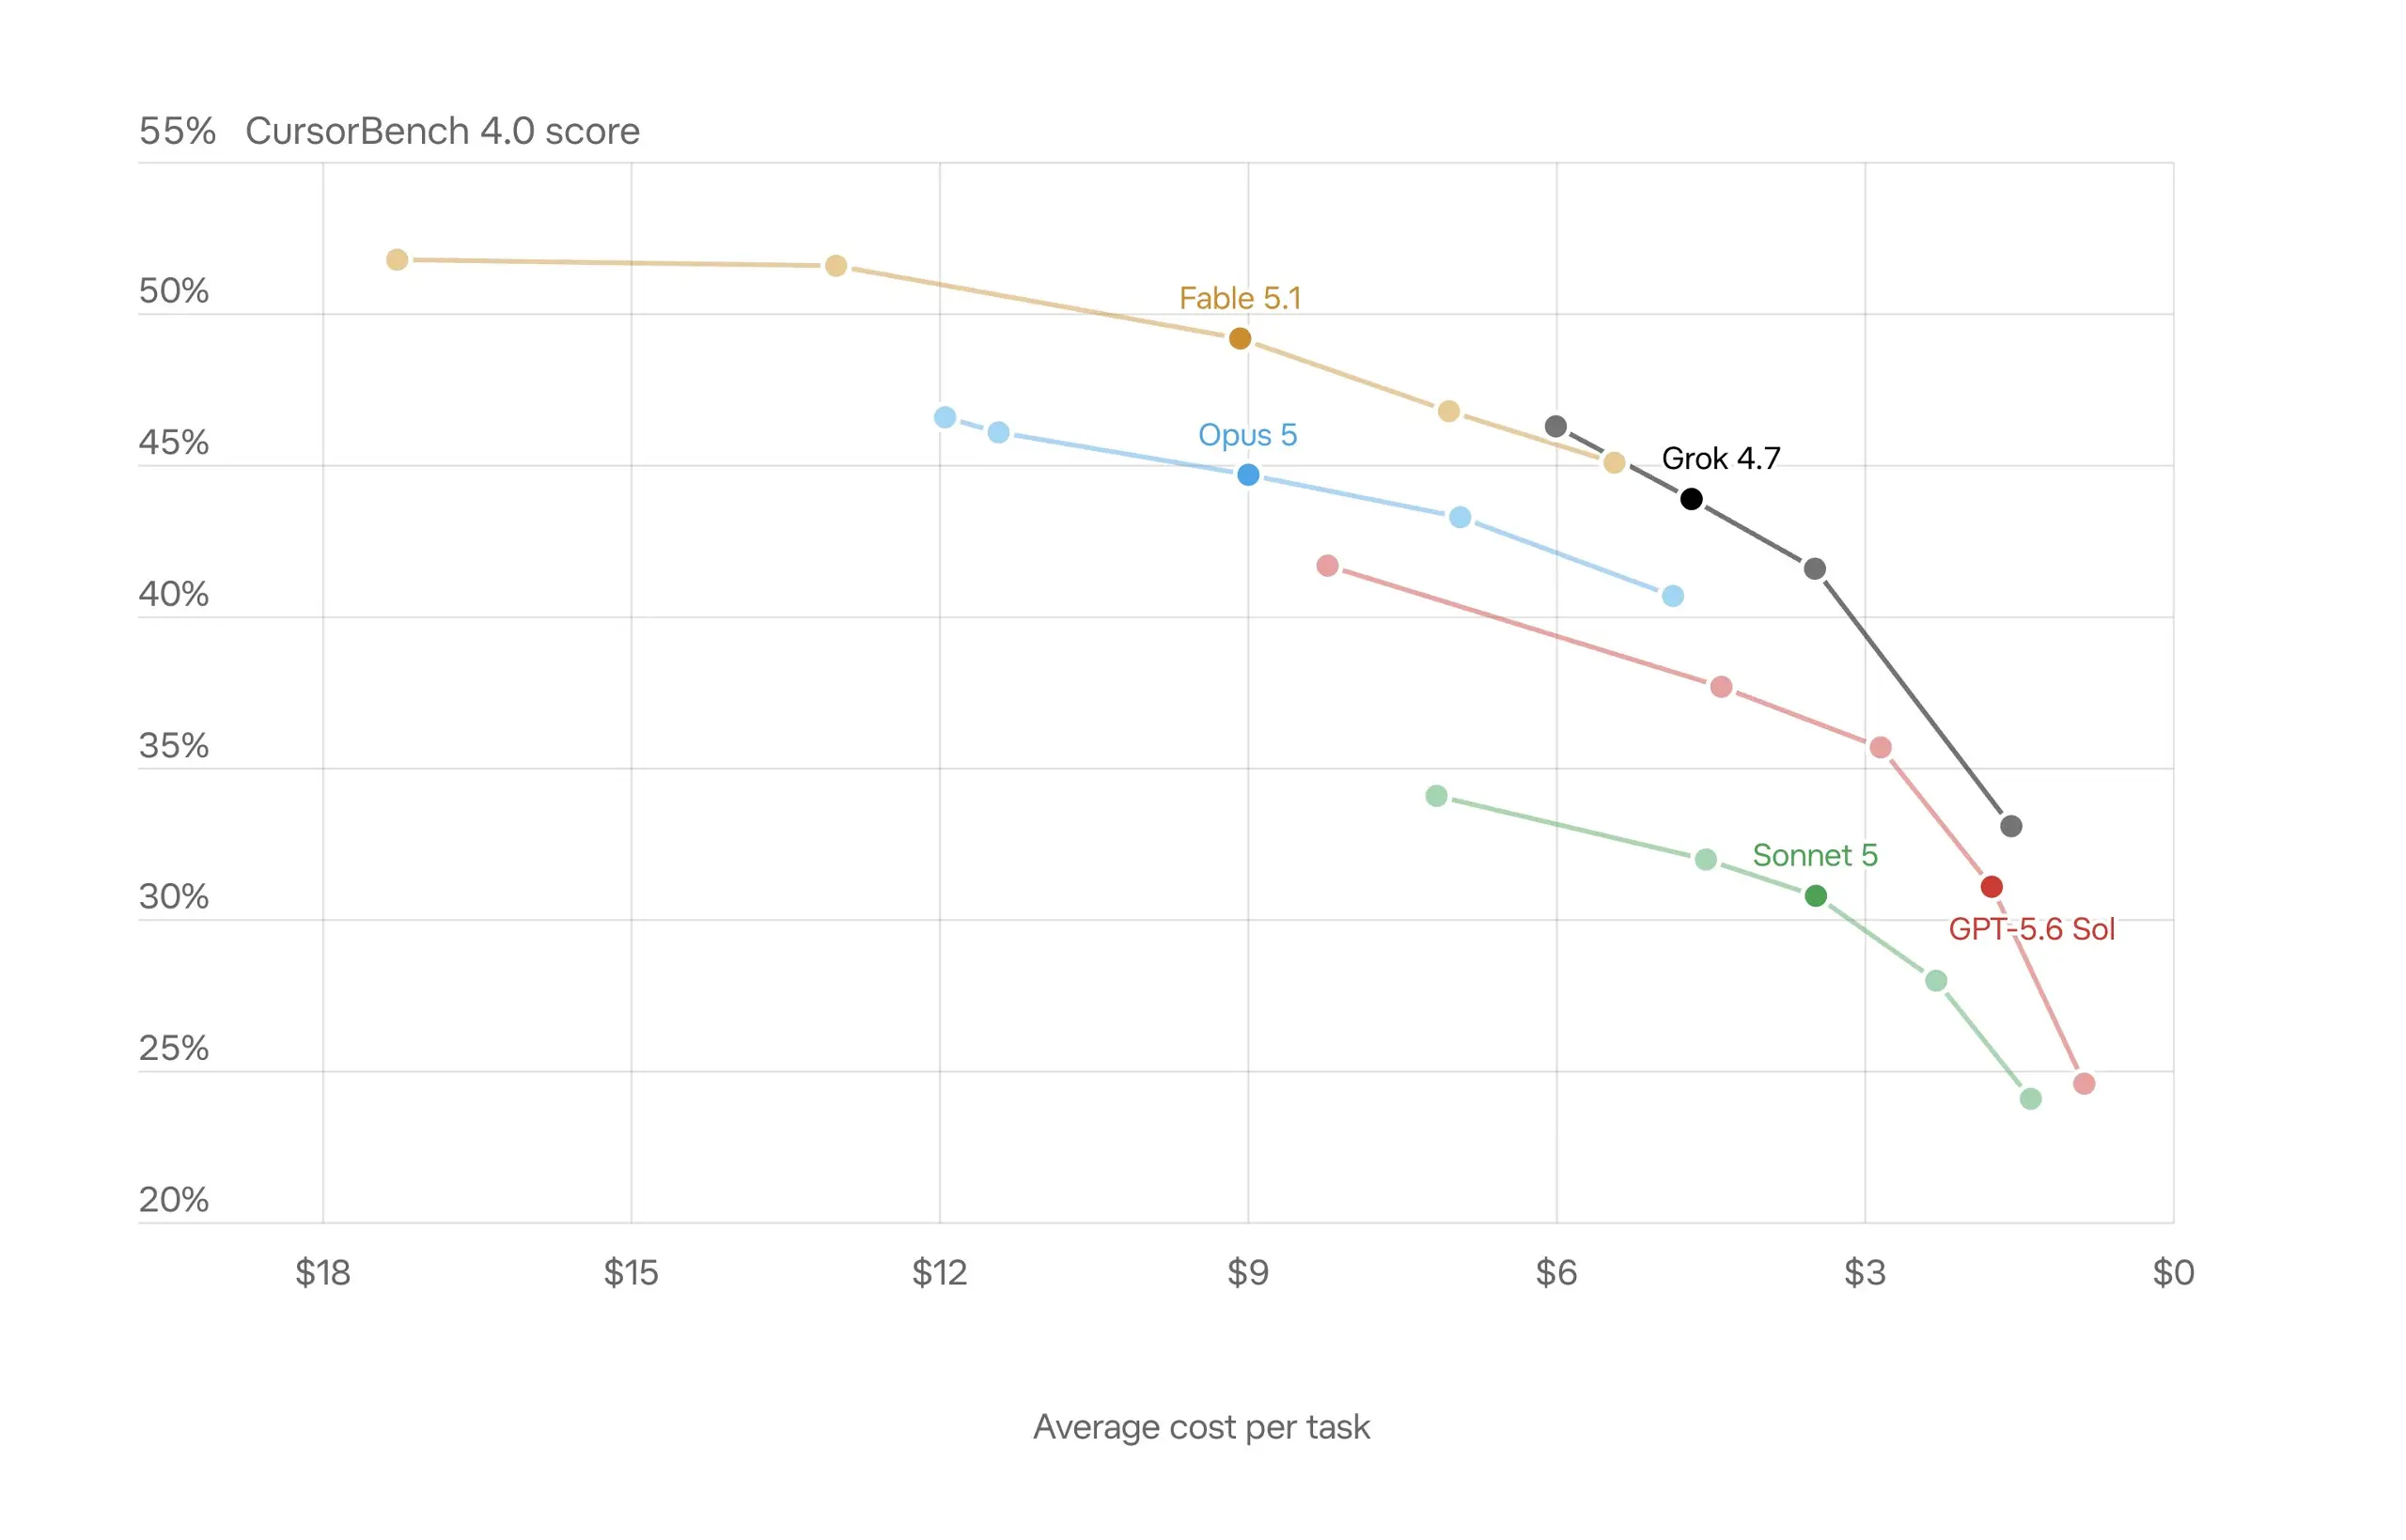
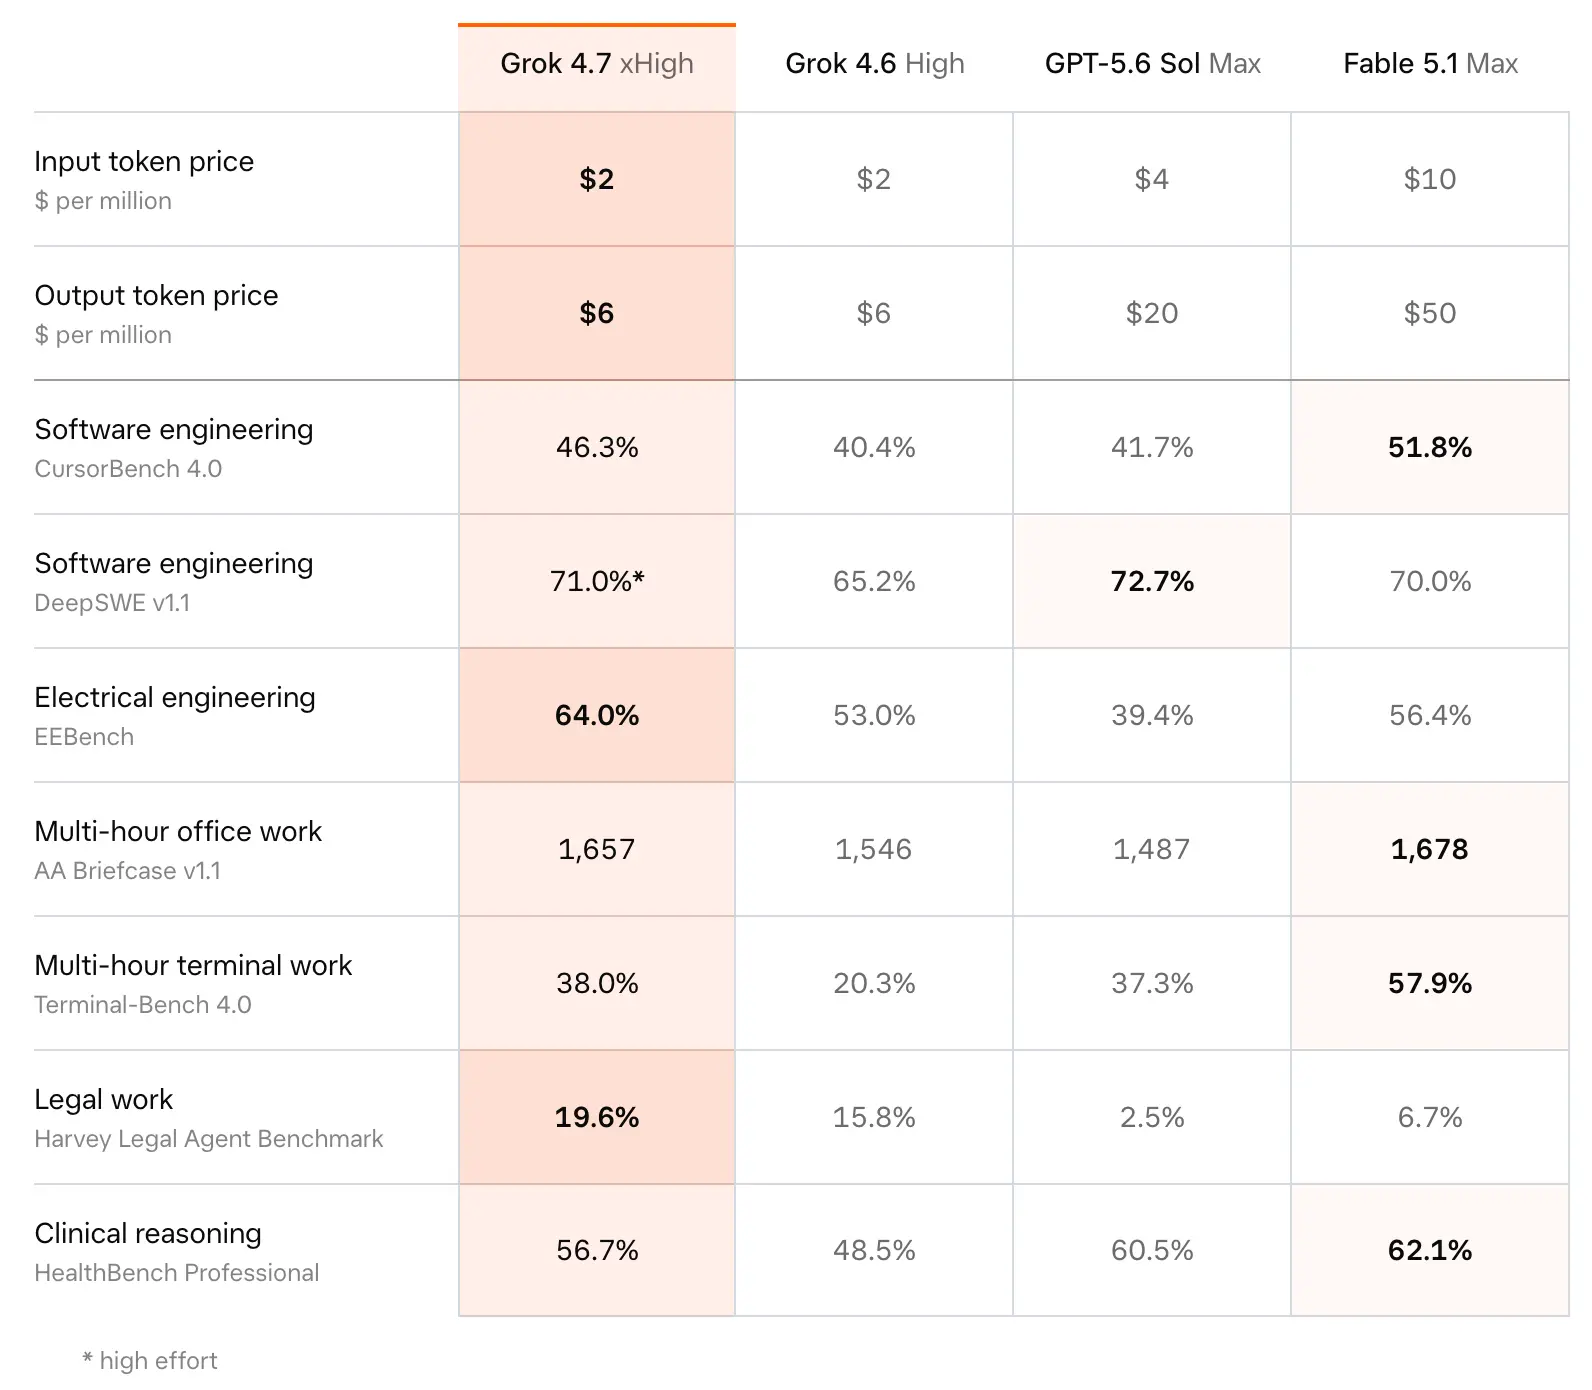
论据藏在榜单里。CursorBench 4.0 是专门压长时编码任务的基准,Grok 4.7 官方给的宣传数据是 55% 分位附近处于"性价比前沿"。对照表更能看出定位:DeepSWE v1.1 上 Grok 4.7 拿到 71.0%(high effort),Fable 5.1 是 70.0%、GPT-5.6 Sol 是 72.7%,咬得很死;但输入 token 价 Grok 4.7 只要 $2/百万,输出 $6/百万,而 Fable 5.1 是 $10/$50、GPT-5.6 Sol 是 $4/$20。同样量级的能力,价格差了数倍——这就是它喊"便宜一半"的底气。
技术路径和别家这几年走的是同一套:更大的基础模型,配合一轮更长的强化学习,训练任务加权偏向那些要跑好几个小时才能完成的重活。重点是模型学会了两件以前没人标榜的事——更好地自我核验,以及原生理解自家 Grok Bot harness,这让它在多轮对话和通用知识工作上更顺。
榜单里有个数字值得单独拎出来:Terminal-Bench 4.0 上 Grok 4.7 是 38.0%,比 Grok 4.6 的 20.3% 几乎翻倍;同时 HealthBench Professional(临床推理)56.7%、Harvey Legal Agent Benchmark(法律工作)19.6%,把同行甩开一截。长时终端操作和垂直专业场景,是它这版主打的差异点。
安全这一侧 SpaceXAI 也下了重注,换了一套全新的 safeguard 栈。官方称这是它测过的拒绝/越狱抵抗最强的模型:HackerBench v0.3(恶意网络任务)里只放行 3.3% 的危险双用途提示,却几乎不误伤正当安全研究;LatchBio 的生物安全基准拿到 62.4% 登顶。它还开始给选定的网络安全合作伙伴发红队能力的内测访问——把"攻"也当成了卖点。
价格上,Grok 4.7 起步 $2/百万输入、$6/百万输出,另有一个快两倍但贵两倍的 fast 变体。今天已经在 Cursor、Grok Build、Grok API 以及第三方编码 harness 和云平台上可用。对开发者来说,这一版最有吸引力的可能就是那个"同量级能力、三分之一价格"的 TCO,而不是又刷高了几分榜单。
来源: