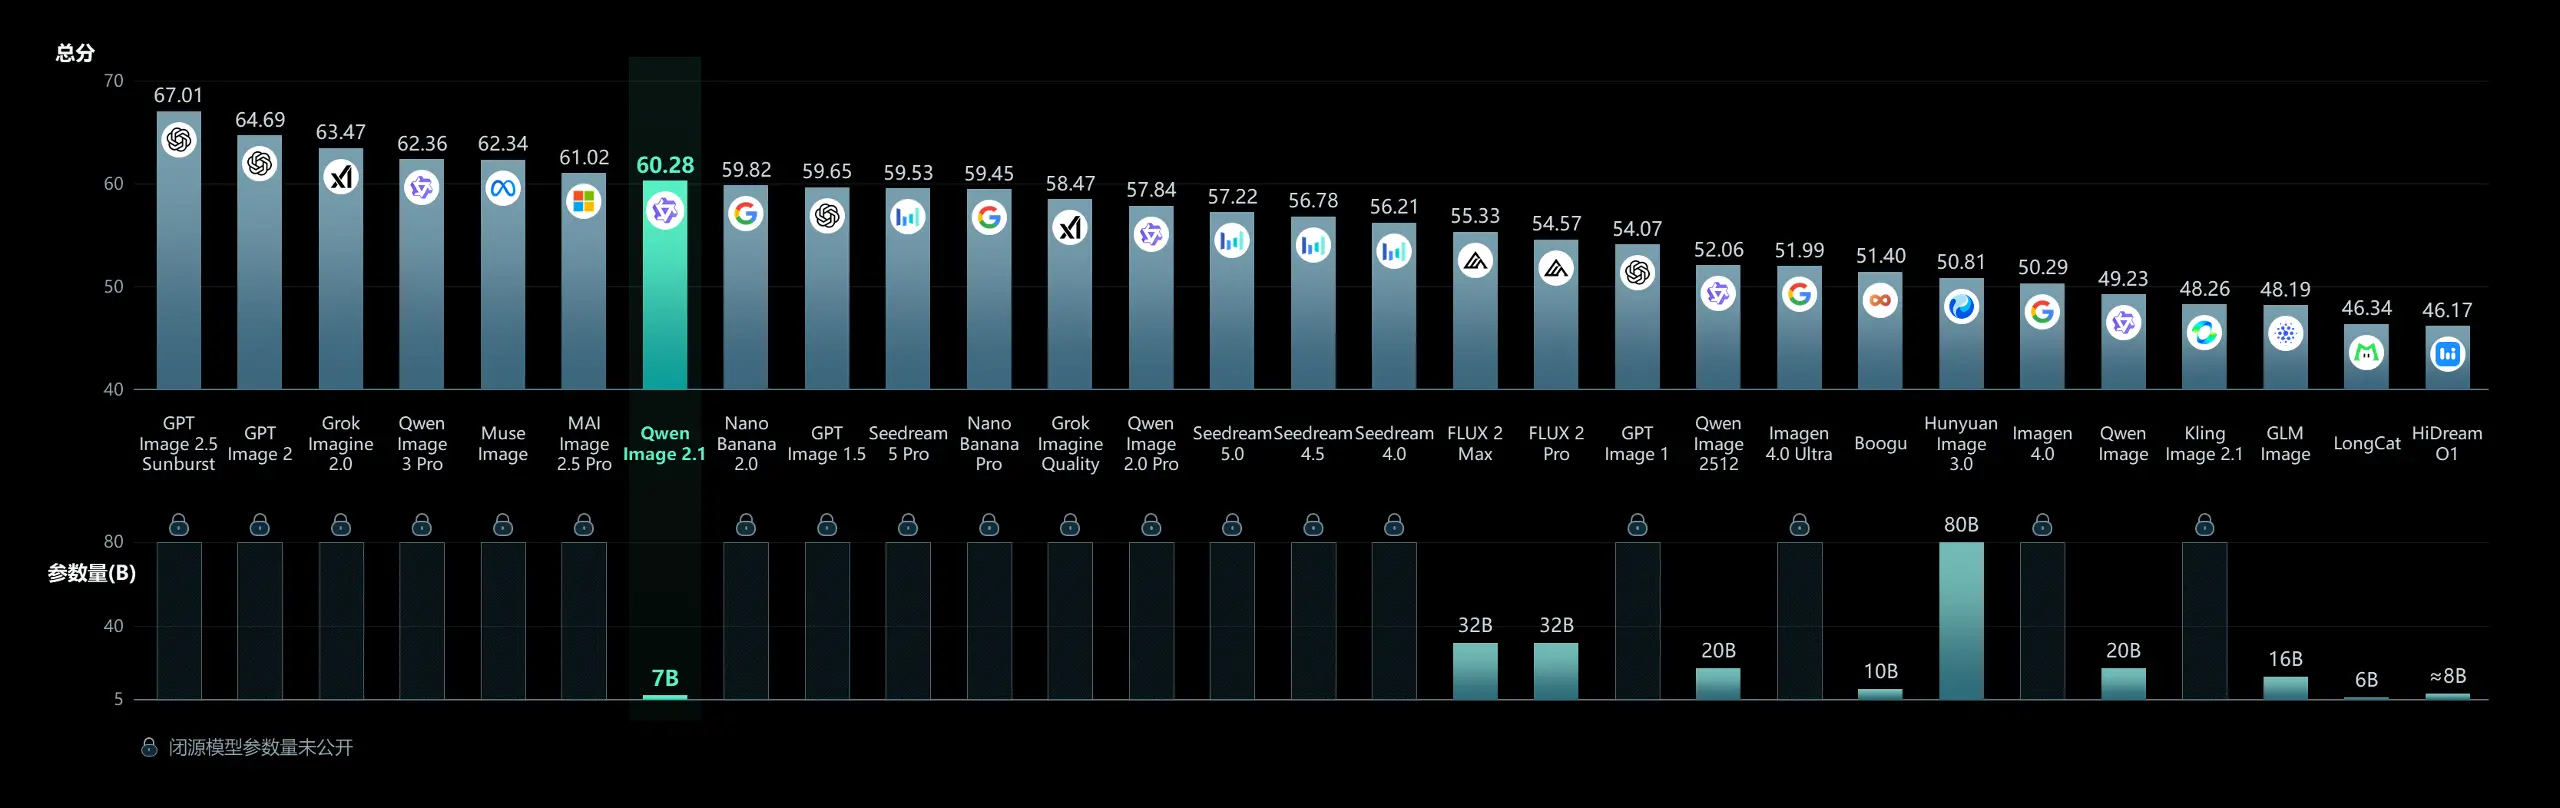
阿里通义千问开源了 Qwen-Image-2.1。一句话概括它的定位:把生成效果、推理效率和成本压到同一个平衡点——视觉生成部分只有 7B 参数,却把文生图、透明图生成和图像编辑整合进了同一个模型,还原生支持透明图像的生成与编辑。
几个值得拆开的点。第一个是"小模强效"——视觉生成部分用 32 层 Single-Stream DiT,7B 参数。省参不代表省脑子,把一个原本要几十 B 干的事压到 7B,靠的是针对推理效率的结构优化:模型对文本和图像采用不同的处理策略,文本(系统前缀、编辑指令)走 Token 级因果掩码,图像生成走 Chunk 级掩码;再用 KV Cache 复用,把输入图像和编辑指令当静态上下文,首步预计算缓存。这套"混合粒度注意力"在多图输入场景尤其省显存、提速度。
第二个看点是"原生透明,创改一体"。2025 年 12 月通义发过专门的 Qwen-Image-Layered 支持透明图生成,这次把能力并进了统一模型——模型会根据提示词自动决定输出普通图还是带透明通道的图,还能直接编辑透明图层(比如保留透明背景只改人物表情、改图里文字)。真实照片也能用:输入 RGB 图,让模型抠出主体,输出带透明通道的 RGBA 图层,方便后续设计合成。
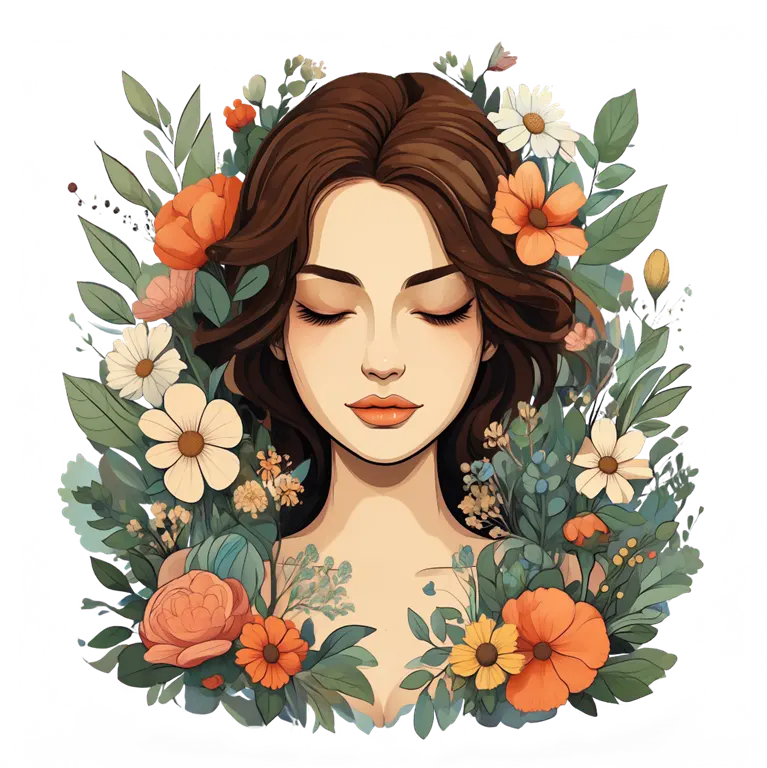
原生透明图像生成
编辑能力围绕"多局保全"四个字展开:最多支持 10 张参考图输入(六张人像合成合照、五张组成穿搭、十张家居图生成室内布置);局部编辑支持圈选、涂抹、独立掩码三种指定方式,还能逐步修改串联成简单动画;保真重点强化人像一致性和商品一致性(编辑后身份特征、商品文字纹理都尽量保留);同时覆盖全景图、信息图、分镜图等多种任务。
对做设计、电商、内容创作的团队来说,这类"文生图 + 透明 + 编辑"合到一个小模型里的路线,直接降低的是把这些能力串起来的工程成本——不用再为透明图、抠图、局部重绘各接一个模型。
具体能复用多少,开源权重、Hugging Face、ModelScope 上都能实测:
- https://github.com/QwenLM/Qwen-Image-2.1
- https://www.modelscope.cn/models/Qwen/Qwen-Image-2.1