"我们芯片多、我们跑得快"——这种话听多了就容易变成营销。Anthropic 这次换了个思路:与其互相吹,不如直接把自家实验室的内部数据拿出来,给"AI 发展速度"这件事定一套可以测量的指标。
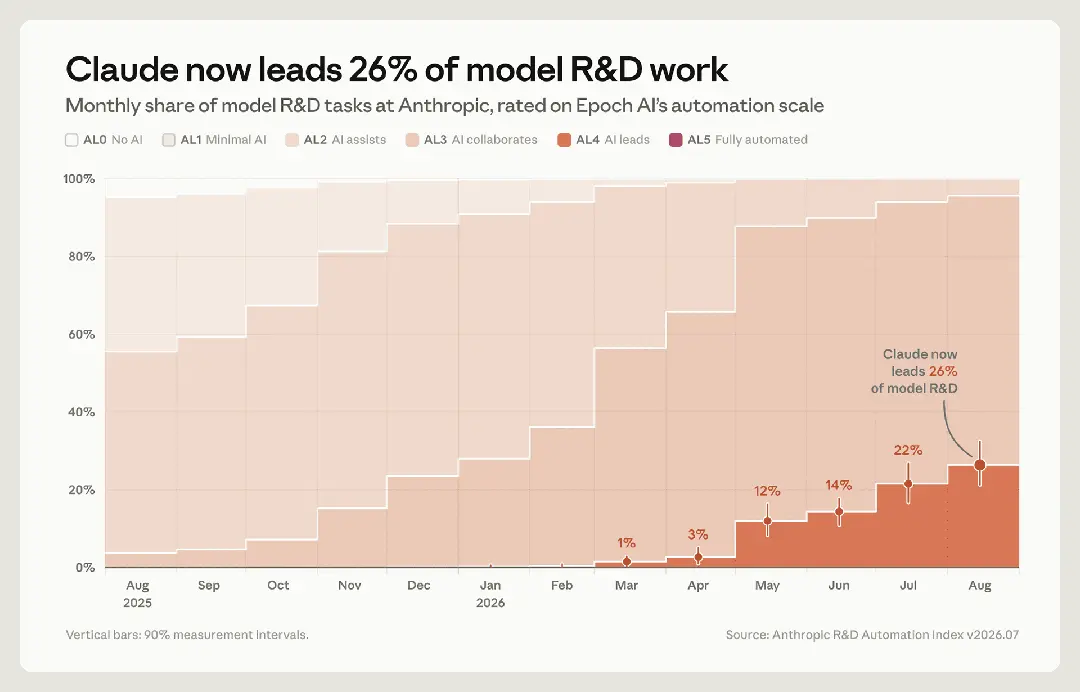
它发了三份方法论性质的度量。第一份叫"AI 主导研发(AI-led R&D)",借用 Epoch AI 的自动化分级(AL0 到 AL5,AL3 是 AI 协作、AL4 是 AI 主导)来统计 Claude 在自己公司内部研发里到底扮演什么角色。结论很克制:截至 2026 年 8 月,Claude 在任何抽样任务子集上都还没有做到完全自主,但已经主导了约 26% 的 AI 研发工作,处于"AI 协作"及以上水平的工作占比超过 90%。
这组数字直接连着"递归自我改进"(RSI)这个悬案。Anthropic 想表达的是:AI 还没到完全自己改自己的程度,但"AI 参与研发"已经不是概念,是正在发生的日常。
第二份量的是"对 AI 智能体的监督"。它说自己最常用的内部平台上,任意时刻都有约 3 万个智能体在做研究和工程。监督分两层——在线监视器实时看、覆盖率 100%,离线监视器事后翻。每周约 10 万份转录被审查,其中约 50 份升到人工处理。在超过 10 亿个决策里,只有 0.002%(约 1/47000)被拦截,监视器每千个会标记 1 到 2 个。
第三份最有意思,量的是"算力分配"。Anthropic 抽查了 7 月 13 到 20 号那一周的全部算力,把工作负载分门别类,看有多少算力给了安全研究。结果:投入 AI 研发的算力里约 6% 给了安全方向,而 AI 主导研发的算力里约 12% 给了安全。它自己强调这些是"刻意保守"的估计——既推进能力又推进安全的任务不计入,模型安全分类器的算力也不算在内。深意在于:算力是 AI 研发流程里"最可验证的输入",真要搞 AI 发展的调控(pacing),算力分配是最容易盯住的杠杆。
配这几段数据的还有一个政策动作。Anthropic 明确提出要把独立的第三方评估者嵌入实验室、给予和内部团队对等的访问权限,也在推 AAIF 政策提案——Dario Amodei 之前公开呼吁过对整个行业的发展节奏做协调。
Anthropic 的立场很清楚:鼓励其他前沿实验室用同一套标准公布同样的数字。它承认安全研究与能力研究难以区分,开发者会有动力把界线画得对自己有利,所以举证责任该放在开发者身上,证明"这是安全相关工作"。这些数字绝对值未必多漂亮,价值在于给"怎么比较"定了一套统一标尺——这在"各家都在说自己最安全"的环境里,至少是个能对着谈的东西。
来源:Measurements for understanding the pace of AI development inside frontier labs - Anthropic