NVIDIA 在 9 月宣布认真押注 Rust 原生 GPU 编程。CUDA C++ 和 CUDA Python 已经是成熟的商用工具链,但这次它没有二选一,而是把 CUDA Rust 往 2027 年及以后持续打磨——明确了要长期养大这套生态,而不是试水。
驱动这个决定的是向下看的视角。AI 的系统层——推理引擎、serving 基础设施、驱动、agent 运行时——日夜都在变,而这层越来越多用 Rust 写,因为它能在编译期拦掉整类 bug 又不牺牲性能。NVIDIA 自己就是这股潮流的一部分:Nova Linux 驱动用 Rust 写,Dynamo 的核是 Rust,NVTX 有 Rust 绑定。唯独一个例外——GPU kernel。你可以从 Rust 发起 kernel,可 kernel 本身往往得用别的语言写。这次 CUDA Rust 就是要堵上这个口子,让 kernel 也能直接用 Rust 写、原生编译成 PTX,而不是包一层别的语言的代码。
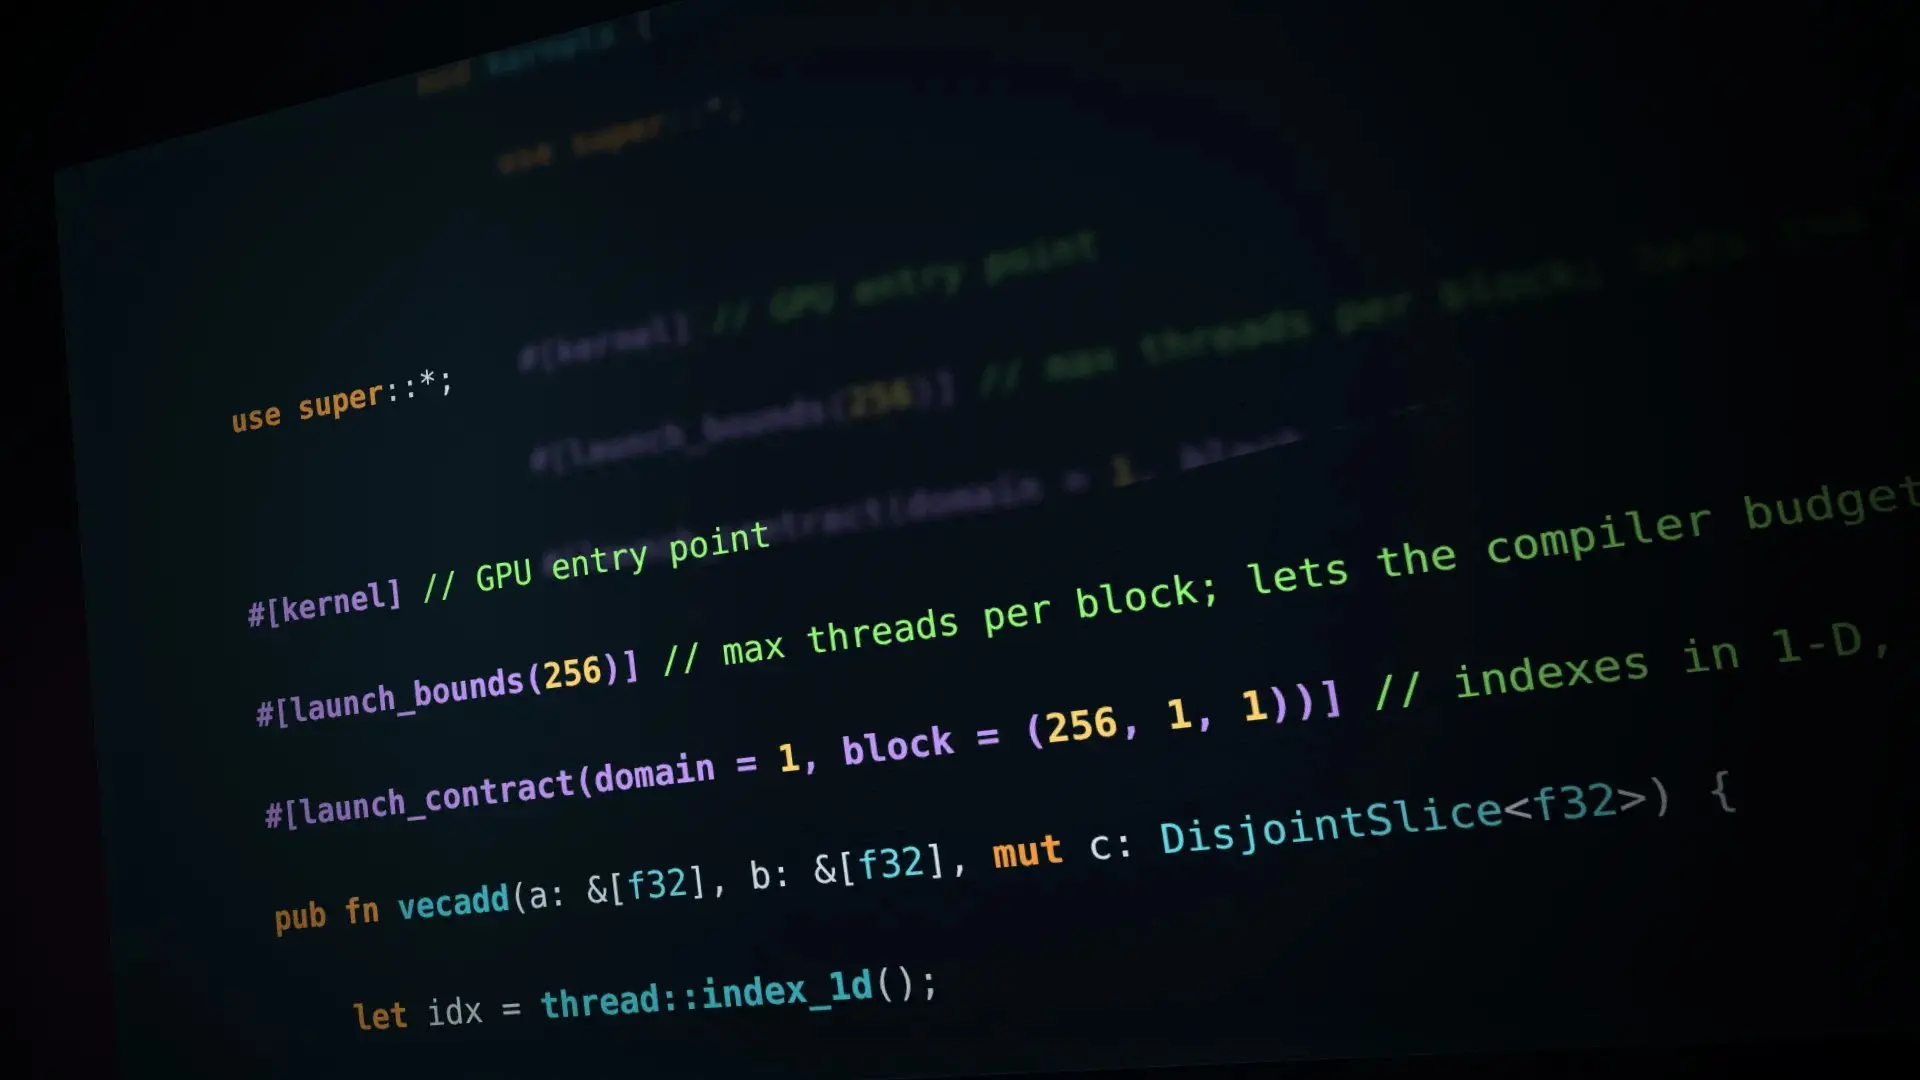
它给出了两条平行路径,对应 CUDA 自己的两种模型。SIMT 是你今天在 CUDA C++ 或 numba-cuda 里已经熟悉的写法——你描述一个线程做什么,然后一次启动几千个线程。Tile 是更新的模型,C++ 和 Python 里也都有——你描述一块 tile 的数据要做什么,剩下交给 Tile IR 编译器去编排。官方建议能选就优先 Tile,因为编译器决定 tile 怎么映射到每种架构,源文件不需要写死特定架构的选择;而当你需要精细控制寄存器、亲手管内存和线程时,再降回 SIMT。
语言和模型是两个独立问题。用哪种 CUDA 接口取决于你现有栈是什么,而下面两个项目专为 Rust 栈而生,并且计划支持语言间互通,选了它不会把你锁死在其他语言之外。
SIMT 这条线叫 cuda-oxide,一个自定义的 rustc codegen 后端。它拦下编译,把 #[kernel] 函数路由经过 Rust MIR、社区 Pliron IR 框架、LLVM IR 一路下到 PTX,其余代码交给标准后端。GPU dialect 和每一步变换都留在 Rust,直到标准 LLVM 后端接手。驱动方式是 Cargo 子命令 cargo-oxide,一条 cargo oxide run 把完整 vector add 程序跑通打印 PASSED: all 1024 elements correct。它的内存安全靠一个 DisjointSlice 类型——输出 buffer 作为自身输入传入时直接编译不过。
Tile 这条线叫 cutile-rs,在更高一层工作:按 tile 而不是标量做计算,每个 tile 块作为单个逻辑线程跑一遍 kernel 正文,编译器决定背后用多少真实 GPU 线程。它唯一特殊的地方是 host 端那个 .partition([128]),三个任务一口气干完——让独占性成真、固定启动几何、顺带读出 tile 宽度。门槛比 SIMT 轻:稳定 Rust 1.89+、CUDA 13.3、Linux,不需要 nightly 也不装自备 LLVM,而且它已在 crates.io 发布,直接 clone 都不用。
最值得看的是「编译器能抓到什么」。两个 kernel 对内存做的声明其实是同一个:输入共享、输出独属一个写者,区别只在声明的层级、以及要不要为此造一个专用类型。几千个线程无固定顺序碰到同一 buffer,一旦两个线程同时写同一地址,顺序就决定了结果——这类 bug 很少按需复现,往往过了测试才在生产炸开。两条路都在编译期不给通过:SIMT 侧是 E0502(可变借用与不可变借用冲突),Tile 侧是 E0382(move 了已使用的值)。经典的内存别名错误,这次在 Rust 编译器眼皮底下就挡住了。
Rust 用了这么多年,glue 层早就 Rust 化了,唯独 kernel 这块硬骨头一直得换语言。现在两条轨道落地,等于把「kernel 也归 Rust 管」补上了最后一块拼图。
来源:Introducing CUDA Rust: Two Tracks for Writing GPU Kernels - NVIDIA Technical Blog