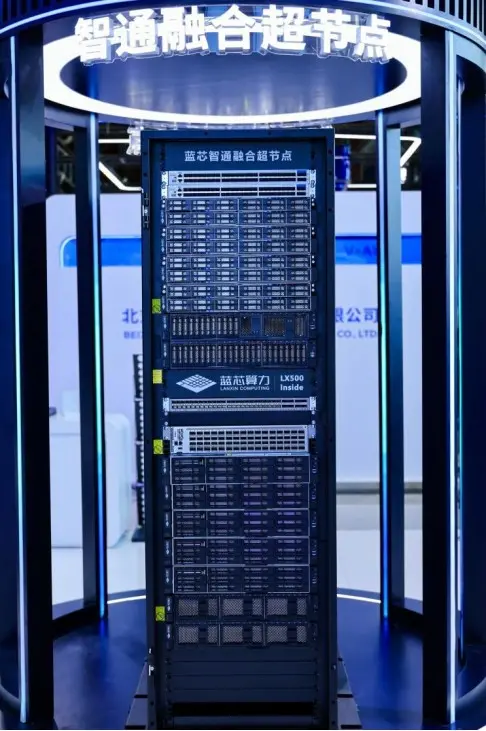
10月19日,在2026 RISC-V中国峰会上,蓝芯算力发布智通融合超节点,进一步将基于RISC-V架构的AI计算能力从单芯片、服务器向集群化算力基础设施延伸。当天,蓝芯算力CTO贾新霞围绕“LX500:解锁AI推理新路径”发表主题演讲,介绍了RISC-V与AI计算融合的技术探索及产品化进展。
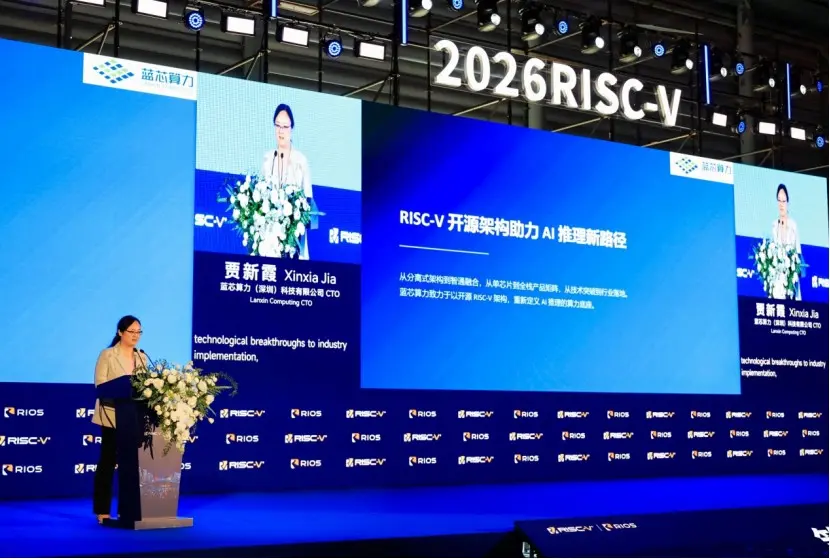
蓝芯算力CTO贾新霞
本届峰会于10月18日至20日在深圳举行,聚焦RISC-V产业生态、人工智能、数据中心与高性能计算等方向。蓝芯算力的此次发布,也体现出RISC-V技术应用正从处理器芯片向服务器和AI算力基础设施拓展。
面向AI推理,探索计算架构融合
随着大模型应用加速落地,AI算力需求正在从单纯追求峰值算力,向性能、能效、成本以及部署效率等综合能力延伸。特别是在大模型推理场景中,模型参数规模和上下文长度不断增加,数据在CPU、内存和AI加速器之间频繁搬运,对系统带宽和功耗提出更高要求。
针对这一问题,蓝芯算力提出“智通融合”架构,将通用计算与AI计算能力集成在同一芯片,并通过统一内存架构减少数据在不同计算单元之间的搬运。
此次发布的智通融合超节点,正是这一技术路线向更大规模算力系统的延伸。
据贾新霞介绍,蓝芯算力LX500采用RISC-V架构,集成48个RISC-V CPU核心,包括32个性能核和16个能效核,同时集成AI Vector和Matrix计算引擎,AI算力达到75 TOPS INT8,并支持INT4至FP32多种精度。芯片采用统一内存架构,共享DDR5内存资源,并支持CXL扩展。
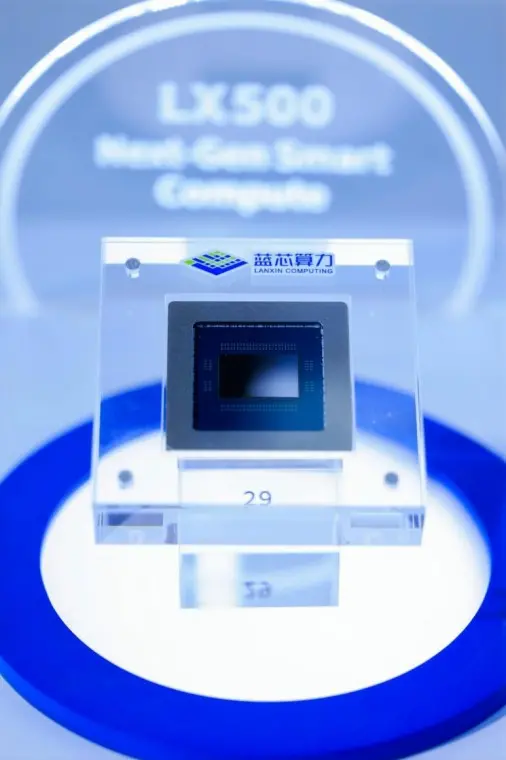
在传统CPU与独立AI加速器分离的架构中,数据需要通过PCIe等高速互联在不同内存空间之间传输。智通融合方案则尝试从芯片架构层面减少数据搬运,并围绕大模型推理中的首Token延迟、Prefill和长上下文等场景进行优化。
从单芯片走向服务器及超节点
此次超节点产品的发布,也是蓝芯算力推进RISC-V AI计算产品化的重要一步。
此前,蓝芯算力已围绕LX500形成服务器、一体机等产品布局。2026年2月,LX500完成芯片点亮;4月首次公开亮相;5月发布RISC-V+AI智通融合一体机原型;7月,搭载LX500的联想问天WR5219 G5服务器亮相;8月,LX500开始向多家行业客户送样,部分客户进入小批量部署测试阶段。
在服务器产品中,LX500将通用计算和AI推理能力集成于单一芯片,减少对独立推理加速卡的依赖。围绕这一架构,蓝芯算力进一步形成LX500芯片、WR5219 G5服务器、LX5000智通融合一体机以及智通融合超节点的产品矩阵,推动产品从单点计算能力向系统级算力扩展。
软硬件协同加快AI应用落地
在芯片和服务器之外,模型适配和软件生态成为AI推理产品能否真正落地的重要环节。
目前,蓝芯算力已围绕Qwen、DeepSeek、Kimi等…模型开展适配,覆盖不同参数规模、不同精度以及长上下文应用场景,并探索通过统一软硬件栈降低模型部署复杂度。
在应用层面,相关产品可面向企业私有知识库RAG、Agent办公助手、金融合规推理、政府离线问答以及工业现场检测等场景,满足部分行业对本地化推理、数据安全和低成本部署的需求。
从芯片到服务器,再到超节点,蓝芯算力正在尝试构建覆盖不同算力规模的RISC-V AI推理产品体系。此次智通融合超节点的发布,也意味着RISC-V在AI推理领域的探索进一步从芯片和单机产品向系统级算力基础设施延伸。
业内人士认为,随着人工智能应用从模型训练逐步走向更加广泛的推理和行业部署,算力基础设施需要兼顾性能、能效、成本与部署灵活性。RISC-V与AI计算的融合,为产业界提供了新的技术探索方向。未来,芯片性能、软件生态、服务器产品以及行业应用之间能否形成更成熟的协同体系,将成为这一技术路线进一步规模化落地的重要因素。