Loop Transformer,
能否真正扩展到视觉语言模型?
近年来,Loop Transformer 逐渐从简单的模块复用走向更复杂的分层循环计算,探索如何通过共享参数持续更新模型状态。一个自然的问题是:当模型开始看图,这套机制还成立吗?
图像中往往同时包含文字、物体和空间关系,而不同循环可能需要关注不同的视觉证据。再次调用相同参数,模型会继续关注原来的位置,还是转向第一遍忽略的地方?
近日,来自中国人民大学、百度、清枢智汇、上海交通大学、清华等机构的研究者提出 LoopVL,围绕这一问题完成了从语言预训练到多模态后训练的系统探索。除了验证循环视觉语言建模的可行性,团队还观察到明显的跨循环视觉注意力重组,并将其称为 Visual Aha Moment。
-
论文标题:LoopVL: Recurrent Visual Intelligence
-
论文地址:arxiv.org/abs/2609.38426
-
开源代码:github.com/Tier-Flow/LoopVL
-
模型权重:huggingface.co/TierFlow/LoopVL
先看结果:
约 1B 语言主干,能走多远?
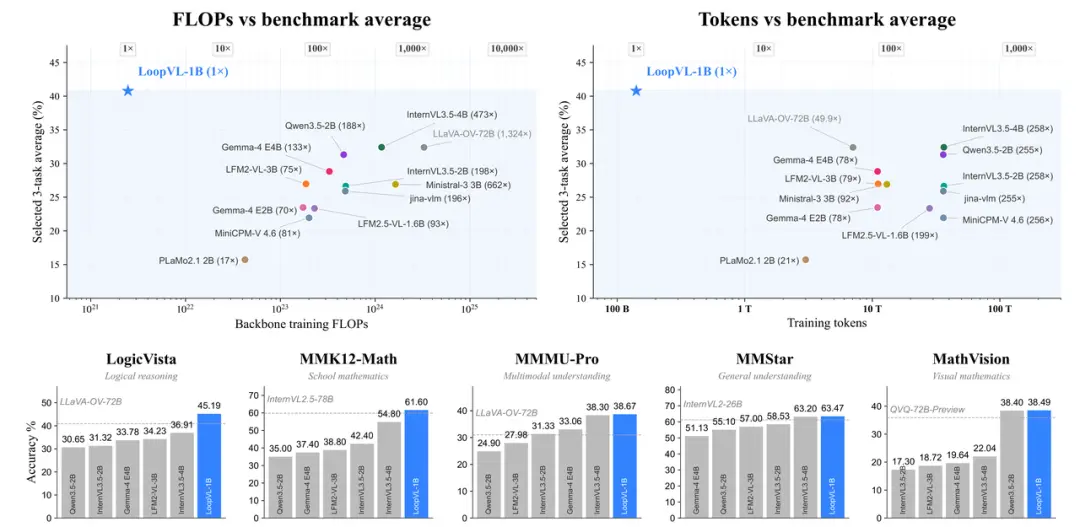
先看一个非常直接的对比:LoopVL 仅用 0.14T 训练 token,而 Qwen3.5-2B 和 InternVL3.5-2B 约用了 36T,训练数据量相差约 260 倍。 尽管数据规模远小,LoopVL 在 LogicVista、MMMU-Pro、MMStar、RealWorldQA、MMK12-Math、MathVision 等多项评测上,依然能够达到甚至超过这些公开 VLM 的表现,体现出较强的数据效率与推理潜力。
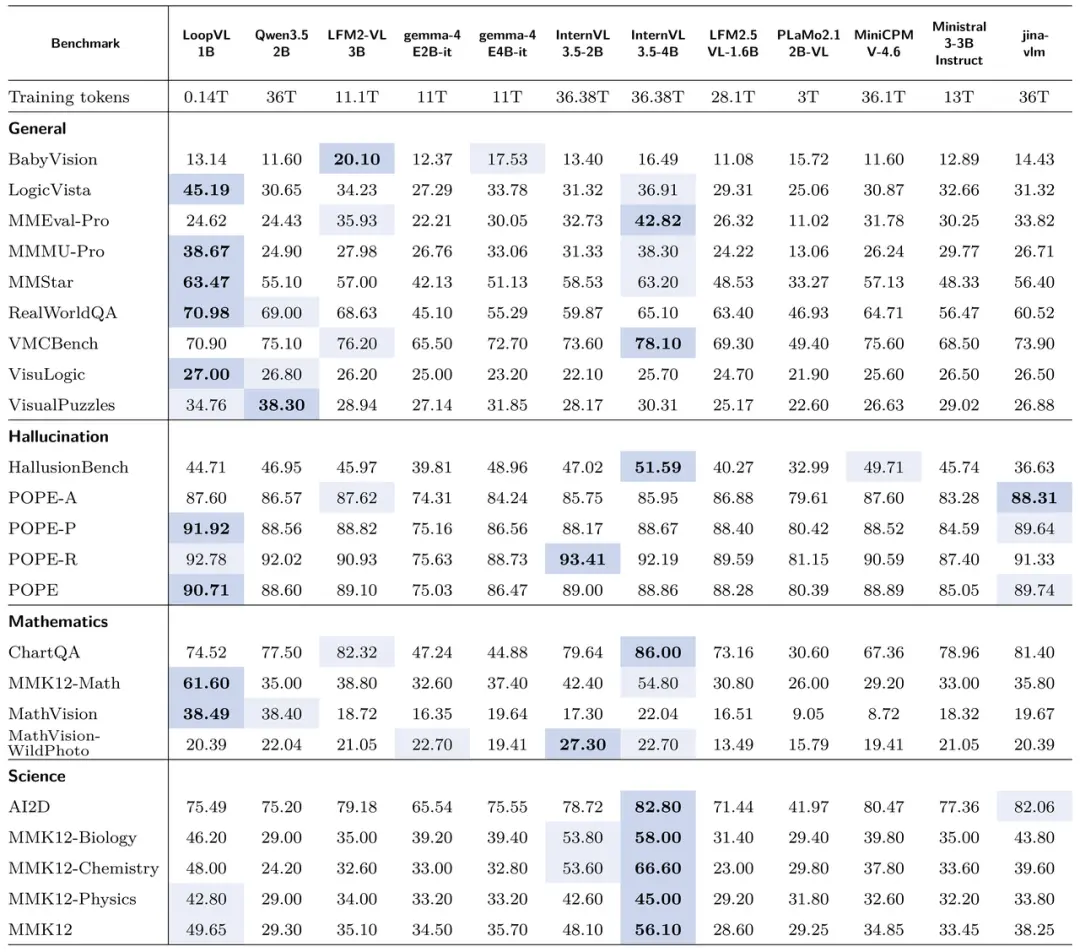
LoopVL 与 Qwen3.5、InternVL 等公开 VLM 的性能比较,涵盖通用理解、幻觉、数学与科学等任务。各模型训练 token 规模列于首行。(论文表 2)
要判断循环有没有带来价值,不能只把不同来源的模型摆在一起。团队构建了三个采用相同 Transformer block 设计的非循环基线:32 层的 Transformer-VL 1B,以及通过增加深度或宽度扩展的两个约 4B 模型,并统一使用 0.14T 训练 token 预算。
相比两个约 4B 的 Transformer 基线,LoopVL 仍保持约 1B 的语言主干,通过循环复用共享模块增加计算深度。在八项受控评测中,LoopVL 有五项同时超过 Deep 和 Wide:RealWorldQA 达到 70.98,高于二者的 66.54 和 66.01;MathVision 达到 38.49,高于 35.92 和 33.55。这表明,让共享参数在不断更新的视觉 — 语言状态上反复计算,也可以成为有效的模型扩展路径。
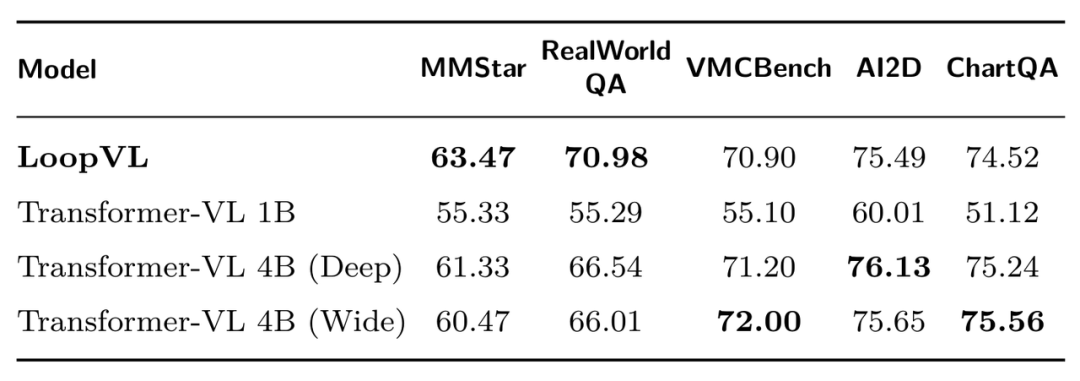
相同训练 token 预算下的受控比较,截取五项指标。Deep 与 Wide 分别通过加深、加宽扩展模型。(论文表 1 节选)
需要强调,参数复用并不意味着推理计算开销更低。LoopVL 与 1B 基线均有 32 套独立 Transformer 层,但分别执行 128 次和 32 次层调用,因此上述结果并非同等推理开销下的比较。
32 层参数,128 次计算:
LoopVL 的两层循环
LoopVL 沿用 HRM-Text 的分层循环架构,将语言主干划分为各含 16 层 Transformer 的 L、H 模块。默认 H2L3 配置下,L 连续执行三次,再执行一次 H,整个过程重复两轮,即 [L×3→H]×2。其中,L 模块的重复调用形成 Module-Loop,完整 L/H 周期的复用形成 Model-Loop。32 套独立 Transformer 层由此展开为 128 次层调用,图像仅经过一次视觉编码,后续循环持续更新联合视觉 — 语言状态。
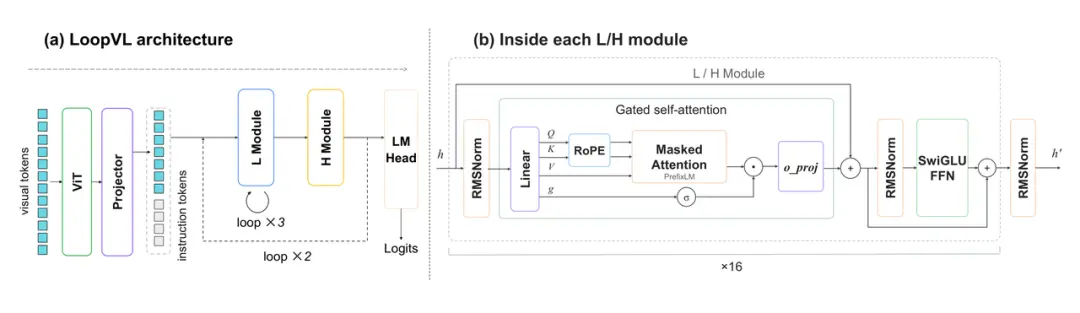
Module-Loop 重复调用 L 模块,Model-Loop 重复整个 L/H 更新周期。视觉与语言共同参与循环计算。(论文图 2)
团队先用 75B token 训练自己的语言主干,再进入多模态训练:视觉对齐阶段冻结语言主干和视觉编码器,只训练随机初始化的投影器;之后联训语言主干与视觉接口,再完成监督微调和视觉强化学习。模型在完整训练过程中逐步学会利用循环计算。这些循环发生在一次前向传播内部,前一轮的隐状态传入下一轮,最后由 H 状态生成输出。
把视觉状态改成 “只读”,
会发生什么?
LoopVL 并不把进入语言主干的视觉 token 当成固定特征。它们对应图像中的空间位置,却会随着循环不断变化。第一轮结束后,下一轮读到的已经是经过视觉 — 语言交互的表示。
为了判断这些更新是否必要,团队保留第一轮计算,在第二轮分别阻断 L 模块视觉更新的传递,或将视觉状态完全冻结。两种干预都降低了性能。但这还不够:推理时突然改变计算规则,本身就可能产生训练与推理不一致。
因此,团队又单独训练了一个 Read-only 版本:第一轮允许更新视觉状态,第二轮只读,训练和推理遵循同一规则。视觉 token 仍然可被读取,非视觉状态也继续更新。结果,正常 LoopVL 在四项评测中依然最高,重新训练的只读版本仍落后于它。
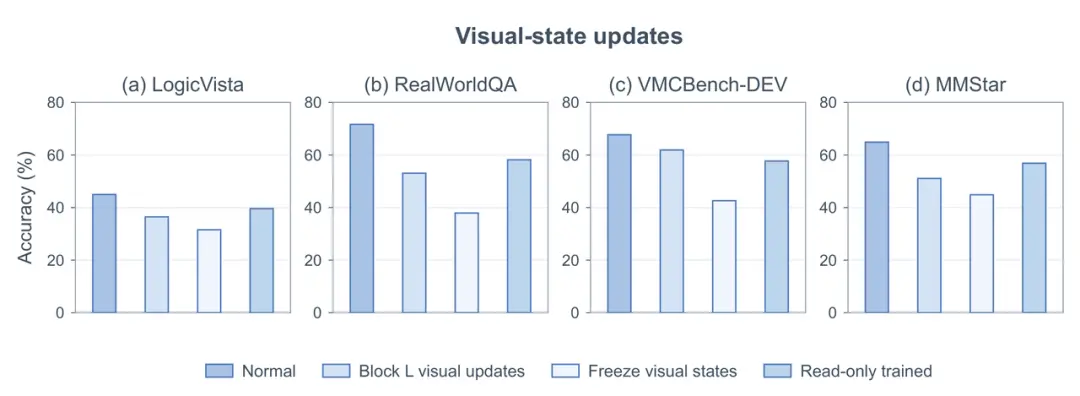
正常模型与三种视觉状态更新控制。Read-only trained 是单独训练的变体,并非仅在推理时冻结状态。(论文图 3)
这组实验支持了一个关键判断:视觉状态的持续更新,是 LoopVL 循环计算中有用的一部分。它不是第一轮处理完图像,后面只剩语言在继续运转。
循环交界处的视觉 Aha Moment !
视觉 Token 保留了与图像区域的空间对应关系,这为研究循环计算提供了一个直观窗口:当同一个共享模块被再次调用时,模型究竟在关注哪里?
团队在多个诊断样本上,沿 128 次层调用记录视觉注意力的变化。空间熵(Spatial Entropy)描述注意力分布有多分散,Gini 系数则衡量视觉 Token 之间的注意力权重有多不均匀:前者越低、后者越高,通常意味着视觉注意力越集中。
最有趣的现象出现在两轮 Model-Loop 的交界处。 从第 63 次到第 64 次层调用,平均 Gini 系数从 0.405 突然跃升至 0.858,第二轮的空间熵也整体更低。这意味着,模型从第一轮相对分散的视觉关注,转向了第二轮对少数视觉区域的集中关注。
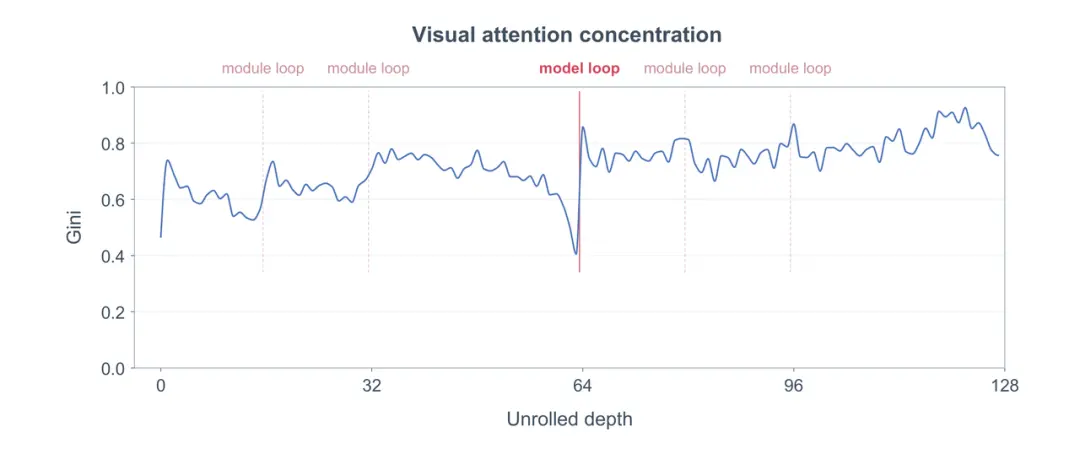
图 7:多个诊断样本的平均 Gini 轨迹。两轮 Model-Loop 的交界处出现显著的注意力集中现象。
这一令人兴奋的现象证明:模型并非简单地重复计算,而是在新一轮循环中重新分配视觉注意力。 第一轮可能侧重于广泛整合视觉信息,第二轮则进一步聚焦于少数关键区域,呈现出从广泛感知到选择性关注的趋势。即使采用完整反向传播,或移除视觉锚点与视觉门控机制,这种现象依然存在。
因此,循环计算的价值可能不仅在于增加计算深度,还在于让模型逐轮调整视觉信息的处理方式,但这一变化为理解循环模型如何实现更深层次的视觉推理提供了重要线索。
当然,注意力变集中,仍然不能说明模型找到了不同的证据。为此,团队进一步比较了两轮循环末端同一个共享 H 模块最后一层的视觉注意力分布,观察模型究竟将注意力转移到了哪些区域。
有趣的是,一些重要的且在第一轮中受到较少关注的视觉 Token,在第二轮中跃升至注意力排名的前 25%。 这种变化不仅出现在简单的颜色判断和计数任务中,也出现在文字识别、方向判断等更复杂的视觉任务中。
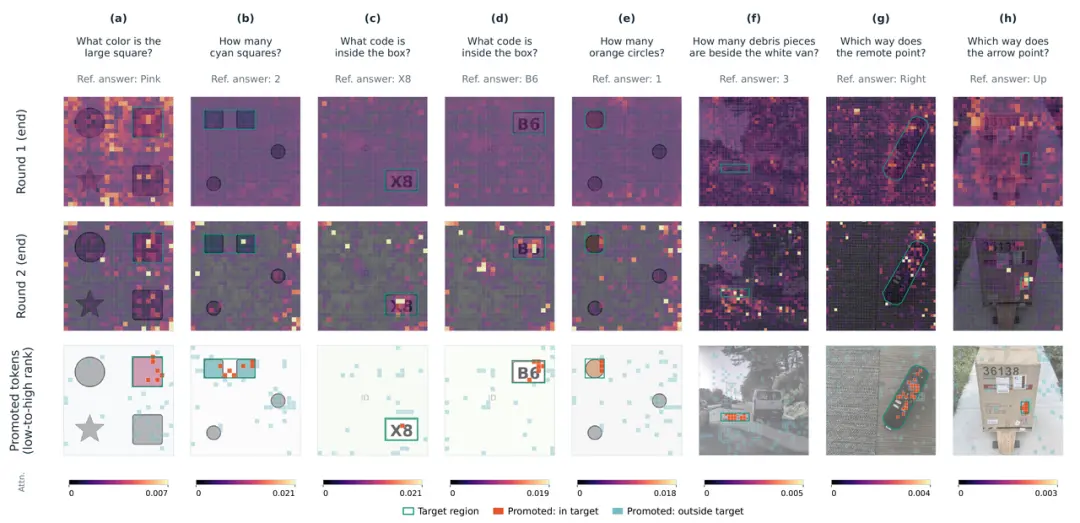
论文图 8:同一共享 H 层在两轮循环中的视觉注意力重分配。前两行展示两轮注意力分布,第三行标记注意力排名显著提升的视觉 Token,其中橙色表示目标区域内,青色表示目标区域外
这一现象被称为 Visual Aha Moment(视觉顿悟时刻)。 它最值得关注的地方在于:模型并没有更换参数,却在第二轮循环中重新调整了视觉关注区域。这意味着,循环计算并非简单重复已有的视觉处理过程,而是可能利用前一轮积累的信息,重新发现值得关注的视觉线索。
这些发现共同揭示了 Loop 架构的一种特质:即使共享完全相同的参数,模型也能在不同循环中呈现不同的视觉信息处理行为。
不过,循环也并非越多越好。固定 H2L3 训练权重,将推理调度改为 H3L3 和 H4L3 后,MMStar 从默认的 63.47 分别下降至 58.20 和 24.00。这也说明,循环能力并不意味着可以无限增加计算次数,训练与推理调度的一致性同样重要。
最后:共享参数,
不必重复同一种计算
LoopVL 把两件事放在了一起:一方面,完整训练和受控实验验证了循环视觉语言建模的可行性;另一方面,Visual Aha Moment 揭示了一个值得关注的现象:即使共享完全相同的参数,模型也能在不同循环中重新分配视觉注意力。这意味着,模型能力的扩展,或许不仅取决于参数规模,还取决于如何组织计算,以及如何利用前一轮积累的信息。
对于多模态大模型而言,这提供了一个新的思考方向。面对复杂的视觉任务,模型需要的不只是更强的感知能力或更长的推理过程,还需要随着推理的深入,动态调整对视觉信息的关注。未来,能否让模型自主判断哪些区域值得再次分析、哪些信息需要进一步整合,以及何时继续或停止循环,将是值得探索的问题。
进一步来看,这也为多模态 Agent 提供了新的研究方向。在复杂任务中,Agent 需要根据任务目标不断调整对环境的理解,从整体感知逐步聚焦关键视觉信息。LoopVL 所观察到的跨循环视觉注意力重分配表明,即使共享相同参数,模型也能随着内部状态的演化改变视觉关注。未来值得探索的是,能否让 Agent 自主决定哪些信息需要深入分析、何时继续计算,以及何时采取行动,从而实现更高效的感知、推理与决策。
或许,未来多模态模型的发展方向,不只是让模型拥有更多参数、执行更多计算,而是让它学会更有效地分配计算:什么时候应该重新观察,应该关注什么,以及什么时候已经掌握了足够的信息,可以采取下一步行动。
作者信息
本研究由中国人民大学高瓴人工智能学院马彦彪老师和百度李和瀚团队牵头、上海交通大学严骏驰教授团队、清华大学韩军功教授团队和 TierFlow 团队合作完成。
马彦彪老师、韩军功教授团队与 TierFlow 团队聚焦于智能体效率优化,模型压缩及推理优化方面的研究。
百度李和瀚团队聚焦于基模构建、大模型后训练、生成式检索 / 推荐的研究
共同一作 Zhe Qian 钱喆(百度实习生)、Ziyang Gong 龚子洋(上海交通大学博士生)、Zhongxing Xu 许重行(莫纳什大学博士生)与 Hehan Li 李和瀚(百度,项目 Leader)。
© THE END
转载请联系本公众号获得授权
投稿或寻求报道:liyazhou@jiqizhixin.com