作者|林绮蓓
编辑|蔡芳芳
Jev 此前的走红,让一类专门为 AI 系统提供判断结果的决策模型进入开发者视野。与通常生成一段文字回答问题的大语言模型不同,决策模型接收当前状态和候选选项,直接给出各个选项的概率,供 Agent 或其他程序决定下一步行动。
如今,这个赛道迎来了一位中国挑战者。
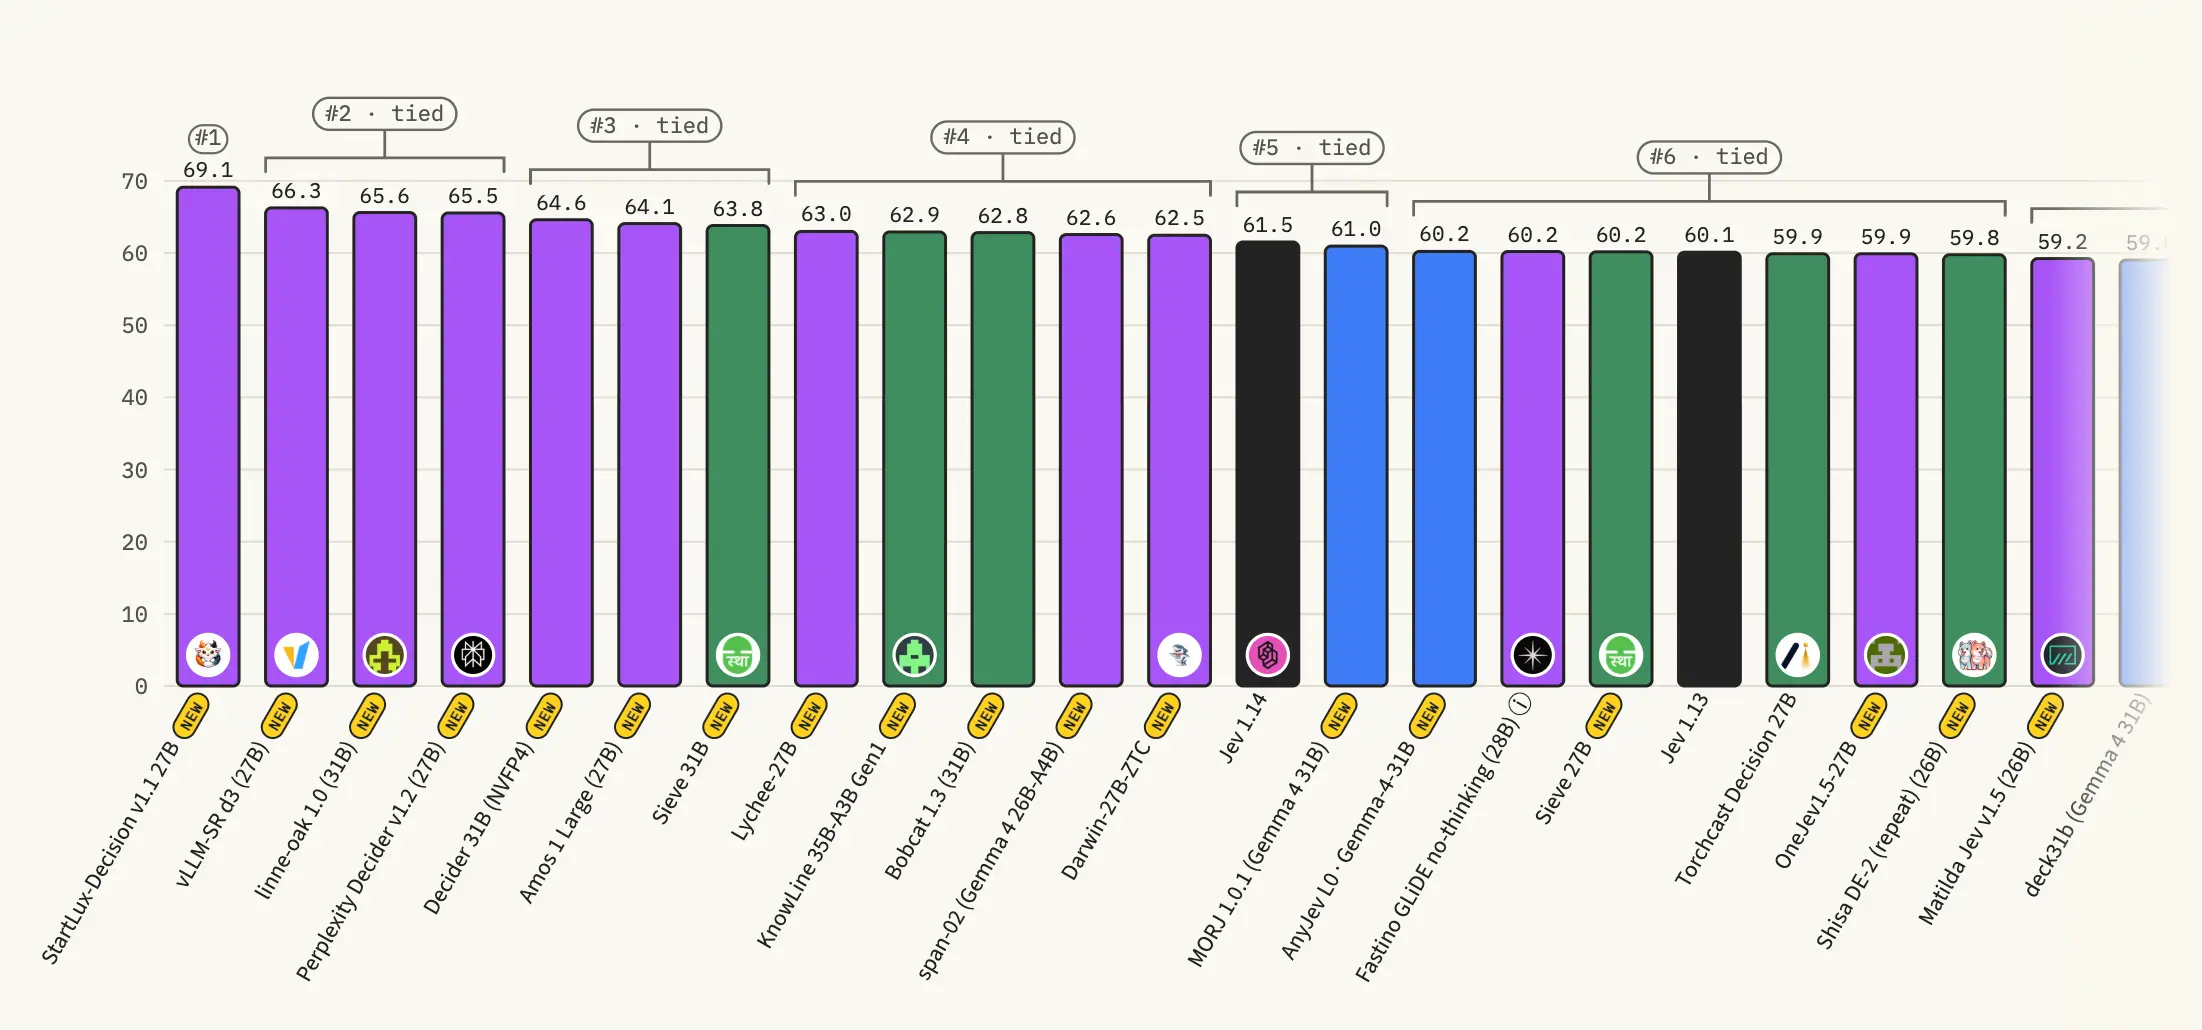
10 月 16 日更新的 Hugging Face Decision Index 0.3.2 榜单中,中国团队 StartLux 的 27B Instant 模型以 69.12 分位列 174 个参评条目第一,公开基准、同类能力私有测试及新领域私有测试三个部分的成绩均排名第一。
而在团队此前公布的 Decision Index 0.3 公开评测中,StartLux-Decision-27B-AutoThink 取得 73.37 分,相比 Jev 托管版的 57.96 分,相对领先约 27%。
这次发布的另一项变化,是让模型学会判断自己什么时候需要多想一会儿。
StartLux 提供 Instant 与 AutoThink 两条路线:前者通过单次计算快速输出概率,后者则根据初始判断的置信度,决定是否启动额外推理。
StartLux 提供 Instant 与 AutoThink 两条路线:前者通过单次计算快速输出概率,后者则根据初始判断的置信度,决定是否启动额外推理。
围绕何时启动推理、如何及时结束推理,StartLux 还提出了 RLCD²强化学习方法。其目标是改善决策概率的质量,同时约束不必要的推理开销。
这次更新也带出了一个更值得讨论的问题:当 AI 系统开始频繁调用模型进行任务路由、权限判断和工具选择时,模型给出的概率究竟有多可靠?增加推理又能在多大程度上改善最终决策?
一、登顶决策模型榜单,StartLux 比 Jev 强在哪里?
从最新榜单来看,StartLux 的领先已经获得公开排行榜的进一步验证。10 月 16 日的 Decision Index 0.3.2 榜单中,27B Instant 综合得分 69.12,领先其余 173 个参评条目。其中,公开基准测试为 72.88 分,同类能力私有测试为 64.82 分,新领域私有测试为 61.41 分,三部分成绩均排名第一。
在团队公布的评测中,StartLux-Decision-27B-AutoThink 以 73.37 分超过 Jev 托管版的 57.96 分,相对高出约 27%。不过,进一步拆开成绩会发现,StartLux 与 Jev 之间的差距,并不完全来自新增的推理能力。
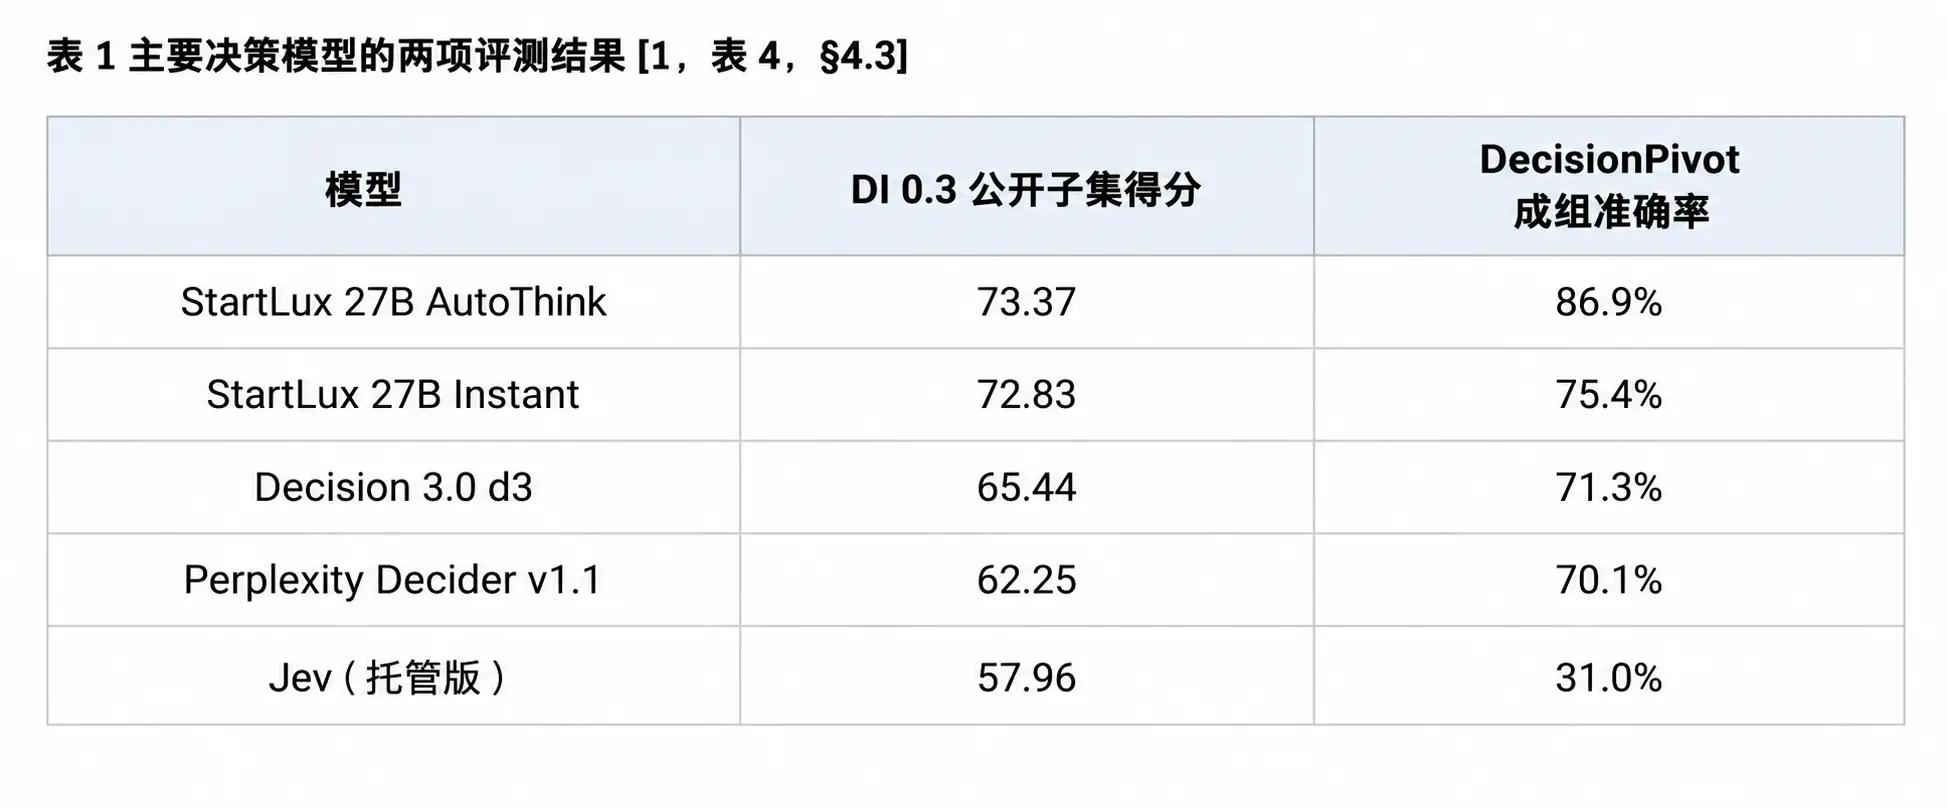
同为 27B 规模的 Instant 版本,无需生成显式推理过程,就在 DI 0.3 公开子集取得 72.83 分,与 AutoThink 仅相差 0.54 分。在这套综合测试中,StartLux 的直接判断路线已经取得了高于 Jev 的成绩。
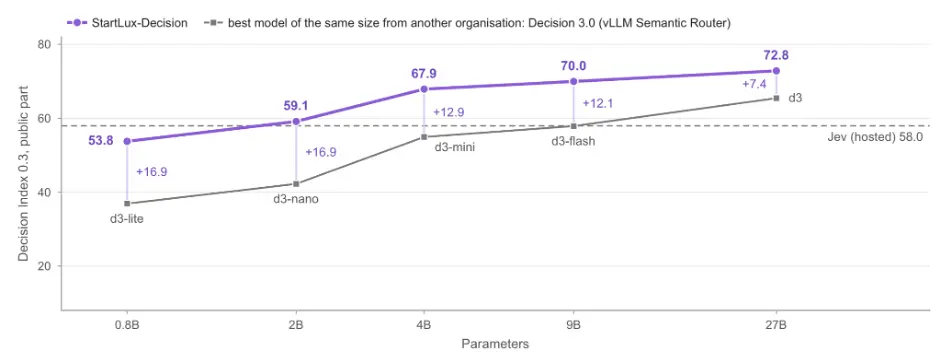
这种优势也延伸到了较小规模的模型。2B Instant 取得 59.14 分,略高于 Jev 托管版的 57.96 分;4B 和 9B Instant 分别取得 67.88 分和 69.96 分。在 0.8B 至 27B 五个规模上,StartLux Instant 均超过了参评的同规模最强第三方决策模型,分数优势约为 7.4 至 16.9 分。
既然 Instant 已经取得较高分数,AutoThink 增加的推理能力究竟带来了什么?团队提出的另一项基准 DecisionPivot 提供了更具体的观察角度:当一道题的关键条件发生改变时,模型能否识别变化,并相应调整答案。
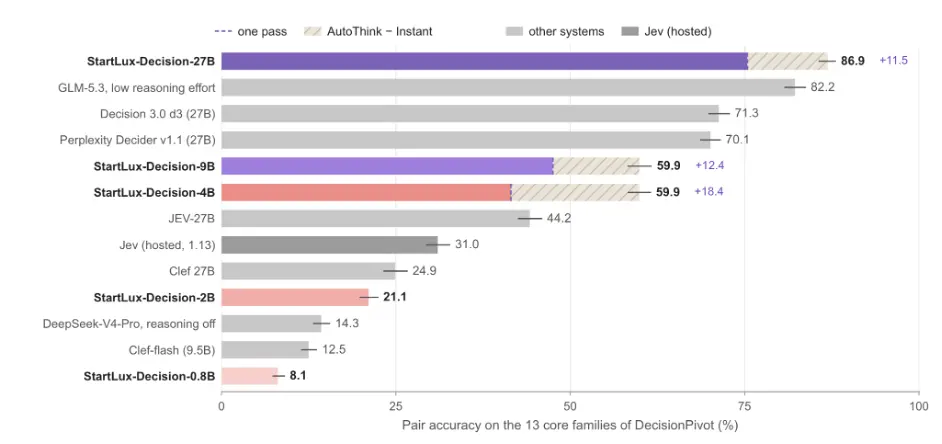
在这类任务上,Instant 与 AutoThink 的差距明显扩大。27B Instant 的成对准确率为 75.4%,AutoThink 达到 86.9%,提高 11.5 个百分点。作为对照,Jev 托管版为 31.0%,Decision 3.0 d3 为 71.3%,Perplexity Decider v1.1 为 70.1%,采用低推理强度的 GLM-5.3 为 82.2%。这些结果表明,额外推理在需要识别和处理关键条件的任务中,能够带来更明显的收益。
二、“拿不准再想”,AutoThink 如何决定是否启动推理?
StartLux 此次提供了 Instant 和 AutoThink 两条不同的决策路线。开发者向模型输入当前状态、问题和候选选项,模型返回各选项的概率。对于任务路由、工具调用、权限判断等场景,程序可以根据这些概率选择后续动作。两条路线的主要区别在于,模型是否需要生成额外的推理过程。
Instant 覆盖 0.8B、2B、4B、9B、27B 五种规模,通过一次前向计算输出选项概率,不先生成一段推理文字。为了充分利用完整输入,Instant 在全注意力层采用双向注意力,使前面的内容也能结合后面的问题和选项进行计算,以提升单次决策的准确率。
这种设计也使其适合高频决策场景。根据团队公布的推理测试,在单张 NVIDIA H200 GPU 上,采用 vLLM、单个并发请求的条件下,0.8B 至 27B Instant 模型的单次请求中位延迟约为 25 至 52 毫秒。这一结果来自特定硬件和测试配置,实际延迟仍会随输入长度、部署环境及并发负载变化。
AutoThink 则覆盖 4B、9B 和 27B,保留了生成推理所需的因果注意力。它首先计算各选项的初始概率:如果最高概率达到阈值,模型就直接返回;没有达到阈值,模型才生成推理过程,再次计算概率。系统最后融合两次结果,默认给推理后的结果 75%权重,初始结果 25%权重。
这一机制的关键,是开发者可以调整启动推理的阈值。当前服务默认阈值为 0.6,论文公布的主要 AutoThink 成绩使用 0.9。阈值越高,初始判断越难直接通过,模型就越可能进入推理流程。在仓库的一组对照实验中,团队将 27B AutoThink 的阈值从 0.9 降至 0.6,DI 0.3 得分由 73.22 降至 72.85,DecisionPivot 成对准确率却从 88.1%降至 68.4%。
这组结果揭示了按需推理的一个重要取舍:减少推理对综合评测分数的影响可能较小,但在需要识别复杂条件的决策任务中,却可能导致更明显的性能下降。因此,开发者不能只根据总体榜单成绩选择阈值,还需要考虑实际任务的复杂度,以及漏掉一次必要推理可能产生的后果。
团队还统计了模型在 DecisionPivot 核心任务上的实际决策过程。在 7800 个样本中,27B AutoThink 直接回答了 39%的问题,这部分准确率为 96%;其余 61%的问题进入推理流程,准确率从初始判断的 57%升至融合后的 93%。在这些启动推理的问题中,系统纠正了 1783 个初始错误,同时也引入了 94 个新错误。
需要注意的是,上文所说的“思考”特指生成额外的显式推理过程,并不意味着 Instant 完全不进行计算或判断。更重要的是,触发条件依赖模型自己的初始置信度。如果模型一开始就对错误答案具有较高置信度,仍可能直接跳过推理。因此,按需推理并不能从机制上消除过度自信的问题。
为了展示决策模型的实际使用方式,StartLux 还公布了多个演示。在一段国际象棋演示中,初代 StartLux-Decision-v1-27B 执白对阵 Jev 1.13,在第 19 回合完成将杀,双方均未使用搜索。
团队还将该模型用于《星际争霸Ⅱ》人族机器人的战略决策,并展示了战胜内置 Hard AI 的结果。
相比游戏任务,连续视觉决策演示更能呈现这种模型在动态环境中的使用方式。火箭发射演示中,模型根据连续画面识别尾焰、烟雾、发射塔及飞行阶段的变化,并针对每帧画面回答九个决策问题。
洪灾救援演示则要求模型持续跟踪救援人员、幸存者、吊索及救援篮的位置和状态,更新对救援进度及任务优先级的判断。
三、推理不能无限进行,RLCD²如何减少计算开销?
当模型判断某个问题需要额外推理之后,还面临另一个问题:究竟应该生成多少推理内容,又该在什么时候停止?如果模型不断延长推理过程,即使最终答案更准确,也可能失去快速决策的意义。
为此,StartLux 团队提出了 RLCD²强化学习方法,全称为 Reinforcement Learning for Calibrated Deliberative Decisions。它不单纯奖励模型给出正确答案,而是关注生成的推理能否改善决策概率的质量,并对超过软长度预算的推理施加惩罚。
RLCD²位于整个训练流程的最后阶段。在此之前,团队先通过监督微调和决策样本训练建立模型的基础判断能力,再通过推理监督样本教会 AutoThink 生成并结束推理过程,最后使用强化学习进一步优化推理质量和生成长度。论文披露,基础训练涉及不同规模的百万级样本,AutoThink 的推理监督阶段则使用约 4000 至 21000 条样本。
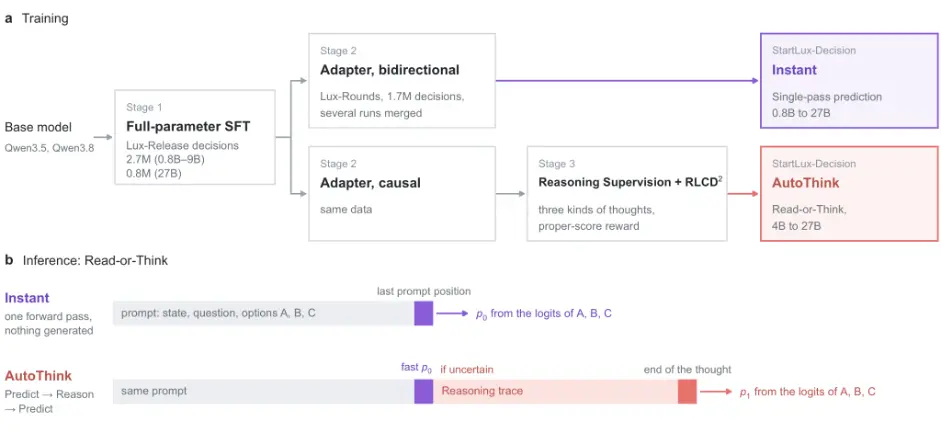
具体训练时,团队保留一个参数冻结的模型副本,作为评分者,比较推理前后的选项概率,并利用概率评分规则衡量推理带来的改善。负责生成推理的模型则持续更新参数,学习哪些推理过程能够真正改善判断,同时减少不必要的生成长度。由于评分者保持固定,训练过程能够以相对稳定的标准衡量推理收益。
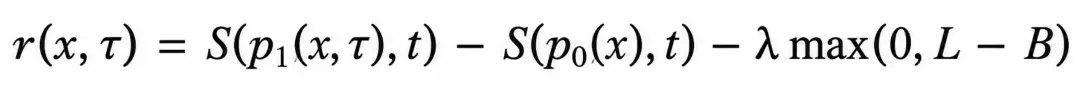
在 2986 个留出样本上,团队对强化学习前后的模型进行了测试,每道题均启用推理。9B 模型在生成限制内正常结束推理的比例从 45.9%升至 93.9%,平均推理长度从 2494 个 Token 降至 868 个,减少约 65%;与此同时,最终答案准确率从 80.38%变为 80.48%,几乎没有变化。
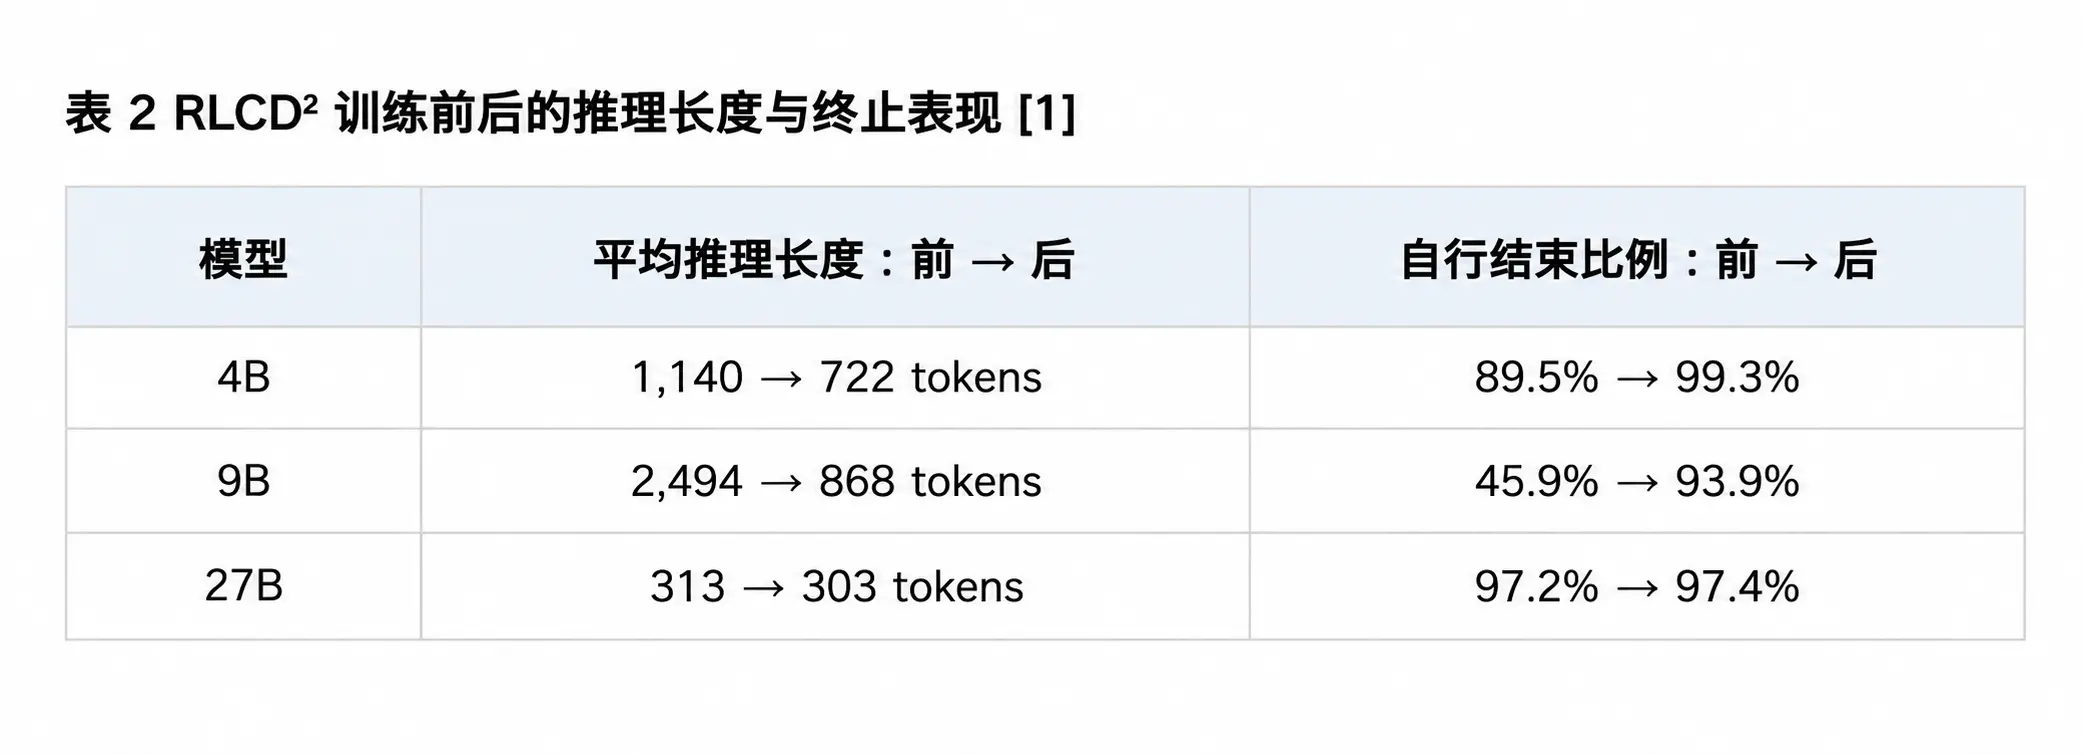
这说明,RLCD²在这组实验中的主要收益来自推理效率,而非大幅提高准确率。不同规模模型的效果也并不完全一致,例如 27B 模型在 DecisionPivot 上的成对准确率由强化学习前的 87.2%变为 86.9%,略有下降;9B 模型则由 53.3%提升至 59.9%。因此,更准确的结论是:这项方法能够改善推理长度和结束行为,并在总体上维持决策性能,但不保证所有模型的准确率都会进一步提升。
如果将比较范围扩大到“完全关闭推理”和“按需启动推理”,额外计算的价值会更加明显。团队在保持 AutoThink 模型不变的情况下进行对照:9B 模型在 DecisionPivot 上的成对准确率从 22.3%提升至 59.9%,平均每题增加 1365 个推理 Token;27B 模型则从 48.0%提升至 86.9%,平均每题生成 304 个推理 Token。这里的平均值包含未触发推理的题目,因此反映的是整个测试集上的平均生成开销。
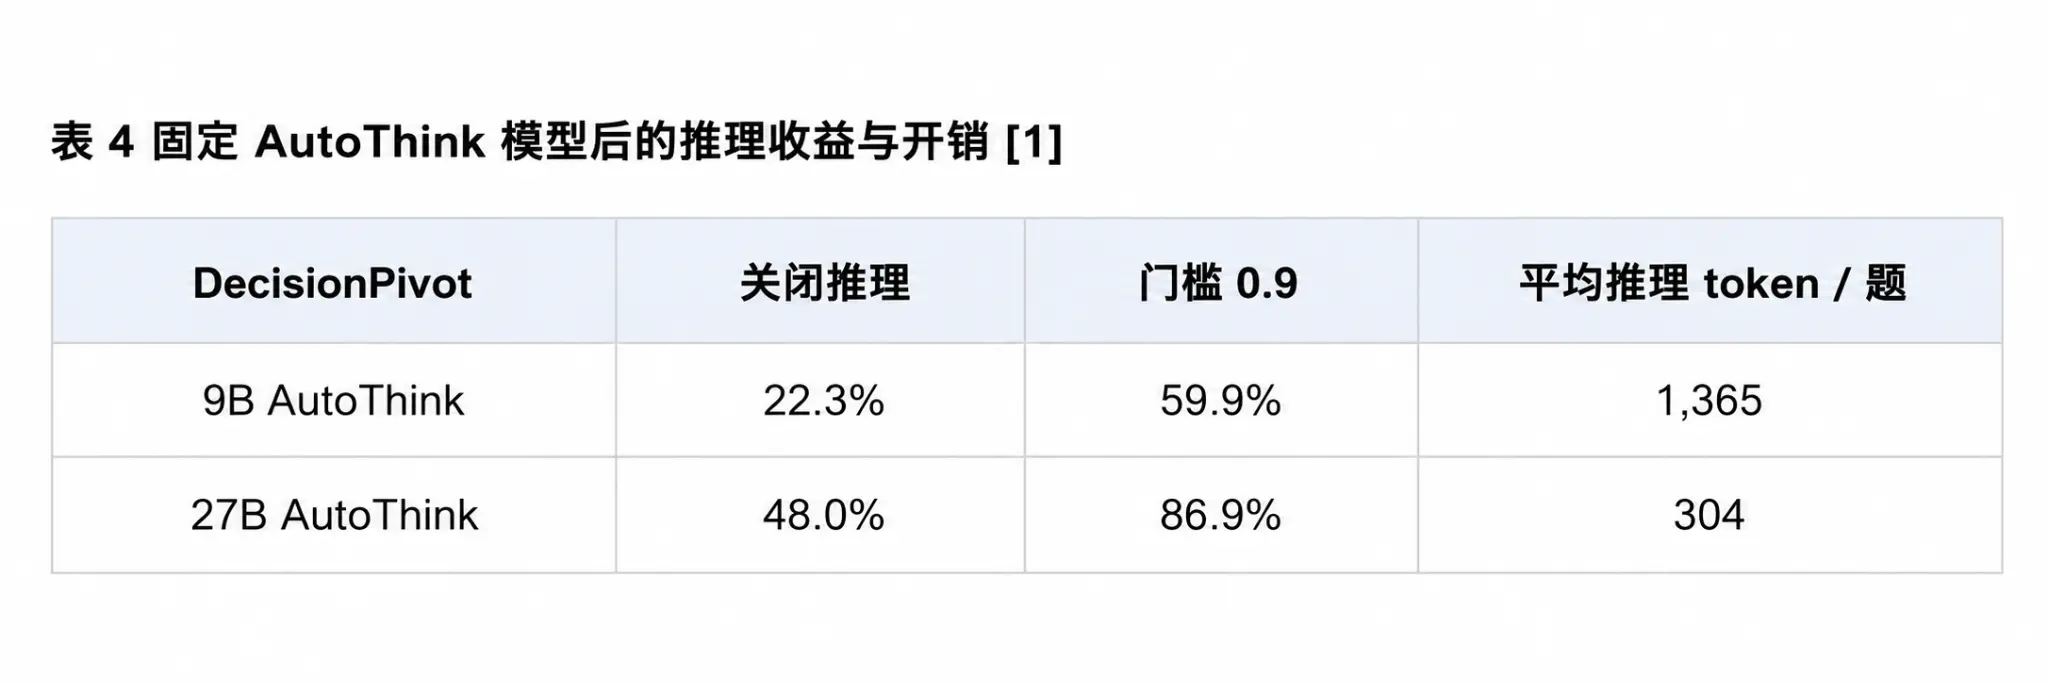
一个有意思的现象是,27B 模型虽然参数规模更大,却在这组实验中用更少的平均推理 Token 获得了更高的成对准确率。这说明,推理 Token 数量并不能单独代表模型完成决策的能力。不过,Token 更少也不直接等于运行成本更低:27B 模型每个 Token 的计算开销更高,实际成本仍取决于硬件、推理吞吐量及部署方式。
四、答对之外,模型能否抓住关键细节、给出可信的概率?
在评测成绩之外,StartLux 团队还关注两个问题:当条件发生变化时,模型能否随之改变判断?当程序根据模型给出的概率筛选答案、分配任务时,这些概率是否仍然可靠?
StartLux 此次发布的 DecisionPivot 基准,首先尝试检验模型对关键条件的敏感性。其核心部分包含 13 类程序生成任务、共 7800 个样本,覆盖权限判断、调度冲突、工具调用有效性及目标状态验证等场景。不同于只检查一道题是否回答正确,DecisionPivot 通过改变问题中的关键条件,观察模型是否随之调整判断。
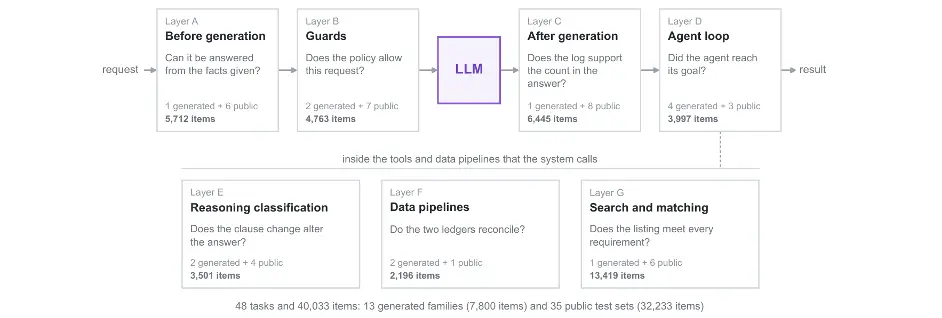
具体来说,DecisionPivot 使用成对准确率:只有模型同时答对一组对照问题中的所有案例,该组才算正确。例如,两道题只有一个关键条件不同,正确答案分别为“是”和“否”。如果模型两次都回答“是”,虽然答对了其中一道题,整组仍然不得分。这种设计有助于识别模型是否只是倾向于某个固定答案,而没有根据条件变化调整判断。
为了提高基准的可复核性,团队还公开了题目生成器、独立求解器、评分程序和数据哈希。核心任务的答案由生成程序计算,再通过独立求解器验证。
除了判断正确与否,另一个更加贴近实际应用的问题是:模型给出的置信度,是否真的对应它答对问题的概率?例如,当一个 Agent 系统根据模型的置信度筛选候选答案时,系统是否能够继续相信“90%的把握”大致意味着 90%的正确率?
论文中的一项实验显示,团队使用 9B 模型验证回答时,在独立回答场景中,置信度位于 80%至 90%区间的部分,实际正确率达到 92%;但当系统从 32 个候选中挑选最高分回答后,同一置信区间的正确率降至 78%。也就是说,即使底层模型没有发生变化,经过筛选之后,置信度与实际正确率之间的关系也可能改变。
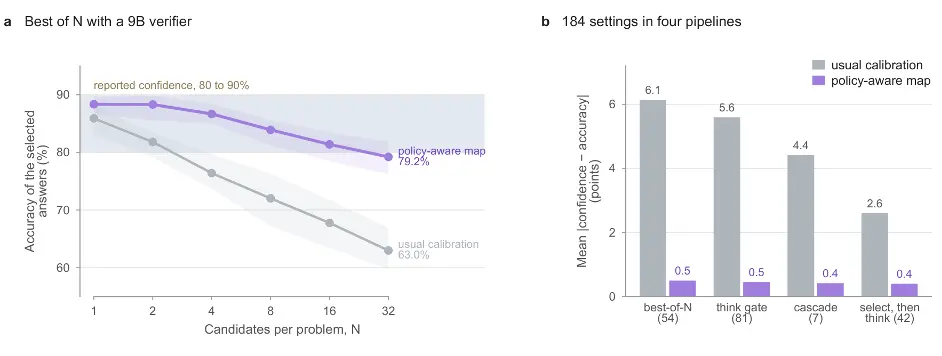
这并不意味着筛选答案一定会降低系统的总体正确率。真正的问题是,开发者如果仍然沿用单独回答时设定的置信度阈值,就可能错误估计筛选结果的可靠性。例如,原本设定“置信度超过 90%即可自动执行”的规则,经过候选筛选或多模型路由后,未必仍对应原先预期的错误风险。
针对这一问题,StartLux 提出了策略感知校准。研究人员先让带标签的校准样本经过实际采用的筛选和路由流程,再根据返回结果的置信度及相关分数,拟合新的概率校准映射。对于候选答案筛选,这一过程还会考虑候选数量、平均分等因素,而无须改变底层模型的参数。
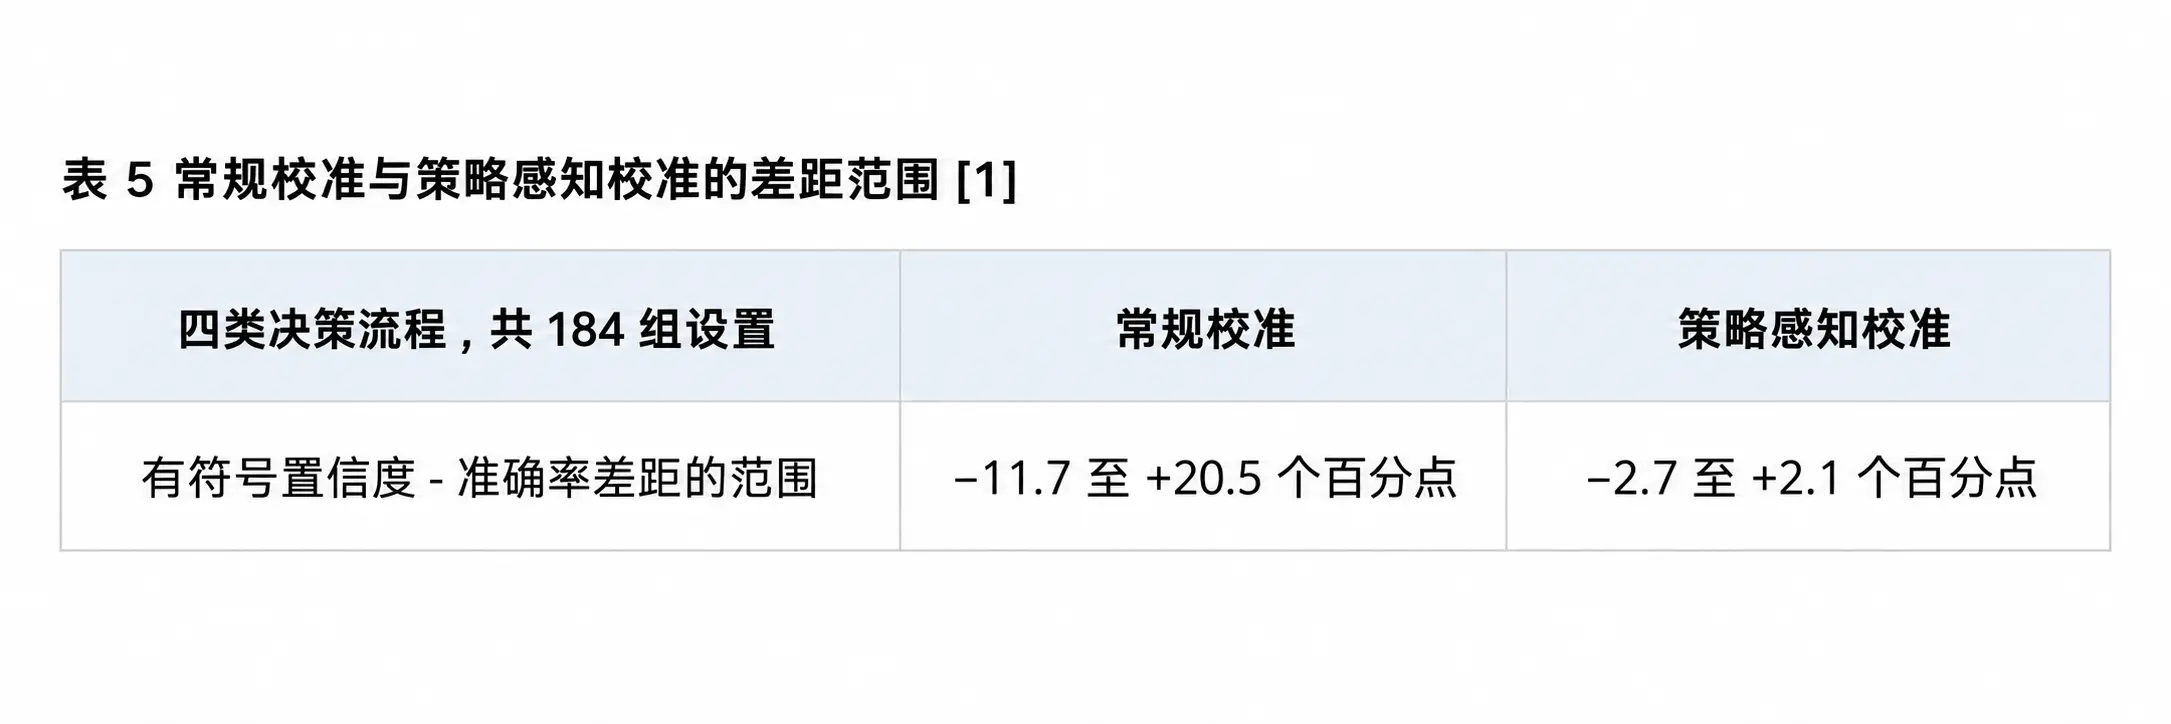
在覆盖候选筛选、推理门控、级联调用等四类流程的 184 组设置中,团队报告,校准后的置信度与正确率之间的有符号偏差落在−2.7 至+2.1 个百分点之间。不过,当校准映射应用到未见过的数据集时,仍出现最高 6.1 个百分点的过度自信。这说明策略感知校准能够改善已评估流程中的概率可靠性,但其效果并不保证在新的数据分布下保持不变。
StartLux 目前已公开模型权重及推理代码,支持通过 vLLM、llama.cpp 和 MLX 部署,并提供不同规模的量化版本。不过,开发者需要注意其许可证限制:推理代码使用 Apache 2.0 许可证,模型权重则采用 CC BY-NC 4.0,仅允许非商业使用;商业部署需要另行取得授权。
随着 Agent 系统越来越多地承担工具调用、任务分配和权限判断等工作,模型需要提供的不只是一个答案,还包括这个答案有多大把握,以及是否值得投入更多计算进一步确认。StartLux 此次围绕快速决策、按需推理和概率校准展开的研究,正是试图解决这些问题。
不过,现阶段的领先成绩仍主要来自特定评测环境。DecisionPivot 提供了可验证的复杂决策任务,但程序生成的测试题与真实生产系统之间仍存在距离。模型在不同业务数据、调用负载和推理阈值下的延迟、成本与错误率,还有待更多实际部署验证。对于正在构建 Agent 系统的开发者来说,这类模型提供了一种新的技术选择:让专门模型承担部分高频决策,在必要时再增加推理计算。它能否真正改善系统可靠性,最终仍要由具体工作流中的表现来证明。
代码、模型及论文链接:
-
GitHub(推理引擎及评测)
https://github.com/StartLuxLabs/StartLux-Decision
https://github.com/StartLuxLabs/DecisionPivot
-
Hugging Face 模型合集
https://huggingface.co/collections/startlux-models/startlux-decision-v11-autothink
-
论文