在前几天DeepSeek发生崩溃数小时事件后,AI圈很多人都在猜测DeepSeek要有大动作。结果,DeepSeek真的在本周末发布重磅消息:发布
DeepSeek-V4.1-Flash-1017版本,还打出一句口号:“许愿式编程一键成真”。从写代码到做项目,AI编程的门槛又降低了。
很多人在问既然升级幅度这么大,为何不直接命名4.2?原因在于基础模型的架构没有变化,更新侧重现有模型的能力迭代。从官方释放的信号,到网友的实操测试,V4.1值得关注的远不止一个新版本。
在投资端 DeepSeek也没闲着,近期传出了DeepSeek投资多笔具身智能领域的消息。 一边是让AI更好完成数字世界里的任务,一边探索机器人如何在真实世界中的行动, DeepSeek的战略版图越来越 大了。
性价比拉满的“许愿式编程”
DeepSeek这次更新,几乎没有给外界留下太多预告。
不过在DeepSeek正式更新之前,有网友就发现模型列表中曾短暂出现“DeepSeek V4.1 Flash-1017”这一名称。“1017”正好对应10月17日,也符合以日期标记模型快照的常见方式。
为什么不是4.2?因为 V4.1 Flash-1017只是对现有版本的一次能力迭代,官方把它概括为“性能—费用的帕累托改进”:性能往上,成本往下。
需要注意的是,降本不是降价,API调用方式和价格都维持不变,开发者仍用 deepseek-flash就能访问新模型。真正的机制在于任务运行时间和输出长度都变短,而大模型按token计费,输出变精简、单次耗时变少,实际综合成本自然就会变少。
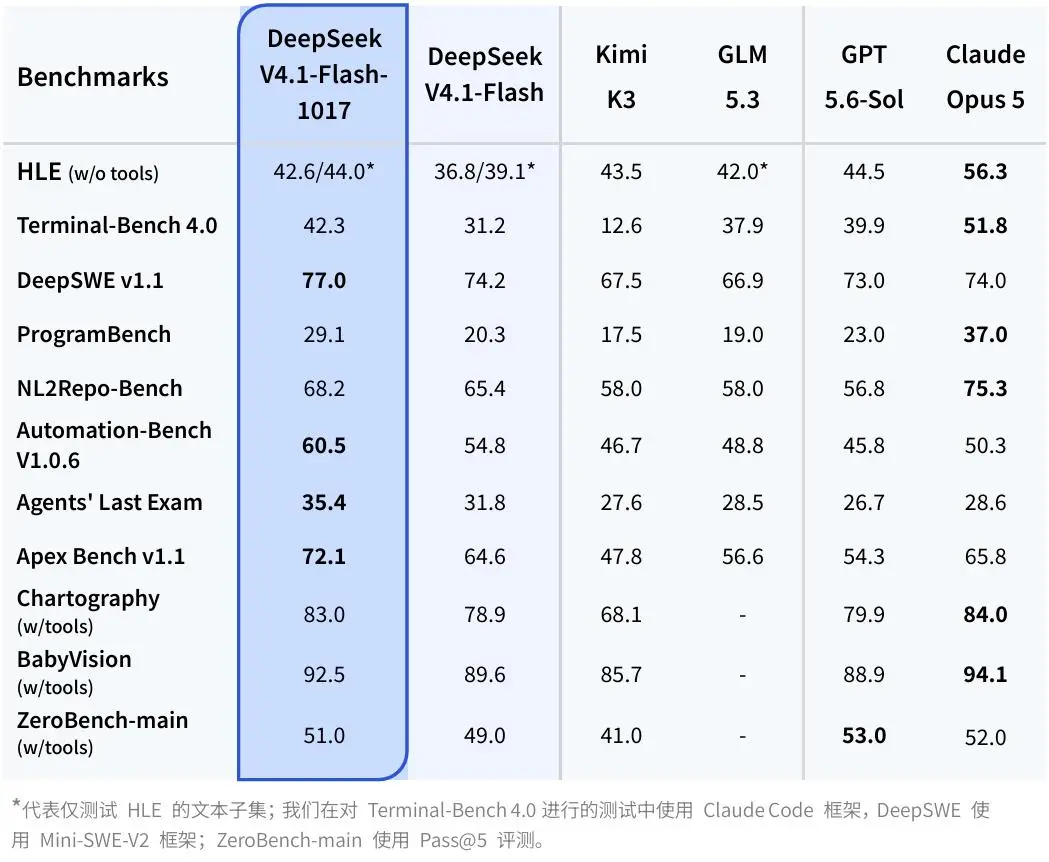
DeepSWE v1.1的Pass@1从74.2升到77.0,超过Claude Opus 5的74.0和 GPT-5.6 Sol的 73.0;Terminal-Bench 4.0从31.2跳到42.3。这两项,考验的都是“独立把活干完”的能力。
不过它也不是全面碾压,在专家级难题 HLE上只拿42.6,明显低于Claude Opus 5的56.3。这次升级方向明确:在工程能力上全力压上,在纯知识广度上不做消耗。
最关键的变化,是模型更强调从零构建完整项目。官方称,新版通过
“基于自反馈的强化学习”训练——模型写完代码自己运行、自己检查、自己修改。
官方展示了四个案例:故宫 3D建模、网页赛车游戏、使用Godot引擎复刻《传送门2》,以及名为Valley of Ages的3D场景。分别对应三维场景搭建、游戏逻辑开发、游戏引擎应用和交互式环境构建,官方表示这些项目只用了少量提示词和参考素材,交互轮次也很短。
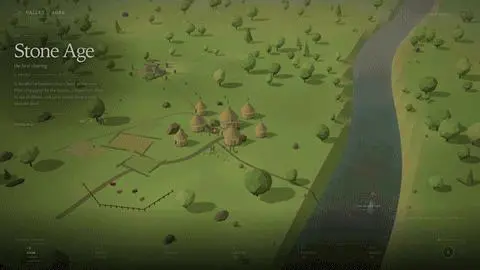
“许愿式编程”的意义就在这:只用寥寥字数,就能帮助用户生成符合心理预期的结果。
有开发者许愿把一张剪纸变成海边小镇。模型需要通过代码构建网页场景,让房屋随着页面滚动逐步立起,灯塔、码头和纸浪依次出现,镜头视角也随之变化。实测中,房屋立起之后能看出纸张的厚度、折痕和投影。拖动时间滑块,天空、海面与窗灯还能随昼夜变化。
理解顺畅度的提升则是集中好评:V2EX上有开发者说旧版“像被降智了一样”,换到1017后“恢复正常了”;Trae论坛有人用“鸡同鸭讲”形容老版,表示换新版后“有种自己智商都提高了的错觉”。知乎答主用新旧版本各做一次马里奥赛车,旧版的跑道是歪的,用户的车一动不动;新版画面精美,操作流畅。
但也有人泼冷水。 Reddit上一名从事编程智能体与评测工作的Nebius员工,使用自己日常工作中的10项编程任务测试新版本,每项任务重复运行3次,并通过隐藏测试检查结果。
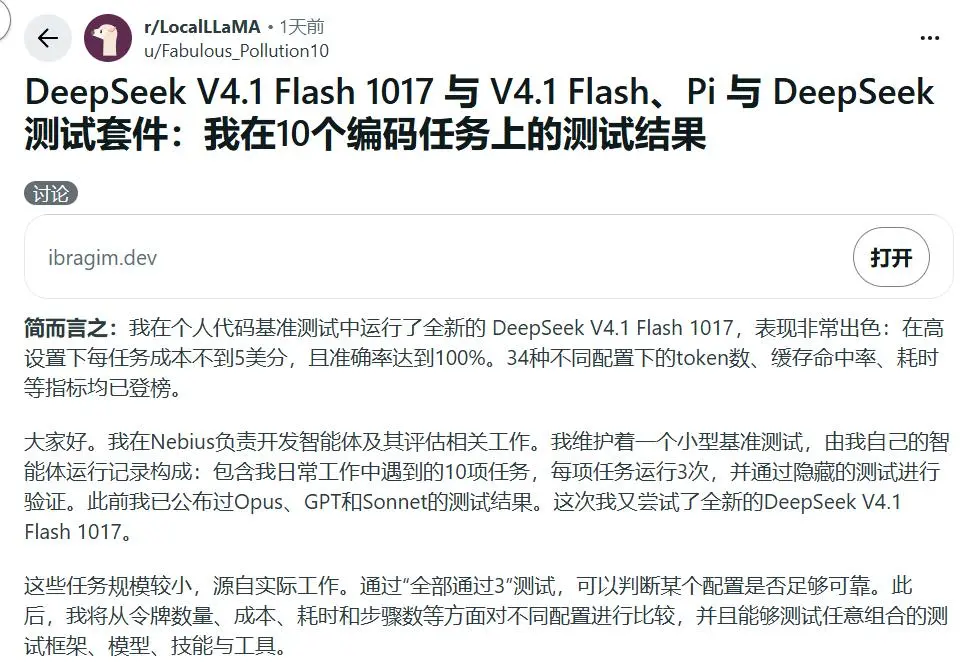
在个人测试中,V4.1-Flash-1017搭配Pi编程框架、采用较高推理强度时,30次运行全部通过;单项任务平均成本约4.5美分。相比之下,旧版V4.1-Flash在另一组最高推理强度测试中,30次运行有24次通过。
测试者还报告,新版每项任务约消耗55万Token。即使单次成本不高,Token用量也提醒用户:模型回答得更快,不代表整个工作流一定更省资源。
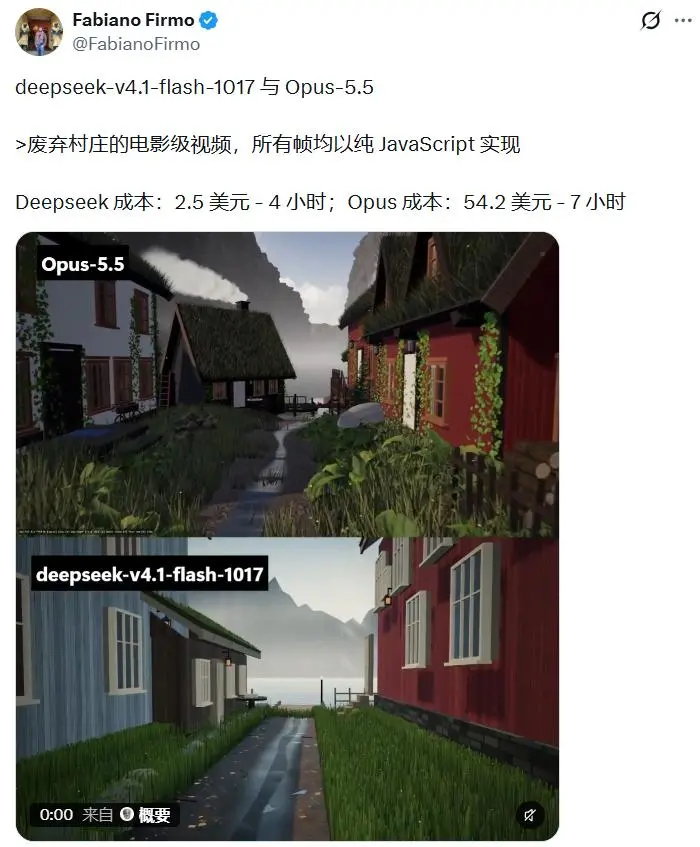
还有网友尝试生成一段 15秒的电影级短视频,V4.1-Flash-1017成本2.5美元花费4小时, Claude Opus成本54.2美元花费7小时。可以看到这次更新改变的,是把“够强”和“够便宜”之间的距离又缩短了一截。
梁文锋的AGI雄心
模型更新迎来一次AI圈的狂欢,但也别忽略了DeepSeek在资本层面的大动作。简而言之,DeepSeek正在给下一代基础模型购买“物理世界的入场券”。
10月18日,行业消息称DeepSeek拟投资前逐际动力人形机器人基础模型负责人俞涛的创业公司,方向是LLM+具身智能,前后两轮估值分别约7000万美元和2亿美元。
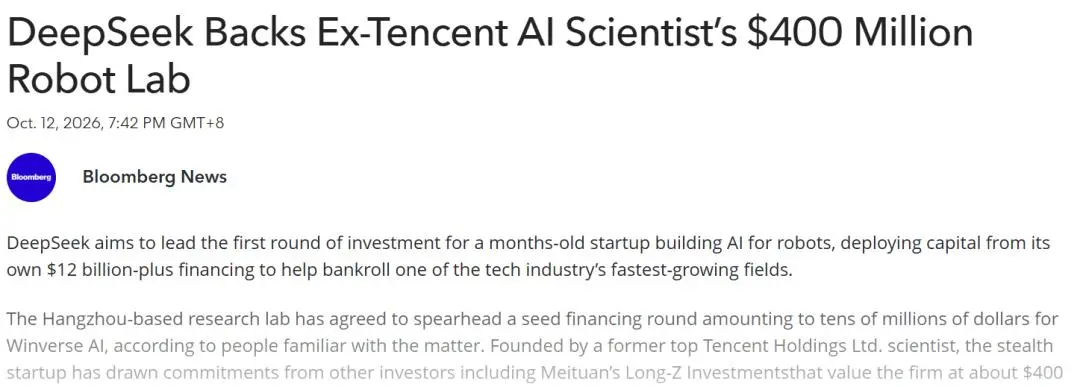
10月12日,据 报道 DeepSeek拟领投前腾讯科学家胡瀚创办的Winverse AI,投后估值约4亿美元,美团龙珠也在参与方之列。
再往前,8月DeepSeek出资约1.41亿元参与宇树科技IPO战略配售,锁定期36个月,并签了联合研发备忘录。
从具身智能公司角度看,这三笔投资,买下了技术栈里位置完全不同的三层能力。
宇树提供的是“身体”:拥有大量真实机器人,这是稀缺的真实物理数据入口。
胡瀚代表“大脑和眼睛”:他是Swin Transformer主要作者、ICCV 2021 Marr Prize 得主,研究方向从视觉基础模型延伸到视觉语言模型(VLM)及具身基础模型,解决“机器人怎样看懂世界”。
俞涛的位置更接近“小脑和运动神经”:他在逐际动力从零搭建了motion mimic 和全身跟踪系统System 0。胡瀚从“大脑”往身体走,俞涛从“身体”往大脑走,两条路线最后在一个地方汇合。
梁文峰的这一步早有伏笔。其公开的AGI路线图规划为六阶梯递进结构:语言模型→思维链→Agent→持续学习→自我迭代→具身智能。如今走向具身智能的脚步正在加速。
过去,大模型圈认为VLA难以通用,但9月GPT-6 Astra的横空出世让人看到,不懂具身也能做出泛化的具身模型。与此同时,Coding能力肉眼可见到顶,大模型公司需要新风口承接震撼,入局具身成了必然。
不过具身是软硬件耦合的苦活,大模型公司自身场景和数据有限,这也是DeepSeek为何先投“大脑、小脑、身体”,而非直接造整机的原因。
具身赛道烈火烹油,据媒体统计,仅今年上半年国内融资总额就超900亿元、是2025年同期的5倍;但下半年风向骤变,机构上会项目锐减,国家层面也提醒机器人产业“防止盲目跟风、一哄而上”。
DeepSeek在这个节点成为新的接盘方/整合者,加速行业向少数大脑+多数身体分层。不难看出,DeepSeek正在从数字世界向物理世界延伸。
早在其招聘动态中就显示出端倪,招聘多模态理解研究员的职位描述显示:AGI绝不会止步于文本,迈向AGI的关键一环,在于让模型拥有理解物理世界的能力。
今天的模型竞争还在跑分榜单和 API价格战里,下一场竞争,就在产线上、在卧室里、在街头中。
本文来自微信公众号“数智奔流”,作者:田渝,36氪经授权发布。