不新增专家示范,也不把候选动作放进外部环境里试错,世界动作模型能否依靠自己的想象继续进化?
当前,已有部分模型能同时预测未来视频和机器人动作,并将视频预训练中积累的知识迁移到陌生任务上。然而,这些模型往往很难产出稳定表现。视频里完成了任务,配套动作却未必与画面一致,生成结果也无法直接用于训练。
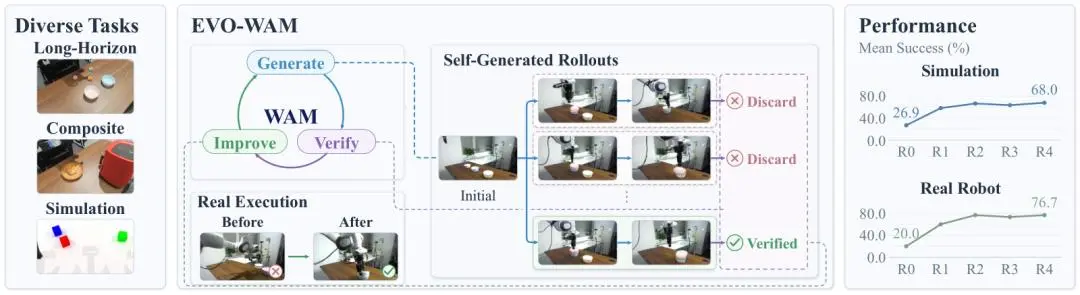
EVO-WAM关注的正是这个问题:能否从模型自己生成的轨迹中找出可靠经验,用来改善它在未见任务上的表现?
它让模型自主生成完整的执行画面与动作,筛选通过验证的经验,再用这些经验训练自己,完成想象→验证→学习的循环迭代。
几轮迭代后,在基本保留已见任务性能的同时,模型Cosmos3在七个未见仿真任务上的平均成功率从26.9%提高到68.0%;在三个未见真机长时序组合任务上,从20.0%提高到76.7%。
△
模型自己的生成结果能成为训练数据吗
世界动作模型(World Action Model,WAM)的一个特点是,生成动作的同时,也生成这些动作预期对应的未来画面。这使得它有机会自己构造训练所需的视频与动作轨迹。
这种机会来自模型已经学到的知识。视频预训练覆盖了大量物体运动、接触和场景变化,即使某个任务没有出现在机器人示范中,模型仍可能生成有用的行为。论文观察到,在相同初始条件下,多次生成的结果中既有失败尝试,也有描绘任务完成的轨迹。
如果能识别其中可靠的部分,就有可能把这些偶尔出现的成功尝试转化为学习信号。已有研究利用单独的世界模型为策略提供经验,EVO-WAM则进一步利用WAM自身联合生成视频和动作的能力,为未见任务提供监督。
首先要解决的是,如何让模型独立生成完整过程。常规闭环执行中,机器人做完一段动作,会收到真实摄像头画面和新的机器人状态,模型再据此预测下一段。自我想象没有这一步外部反馈,后续生成所需的信息必须由模型补上。
为此,EVO-WAM让WAM同时预测每段结束时的机器人状态,并使用最近生成的多帧画面继续预测。初始画面也会一直保留,作为物体和场景的参照。这样,模型便能从一张初始观测、机器人状态和任务指令出发,逐段生成完整候选轨迹。

△
视频里的成功还需要动作来验证
轨迹能生成出来,并不意味着它已经适合拿来训练。EVO-WAM需要回答两个问题:任务完成了吗?生成的动作与视频一致吗?
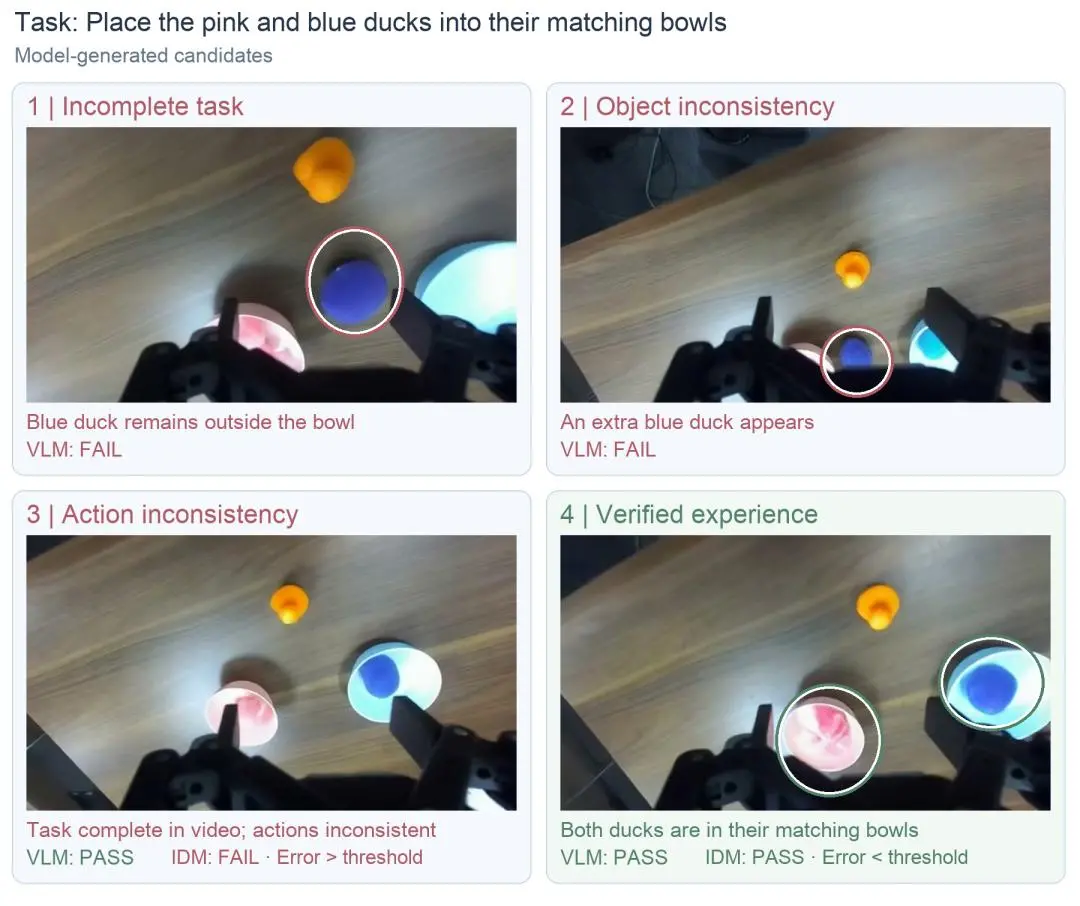
第一个问题交给视觉语言模型(VLM)。系统让VLM先描述画面中的物体与变化,再根据视觉证据判断目标是否达成。对于包含多个子任务的指令,需要检查相应条件是否满足,并找出完成任务的片段终点。
以放鸭子的生成结果为例,有的轨迹没有把鸭子放进碗里,有的画面中多出了一只鸭子。这些错误会让生成内容偏离任务或初始场景,不能直接作为成功经验保留下来。
但仅靠视觉判断,还有一类问题容易被漏掉:视频中的机械臂完成了操作,与之配套的动作却没有描述同样的运动。只看最终画面,很难发现这种不一致。
EVO-WAM因此引入逆动力学模型(IDM)。它根据视频中相邻观测的变化反推动作,再与WAM生成的动作进行比较。误差超过阈值的候选会被拒绝;满足任务完成和动作一致性要求的片段,才进入训练数据。
这一步为生成经验增加了动作层面的检查。IDM提供的是一致性检验,最终效果仍要通过真实执行评估。它的价值在于,筛选时不需要把每条候选动作都放进环境里试一遍。
△
把可靠经验留下来再学一轮
通过验证后,EVO-WAM保留从起点到任务完成位置的有效片段,而非无条件收下整段生成结果。这样,训练可以集中在已经验证的任务过程上,避免继续生成的无关动作混入成功示范。
这些片段会跨轮次积累,与原始训练数据一起用于微调WAM。更新后的模型再次生成候选,接受验证,再进入下一轮训练。模型的生成能力因此成为后续学习的数据来源。
这里的自我改进发生在训练阶段。初始场景、机器人状态和任务指令仍然需要提供,基础模型也已经接受过训练;省去的是为这些新任务额外采集专家示范,以及在筛选过程中执行候选动作获取反馈。
对于长时序组合任务,这条路径尤其值得研究:新任务的完整专家轨迹不易获得,但模型可能已经掌握其中一些运动和交互规律。EVO-WAM尝试从它自行生成的完整过程中,筛出可以继续学习的经验。
从仿真到真机检验新任务表现
研究团队在两种WAM骨干和两类环境中进行了评估。这里的“未见任务”,指这些任务没有出现在基础模型训练中;自训练阶段,模型会针对这些任务生成并学习自己的经验。
在RoboTwin 2.0的七个未见任务上,经过四轮自训练,Cosmos3的平均成功率从26.9%提高到68.0%,提升41.1个百分点;DreamZero从28.5%提高到46.4%,提升17.9个百分点。不同骨干都能受益,具体任务上的增幅则有所不同。
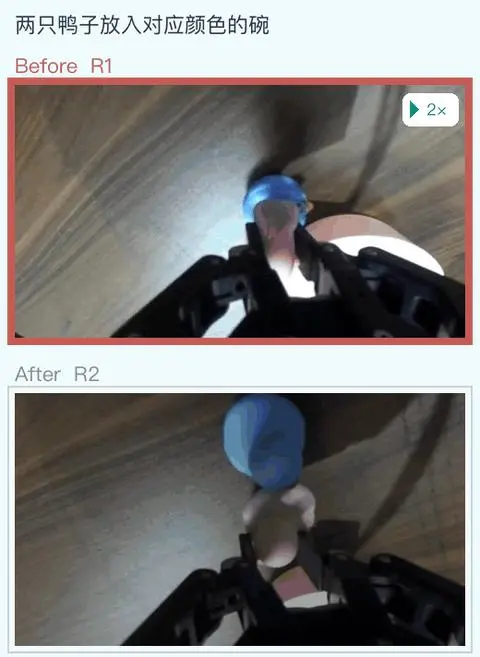
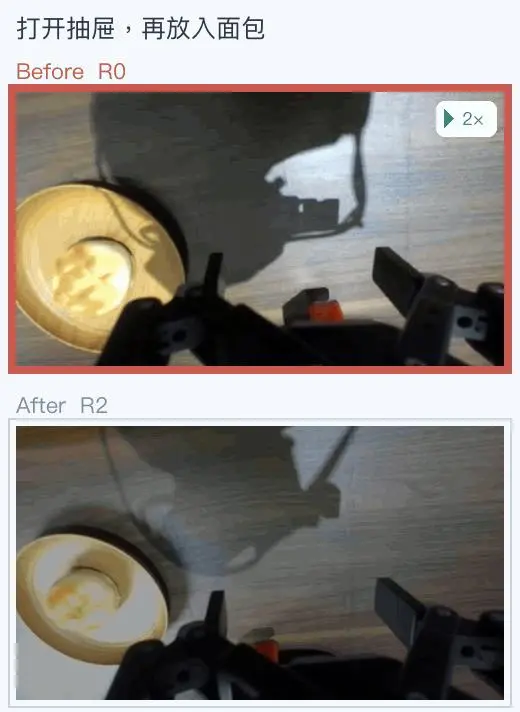
真机实验包含叠碗、将两只鸭子放入对应颜色的碗,以及打开空气炸锅抽屉后放入面包三个长时序组合任务。下面展示其中两项任务在自训练前后的真机表现。
△
空气炸锅任务则需要先拉开抽屉,再将面包放入。
△
每个策略在每项任务上测试10次,Cosmos3的平均成功率从20.0%提高到76.7%,提升56.7个百分点。

△
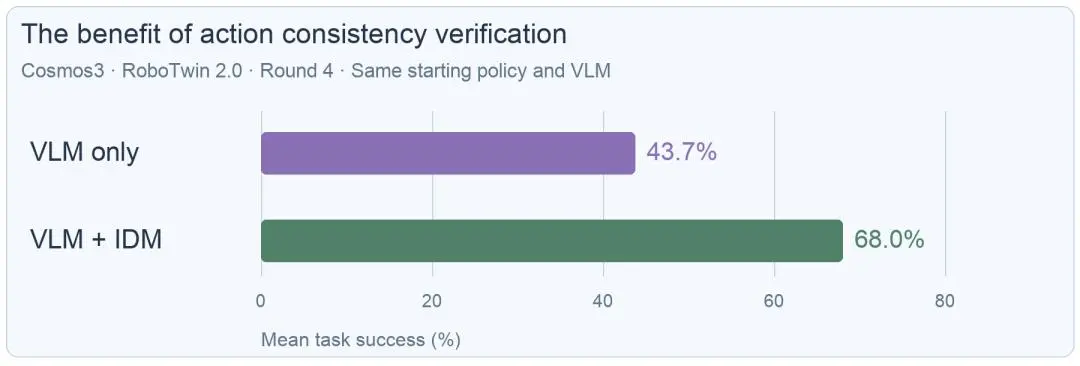
动作验证究竟带来了多少帮助?在相同起始策略下,仅使用VLM检查视觉完成情况,第四轮平均成功率为43.7%;加入IDM动作一致性检查后,达到68.0%。这说明,画面上的成功还不足以筛出高质量的动作监督。
验证器也不必固定为一个模型。保留IDM,将任务判断模型换成较小的Qwen3.5-27B后,第四轮仍达到65.7%。研究还发现,Cosmos3在已见任务上的表现基本得到保留。
△
提升并非每一轮都单调发生。Cosmos3在仿真中的收益主要出现在早期,第三轮曾有回落,第四轮再恢复;真机也存在轮次间波动。这提示,自训练效果仍取决于生成候选的质量和验证的可靠性。
自我想象也能成为泛化的来源
EVO-WAM展示了一条利用WAM自身生成经验改善新任务表现的路径:从视频预训练带来的知识出发,用任务完成和动作一致性验证筛选经验,再通过训练把这些经验转化为更好的执行能力。
这些结果表明,具身智能在新任务上的提升,未必每一步都依赖新增真实示范或环境试错。模型自身的想象,经过可靠验证并用于训练,也能成为改善泛化能力的经验来源。
论文:EVO-WAM: Evolving World Action Models through Video-Action Verification
arXiv:https://arxiv.org/abs/2609.38057
项目主页:https://evo-wam.github.io/
GitHub:https://github.com/Clausy9/EVO-WAM
Hugging Face Daily Paper:https://huggingface.co/papers/2609.38057
实现与实验细节咨询:Shiyang Zhou,shiyangzhou@stu.hit.edu.cn
本文来自微信公众号“量子位”,作者:EVO-WAM 团队,36氪经授权发布。