作者|定西
针对近日流传的“国内超一半算力在造爽剧”等说法,豆包公关负责人刘星回应称,相关算力数据“有些不靠谱”,字节公司总算力中,只有约10%用于视频生成模型的训练和推理。
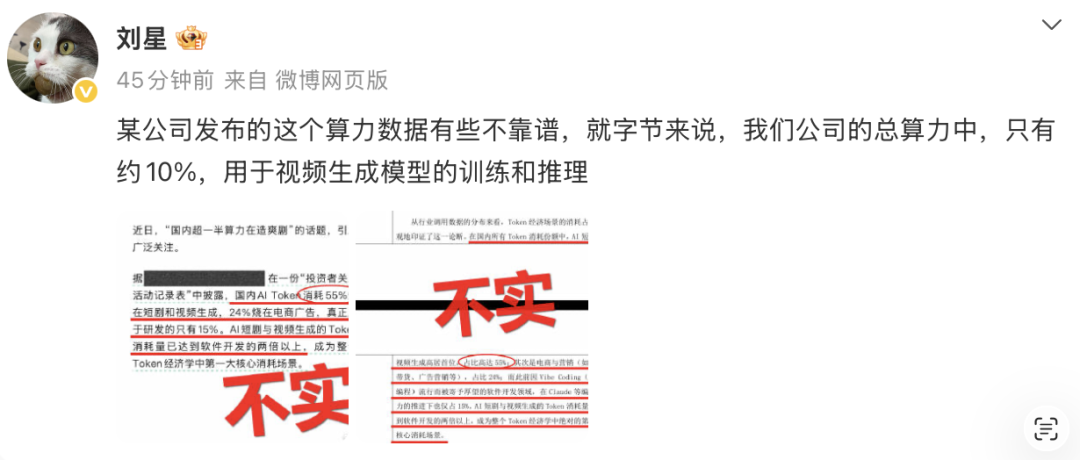
刘星写道:“某公司发布的这个算力数据有些不靠谱,就字节来说,我们公司的总算力中,只有约10%,用于视频生成模型的训练和推理”。随文发布的两张图片,均对有关AI短剧与视频生成消耗占比的内容标注了“不实”。
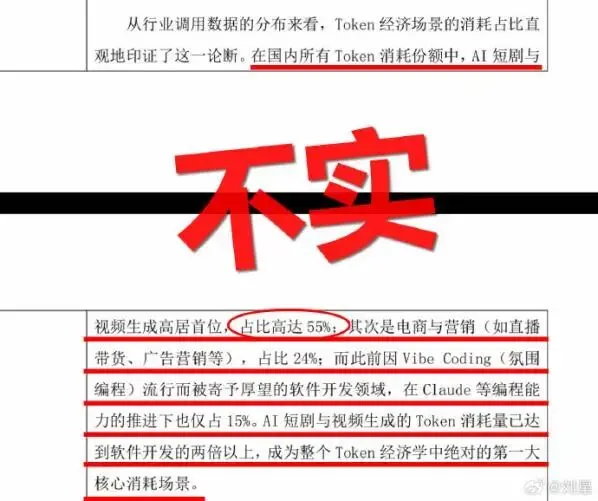
这场争议源于一组被广泛转引的数字:国内Token消耗中,AI短剧与视频生成占55%,电商与营销占24%,软件开发占15%。在传播过程中,这组数字被进一步概括为“国内超一半算力在造爽剧”,并引发对AI资源投向的讨论。
相关表述可以追溯至中文在线今年6月3日披露的《投资者关系活动记录表》。该文件记录了公司6月1日至2日的路演及电话会议。其中,公司以行业调用数据为依据,列出了上述三个比例。不过,文件未交代这组数据的具体统计机构、样本范围、统计周期及测算方法。
从原始材料到网络热议,几处表述变化值得注意。原文中的“AI短剧与视频生成”被简化为“爽剧”,“软件开发”被扩大为“研发”,而Token消耗占比则被直接替换成了算力占比。几种说法看似接近,实际对应的范围并不相同。
Token通常译为“词元”,是模型处理信息时使用的基本单位。在文本模型中,一个词可能被拆分成多个Token,也可能整体作为一个Token。它可以用来衡量模型处理的数据量,但并不是一张显卡、一小时计算时间或一度电的同义词。
在视频生成服务中,Token又与视频规格等因素相关。火山引擎的官方计费说明显示,视频价格由Token单价和用量共同决定,同等条件下,高分辨率视频价格通常高于低分辨率视频,输入是否包含视频也会影响价格。因此,讨论不同应用的资源消耗,需要先明确模型、任务和计量方式,不能仅凭Token数量直接推导全国算力的分配比例。
刘星此次披露的数据,也有明确的适用范围。他谈及的是字节公司总算力,以及其中用于视频生成模型训练和推理的部分。训练是模型学习的过程,推理则是使用训练后的模型生成输出或作出预测。两者属于不同环节,都会消耗计算资源。
这意味着,约10%与网传55%不能直接作为同一口径下的两个数字比较:前者涉及一家公司的总算力,后者声称描述国内Token消耗结构。刘星的回应提供了字节自身的情况,但并未给出全国视频生成算力占比,也没有披露字节其余算力的具体用途。
争议之外,视频生成技术确实已进入内容制作流程。字节跳动此前发布的Seedance,支持文字、图片、音频和视频四种模态输入,并提供内容参考和编辑能力。这类工具让创作者能够围绕角色、动作和镜头进行生成与调整,为短剧、广告等内容生产提供了新的制作手段。
目前,围绕“55%”的争议,仍需要更完整的数据来源和统计方法才能进一步核实。所以,大家还是先散了吧。