新智元报道
新智元报道

谷歌,终于把这块最硬的骨头啃下来了。
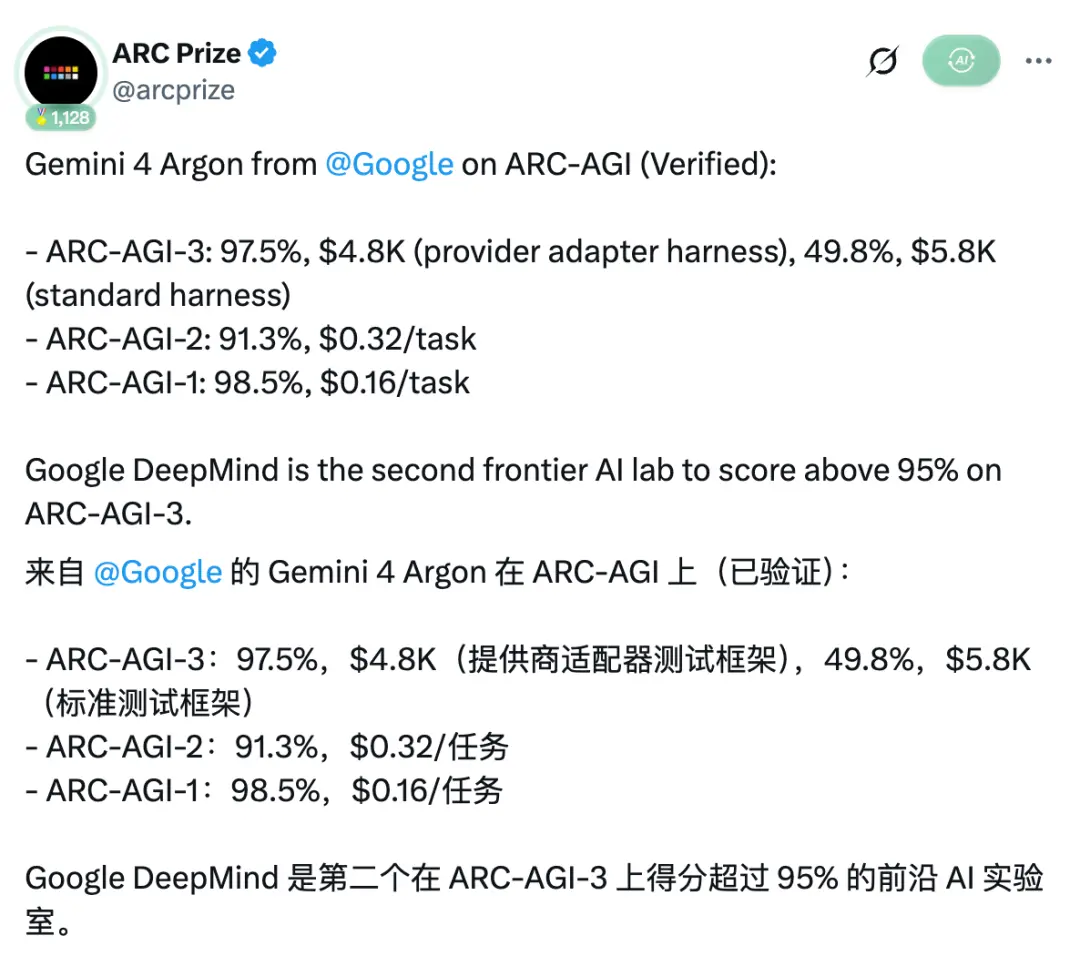
就在刚刚,ARC Prize官方在X上甩出了一张成绩单:
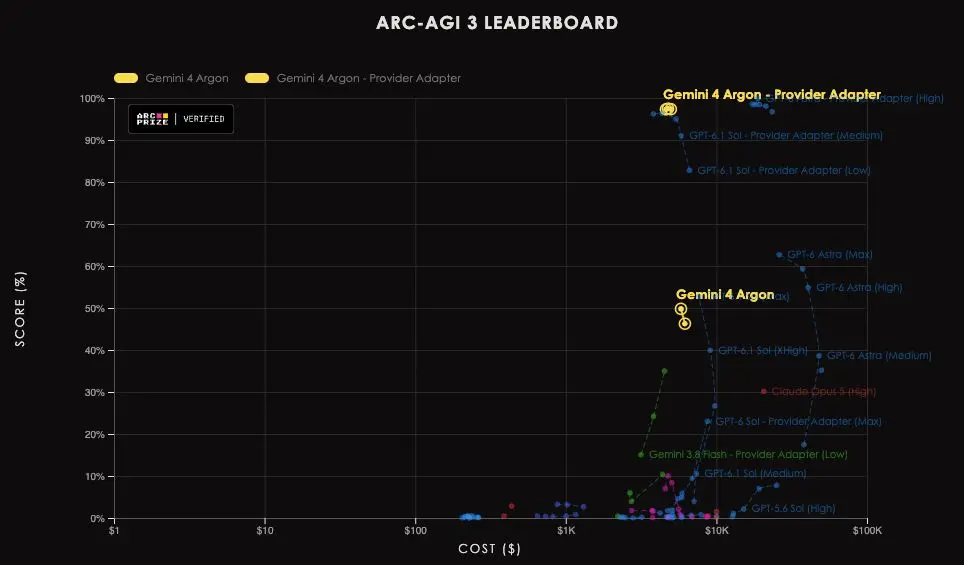
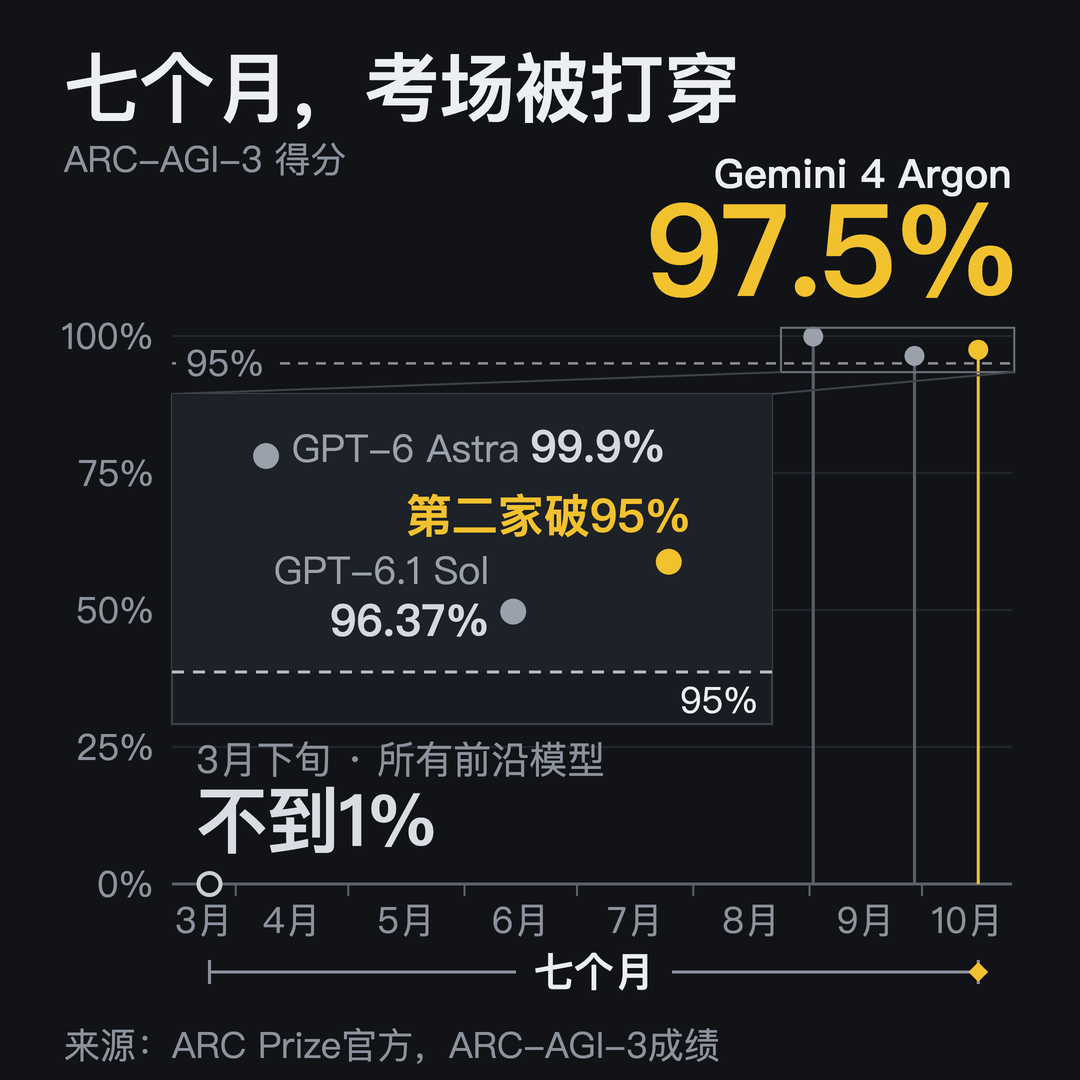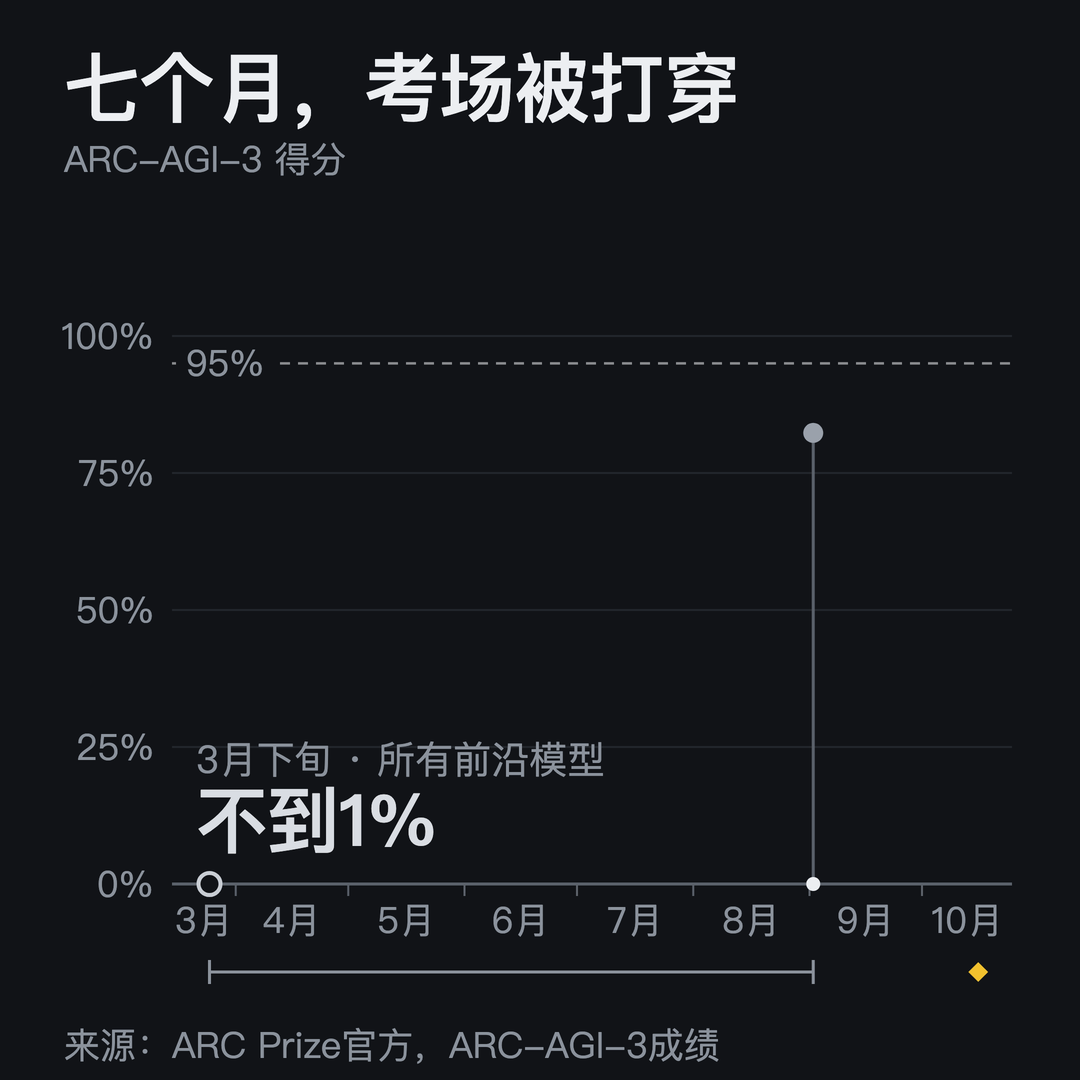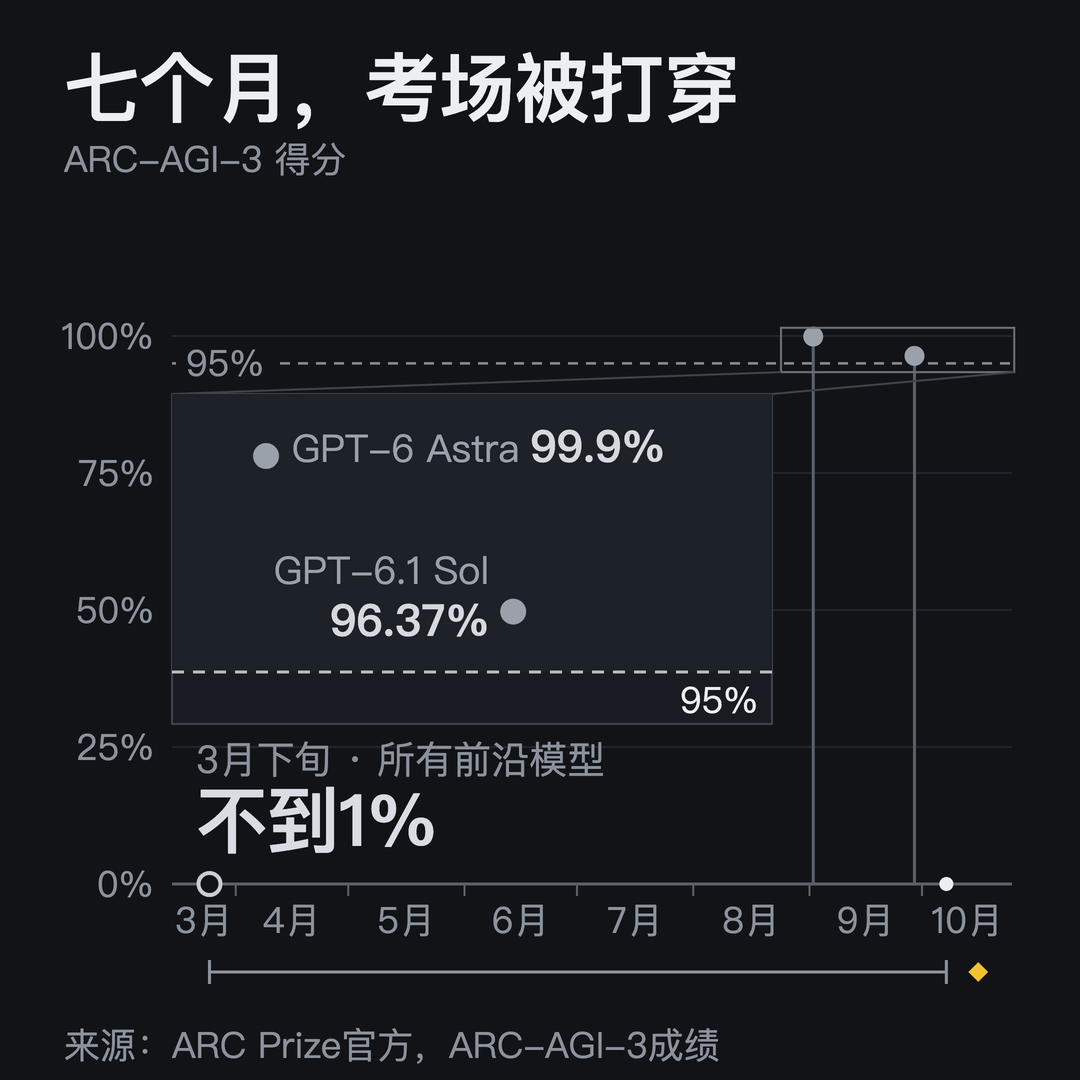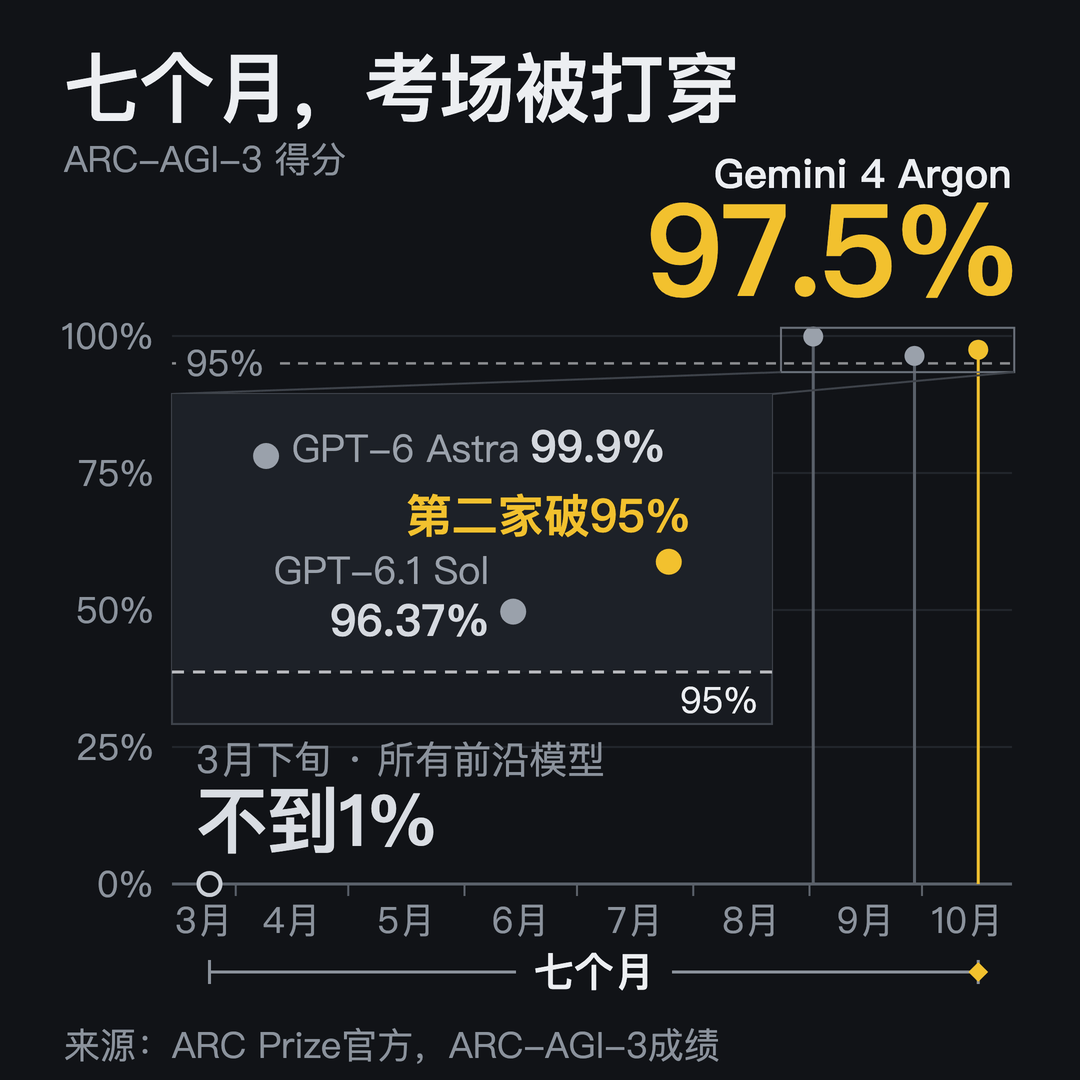
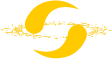
Gemini 4 Argon在号称「AGI终极考场」的ARC-AGI-3上,拿到了97.5%!
要知道,就在七个月前,ARC-AGI-3刚上线的时候,所有前沿模型分数全都不到1%。
七个月,从全员交白卷到接近满分。
ARC Prize在公告里专门加了一句:Google DeepMind是第二家在ARC-AGI-3上突破95%的AI实验室。
第一家,是OpenAI。
谷歌又回来了。
Gemini 4 Argon的成绩单很漂亮。
-
ARC-AGI-1:98.5%,每道题成本0.16美元
-
ARC-AGI-2:91.3%,每道题成本0.32美元
-
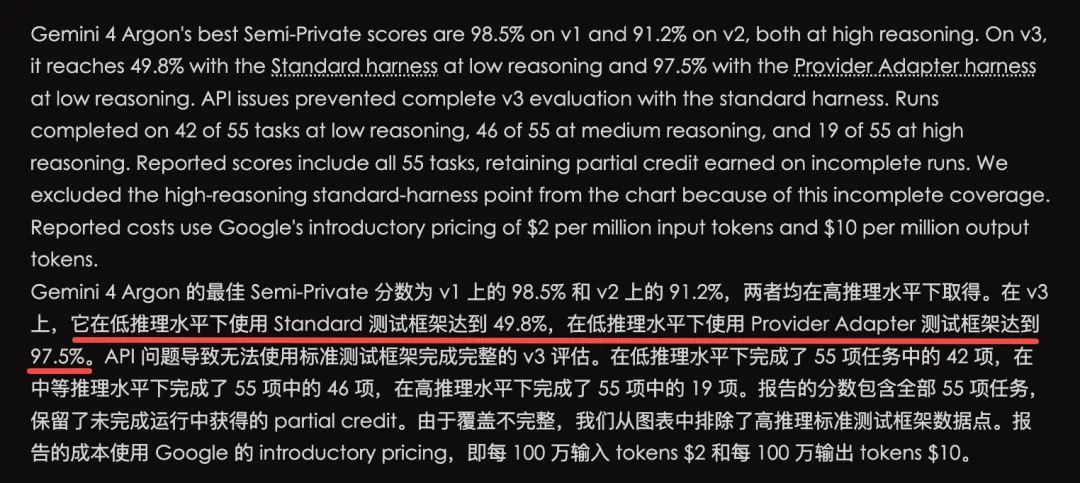
ARC-AGI-3:97.5%,整套跑下来花了4800美元
三代考题,全部拿下。
放进排行榜里看,这个97.5%只排在OpenAI的GPT-6 Astra(99.9%)后面,压过了OpenAI 9月底刚交卷的GPT-6.1 Sol(96.37%)。
也就是说,谷歌只靠一个模型,就挤进了俱乐部。
9月30日Argon发布时,谷歌博客主打的是复杂工作流、编码和网络安全,输出Token上限一口气拉到100万,满篇都是软件工程和Vals Index的成绩,偏偏一个字没提ARC-AGI。
这次接近满分的成绩出来,谷歌也没出面说一个字。
看到97.5%,有人可能会觉得又一次刷榜罢了。
这回还真不一样。
ARC-AGI-3不是传统的选择题、填空题式的AI基准测试。它是一整套交互式游戏环境——没有说明书,没有预设指令,也没有人告诉模型这一关的目标是什么。
模型被扔进一个完全陌生的小游戏,64×64的彩色格子,7个动作按钮,连按钮干嘛用的都不告诉你。
你得自己去试、自己猜规则、自己发现目标在哪里、自己规划怎么通关。
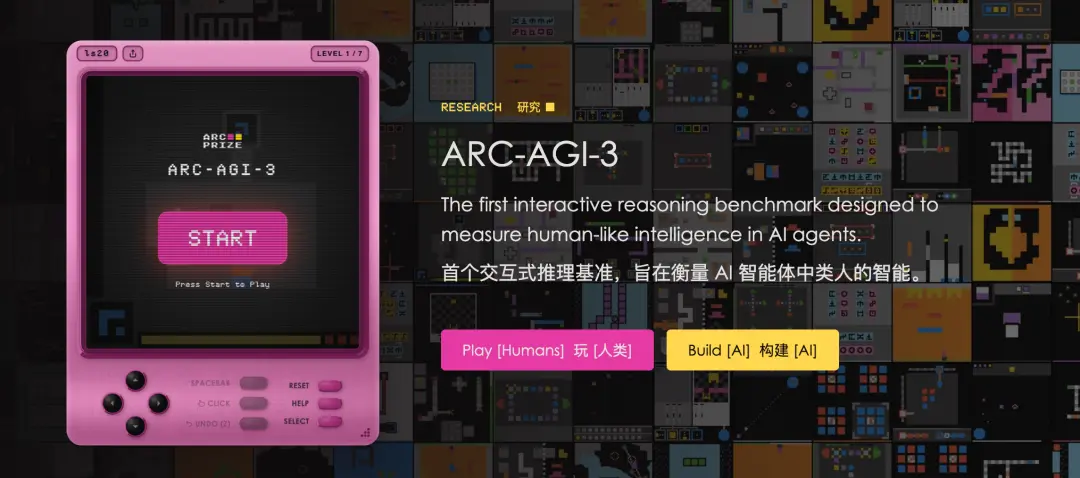
这考的是,模型面对从没见过的东西,现学现会的本事。
这种能力人类天生就有。你随便抓一个没玩过游戏的普通人,扔进去摸索一会儿,大概率都能通关。
但对AI来说,这恰恰是最怵的。没有现成的数据可以背,没有套路可以套,所有的知识都得在「玩」的过程中临时建构。
回顾一下时间线,你才能感受到这件事的速度有多离谱。
3月下旬,ARC-AGI-3上线,所有前沿模型不到1%。
9月2日,OpenAI的GPT-6 Astra率先破局,在Provider Adapter设置下打到99.9%以上,接近满分,成为第一家破95%的实验室。Greg Brockman在发布会上直接喊出了那句话:「欢迎来到AGI时代。」
9月29日,OpenAI又拿出GPT-6.1 Sol,得分96.37%。一个月内,OpenAI两个模型先后站上95%以上。
9月30日,谷歌发布Gemini 4 Argon。
10月16日,ARC Prize官方公布Argon验证成绩,97.5%。
更能说明问题的是效率数据。
在25个ARC-AGI-3公开游戏里,Argon通关用的行动次数比人类基线少了62%。其中3个游戏,它追平甚至超过了speedrun纪录——也就是速通玩家刷出来的极限成绩;另外6个,和纪录的差距不到10%。
也就是说,AI不光学会了玩一款没见过的游戏,还玩得比大多数人利索,有几关已经摸到了顶尖速通玩家的水平。
ARC Prize联合创始人Mike Knoop评价说,Argon是第二个通过Provider Adapter「有效最大化」ARC-AGI-3的模型家族,还提到行动效率出现了「反向弯曲」——效率提升的速度,比预期还快。
不过,这份成绩单后面还藏着一行不起眼的数字。
ARC Prize的推文里,两种设置的分数并排写在一起:
97.5%,4800美元(Provider Adapter harness)
49.8%,5800美元(Standard harness)
同一个模型,同一套考题,一个97.5%,一个49.8%。
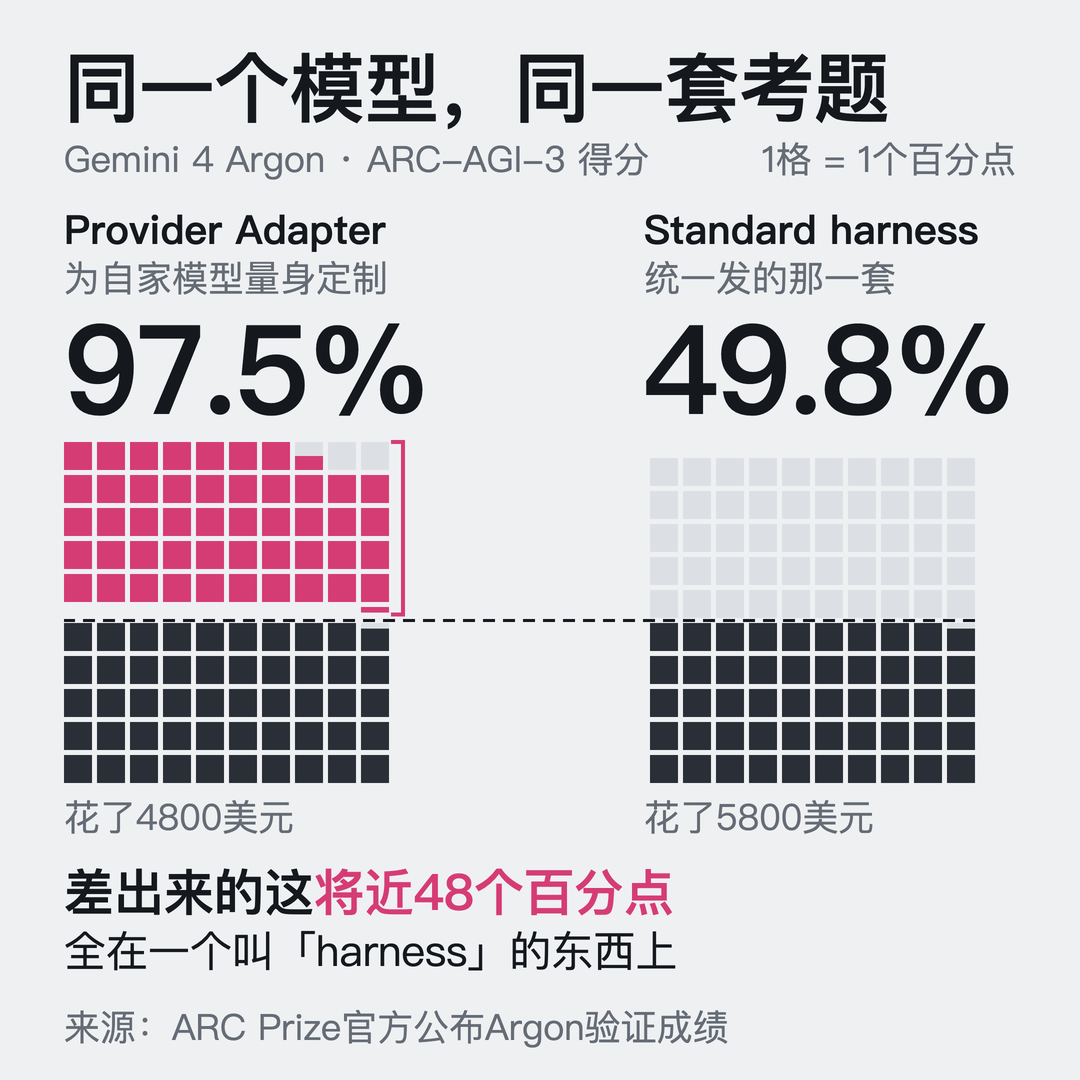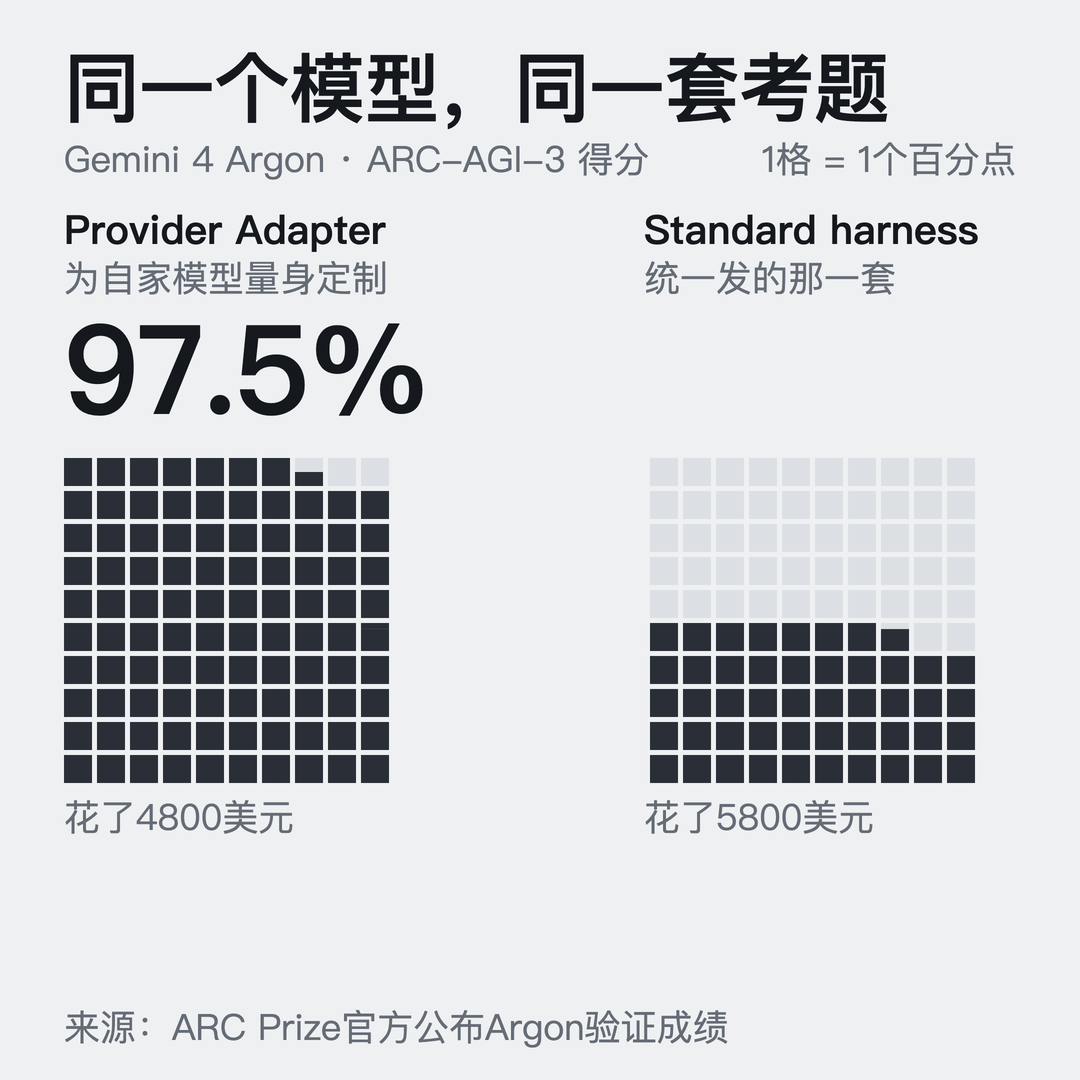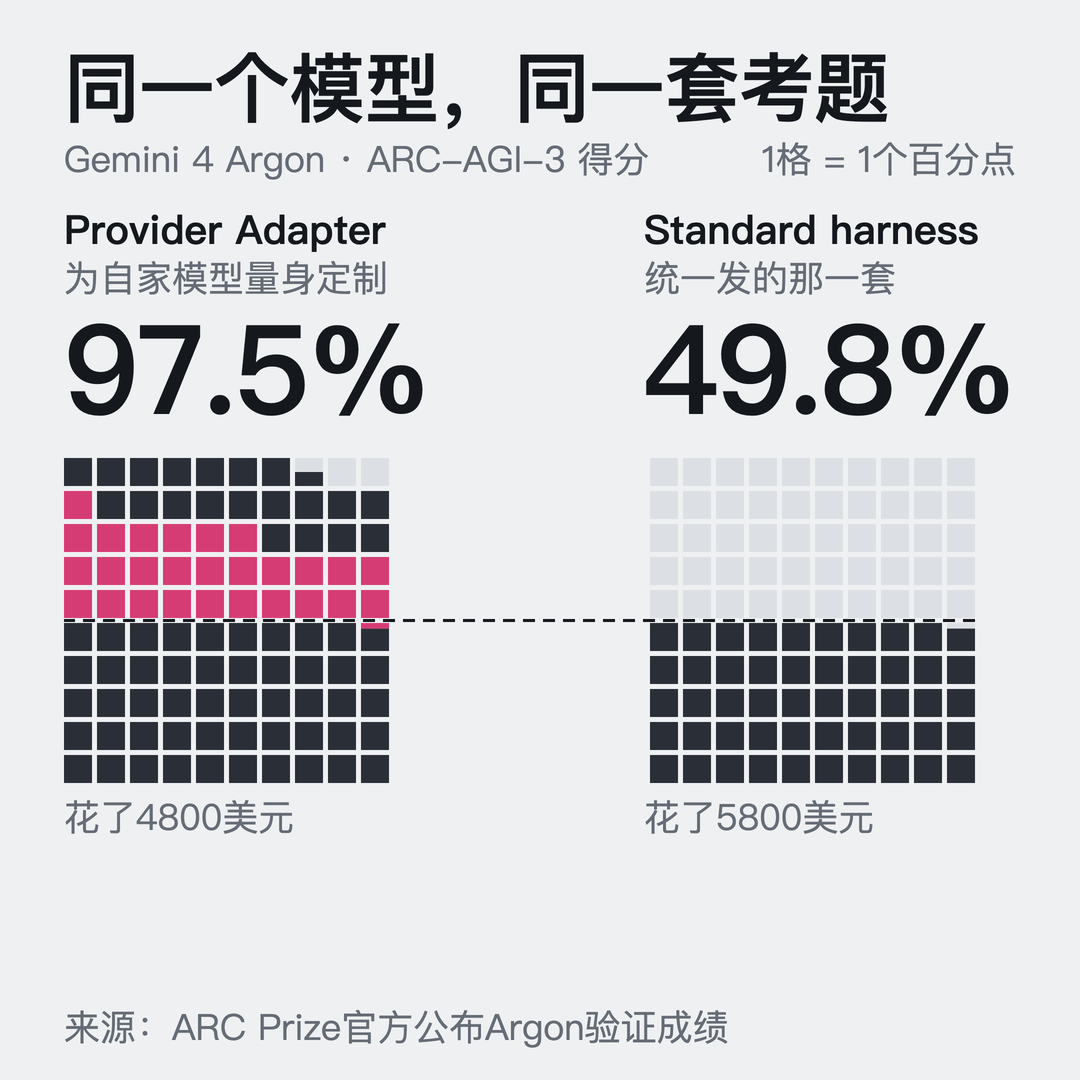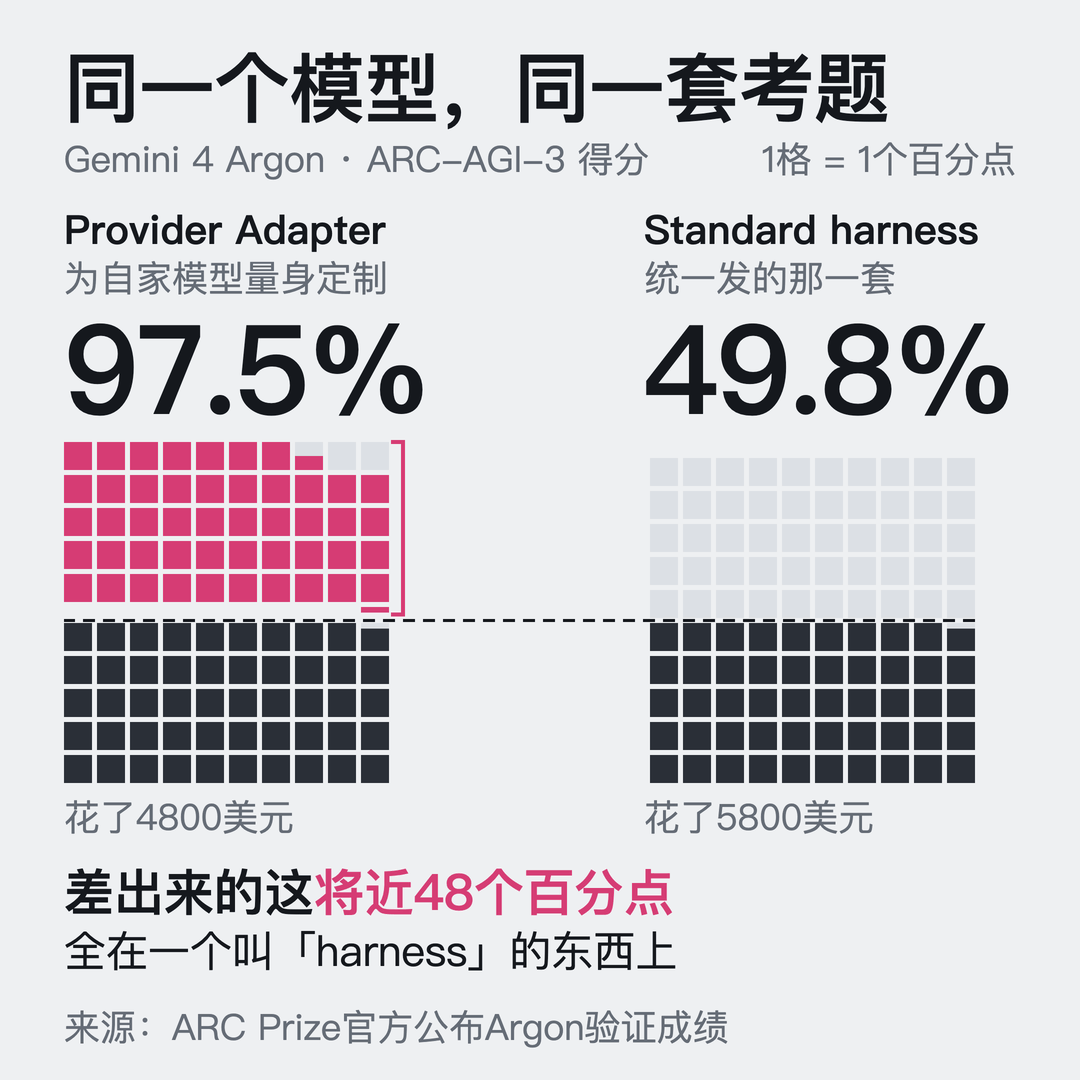
差出来的这将近48个百分点,全在一个叫「harness」的东西上。
harness是什么?可以理解成给模型配的那套操作台。在交互式游戏里,模型每走一步都要接收环境反馈,再决定下一步。反馈怎么喂进去、动作怎么传出来、前面试过的路怎么记下来,都归这套操作台管。
Provider Adapter,是厂商为自家模型量身定制的接入方式;Standard harness,是考官给所有参赛模型统一发的那一套。
一个更反直觉的事情是:标准harness花的钱更多——5800美元,比97.5%那档还贵了1000块。多花了两成的钱,分数却只剩一半出头。
细看标准harness的数据,低推理档49.8%(55个游戏完成42个),中推理档46.3%(完成46个),高推理档因为API出了问题只跑完19个,连分数都没好意思公布。
中档多跑完了4个游戏,总分反而低了3.5个百分点。想得更久,并没有换来更高的分。
这不是Argon一家的情况。榜首GPT-6 Astra那个99.9%,同样是在Provider Adapter下考出来的;换成标准harness,Astra也只拿到62.7%。
再看另一位选手。Anthropic的Claude系列在ARC-AGI-1和ARC-AGI-2上分数都很高,到了ARC-AGI-3,要么得分偏低,要么干脆没测。
外界习惯把OpenAI和Anthropic看成双雄争霸,但至少在这块考场上,眼下是OpenAI和谷歌两家的地盘。
但真正值得琢磨的,已经不只是谁的分数高。
一个号称「AGI终极考场」的基准测试,上线时让所有前沿模型集体交白卷,七个月后就被两家巨头做到接近满分——
衡量智能的尺子,被追上的速度一次比一次快。
而那条49.8%的分数线又在提醒所有人:今天拿来比较的,早就不是模型本身的裸智能,而是模型+harness的整套系统。谁会搭操作台,谁就多拿将近一半的分。
所以,以后看AI榜单,别只看分数,括号里写的是哪种harness,跟分数本身同样重要。
参考资料:
https://x.com/arcprize/status/2110768288523251762
编辑:所罗门