从「构建 AI」到「驾驭 AI」,100+ 实战案例拆解 AI Native 时代的工程新实践!
2026 年 QCon 全球软件开发大会大会 · 上海站将于 10 月 22 日-24 日举办,来自阿里巴巴、腾讯、字节跳动、美团、小红书、蚂蚁集团、无问芯穹、阶跃星辰、快手、百度、网易、微软、华为、携程、平安等企业的一线技术实践者,将从 AI 应用、Agent 工程、AI Coding、基础设施、数据系统、质量、安全、SRE 以及具身智能等方向,分享 AI 进入真实生产环境之后正在发生的变化。
阿里巴巴淘天集团高级测试开发专家泠乐已确认出席 “AI 驱动的软件工程” 专题,并发表题为《AI 写完代码,谁来验证?——手淘 TEKO“写—验—修”自主闭环的工程实践》的主题分享。AI 编程助手把代码的生产速度放大了,验证能力却没有同步跃升。但"多招几个测试"解决不了这件事——复盘后发现真正的堵点有两个,且是乘法关系:
-
判据缺失:AI 不知道"什么算对"。需求、技术方案、基建规范、团队约束都散在文档里,无法被消费,于是 AI 只能追求"看起来能跑通"。
-
信号缺失:AI 拿不到"对不对"的客观反馈。它看不见屏幕、读不到运行时、点不动按钮、没法把 App 拉到目标状态。我们量化过:AI 生成 100 个用例,环境搭建 60% × 数据构造 50% × 执行 40% × 工具自动化率 70%,综合可执行率只有 6.4%。
任一为零,自主性就是零。TEKO 的答案是同时补两根柱子:
-
判据侧:把质量能力做成可在任意研发环节调用的 Skill,让"验收条件"成为一个在链路上逐级传递、逐级细化的结构化数据对象:需求文档产出需求验收条件;技术方案 + 基建规范 + 团队约束产出技术验收条件;代码 diff + context7 + 领域知识产出风险点与配套用例;构建产物产出单测 / 白盒 / UI 自动化用例。最反直觉的一步是把验收条件回喂给生码环节——判据先行,这才是 AI 原生的 TDD。
-
信号侧:把 App 从"只能被人看的交付物"改造成"能被 Agent 寻址、观测、驱动、复现的可编程环境",并往下打到根因:自动化上不去往往不是用例不够,而是系统本身不可测。我们用终端环境全局切面 + SDK 可测性基线与 CI 卡口去改造"物理法则"。
两根柱子合流,Agent 的循环长度才能从 1 变成 N——从"生成后交给人"变成"生成、执行、观测、判断、修复、复跑"全程无人;线上 Crash 与舆情也能反过来自动转化为回归用例,让用例库有机生长而非靠人工建设。在本次分享中,泠乐将围绕以上内容展开分享。
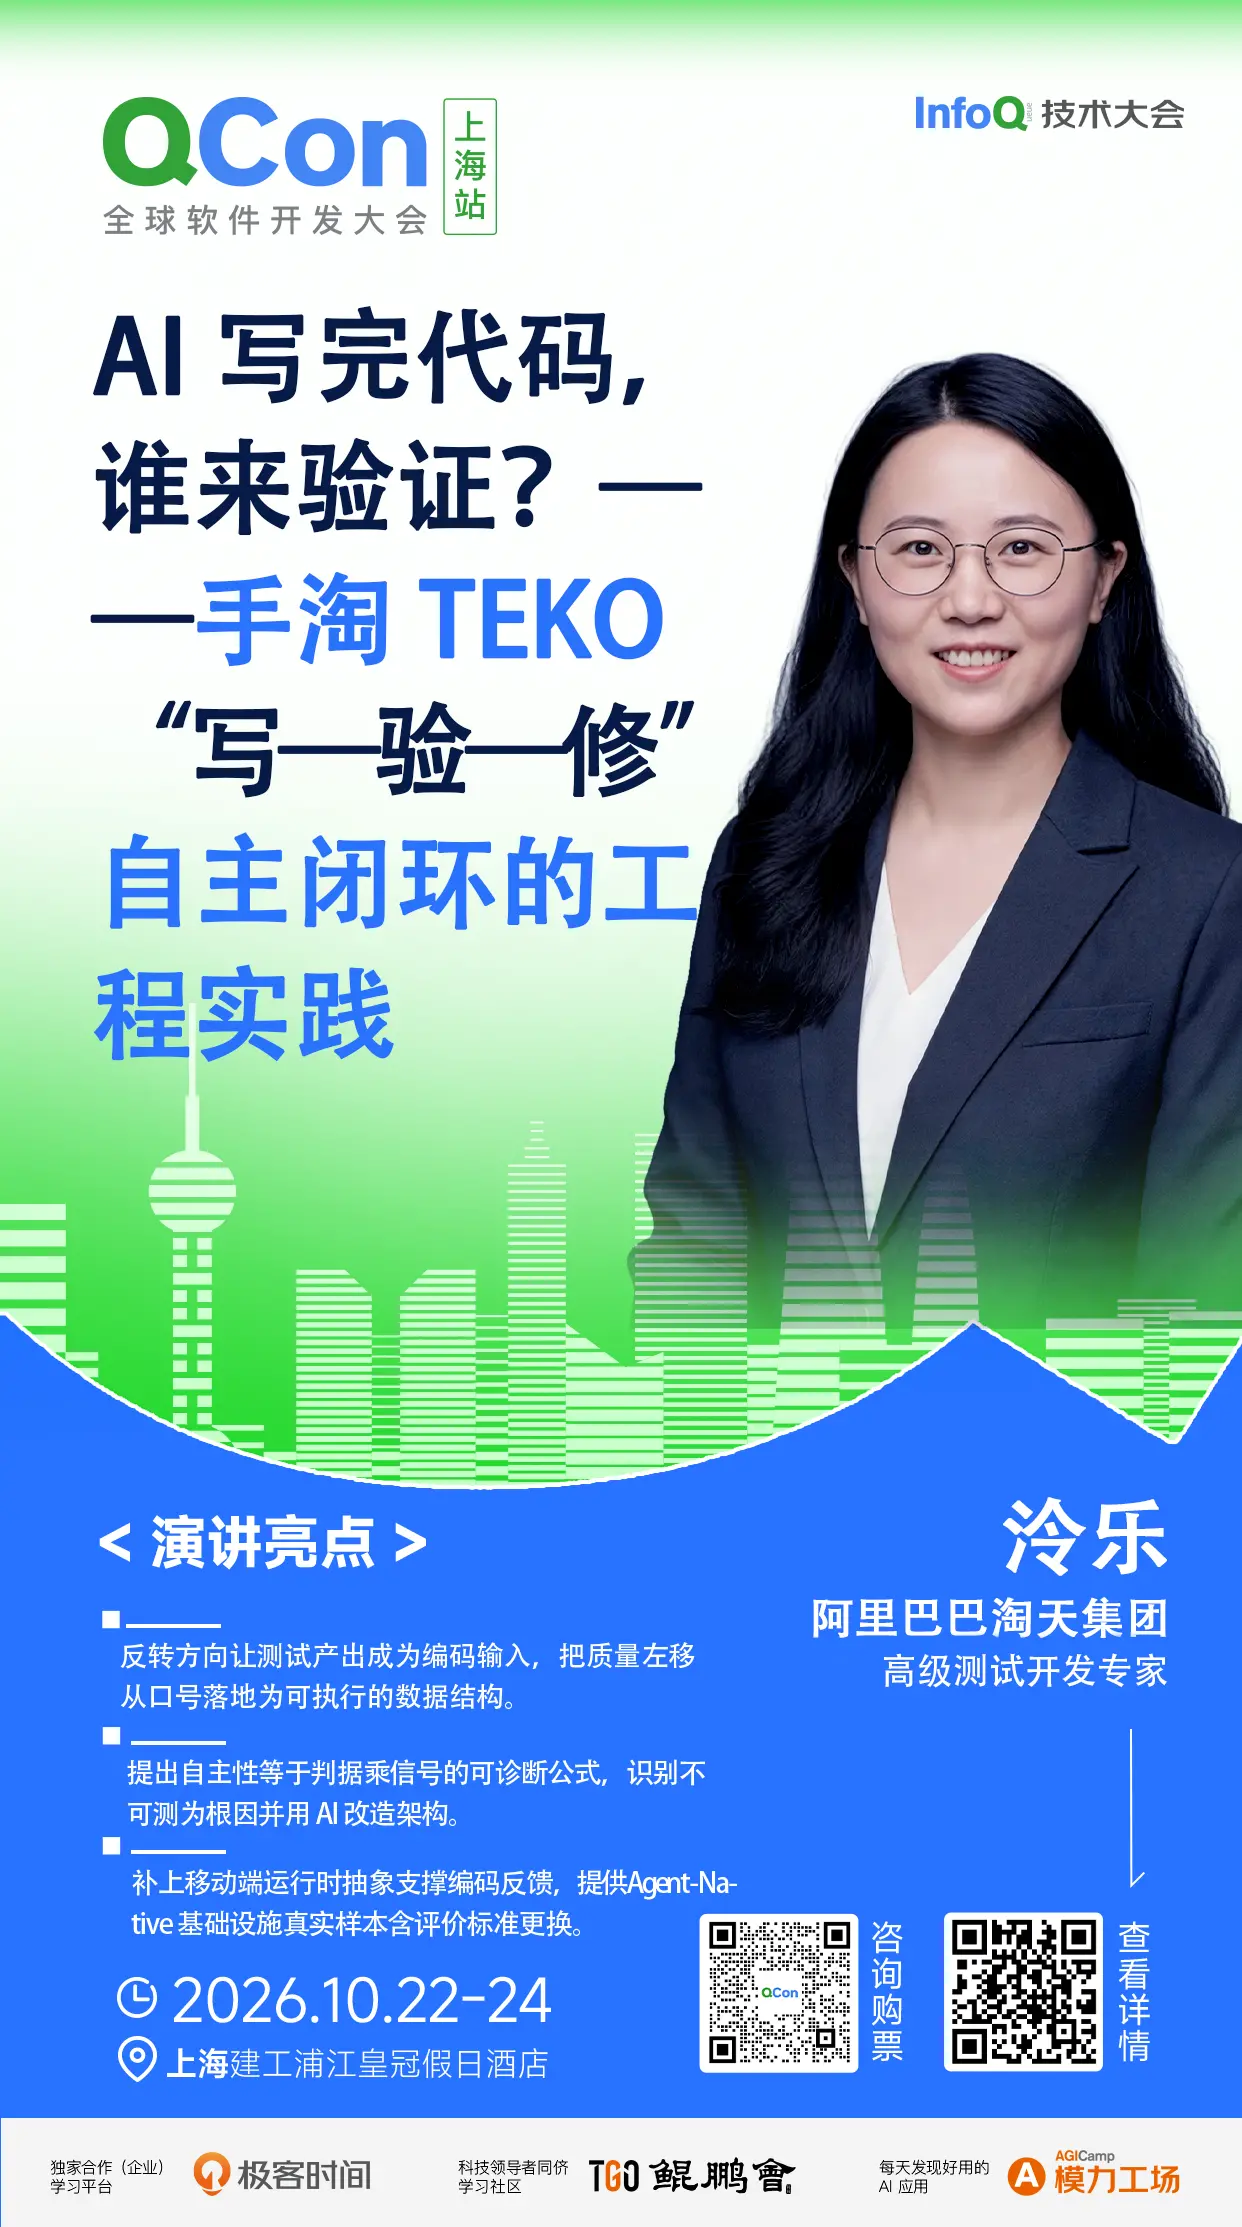
泠乐,负责淘宝客户端及移动基础设施的质量保障,对 APP 稳定性、性能体验优化、质量效率、安全生产等领域有多年的研究和实践,现深入研究 AI 技术在移动端研发效能、质量保障等领域的应用。她在本次会议的详细演讲内容如下:
演讲提纲
AI 生码放大了生产速度,验证能力没有同步。三个诊断——变更快过用例的老病、"能跑通≠逻辑对"的新伤,以及最易被忽略的根因:系统本身不可测。提出全场骨架:自主性 = 判据 × 信号,二者是乘法关系,只补一边等于没补。
一、判据:把"什么算对"变成可传递的数据:需求文档不适合生成用例,但它是判据的天然来源——判据左移,验证右锚。四级验收条件流水线:需求文档→需求验收条件;技术方案+基建规范+团队约束→技术验收条件;代码 diff+TBContext7+领域知识→风险点与配套用例;构建产物→单测/白盒/UI 用例。最反直觉的一步是把验收条件回喂给生码环节,即 AI 原生的 TDD。含三源上下文(改了什么/影响了谁/意味着什么)、可执行性过滤与双模召回、以及为什么做成 Skill 而非平台。
二、让判据生产线跑得稳:Session-Stage 编排与五路并行、多 Agent 容错、AI 产出多策略修复链(解析成功率 80%→99%+)、全链路 Trace 与两层评估。主张:AI 系统必须是白盒。
三、信号:把待测对象改造成可编程环境,提供编码反馈的环境层:对人是交付物,对 Agent 必须是环境。四个必要条件、6.4% 可执行率的连乘诊断、三层信号(单测/白盒/UI)、三个工程取舍(侵入边界、结构优先视觉兜底、会话解耦)、可测性治理与 L0→L5 成熟度阶梯。主张:自主性的地板是可测性。
四、合流:循环长度从 1 到 N,改变的是 Agent 能承担的任务类型;三个闭环证据 + 线上负向信号转回归用例的反向飞轮。
五、效果与代价:三端 100% 覆盖、单次分析 12 分钟、1.5w+ 入库用例、96% 操作成功率、性能报告 10 人日→1 人日;坦诚讲鸿蒙短板、运营成本与组织阻力。
六、总结收尾:更高的自主性来自更严的约束;质量工程师的价值转向设计判据、构建信号、改造环境。
实践痛点
判据的冷启动:最关键的知识恰恰没有载体
上下文的规模与新鲜度:影响面算不准,下游全歪
AI 的不确定性,让测试系统自己不可回归
效果无法自证:这个领域没有 ground truth
环境能力是连乘的,短板决定上限
测试基建自己成为线上风险源
可测性治理的阻力在组织,不在技术
演讲亮点
把方向反转:测试产出成为编码的输入
把"质量左移"从口号变成一个数据结构
一个可诊断的公式:自主性 = 判据 × 信号
识别出"不可测"才是根因,并用 AI 去改造架构
补上移动端缺失的那层运行时抽象,支撑编码反馈的环境层
Agent-Native 基础设施的一个真实样本,含评价标准的更换
听众收益
一个可复用的诊断公式:自主性 = 判据 × 信号。附两侧各自的量化诊断法(6.4% 可执行率的连乘模型、可测性基线扫描),听完能定位自己团队缺的是哪一边
“验收条件”作为数据契约的完整设计:四级流水线的输入源、产出物、消费者与回喂机制;以及为什么它必须是结构化对象而不是一段文字。这是全场最可直接照搬的一节
一个可自评的环境成熟度阶梯 L0→L5:每级明确"判定标准 / 需要的基础设施 / 解锁的场景 / 代价"。含三个自建绕不开的取舍:侵入与非侵入的边界、结构化定位 vs 纯视觉、设备会话与 Agent 会话解耦
“用 AI 评估 AI”的闭环设计:全链路 Trace 采什么、两层评估如何平衡成本与精度、评估结论如何反哺 Prompt。以及大模型工程化的脏活清单——多 Agent 主备降级、超长 diff 自适应、AI 产出多策略修复链(解析成功率 80% → 99%+)
一组生产验证的数据与代价:三端 100% 覆盖、12 分钟单次分析、1.5w+ 入库用例、96% 操作成功率、性能报告 10 人日 → 1 人日;同时坦诚讲清鸿蒙端 85% 成功率、真机不稳定性的兜底、以及可测性治理遇到的组织阻力
适合听众
测试与质量效能负责人、研发效能与工程基础设施团队、移动端研发与架构、AI Agent 平台建设者。
预备知识
了解 LLM / Agent 基本概念,用过任一 AI Coding 工具(Cursor / Claude Code / Qoder)。
除此之外,本次大会还策划了Loop Engineering、千行百业 Agent 创新实践、Agent 自主进化:从记忆到持续学习、Agent as a Service、Vibe Coding 时代的新质量债、理性驾驭 AI 的 SRE 可靠性工程、金融 AI Native工程实践:从研发提效到业务破局、AI Infra:算力效率决定规模化落地、AI Native 架构等 20 个专题论坛,届时将有来自不同行业、不同领域、不同企业的 100+资深专家在现场带来前沿技术洞察和一线实践经验。
查看更多详情可扫码或联系票务经理 18514549229 进行咨询。