10 月 15 日,蚂蚁集团旗下百灵大模型宣布开源 Ling-3.1-flash。该模型主打“真实可用”,面向真实世界任务实现能力升级,让模糊的业务需求更快变成可用的成果。开源模型面向 Hugging Face 和 ModelScope 提供权重下载。
Hugging Face 地址:https://huggingface.co/inclusionAI/Ling-3.1-flash
ModelScope 地址:https://www.modelscope.ai/models/inclusionAI/Ling-3.1-flash
Ling-3.1-flash 延续了 Ling-3.0-flash 的混合线性架构,拥有约 560B 总参数,每个 Token 激活约 25B 参数;最高支持 1M 上下文。模型在办公、医疗、软件工程、终端操作等复杂工作流中保持了高质量表现。面对分散资料,它可以协助整理报告与汇报材料;面对零散症状,帮助梳理病史和就诊问题;面对旧代码,能够读懂原有实现、编写新功能,并依据测试结果继续修正。
在办公任务评测 GDPVal-AA V2.1 中,Ling-3.1-flash 获得 1673 分(ELO)。在 HealthBench Professional 医疗场景评测中,模型得分 65.35。在软件工程基准 FrontierSWE 和终端操作基准 Terminal-Bench 4.0 测评中,模型同样表现出了处理复杂工程任务的能力。
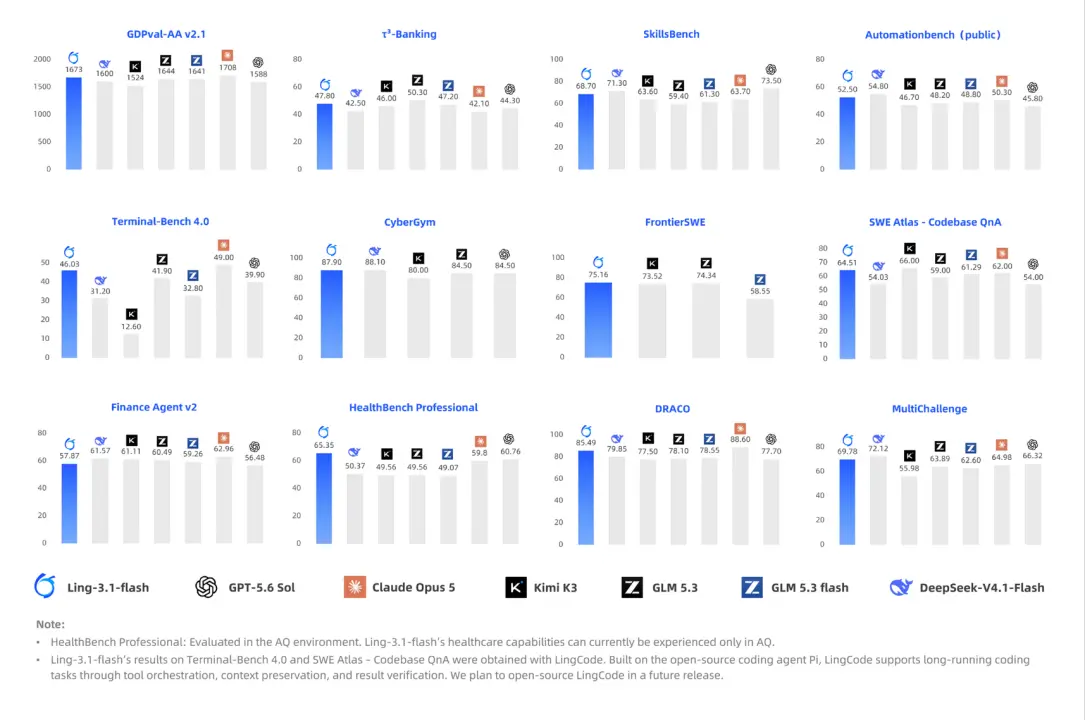
通过此次开源,百灵希望更多团队能够在自有环境中部署和接入 Ling-3.1-flash,把这些场景能力融入自己的业务流程。
日常面向真实任务时,企业知识助手和代码助手经常要连续处理资料、生成内容,并根据反馈修改结果。模型既要具备处理这些任务的通用能力,也要让多轮调用保持足够快的响应。“智效比”作为百灵系列模型的核心特点,在 Ling-3.1-flash 模型层面得以延续并进一步强化。
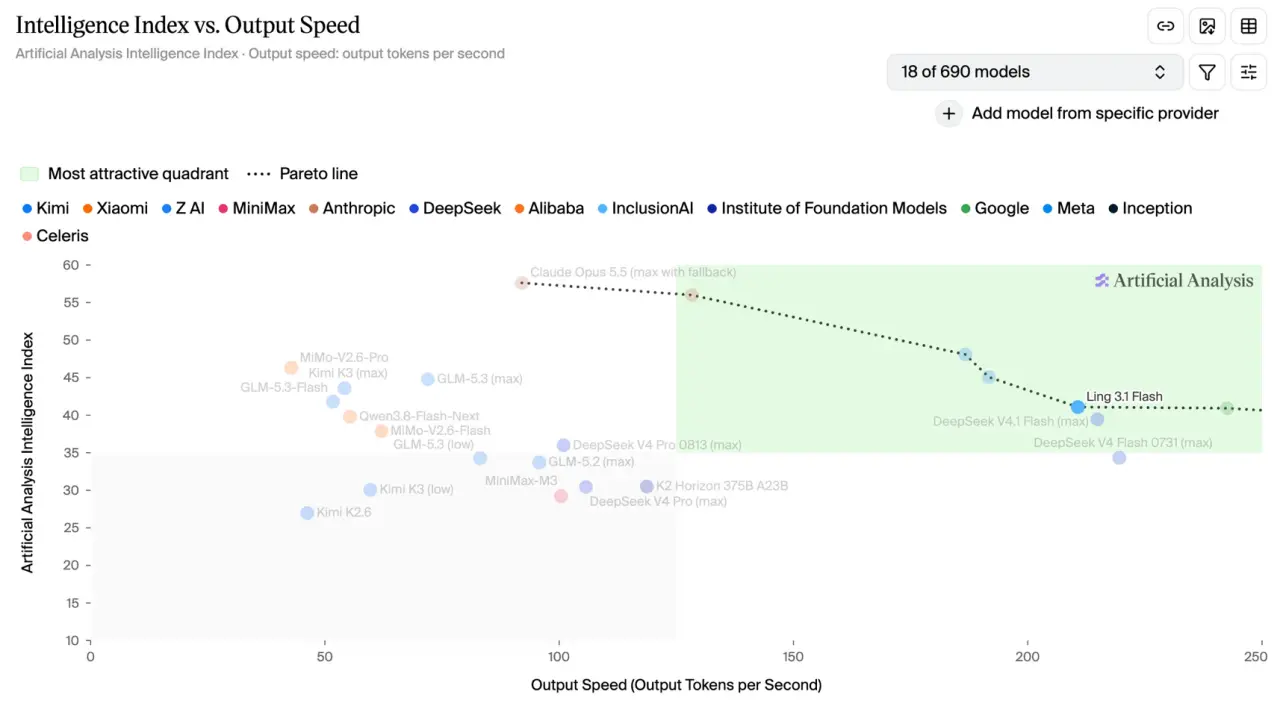
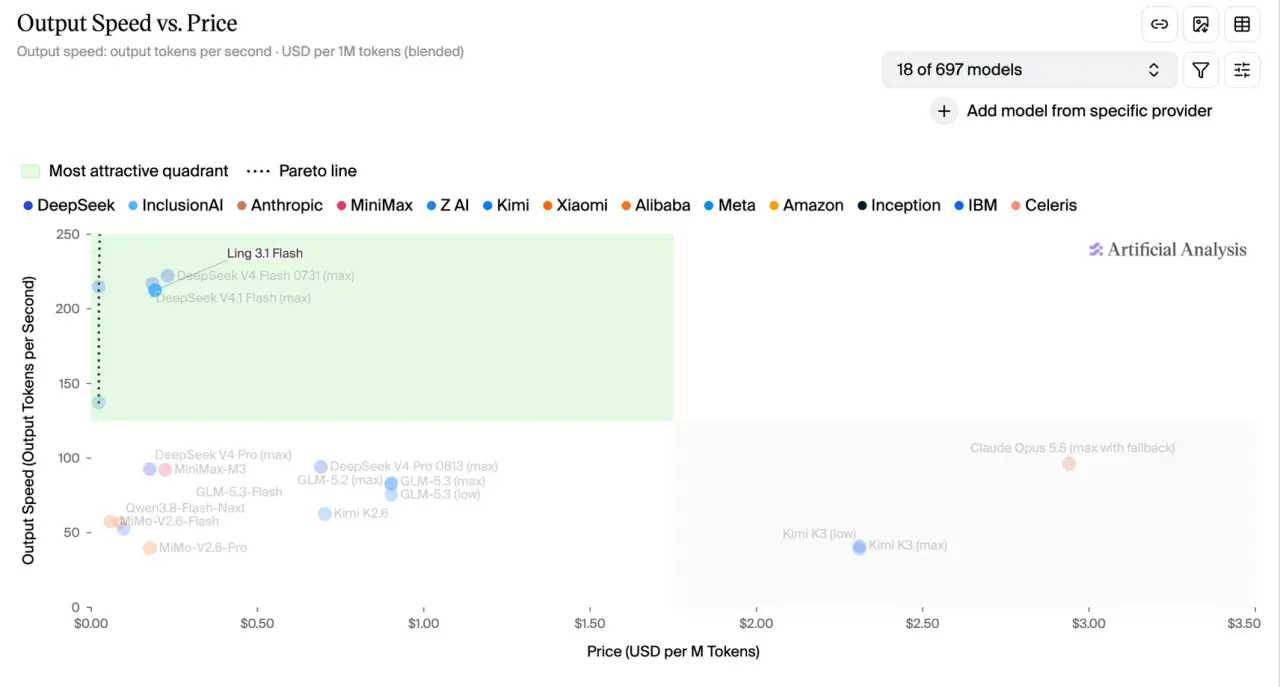
在 Artificial Analysis 的公开评测中,Ling-3.1-flash 的智能指数为 41、输出速度约为每秒 210 Token,面向高频业务场景提供智能指数与生成效率的双重能力。此外,Ling-3.1-flash 的混合调用价格约为每百万 Token 0.19 美元,位于较快输出、较低价格区间,面向高频调用场景兼顾生成效率与成本优势。
针对本地部署,团队对 routed experts 采用 MXFP4 量化、dense 层保持 block-FP8,权重占用从约 534GB 降至 292GB。在对应的 Hopper GPU 测试配置中,服务部署由 8 卡降至 4 卡,让具备服务器级 GPU 的团队以更少卡数运行模型。
此前,Ling 3.0 系列已在多类设备上开展开源实践,覆盖从服务器到个人电脑、移动终端的多种部署路径。例如在服务器端,单台 NVIDIA DGX Spark 可运行 Ling-3.0-flash,用于驱动编码智能体构建并测试小游戏;在个人电脑端,16GB MacBook Air 可运行 Ling-3.0-tiny,搭建常驻本地助手;在移动端,Galaxy A32 4G 通过 Tiny GGUF 版本验证了本地推理与工具路由原型,小米 14T Pro 则借助 PocketPal 实现了 Tiny 版本的本地对话。
据了解,Ling-3.0 系列模型在 Hugging Face 近 30 天下载量接近 100 万次,社区已提供 Flash GGUF、Tiny GGUF、Flash MLX 4bit 等多种适配版本。随着 Ling-3.1-flash 开源,百灵系列模型为开发者提供了更完整、可自主验证和二次适配的模型基础,同时也意味着模型能力正进一步贴近真实业务交付,从需求文档、代码仓库到生产环境之间的链路被继续压缩。
百灵作为蚂蚁集团 AI 业务发展背后的模型研究力量,为消费端 AI 应用和企业级智能体提供了重要的模型能力支撑。
不同于单纯追求模型参数规模,百灵聚焦将模型能力带入真实业务中交付结果。在金融、医疗等复杂专业领域,百灵依托基座模型已相继推出 Ling-3.0-flash-Fin、Ling-3.0-flash-Sante 等增强模型,将通用模型能力进一步转化为投研、健康管理等真实业务流程中的专业能力。