► 文 观察者网心智观察所
2026年10月11日,AI领域的知名学者安德烈·卡帕蒂在社交平台上翻出了自己同年4月发布的一条动态。作为OpenAI研究中心的联合创始人以及特斯拉前AI总监,卡帕蒂的一言一行向来是硅谷的风向标。半年之前,他曾感叹人们对大语言模型能力的认知存在巨大分歧,仿佛两个世界的人在自说自话。
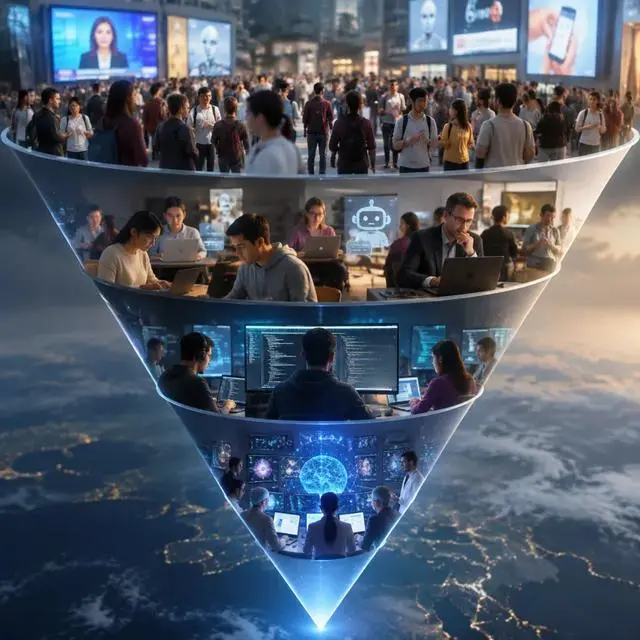
半年之后,他修正了这个判断。在他看来,社会对于AI的认知裂痕已然演变为一个巨大的漏斗。在这个漏斗的顶端开口处,数十亿人觉得AI不过是虚火旺盛的噱头,而在漏斗的最底端,全球仅有大约5000人正在目睹一场令人眩晕的智力狂飙。这5000人究竟看到了什么,以至于和普通人的日常体验拉开了如此之大的鸿沟?
四层漏斗里的折叠世界
卡帕蒂用一组粗略估算的数字,将全球人类在AI时代的处境切分成了四个截然不同的图层。
位于漏斗最宽阔开口处的,是大约60亿人,占全球总人口的75%。这群人几乎从未真正接触过大语言模型。AI对他们来说,只存在于电视新闻的播报、街头巷尾的广告牌或是年轻人的饭桌谈资里。
往下一层,是大约10亿到20亿的轻度用户,占全球人口的20%左右。这群人偶尔会点开免费的聊天机器人网页,让它帮忙润色一封求职信,或者解答一个生活常识问题。在他们眼里,这个新奇的玩意儿表现得有些笨拙,有时还会一本正经地胡说八道,充其量只算一个稍微好用点的搜索引擎或是文字秘书。甚至很多非技术领域的专业人士,比如每天忙于人际沟通、协调利益冲突的企业高管,也停留在这个层级。卡帕蒂非常理解这部分人的感受,他坦言自己身边不少非技术背景的朋友觉得大语言模型完全派不上用场,这种判断基于他们自身的日常体验,完全合情合理。
视线继续下移,漏斗急剧收窄。这一层聚集着大约2000万人,仅占全球人口的0.2%。他们主要分布在数学和计算机编程领域,是前沿付费大模型的深度使用者。这群人亲眼见证了工作方式的剧烈重构。过去需要耗费几周甚至几个月才能啃下来的大型复杂软件工程,如今只需要输入一段提示词,智能体就能自动接管。从零开始构建应用程序、复刻现有软件、跨语言翻译代码,甚至将机器底层的二进制文件逆向反编译成人类可读的程序,都在极短时间内自动完成。卡帕蒂感叹,就在不到一年前,他自己还坐在电脑前,凭着记忆把代码指令一个字符一个字符地敲进编辑器,偶尔按一下键盘上的跳格键来自动补全一小段代码。如今,这种传统的手工作业方式正在以肉眼可见的速度成为历史。
在漏斗的最尖端,站着大约5000人,占全球人口的0.00006%,这个数字比人类历史上成功登顶珠穆朗玛峰的人数还要少。这5000人是顶级AI实验室的核心研究员,拥有尚未公开的内部前沿系统的最高访问权限。在他们面前的屏幕上,成千上万个智能体正夜以继日地协同运转,一干就是好几个星期。这些数字劳工在无人干预的情况下开发庞大的软件系统,制造此前从未被发现的网络零日漏洞,以机器的毫秒级速度进行网络攻防战,甚至在基础科学和前沿数学领域开辟疆土。过去需要业内最顶尖的科学家耗费数年心血才能达成的突破,正在被机器批量生产。
在这5000人的世界里,最紧迫的危机已经变成了人类的脑力跟不上机器的产出。卡帕蒂在推文中提到,研究人员至今还像考古一样,慢慢挖掘和消化几个月前OpenAI研究中心与Hugging Face平台联合发起的科研项目中机器产出的海量成果,而世间顶尖的数学家面对机器一口气生成的722篇前沿数学手稿,哪怕只是从头到尾读懂并验证一遍,都还要花费漫长的时间。
幽灵如何学会自己做题
为什么编程和数学领域的从业者能感受到地动山摇的变化,而普通行政人员、教师或管理者却觉得AI表现平平?
卡帕蒂在早先的访谈中说,人类制造AI,跟大自然演化出动物完全是两码事。小猫小狗的智能根植于亿万年的生物进化,一生下来就带着基因编码的本能和感知物理世界的身体。而科学家训练大语言模型,更像在数字世界里召唤幽灵。这个幽灵没有实体,也没有真实的生活体验,它所有的智慧都源于对人类互联网海量文本数据的模仿,核心技能就是根据上文预测下一个最可能出现的字词。
很长一段时间里,这个幽灵只能靠模仿人类说话来讨好用户。叫它写一首诗,或者写一份年终总结,它能拼凑出华丽的辞藻,但因为这类任务在现实中没有绝对的对错标准,幽灵不知道自己写得好不好,只能维持在一个平庸的水平。管理者协调一场部门纠纷,编辑判断一篇文章能否打动读者,往往存在十几种合理的方案,效果好坏甚至要几个月后才能见分晓。在这些模糊的人类事务上,大语言模型很难获得精准的反馈,进步自然缓慢。
但是在数学和计算机代码的世界里,情况完全不同。这里的规则是高度数字化且绝对冷酷的。一段程序写得对不对,扔进编译器里跑一下就知道;一道数学题解得通不通,逻辑链条检验一下便知分晓。
正是这种非黑即白的特性,让AI专家们找到了一把名为可验证奖励强化学习的屠龙刀。DeepSeek团队发布的第一代技术报告,就曾详细展示过这种训练方法的威力。简单来说,科学家把大语言模型关进一个精心设计的数字练功房里,给它成千上万道高难度的数学题和编程任务,不教它具体怎么解,只告诉它最终的检验标准。模型在里面自己尝试,做对了系统就自动给一朵小红花,做错了就扣分。
由于检验过程完全由计算机自动完成,不需要人类老师在旁边批改作业,模型可以在几天之内经历人类几辈子都做不完的题海战术。在追求高额经济回报的驱动下,各大科技巨头投入海量算力,把这种数字练功房的规模推向了极致。在这个过程中,模型甚至自己摸索出了反思、复盘、拆解步骤等高级思维技巧。
这种偏科式的训练方式,直接导致了AI能力的畸形发展。凡是数字化程度高、结果可自动验证、又有极高商业价值的领域,系统的能力就呈垂直曲线飙升;而在那些需要生活常识、情感共情和复杂社会经验的领域,它依然像个笨拙的学徒。
氛围编程与看不见的门槛
在漏斗的第三层,那2000万专业人士正在经历的剧变,被卡帕蒂用自己创造的一个新词来概括,叫做氛围编程。
早在2025年2月,卡帕蒂在社交平台上随手写下这个词时,完全没想到它会火遍整个科技圈。所谓氛围编程,就是人类不再亲自去写代码,转而像个导演一样,用自然语言向AI描述自己想要什么样子的软件,把握一下整体的感觉和氛围,剩下的脏活累活全部交给智能体去干。
这种模式催生了一批传奇创业故事。在硅谷和全球各地的独立开发者社区里,单枪匹马的独狼创业者正在借助AI杠杆撬动过去需要几十人团队才能完成的生意。有的独立开发者利用AI构建的应用生成器,创业仅仅6个月就以8000万美元的价格被收购;知名的独立开发者彼得·莱维尔斯在没有雇佣一名员工的情况下,靠着几个大模型工具维护多款产品,每年的净收入折合人民币超过2000万元。推特的联合创始人杰克·多尔西,甚至也以这种氛围编程的方式,在极短时间内开发出了一款全新的即时通讯应用。
在卡帕蒂看来,氛围编程正在把软件代码变成一种免费可用、临时生成、用完即弃的消耗品。过去因为开发成本太高而被迫放弃的小众软件需求,现在几分钟就能搓出来。科技公司纷纷为工程师配备Cursor 和 Claude Code等新一代工具,试图将生产力翻倍。
然而,如果把镜头拉远,就会发现从漏斗的第二层迈向第三层,中间横亘着好几道看不见的铁门槛。这也是为什么全球有十几亿人用过聊天机器人,却只有2000万人真正享受到智能体红利的原因。
首先是任务规模的错位。卡帕蒂指出,AI的影响力与使用者手头问题的规模、目标大小以及时间跨度成正比。一个普通人问一句今晚吃什么,或者写一段祝福语,这种几秒钟就能答复的轻量级问题根本无法激活大模型深层的推理和规划潜力。只有当你手里攥着一个自己真正关心的、规模庞大且难度极高的工程项目,需要模型连续运转几个小时去拆解子目标、自我纠错时,它的威力才会显现出来。很多人觉得AI没用,往往是因为自己手头并没有值得动用重型武器的硬骨头。
其次是实打实的资源与权限壁垒。大语言模型的世界等级森严,免费层、付费层和实验室内部层之间,隔着算力额度、模型版本和外部工具调用权限的巨大鸿沟。普通大众在网页上免费使用的,往往是算力受限的旧版本模型,还会经常面对AI答错弱智吧问题的搞笑截图。用着被阉割的免费工具,看着网上的翻车视频,普通人自然会得出AI不过是一场泡沫的结论。
哪怕是在专业领域,把一句模糊的想法变成机器能够精准执行的指令,也需要极高的专业素养。中国互联网络信息中心发布的第57次统计报告显示,截至2025年12月,中国生成式AI的用户规模已经达到6.02亿人,普及率高达42.8%。跨过初次尝试的门槛之后,绝大多数人卡在了如何用好的阶段。普通人的需求往往是帮我做个年终汇报这样笼统的一句话,而专业人士懂得如何将复杂需求拆解成机器擅长的逻辑步骤。
垂直曲线上的眩晕与隐忧
顺着卡帕蒂的漏斗往下看,每一层的人都容易陷入一种认知盲区,把自己亲眼看到的局部体验,当成整个技术发展的全部真相。宽处的人嘲笑窄处的人在制造焦虑、炒作泡沫,窄处的人则困惑于大众为何对近在咫尺的海啸视而不见。
但即便是在最核心的第三层和第四层,技术狂飙带来的也并非全是喜悦。媒体在报道这群前沿用户的状态时,频繁使用一个词:眩晕。由于模型能力迭代的速度太快,即便每天都在高强度利用这种工具的顶尖程序员,也很难准确评估它的能力边界究竟在哪里。
同时,很多隐性成本被隐藏了。模型评估与威胁研究机构在2025年7月发布过一份令人意外的研究报告。研究人员对一批使用AI编程助手的资深软件开发人员进行了跟踪测试,结果发现,这些开发者的实际生产力非但没有提升,反而下降了19%。更耐人寻味的是,参与测试的程序员们普遍对工具抱有盲目的自信,在测试结束后依然主观认为AI帮自己把效率提高了20%。
一句提示词确实能在几分钟内生成上千行代码,但需求由谁定义?背景资料是谁整理?模型在生成过程中悄悄埋下的逻辑漏洞由谁来排查?机器接管了编写代码的过程,人类程序员被迫成了全职代码审查员和善后工。如果生成代码省下了两个小时,却要花四个小时去读懂机器的思路、修补隐蔽的缺陷、确保新代码能安全接入公司原有的庞大系统,那么所谓的效率奇迹就要打上一个大大的问号。
这一困境在漏斗最窄处的科研端表现得更为残酷。卡帕蒂坦言,人类对机器产出的理解和审查已开始捉襟见肘,这是整个前沿科学界正在面临的严峻考验。如果成千上万的智能体可以一气吐出722篇前沿数学论文、海量的新材料分子结构或是复杂的网络攻防代码,人类数百年来建立的同行评审与科学验证机制也面临着瘫痪的风险。毕竟,科学研究的本质不仅在于得出结论,更在于理解并复核推导过程。如果机器产出的速度远远超过了人类大脑阅读、理解和检验的速度,那些堆积如山的科研手稿和软件工程,会不会成成为混杂着致命错误与机器幻觉的数字垃圾?谁来为这些机器成果的可靠性签字背书?
卡帕蒂的认知漏斗,撕开了2026年AI行业最真实也最荒诞的切面。在这个折叠的时空里,60亿人的岁月静好、十几亿人的浅尝辄止、2000万人的效率重构以及5000人的极限狂飙,在同一秒内并行不悖地发生着。技术最锋利的尖端还在向深不可测的未知领域加速下探,而被甩入漏斗的人类社会还在手忙脚乱地找寻着这辆高速列车的踏板。
来源|心智观察所