2025 年,Vibe Coding 成为科技圈高频词,甚至入选柯林斯年度词汇:人们用自然语言向 AI 描述意图,让模型协助生成、运行和调整代码。进入 2026 年,类似的工作方式开始向科研场景延伸——读文献、整理数据、执行分析、生成图表,研究者把一部分操作交给智能体,把更多注意力放在提出问题和判断结果上。
围绕这种变化,有人开始讨论 Vibe Research。它指向一种人机协作方式:研究者提供方向和关键判断,AI 承担具体执行。工具操作的门槛在降低,研究者可以更直接地围绕问题组织工作。
但降低操作门槛,只是开始。
与快速搭建一个原型不同,科研应用需要经受方法、证据与复现的检验。一段代码能跑、一张图顺利生成,不意味着研究结论已经成立。更关键的是,一次性对话承载不了持续研究:一个研究项目往往跨周跨月,中间要换数据版本、改分析方法、回应合作者和审稿人的追问——这些东西需要文件、环境、工具调用和过程记录共同存在,而不是散落在聊天记录里。
Vibe Research 能走多远,既取决于模型能力,也取决于支撑执行、记录与验证的这一层基础设施。
近日,AIPOCH 团队发布开源 AI 科研工作台 AIPOCH Open-Science 1.0 版本。项目以 Apache-2.0 协议开源,支持 macOS、Windows 和 Linux 桌面端,同时提供命令行工具。
据介绍,AIPOCH 团队负责产品设计、软件开发与研发推进,来自全球 76 家院校及机构的合作作者参与了产品试用与验证,覆盖复旦大学附属中山医院、阿姆斯特丹大学医学中心(Amsterdam UMC)、哈佛医学院教学医院贝斯以色列女执事医疗中心(Beth Israel Deaconess Medical Center)等医学中心,北京大学、上海交通大学、浙江大学、伊利诺伊大学厄巴纳-香槟分校、以色列理工学院等高校,以及商汤科技、艾德生物等企业。相关预印本详见:https://arxiv.org/abs/2610.17110。
Open-Science 产品演示
它既是帮助研究者完成任务的科研工作台,也是连接模型、数据、工具和过程记录的科研操作系统。
借助 .science 包,AI 的使用过程可以在机器之间从一个系统带到另一个系统,形成可检查、可交接的存档。它既服务于人与人之间的协作,也让专家经验有机会被保留下来、继续复用——这或许会成为 Agent 时代的一种新型工作方式。
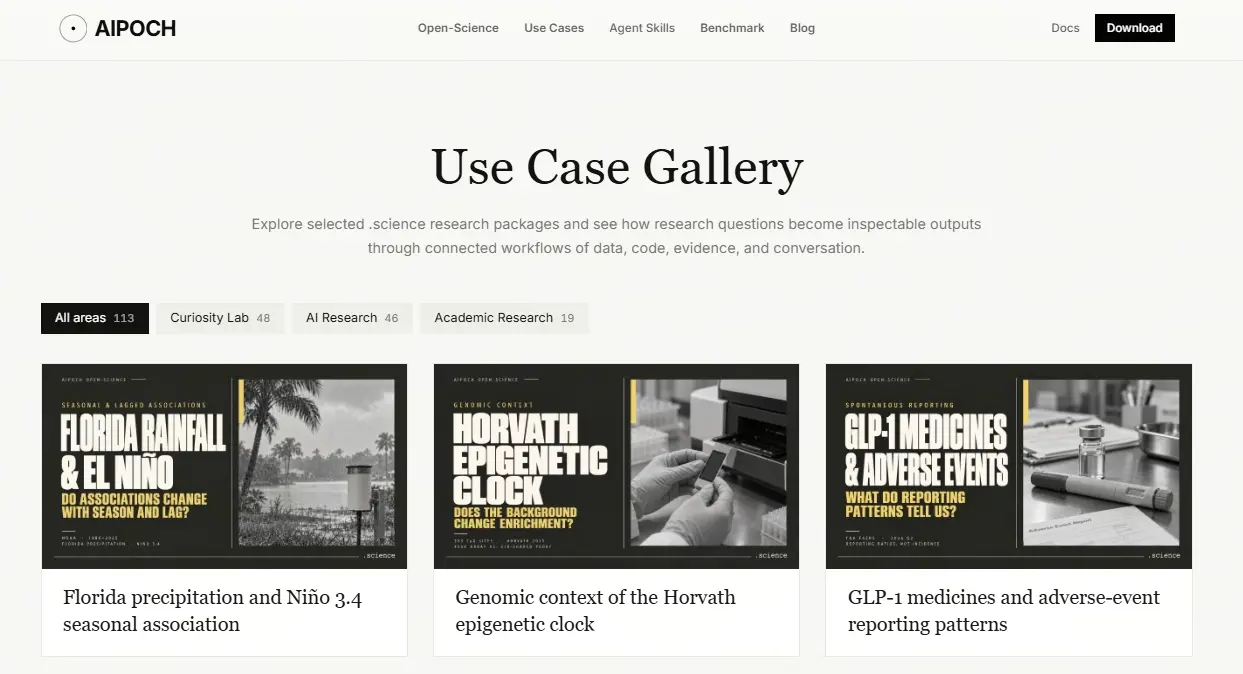
AIPOCH Open-Science 官网案例库
如果想更具体地理解 .science 的价值,不妨把它当成一份可以观摩的研究档案:研究者可以打开别人分享的研究包,沿着选定的对话分支、文件版本、Notebook 记录和验证证据,看看一个问题是如何被提出、分析和复核的。它适合用来学习专家怎样组织假设、选择数据、调用工具和检查结果,也适合团队在交接前先看懂一项工作的来龙去脉;导入后的内容仍是只读的,不会在本机执行代码或恢复凭据。
AIPOCH 已在 Hugging Face 和官网持续整理案例仓库,里面是可以直接浏览的研究实例:能看到数据、代码、证据和对话如何连接成可检查的产出。 可通过Hugging Face案例库和官网Use Case Gallery访问这些内容。
.science 包的组织理念也与 RO-Crate 等开放标准相呼应:研究数据、代码、作者、许可和 provenance 可以共同构成一个可交换的“研究对象”,让研究记录不再停留于某个软件界面里。
一、越攒越多的工具,越切越碎的流程
文献管理、数据分析、绘图排版、流程编排,科研的许多环节都已有成熟工具。选择丰富了,工具之间的衔接却仍然需要研究者自己完成。
文献保存在文献管理器里,原始数据分布在文件夹和数据库中,分析在 Python、R 与命令行之间展开,图表导出后再进入报告。跨工具工作时,研究者经常需要重新整理背景:数据来自哪里,变量代表什么,上一步采用了什么处理方法。
其中重复性的文件搬运、环境配置和信息核对,会占用额外精力,也可能引入版本混淆与操作遗漏。对刚进入一个研究领域的人而言,学习工具和准备环境,还可能成为开始分析前的一道门槛。
自然语言交互让任务的发起更加直观,但对话本身并不会自动解决这些衔接问题。AI 生成的代码在哪里执行,输入文件如何管理,图表怎样对应到具体分析步骤,仍然需要明确的工作机制。
从“能向 AI 提出要求”到“能持续开展一项研究”,中间还有一层工作需要接起来。
二、把研究任务,组织进同一个项目
AIPOCH Open-Science 的思路,是以项目为单位,将资料整理、计算分析与产物管理集中到同一个工作区。
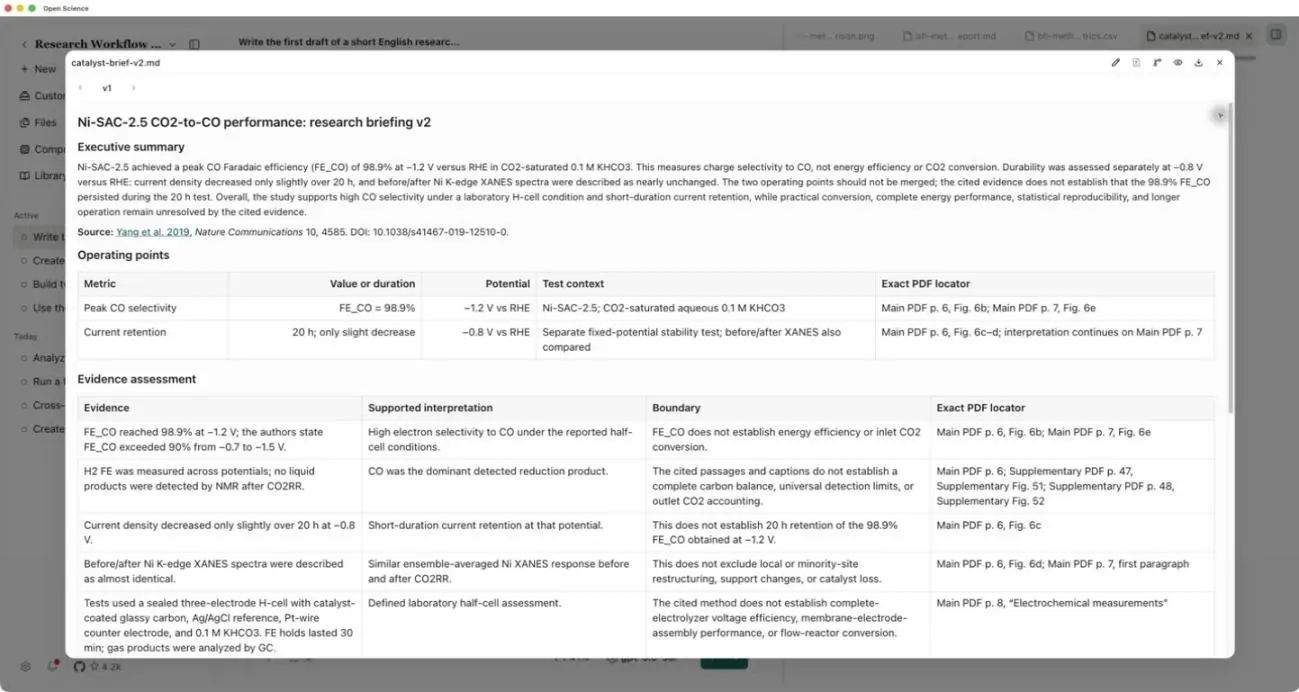
Open-Science 界面:一项催化剂研究简报的证据评估
研究者在项目中描述目标,引用论文和数据,安排分析任务,再查看生成的报告、表格与图表。相关文件与讨论记录保留下来,为后续工作提供上下文。执行层支持 Python 与 R 计算环境,运行中的内核能够保留变量和分析状态,便于连续处理任务;耗时较长的工作可以在后台运行。本地算力不足时,还可使用已配置的 SSH 远程主机或 Slurm 集群。
项目文件和工作区记录默认保存在本地。但需要说明的是,调用云模型、网络搜索或远程科研连接器时,提示词、必要上下文或任务输入可能发送给对应服务。工作台提供不同的权限模式,哪些操作需要研究者确认,可以按任务配置。
模型方面,Open-Science 支持多家模型服务及兼容的自定义网关,研究者可以按会话选择模型,在支持的范围内调整推理设置。更换配置后,仍需检查工具调用和任务执行是否符合预期。
工具连接之外,工作台提供方法复用的入口。内置科研连接器覆盖科学文献、生物医学等方向,精选技能涵盖文献综述、计算生物学等场景。研究者可以将常用流程整理成技能包,通过技能市场浏览、安装和更新,也可以配置专家智能体,明确其角色与可用工具。
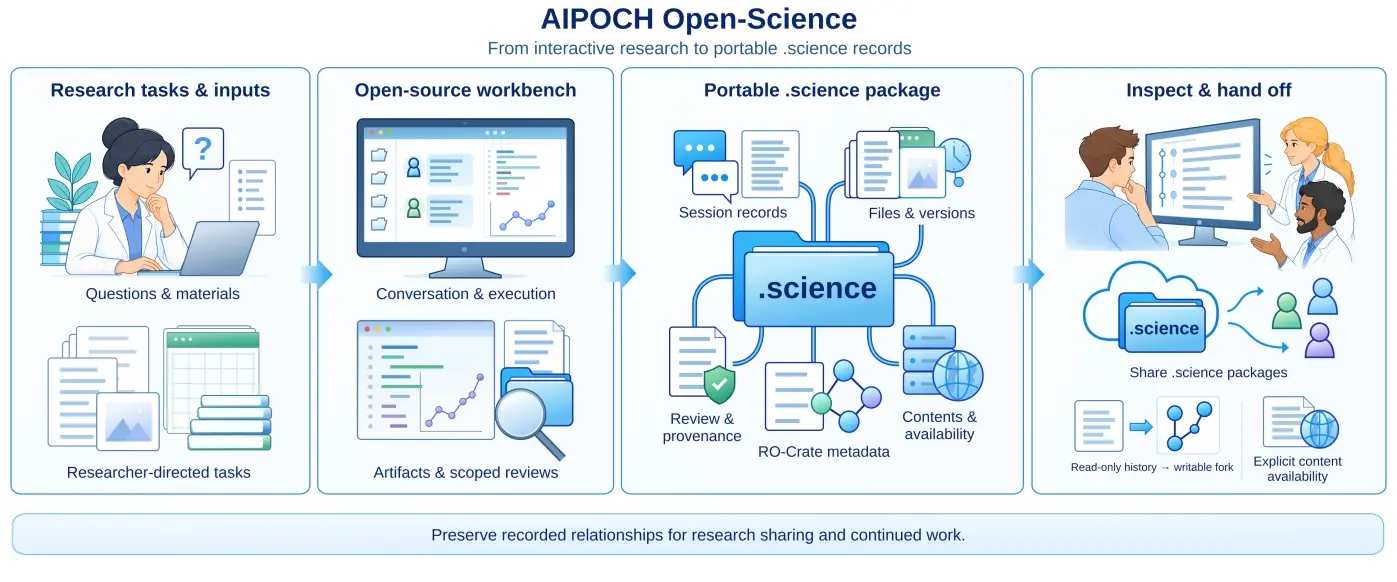
Open-Science 概念工作流:从研究任务、执行与复核到研究者接续
三、AI 做的分析,怎样留下可检查的依据
可复现性其实是一个老生常谈的话题了。2016 年《自然》的一项调查收集了 1500 余名研究者的回答,超过 70% 的受访者表示自己曾尝试却未能重复他人的实验。十年过去,当 AI 开始参与更多分析步骤,如何检查过程、解释差异,又增加了新的实际问题。
Open-Science 将研究产物与系统已经捕获的记录关联起来。对于报告、图表、表格等文件,工作台保存产物版本供研究者回看;在内置编辑器中修改支持的脚本或文本类产物时,保存操作会生成新版本,便于比较前后变化。
与版本相连的是溯源机制。研究者可以查看系统已记录并关联到该产物的代码、输入文件、执行历史、环境信息与对话上下文。无法获取或核实的证据会提示尚不可用,不将缺失信息当作已经确认的事实。
研究者还可以按需启用复核功能,让系统对照已有对话、执行记录和产物,提示缺乏支撑的结论、前后矛盾的表述或证据缺口。它提供的是辅助检查线索,不能替代对研究方法与科学结论的独立验证。
这些记录的意义在于:导师可以查看分析步骤,合作者可以核对某个数字,研究者为投稿整理方法时不必从零翻找。但需要讲清楚边界——记录和 .science 包可以降低核对与重用成本,完整重放仍依赖输入、执行配方、软件依赖、权限和可用环境。
过程可追溯,是让结果有线索可查;能否复现、结论是否可靠,还需要结合数据、方法与执行条件验证。研究判断仍由研究者完成。
四、从工具连接,走向方法共享
从 Vibe Coding 到 Vibe Research,变化首先发生在任务如何被提出、工具如何被调用。要让这种工作方式持续服务科研,还需要几层支撑。
第一层是降低操作门槛。通过自然语言组织任务,让研究者更容易调动已有工具,把更多精力用于问题、方法和判断。
第二层是连接工作环节。将文献、数据、代码、计算环境与研究产物组织进同一项目,减少重复搬运,让已经完成的工作能够为下一步所用。
第三层是支持开放复用。项目代码采用 Apache-2.0 许可证公开,研究者和开发者可以按许可条款查阅、修改和分发。技能包、工具配置与可检查的过程记录,为方法交流提供了更具体的基础。
软件开源不会自动公开研究资料。分享什么、向谁分享,仍由研究者决定;方法能否适用于新的数据,也需要接收者检查。在这一前提下,开放的工具与可携带的方法,有机会让跨团队复用和验证更容易开展。
Open-Science 想做的,不是又一个更会答题的 AI 工具。它想回答的是:当研究者把一部分操作交给 AI 之后,中间那层把文件、工具、环境和证据接起来的基础设施,应该长什么样。
“Science, Open to All”是项目写在官网上的话。落到具体工作里,就是让工具更容易使用,让过程更容易检查,让团队积累的方法有机会被更多人理解和改进。研究问题怎么提、方法怎么选、结论怎么判,这些仍然是研究者自己的事。