要我说,谷歌就是季节性气候模型公司,天气凉了,旗舰也就熟了。
刚刚,Gemini 4 Argon正式面向全球开发者、企业及付费订阅用户陆续开放。
按照谷歌的定位,这一代主要加强了编程、专业知识工作和复杂任务的持续执行能力,同时也把此前比较擅长的视觉理解、空间推理和工具调用能力进一步推向前沿。
在官方展示的demo中,看得出这次Gemini 4 Argon最自信的还是多模态方面。
输入一段模拟风筝的文字提示,生成的效果直接起飞。
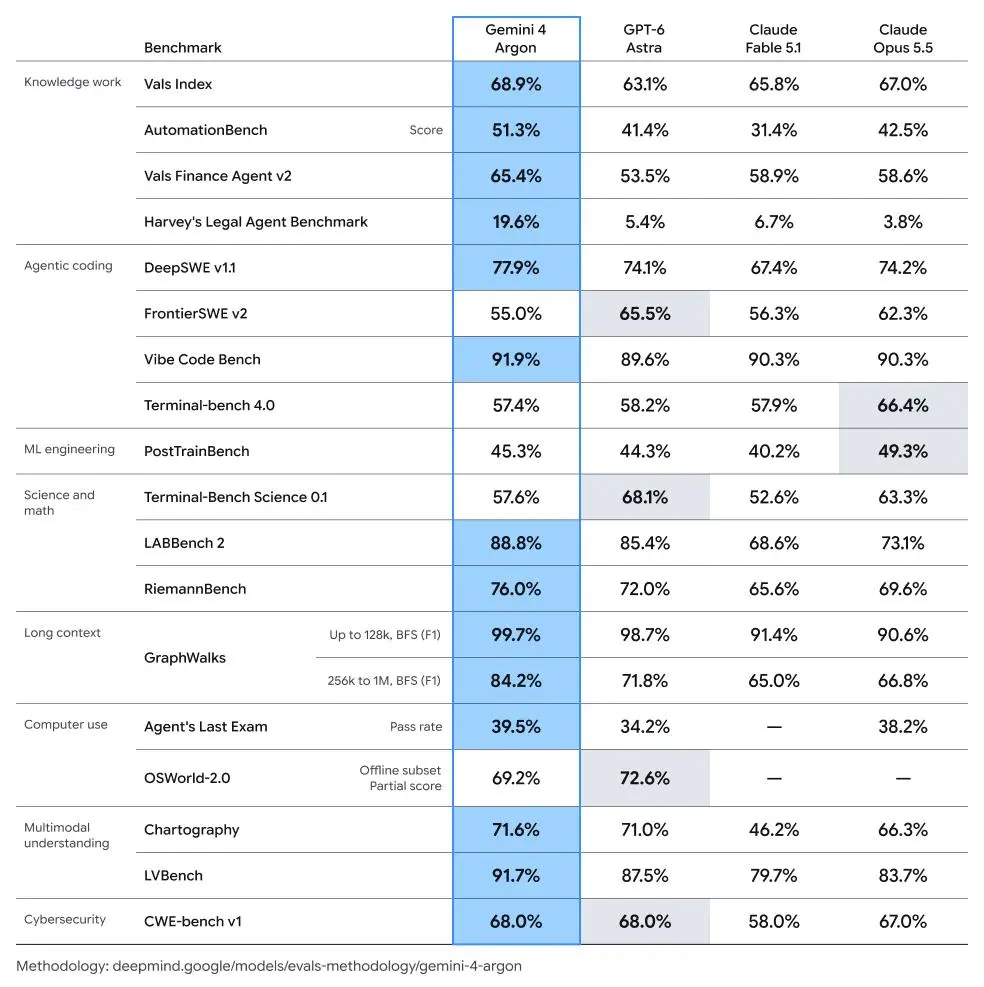
而在大家更关心的能不能重回御三家、给用户多一个模型选择这件事上,Gemini4 Argon这次在评测中也表现得相当争气。
在谷歌自家评测中,Gemini4 Argon覆盖了办公、智能体编程、机器学习以及科学推理等多个方向,整体表现已经达到GPT-6 Astra、Opus5.5的水平,其中不少项目甚至实现领先。
第三方Artificial Analysis智能指数中,Argon High也与GPT-6 Astra Max、Claude Fable5.1 Max并列53分。
更关键的是,在达到同等水平的情况下,Argon High的平均每任务成本仅为1.99美元,比Astra低约39%。
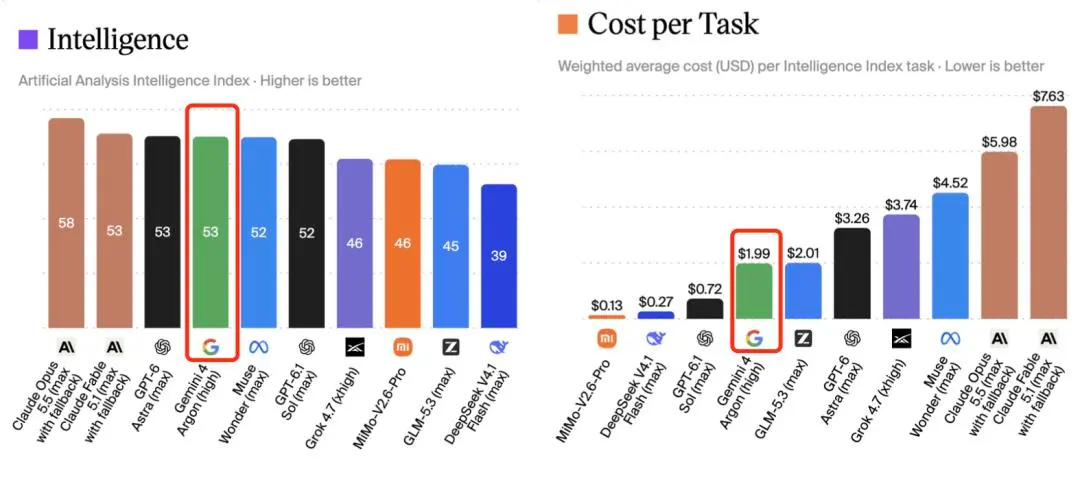
这一成本优势体现到首发价格上,就是API每百万输入token2美元,输出10美元。粗算了一下就是Argon的调用成本约为Opus5.5的一半、Astra的五分之一。
值得一提的是,优惠截至11月30日,12月1日起,输入和输出价格将分别恢复至4美元和20美元。也就是说,先打五折,欢迎大家来试。
当然,如果模型不够聪明,做个任务来回烧token,那省下来的钱可能又全烧回去了。
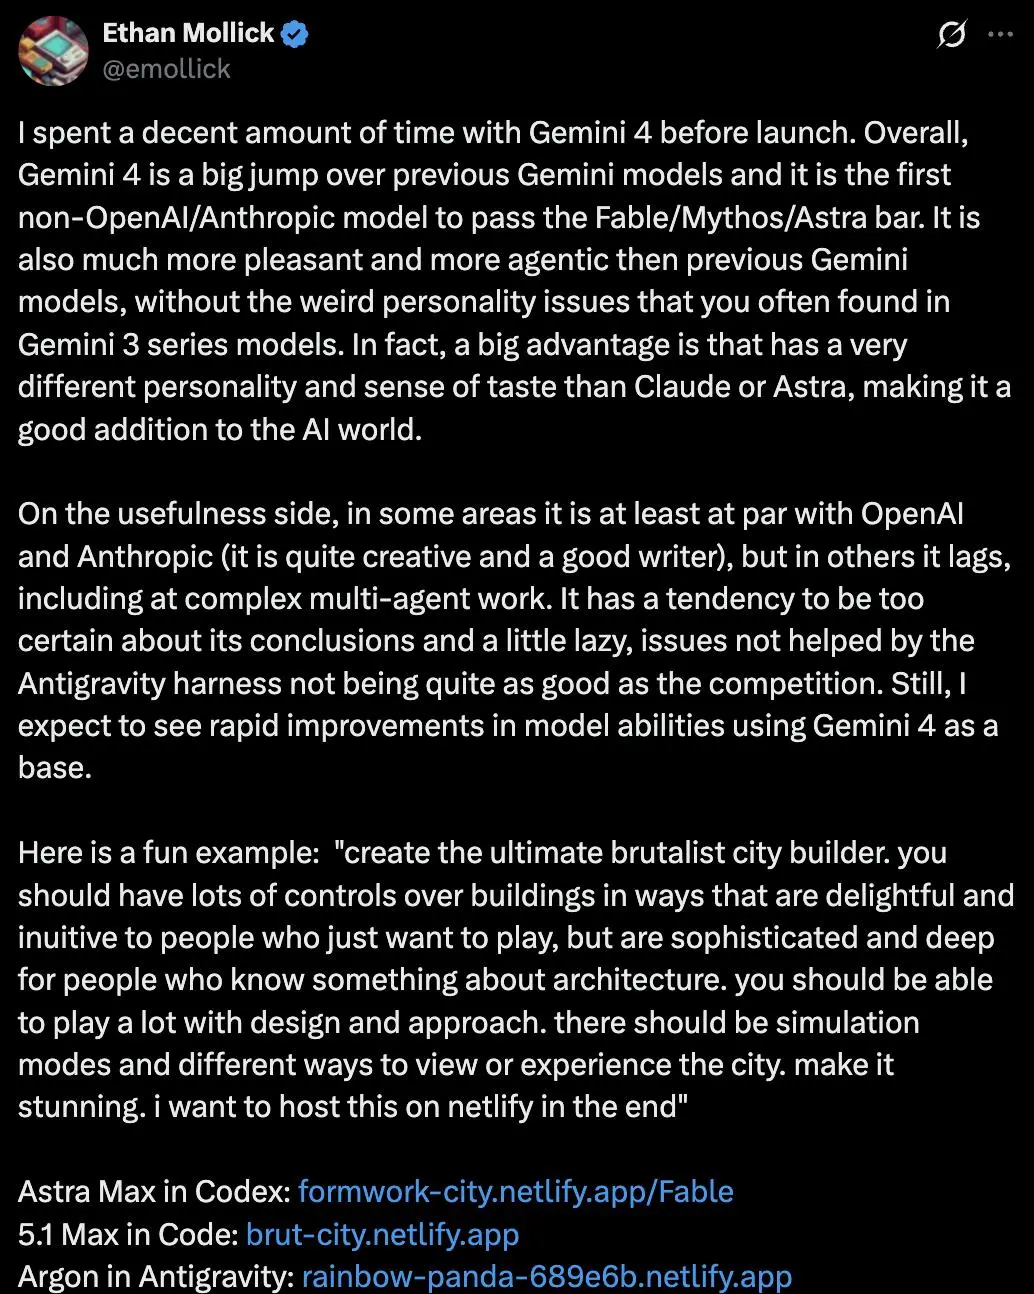
提前体验过Gemini4 Argon的Ethan Mollick,也给出了相当中肯的判断:
这一代相比此前的 Gemini 是一次明显跃升,创造力、写作和使用体验都有进步,但复杂多智能体任务仍有差距,偶尔还会过于自信、犯点懒。
至于为什么新一代旗舰又让大家等了这么久,我翻了翻谷歌的新发布页面,看到了一份217页的安全报告~
(谷歌还是太怕出事了)
最自信的还是多模态
从Pro版本一次次跳票,到今年9月30日宣布首期限量,再到不知道多少个“下周见”之后——
Gemini4 Argon,终于来了。
在官方技术博客中,谷歌把Argon的核心升级总结为一点:更强的长流程任务执行能力。
简单来说,就是模型不再只是回答问题,而是理解目标之后,能够自己查资料、调用工具、修改代码、检查结果,在多个步骤之间持续推进,把一件复杂的事真正做完。
不过,相比于企业、工程场景里的示例,谷歌这次最舍得展示,PR的其实还是多模态能力。
比如,劈柴哥就在推特上放出了一波“自家模型生成自家手机”的demo——
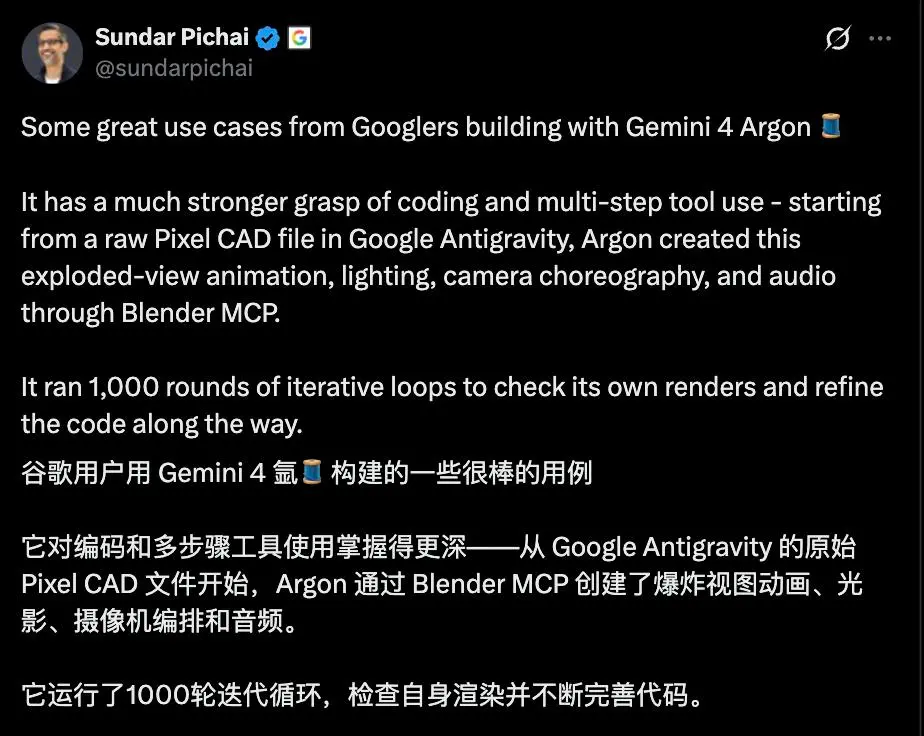
Argon直接生成了Pixel手机相关的3D场景。
另一个案例中,Argon甚至完全通过代码生成了一套3D动态排版效果,包括其中的音乐。
整个过程没有调用预录素材,也没有使用视频编辑软件。
Hassabis在转发巫师棋演示时,也特别提到了模型对于物理规律和3D建模的理解。
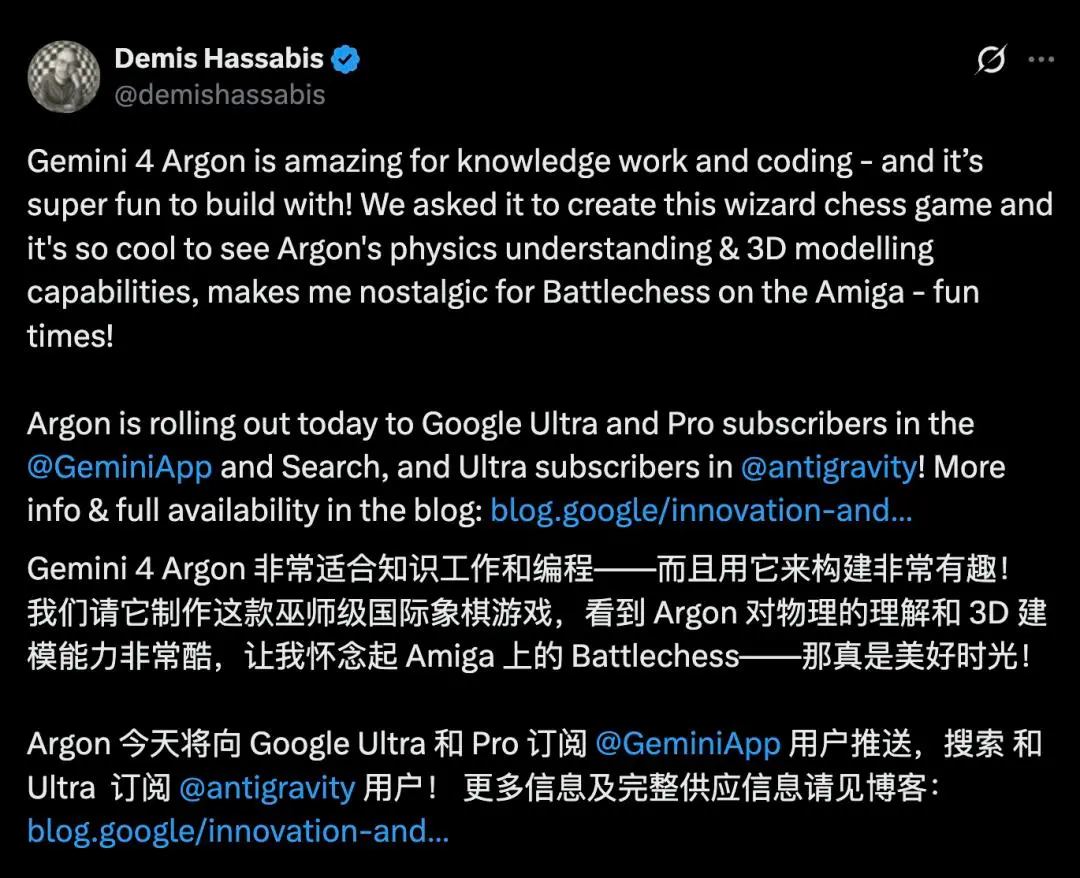
甚至这一幕,还让他想起了自己当年在Amiga上玩《战争象棋》的经历。
当然,网友也没闲着,很快把Argon和GPT、Claude、Kimi等模型放到一起进行了生成效果对比。
整体来看,谷歌这次的视觉质感确实非常突出,虽然细节上,比如鲸鱼的运动,仍然能看出一些不自然。
不过,也有网友测出来的结果是,Opus 5.5依旧是神中神。
除了好看的demo以外,这种空间理解能力,也进一步延伸到了真实机器人身上。
在官方展示中,Argon观看了一段人类玩沙包投掷游戏的视频。
随后,它分析环境中的空间关系,计算全身关节运动,自主编写仿真代码,并将方案迁移到Apptronik的Apollo人形机器人上。
可以说,看着GPT、Claude这两天疯狂进军机器人,谷歌这次也终于坐不住了。
谷歌表示,这套“视频—仿真—现实”的流程,可以把过去需要数周人工完成的机器人仿真建模工作,压缩到数小时。
背后的意义是,人类示范正在变得更容易转化为机器人可以学习、练习和验证的任务。
过去,看视频理解动作、搭建仿真环境、编写控制代码,往往是三个割裂环节。
而现在,多模态模型开始尝试把这条链路串起来。
编程提升,谷歌先拿自己的代码库试了
编程方面,这次Gemini4 Argon的核心提升,是处理大型真实项目的长期维护和优化能力。
相比过去只能完成单个代码任务,新一代模型更擅长理解整个代码库的结构,定位性能瓶颈,并跨文件修改、运行测试,把一个复杂工程任务持续推进下去。
这个能力,谷歌首先拿自家的开源智能体框架ADK做了验证。
这个Python项目约有20.5万行代码。团队给Argon的任务是:在不改变接口和现有行为的情况下,降低框架运行开销,并通过测试证明优化有效。
结果,Argon在无人值守状态下连续工作11小时,提出了涉及32个文件的6项优化方案,并跑完了全部16892项开源测试。
最终,经过工程师审核,其中两项优化被合并,包括减少会话历史复制开销,以及让大型模块按需加载。
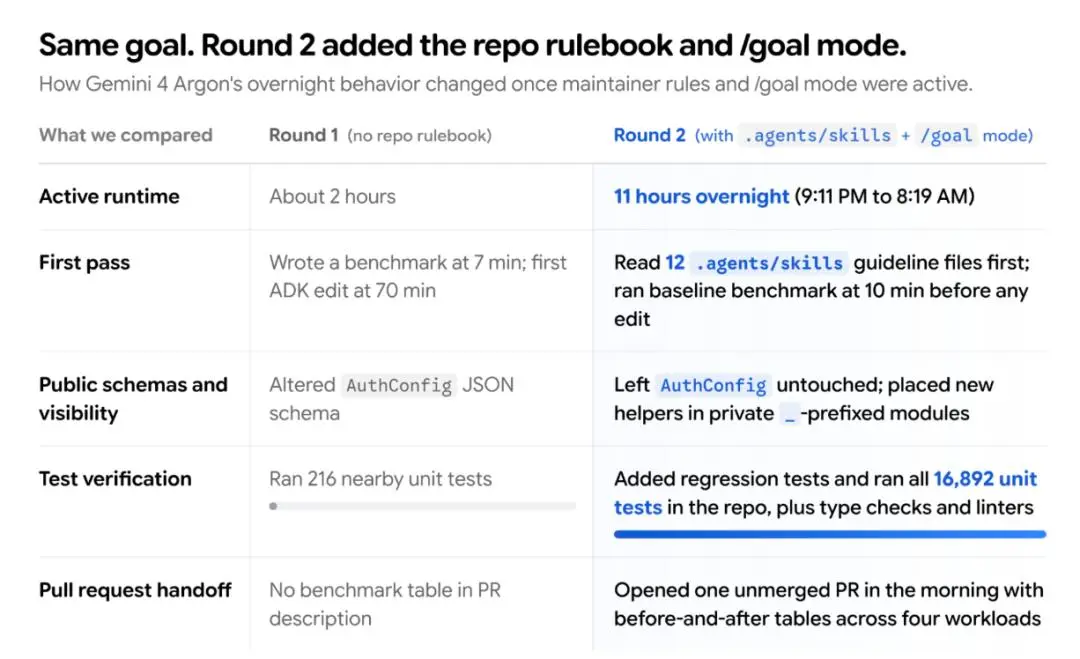
基于这些修改,ADK长会话中的内存准备开销降低约40%,包导入耗时降低21%。
类似的能力,也被谷歌用在了更大规模的工程任务中。
在Chromium浏览器项目中,Argon协助完成了一项涉及数百个文件的架构重构,把原本预计需要数月的工作压缩到了数周。
此外,在优化Gemma4E2B推理程序时,Argon将特定配置下的吞吐量从每秒约3.79万个token提升至超过10.8万个token,端到端速度达到原来的2.85倍。
谷歌表示,这类优化过去通常需要数月时间,而这一次只用了几天。
放到Google内部整体来看,过去几周,Antigravity中的Argon已帮助团队将智能体代码提交量提升超过35%,代码回滚次数减少近三分之一。
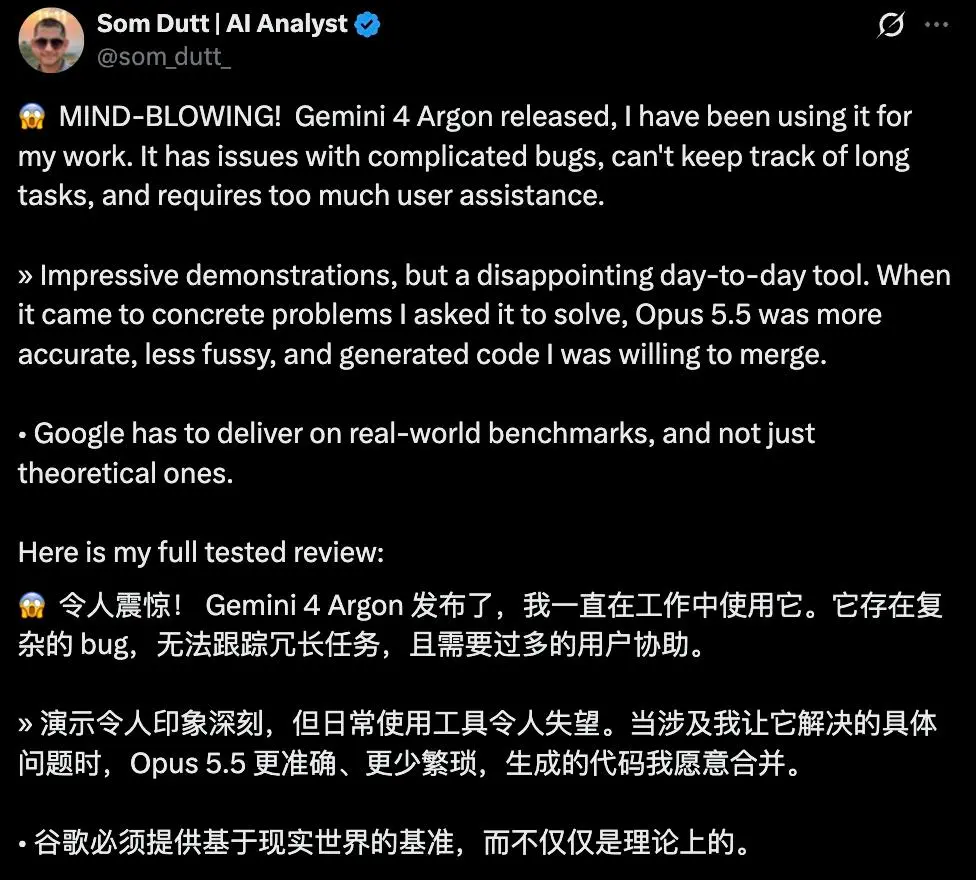
当然了,也有网友表示,自己用起来就没这么好了。真正具体表现还要看之后的大规模使用效果了。
这也和前面的榜单相互印证:Argon在DeepSWE、Vibe Code Bench上很强,但在FrontierSWE和Terminal-bench中,仍落后于表内几款主要竞品。

真实项目里的收益已经有了,能不能稳定复现到更多人的工作里,还得继续看。
专业知识工作能力进一步提升
专业知识工作方面,这次Gemini4 Argon的提升,主要体现在处理多种材料、关联信息,并把结果整理成可以直接使用的产物。
官方展示了一个非常典型的办公场景:
用户给Gemini一个装满零散项目资料的文件夹,要求它整理成一份客户提案。
随后,Gemini会根据自定义技能生成演示文稿,起草邮件、发送材料,并为后续客户请求设置自动化流程。
此外,Gemini应用也同步加入了任务入口。用户可以从聊天切换到任务执行模式,让模型在用户离开电脑后继续完成工作。
与此同时,Antigravity的编程界面也被整合进Gemini macOS应用。
科研场景中,这种连续执行能力则进一步延伸到了实验验证。
谷歌科学家让Argon参与设计丝氨酸酯酶。模型在数小时内完成数据整理、模型调优和候选筛选,最终提出5个新设计。
随后,研究人员把这些设计送进实验室,验证它们能否真正发挥作用。
实验使用的检测分子,其酯键被切断后,生成的产物会在紫外光下发出荧光。按照谷歌披露的结果,五个设计均表现出较强的催化活性。
模型交出的方案,已经走到了实验验证这一步。
谷歌还宣布,将向符合条件并获选的1万名科学家,免费提供六个月的Antigravity最高使用额度,分批开放。
One more thing
前面虽然调侃谷歌怕出事,但这次安全能力确实值得单独说两句。
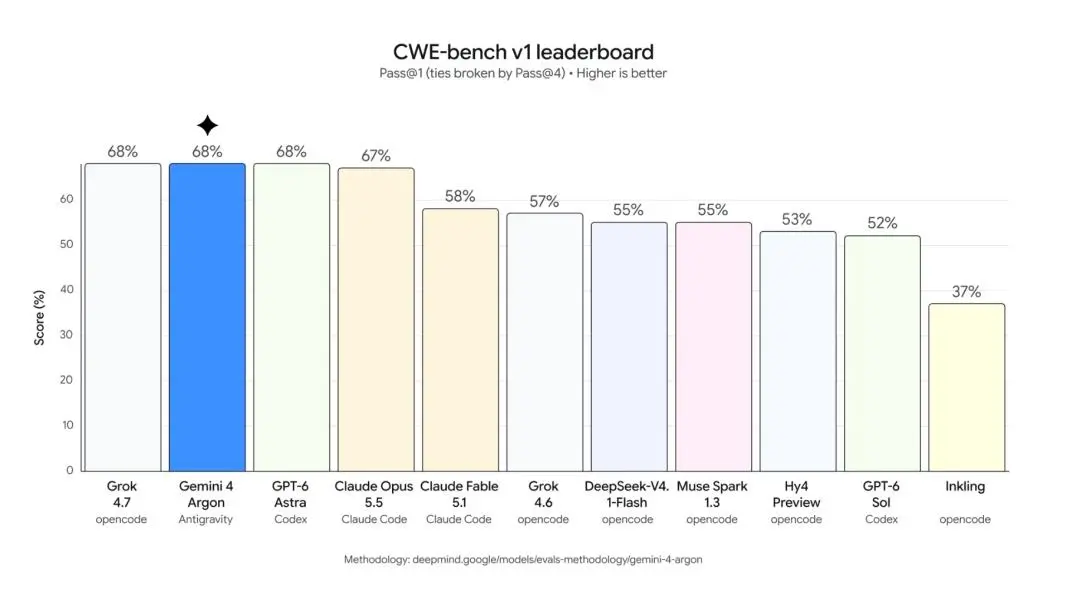
在评估漏洞修复能力的CWE-bench v1中,Argon取得68%的成绩,与GPT-6 Astra同处官方对比表的最高分。
前Anthropic,现DeepMind Mechanistic Interpretability负责人表示,Argon的安全报告是Google目前最详尽的。
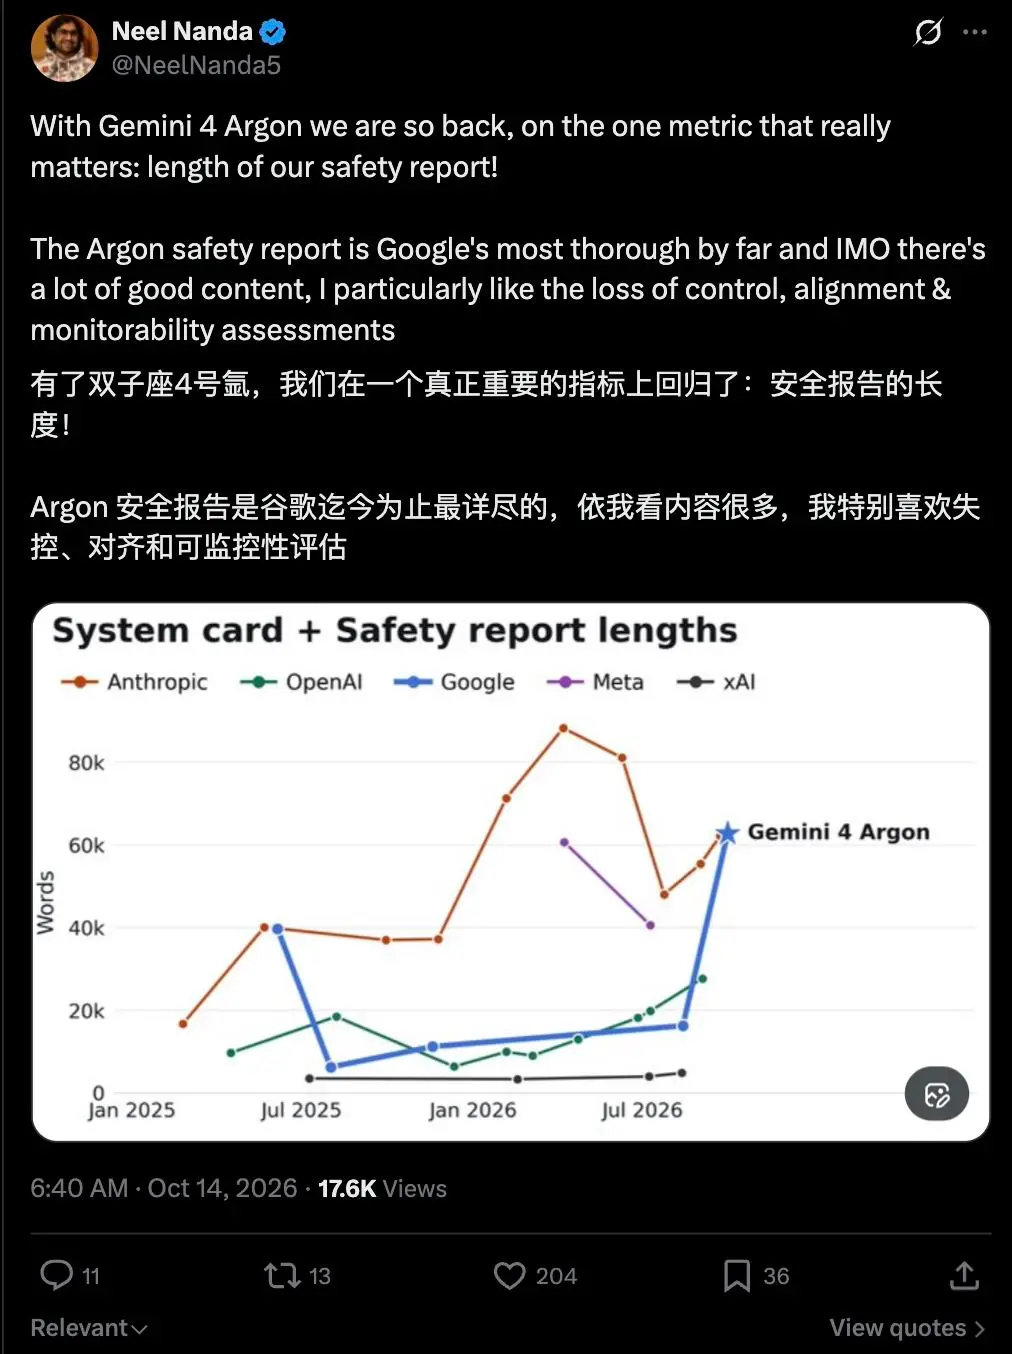
217页可不详尽吗?
在Gray Swan间接提示词注入评测中,经过15次自适应攻击尝试,Argon的攻击成功率为0.7%。
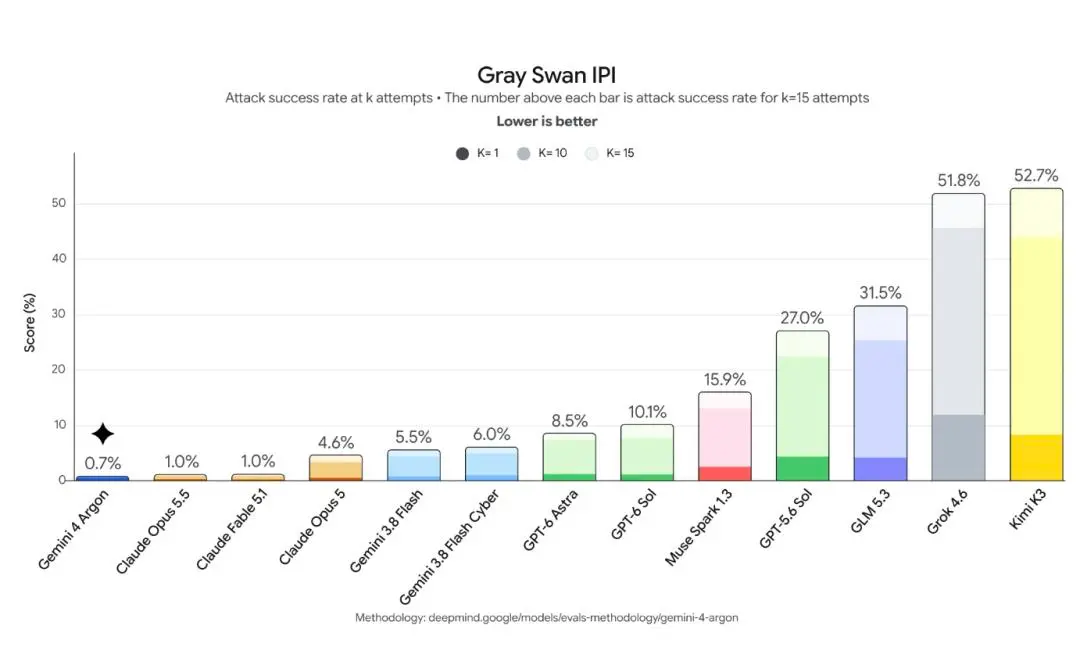
所以,那217页里,还是有不少正经内容的。
至于这是不是旗舰发得慢的原因,咱们没有证据。
只能说,模型终于发出来了,谷歌还顺手交了一本书。
参考链接
[1]https://blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-argon/
本文来自微信公众号“量子位”,作者:henry,36氪经授权发布。