出品 | 网易智能
作者 | 辰辰
编辑 | 王凤枝
Meta刚宣布追上OpenAI和Anthropic,就有开发者试完泼了冷水。
美国当地时间10月12日,Meta发布Muse Wonder和Muse Wonder Full两款模型,主攻个人助理和专业工作中的智能体任务。扎克伯格在X上宣布,Meta的新模型已经达到前沿水平。
Wonder已开放API,更强的Full则先进入编程工具Muse Code,面向订阅用户提供。
在接受《金融时报》采访时,扎克伯格谈到一个让他觉得奇怪的现象:AI已经能做高深数学,却还不能稳定地为所有人做好客服。
按照Meta的介绍,Wonder这次加强了记忆和持续执行任务的能力:找回用户此前交代过的要求,遇到障碍时尝试其他办法,让Muse在订餐、购物、安排出行时,少一些反复询问,少一些半途卡住。
不过,新模型发布后,开发者的反馈并非一片叫好。
开发者Theo把Full与Claude Opus 5.5排在同一档,随后又专门提醒:通过API提供的标准版Wonder明显更弱。
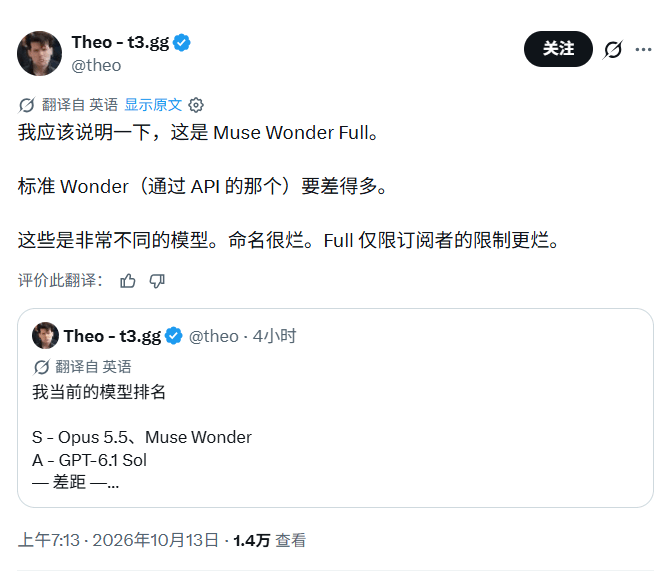
他连同两个版本的命名、Full只能订阅使用的安排,一起吐槽了一遍。
一、榜单冲上来了,开发者的评价却不一样
Muse Wonder系列的内部代号是“西瓜”(Watermelon),上一代Muse Spark则叫“牛油果”(Avocado)。Wonder面向日常工作,更大的Wonder Full提供更强能力。
在Artificial Analysis的Intelligence Index v4.3中,最高推理档位的Muse Wonder取得52分,Wonder Full取得56分,上一代Muse Spark 1.3为48分。Full超过了Claude Fable 5.1、GPT-6 Astra和Gemini 4 Argon,仍落后于Claude Opus 5.5。
两代模型的发布时间相隔六周。Full在该指数的十项评测中全部超过Spark 1.3,其中六项进入前三;提升较大的项目包括需要使用终端完成任务的Terminal-Bench 4.0,成绩从33%升至约57%。
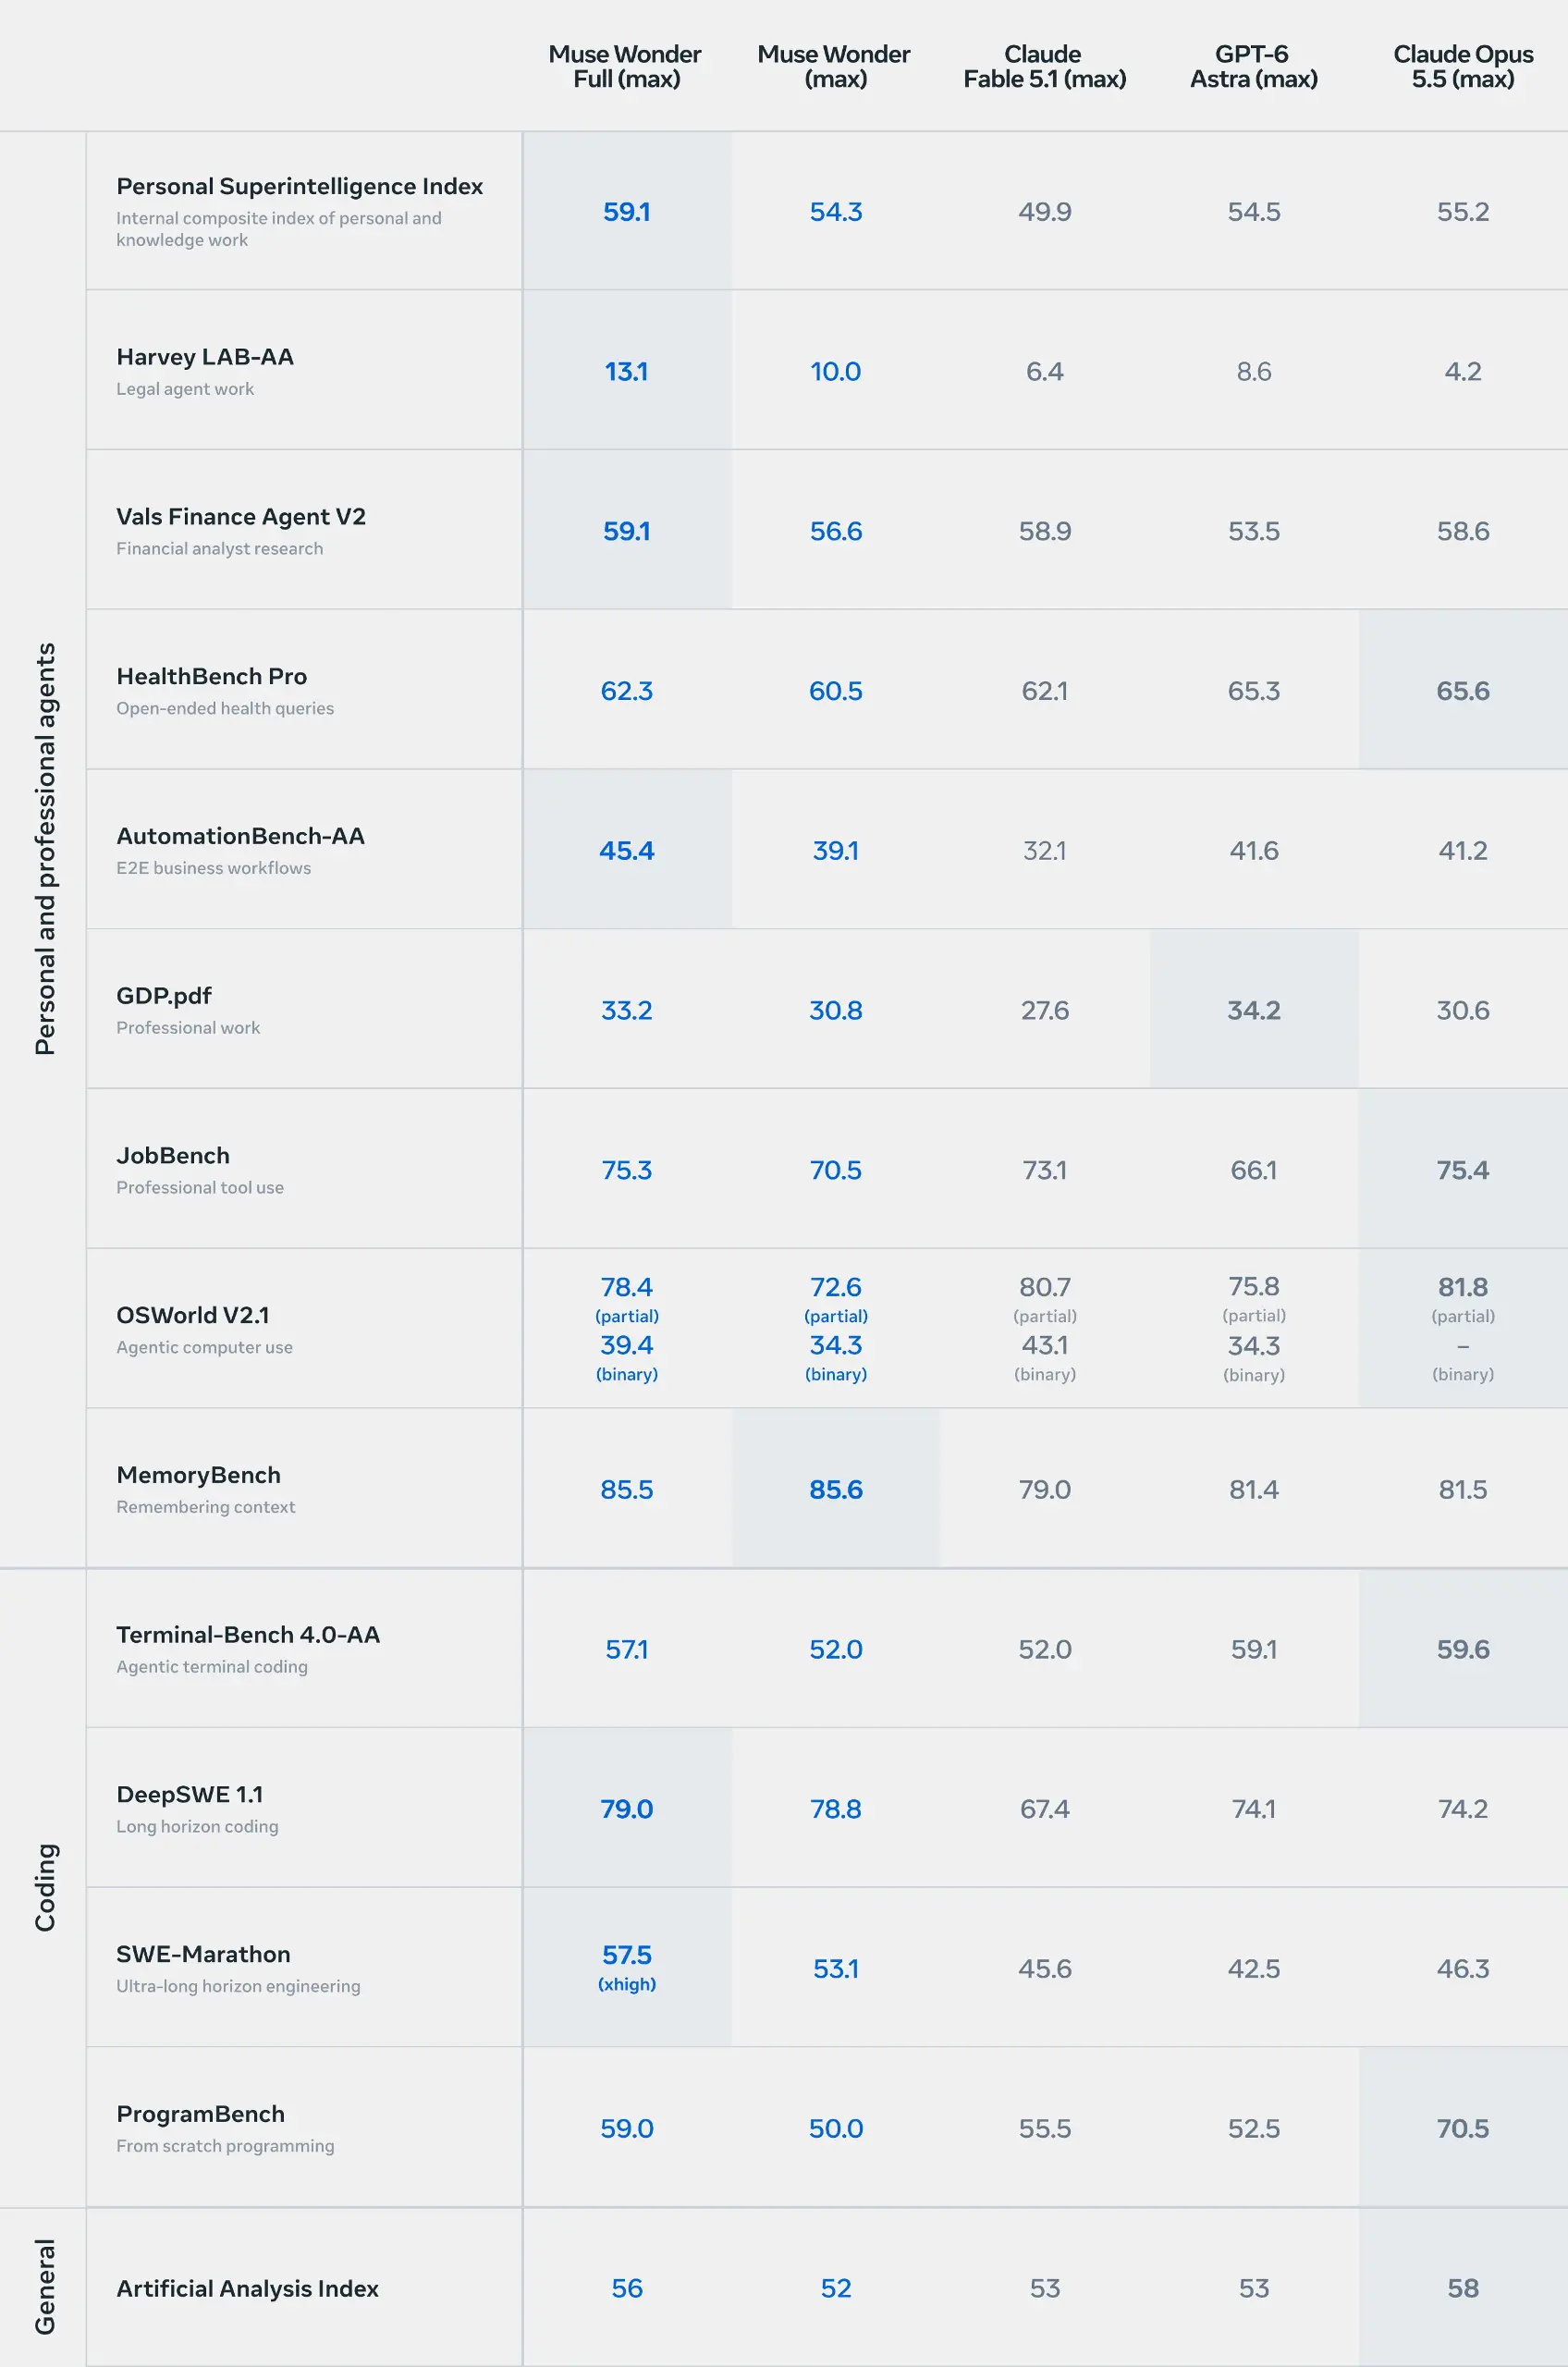
在Meta公布的长时间软件工程测试SWE-Marathon中,Wonder Full得分57.5,高于同表中Claude Opus 5.5的46.3和GPT-6 Astra的42.5;在DeepSWE 1.1中,三者分别为79.0、74.2和74.1。

另一组第三方结果来自Artificial Analysis的编程智能体指数。在最高推理档位下,Muse Code搭配Wonder Full得到68分,与Claude Code搭配Sonnet 5.5的成绩相同;Muse Code搭配Wonder为63分,搭配上一代Spark 1.3则为54分。
这里测的是模型与编程工具配合完成任务的表现。
长时间编程往往要反复查看代码、修改多个文件,再运行测试、处理报错。Meta称,团队用多种长任务训练了这两款模型,让它们在连续测试和修改中保持进展。
Every另做了一项代码库重写测试,让模型从头重写一个由AI辅助编程生成的项目。截至发稿,参加测试的标准版Muse Wonder 1.0得分48%,GPT-6.1 Sol为71%,两者均使用Codex CLI和high推理档位。
这张表只覆盖一个重写任务,按检查项计分,没有Wonder Full的成绩。
对于开发者常用来展示效果的3D小游戏,Meta首席AI官汪滔(Alexandr Wang)在X上表示,团队没有针对这类演示专门训练模型,并请大家把Wonder用到实际编程工作中。
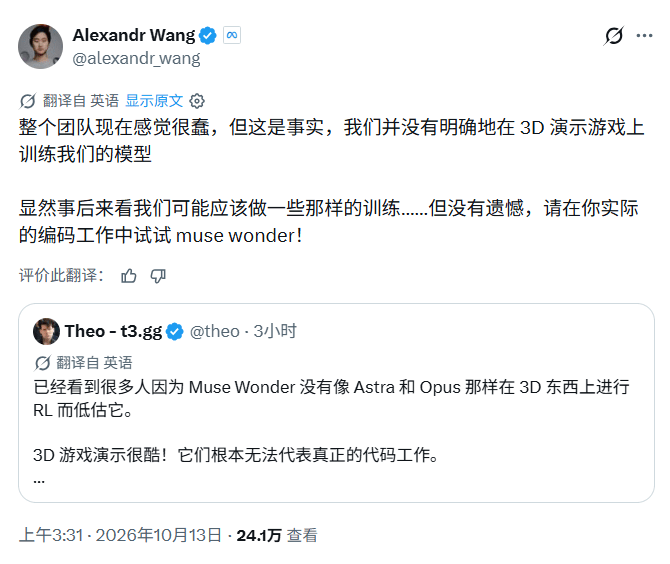
Theo已经让Opus调用Wonder做代码审查和架构审查。网友bubble boi也称,自己用Wonder生成了RISC-V处理器核心设计,正用OpenROAD处理,并计划随后流片。
测试Full的开发者Claire Vo,对不同任务给出了不同评价:智能体任务表现突出,编程有竞争力,写邮件也不错;前端设计、其他写作和创意任务则不够理想,她还抱怨了Muse Code的使用体验。
另一位用户imjustnewatai的评价更低,认为实际表现配不上榜单成绩,与Opus 5.5仍有明显差距。
二、记住前面的要求,遇到障碍换条路
离开代码编辑器,Muse还要处理订餐、购物、安排出行这些日常事务。用户交代过的条件可能分散在几次对话中,执行到一半又碰到网页无法访问、预约时间不合适等问题。
助手要接着办事,就得找回相关信息,再决定下一步怎么做。
Meta把这次重点改进的两项能力称为“主动记忆”(Active Memory)和“主动专注”(Active Focus)。
主动记忆要处理的,是跨对话的信息:记住与用户有关的重要内容,在后续任务需要时主动找出来。在Cheeky Pint访谈中,汪滔解释,团队同时设计了模型和配套系统,模型也需要学会利用不同信息来源、有效压缩上下文。
扎克伯格在同场访谈中,讲了一个与“西瓜”有关的小插曲。他三岁的女儿喜欢烘焙,自己会在一周里用尚未全面开放的Muse语音模式讨论食谱,到周六再由Muse通过Instacart准备食材。
最近一次,食材订单的金额没达到配送要求。Muse知道代号“西瓜”的新模型即将发布,便提议往订单里加一个西瓜,还问他要不要。扎克伯格同意了。他在发布直播中吃的,就是这个西瓜。
主动专注则针对任务执行。汪滔告诉CNBC,现实中的任务总会遇到障碍和意外,团队专门训练模型尝试其他办法,减少一遇到问题就停下来找用户的情况。
Meta的产品说明同时保留了确认环节:有必要时澄清要求,在重要操作前征求用户意见。
要办好这些事,模型还得懂任务涉及的知识。汪滔说,理想中的个人智能体,应该让用户觉得身边有一整支专家团队,包括法律、财务和医疗方面的帮手。
为此,团队在预训练阶段就加入了相关领域的数据,而不只在后续训练中练习执行任务。
官方发布页给出的演示包括根据图片制作可玩的3D厨房游戏,跨网页和应用规划跑步路线,以及安排婚礼座位表。法律和金融测试则考察它能否结合材料、遵循细致要求,完成专业工作。
扎克伯格最喜欢的用法之一,是让Muse当综合格斗教练。他在健身房装上摄像头,让模型看训练画面,在回合间歇给反馈。间歇只有一分钟,有一次Muse给反馈就占去了约30秒,他嫌太慢,要求它再快一些。
为了分析训练视频,智能体会在后台编写视频处理程序、提取画面,他自己不用看代码。此前,他也用OpenClaw尝试过这件事。
而这些日常要求,很难在训练中逐一列尽。Meta这次还测试了模型处理陌生任务的表现:一组任务是后训练重点覆盖的,另一组则没有被专门针对。
以两代模型在前一组任务上的表现作为参照,Wonder Full在陌生任务上的成绩,高于按Spark 1.3的表现趋势推算出的水平。Meta将这一差别归因于更大的基础模型,认为它有助于把学到的能力用到新任务上。
三、免费版保留,Wonder先向订阅用户开放
Muse应用不会因为Wonder发布就全面收费。扎克伯格在访谈中说,免费使用仍由Spark提供;Wonder规模更大、服务成本更高,初期主要面向付费用户。
正式发布当天,Wonder已可通过Meta Model API和Muse Code使用;更强的Wonder Full只向Muse Code订阅用户开放。
Muse应用内的Wonder升级则还要稍等。
据CNBC报道,Muse应用有每月20美元和100美元两档订阅,Muse Code则有每月50美元和200美元两档。应用订阅和API调用分别计费。
Wonder的API价格为每百万token输入4美元、输出20美元、缓存输入0.20美元。Full尚未公布按token计费的价格。
对于开发者,换模型后的花费还涉及任务要调用几轮、读入多少内容,以及缓存能复用多少。
Artificial Analysis在综合指数测试中测得,Wonder和Full每项任务平均使用约5.4万输出token,比Spark 1.3少约10%。
但在该机构按综合指数任务计算的加权成本中,Wonder仍达到每任务4.52美元,上一代为1.60美元。
在该机构为各模型选定的推理配置下,Wonder的测试成本低于Claude Fable 5.1的7.63美元、Opus 5.5的5.98美元和Sonnet 5.5的5.46美元,高于GPT-6 Astra的3.26美元和Gemini 4 Argon的1.99美元。
上线当天,订阅额度还出了岔子。《金融时报》报道,Muse Code出现用量计入额度的错误。
汪滔随后在X上表示,团队已修复导致Wonder和Full额度消耗异常快的问题,并重置了Muse Code的使用额度。
四、模型还没做出来,投入就得先定
Wonder背后,是Meta对AI团队和技术体系的一轮重建。2025年4月,Llama 4的表现未达外界预期。此后,扎克伯格加大数据中心和人才投入,请来Scale AI创始人汪滔,领导处于核心位置的TBD Lab。
Meta在此次公告中说,整套AI工作的重建始于14个月前。团队重新搭建技术体系,再逐步扩大模型规模。Wonder和Wonder Full在吉瓦级Prometheus数据中心完成训练,升级同时涉及预训练和强化学习。
今年4月推出的Muse Spark,是TBD Lab组建后的首个模型成果。9月,搭载这一系列模型的Muse应用走红。据《金融时报》报道,截至Wonder发布时,Muse仍位居美国苹果和安卓应用商店下载榜首。
在Muse应用走红之前,大笔投入就已经提上议程。
扎克伯格在Cheeky Pint中回忆,去年底讨论1000亿至2000亿美元级AI投入时,尚未看到最终模型,他曾问汪滔是否确定能做成。
这段回忆也被投资者Shay Boloor转发到了X上。
扎克伯格在访谈中还给出了一笔粗略的基础设施账:一个吉瓦级算力集群,前期建设约需500亿至600亿美元,运营一年约需150亿美元。
训练前沿模型时,除了大规模训练本身,还要做大量较小规模的实验;模型推出后,也需要算力支撑用户调用。
汪滔把这称为“困难模式的创业”,与精益创业正好相反。
通常,创业者可以先用较少的钱验证想法,看到效果后再扩大投入;做前沿模型,却得在看到最终结果之前,先决定投入多少算力、招来怎样的团队。
五、越了解用户,越要管好权限
助手越了解一个人,代办任务时就越容易碰到隐私问题。扎克伯格举了订餐的例子:如果用户怀孕了,或对某些食物过敏,Muse需要据此挑选餐厅,却不该每次都把健康状况告诉对方。
他希望助手在把事情办成的同时,尽量少透露用户的信息。
Meta称,Wonder系列加强了对抗恶意指令和处理私人信息的能力。在公司公布的未授权代码执行、个人信息处理测试中,两款模型的表现优于同表中的Claude Fable 5.1和GPT-6 Astra。
Meta还称,针对化学、生物、放射、核及网络滥用的防护达到公司迄今最强水平,完整的安全评测报告将随后发布。
Muse此前已经遇到授权争议。一些用户称它在未获许可的情况下访问私人消息,Meta对此予以否认。
汪滔向CNBC解释,有些用户在较早的对话中允许了某类通信,后来忘记自己给过授权;团队正在跟进相关事件,并帮助用户了解产品的使用方式。
这种解释也留下了一个具体问题:一段对话里给过的许可,到下一次执行任务时,用户是否还清楚它覆盖哪些操作。
记忆能帮助助手少问几遍,涉及对外通信和私人信息时,确认又不能省错地方。
外部平台也会限制助手能做的事。Muse上线后不久,亚马逊就屏蔽了它在网站上的购物行为。即使模型更会操作网页,能否进入用户常用的平台,仍会影响任务能否完成。
扎克伯格还向《金融时报》提到了正在准备的Muse Confidential VM。按照Meta的设想,这个版本将让公司也无法接触用户的数据及其与智能体的对话。截至此次发布,该版本尚未推出。