AI视频领域又出新状况,但这次搅局的不是Minimax H3这类专业模型,而是以往只用来对话的通用大模型。
不久前,Anthropic发布Claude Opus 5.5,虽然官方文档中并没有任何一个段落提及“视频生成”或“图像生成”这样的功能,但发布不到一周,社交媒体上就出现了大量让人意外的动画和短片。
有人用它在12小时内做出一部反乌托邦风格的叙事短片,有博主用它生成产品发布视频、科普讲解动画,甚至带有粒子特效和音频同步的Motion Graphics作品。更有开源社区整理了数百套提示词,按动画、3D场景、交互效果等分类归档。

马斯克多次转发这些作品,其中一条评论被广泛传播:“这一次我真切感受到了AGI的深远影响。”
这就是横空出世的“Vibe Video”,即不依赖专业视频模型,仅凭大模型写代码,就能产出完整视频。
一个在大家印象中只输出文本的模型,正在被全球创作者当作“视频生成工具”使用,这个“跨界”是不是很有意思?
当然,真正的视频生成模型也不会闲着,其中占有率最高的Seedance 2.5已经以原生30秒直出和50个多模态参考素材的能力,坐稳国产视频模型第一梯队。快手旗下的可灵4.0在9月底也带来了10-bit HDR、精准多关键帧控制和最多15个参考资产的Omni Reference系统。
通用大模型跨界而来,似乎要重新定义“AI视频”这件事,而专业视频模型在画质、时长、控制力上也在持续加码。一系列问题不可避免地出现,这两条完全不同的AI视频制作路线到底有什么不同?哪一条更强?
要回答这些问题,需要从理解各自的技术底层逻辑开始。
优劣对比,“Vibe Video”是如何实现的?
首先要明确的是,Claude Opus 5.5具备“视频能力”是一个误读,严格来说,Opus 5.5没有视频输出模态。
这种语言大模型不像专业视频模型,其工作方式主要是写代码,输出文本。所以,当用户要求“做一个30秒的动画”时,Opus 5.5输出的是HTML、Canvas绘图指令、SVG路径、Three.js的3D场景代码,或者GSAP的动画时间轴脚本。
常见的流程是借助诸如Playwright的浏览器自动化工具,打开大模型生成的HTML文件,通过JavaScript逐帧“seek”到特定的时间点,截取画面,再通过FFmpeg将连续帧编码为MP4视频。
这种通过代码渲染机制创作的视频最直接的结果,就是确定性。
同一段代码,输出的就是几乎完全相同的画面,同一个提示词跑两次,结果一模一样。这种情况下,创作者就可以具体到某一帧来调整视频内容。比如发现第137帧有问题,只要修改代码、重渲染那一帧就可以,而不用担心“抽卡”所带来的随机性。
第二个结果,就是可寻址性。
代码渲染的每一个视觉元素都有显式的坐标和参数,这样的好处是,如果你想让图片中的某个圆点左移20像素,改一个数字就可以。想让视频某一帧的画面晚0.2秒出现,改一下时间轴。

这种级别的精确控制,在Seedance2.5和可灵4.0等专业视频模型上几乎不可能实现,往往只能依靠“抽卡”,期待模型能“精准理解”你的意图。
当然,创作者最关注的还有成本问题。
Opus 5.5的API定价是每百万输入token 4美元、输出20美元。一个60秒讲解视频的代码生成,token消耗量通常在几千到几万之间,模型费可以控制在几美元以内。渲染成本主要是本地或云端的CPU时间,整体成本明显低于专业视频模型。
但是,这种代码渲染式的视频创作模式的局限性也非常明显。
首先就是代码渲染画不出真实世界。比如Anthropic官方文档中就表述称:“不使用视频生成模型,因此不会创建逼真影像或人物。”用户可以用代码渲染一个几何图形、一段数据可视化、一套界面动效、一段文字动画,但无法用代码“渲染”出一张真实的人脸或复杂的产品实拍镜头。
未来随着技术的进步,也许可以实现突破,但至少目前还不行。
此外,物理模拟的缺失同样不容忽视。
代码渲染可以做运动学动画,比如物体沿预定轨迹移动、旋转、缩放等等,但其没有内置的物理引擎来模拟重力、碰撞、流体、布料。如果要做一个“苹果落地”的动画,程序员需要显式写出重力加速度、初始高度、落地反弹系数。而在视频专业模型中,模型“见过”足够多的苹果落地视频,生成时能够“猜”出符合物理直觉的画面,所以作品可以更接近真实画面。
输入模态也是一个明显的限制,诸如Opus 5.5这类大模型可以读文字、图片和文件,但不能根据参考视频进行创作。如果创作素材是屏幕录制、产品短片等视频内容,就无法进行读取,这超出了它的能力范围。
这时候,就需要专业视频模型出场了。
专业视频模型的“三国杀”
Seedance 2.5、可灵4.0和Minimax H3都是专业视频模型的代表,都是基于扩散模型,经过海量视频数据的训练,学会从噪声中“去噪”出符合统计规律的像素排列,最终制作出视频内容。
这条路径的强项在于对真实世界视觉分布的拟合能力,比如光影、材质、人脸、复杂场景,都可以被“联想”出来。
但是,在具体的技术方向上,它们又各不相同。
Seedance 2.5的最新突破是从片段到叙事的切换,其单次生成时长已经从2.0时代的15秒翻倍到30秒,这个数字看起来只是参数升级,但用过就知道,30秒已经能完成一条完整的情绪弧线,而15秒只能完成一个片段。
多模态参考能力的升级也非常明显,Seedance 2.0支持最多9张图片、3段视频、3段音频作为参考素材,而到了2.5,这个上限被直接拉到了50个全模态参考,图片、视频、音频、文字可以混着来。
普通用户做视频,其实用不了这么多的参考,其主要面向的需求有两类:品牌内容需要保持多个演员形象一致、视觉系统统一;影视前期制作需要把分镜、角色设定、参考镜头、背景音乐一起丢进去看效果。而为了进一步对标专业影视的工业管线,Seedance2.5还新增了白模和绿幕参考能力。
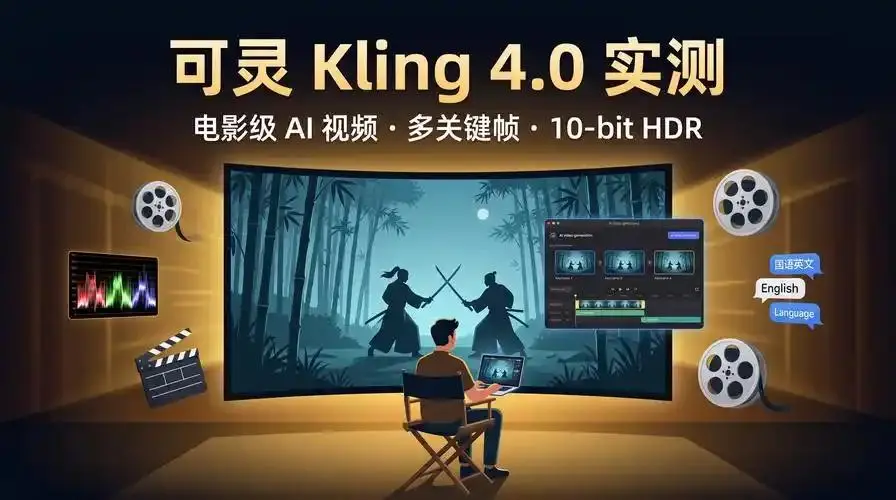
面对强势的Seedance2.5,快手终于在9月底把可灵升级到了4.0,其主要聚焦于控制精度和视听质量。其系统支持最多15个参考资产,包括最多10张图片、5段视频、7个主体(含指定声音)。而且,多关键帧控制支持最多10个关键帧图像,可以定义角色何时出现、场景何时变化、产品何时揭示。
但是,这些能力仍很难让可灵4.0抢走Seedance2.5的市场,其优势仍集中在画质,比如10-bit HDR输出,能够在4K和1080p下提供更丰富的色彩和更平滑的明暗过渡。在逆光、夜景、霓虹灯等高对比度场景,可灵4.0能保留更多高光和阴影细节,减少色彩断层。
据天眼查显示,可灵AI的运营主体为北京可灵科技有限公司,快手通过间接方式持有约68.33%股权,其财务业绩并入快手财务报表。而根据最新的消息,可灵估值已达到1200亿元,超过了母公司快手。
不难理解,可灵已经被快手寄予厚望。但是,从目前的视频效果来说,可灵4.0如果没有特别亮眼的功能提升,很难逆势翻盘。但如果你认为视频专业模型领域只是两强争霸,那就错了。
Seedance和可灵之外,MiniMax H3即海螺3.0的出现,正在让“专业视频模型”这个类别本身变得更为多元。
Minimax H3的核心规格是33B密集全模态生成模型,原生2K分辨率、24fps,单次生成4-15秒(可延长至约30秒),并且同样可以实现音画同步直出,和Seedance和可灵相比,并没有特别明显的差距。
音画同步,本质上是在视频生成之后附加的音频生成步骤,但H3的架构不同,它可以把视频和音频放在一个联合注意力序列中处理,这意味着声音和画面从第一个去噪步骤开始就在“互相看见”。一个角色张嘴的动作会影响生成的声音,反之亦然。
但是,Minimax H3最独特的属性还是开源。
H3的基础权重在Hugging Face发布后,直接催生了一个Seedance和可灵都不具备的生态。第三方团队可以下载权重、自行优化推理速度。
比如vLLM-Omni团队报告称,通过FastVideo的FastH3适配器,一段完整的10.1秒音视频MP4在约8.7秒内渲染完成,比播放时长还短。
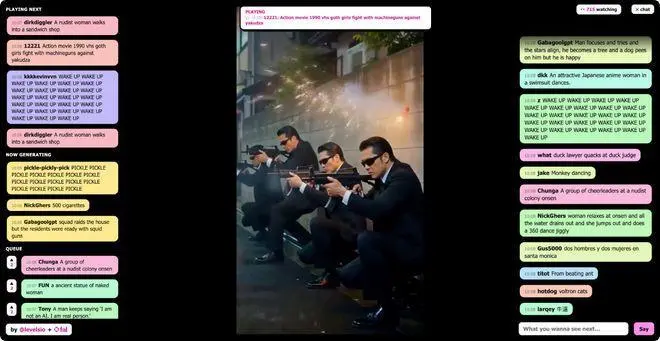
基于“快于实时”的能力,独立开发者Pieter Levels做了一个24小时AI直播网站Infinite Slop。观众在聊天室输入想看的内容,系统将提示词转化为下一段视频,并尝试与上一段画面衔接。观众不再只是收看节目,也开始决定节目接下来播放什么。
“永不结束的 AI 直播”,从段子变成了现实。Minimax H3打开了一个专业视频模型此前��法触及的场景。
更为重要的是,Minimax H3的“快于实时”不靠更大的GPU集群算力,靠的是开源权重让第三方团队做推理优化。这种策略,闭源模型的Seedance2.5、可灵4.0无法复制。而且,开源模型的成本优势也非常明显,MiniMax H3的15秒视频账单只要7块钱左右,仅是Seedance 2.5的五分之一。
如果用户把优化过的Minimax H3模型部署在家机器上,其成本将趋向于免费。无论是Seedance2.5还是可灵4.0,都不得不面对其竞争压力。
尤其是可灵4.0,本就处于和Seedance 2.5竞争的弱势地位。而更为“雪上加霜”的是,“Vibe Video”也来了。
两条路线,可灵4.0腹背受敌?
看起来,专业视频模型和Vibe Video代码渲染两条路线完全不是一回事。
专业视频模型的路线,不论是Seedance2.5、可灵4.0亦或Minimax H3,其核心都是对真实世界的拟合能力。模型从训练数据中习得了光影、材质、人体运动的统计规律,能“联想”出看似正确的画面。
“Vibe Video”的代码渲染路线的核心是确定性。其画面都是通过代码计算得出,每一帧都可预测、可寻址、可精确修改。
简单讲,专业视频模型用的是“猜”,代码渲染依靠的是“算”。但是,这并不代表着两种路线只能二选一。
马斯克转发的那条视频就是一个案例。
在该博主公开的提示词中,明确写了调用Seedance 2.5生成画面、ElevenLabs生成声音、fal跑视频生成,再用JavaScript叠动态图形。
也就是说,其画面并不是完全用代码渲染出来的,而是Seedance2.5生成,Opus 5.5在其中干的是导演+剪辑,是两条路线的融合。

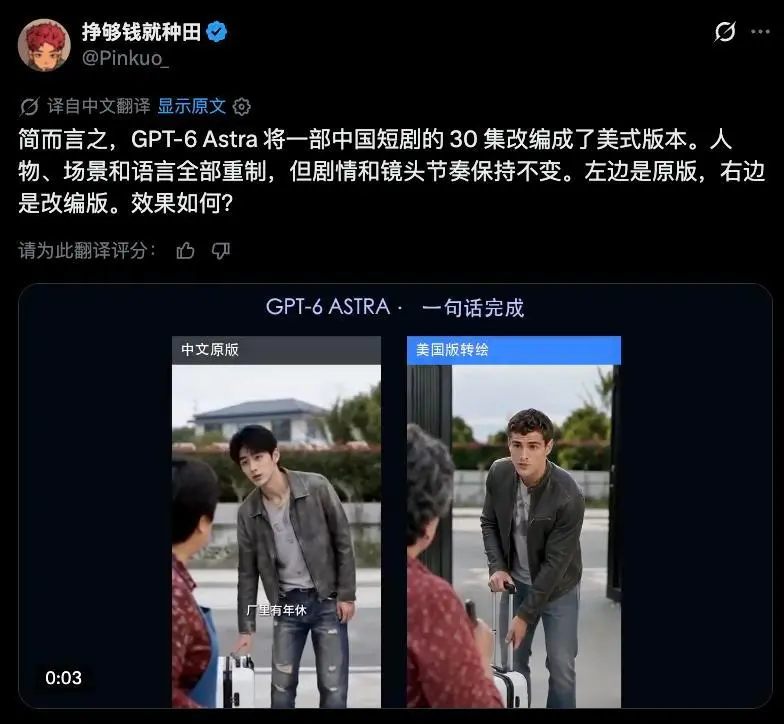
这里还有来自GPT-6 Astra的案例,Astra拿到一段总要求后,自己先写了一个剑斗故事,在Blender里完成预演,生成不同镜头的参考帧,然后再交给Seedance 2.5生成正式画面,进而把素材拖进剪辑工具,拼接出最后的成片。
人类只需要给出一段自己想实现的要求,从Brief到最终导出全自动完成。显然,一种分层协作的视频制作模式正在出现。
在这种新的分工中,专业视频模型作为被挑战的一方,护城河还靠得住吗?
相比代码渲染这条路线,Seedance2.5、可灵4.0这类视频专业模型的护城河显而易见,就是其拥有物理真实感的训练数据积累。
比如Seedance 2.5在复杂运动场景中能实现“人物动作建模此前未有的自然性、连贯性与物理合理性”;可灵4.0能够实现“动态运动和复杂镜头运动的流畅稳定”。这种能力来自对海量真实视频的训练,大模型只有“见过”足够多的人体运动、物体交互、光影变化,才能在生成时做出符合足够真实的画面。
然后就是工业壁垒,专业视频模型能够将工作流深度嵌入制作流程。
比如Seedance 2.5的白模和绿幕参考直接接入Maya和Blender的专业影视管线;可灵4.0的精准多关键帧控制让角色出现、场景变化、产品揭示的精确时间点可被定义。
但是,专业视频模型的护城河并非没有短板。
其一就是上游入口存在失守风险。如果 Opus 5.5、GPT-6 Astra这类通用大模型逐步掌控了“创意策划—分镜设计—镜头预演”的上游环节,专业视频模型就可能被降格为渲染引擎。价值分配会向规划层倾斜。
其二就是轻量场景可能被替代。比如Claude Motion的定位就是all-hands讲解、董事会图表动画、客户引导走查,这些场景不需要写实画面,不需要复杂物理模拟,代码渲染的确定性和可编辑性反而优于专业视频模型。
如果这类“轻视频”需求规模足够大,专业模型在这一细分市场的空间势必会被压缩。而进一步细化来看,Seedance 2.5在专业视频领域占据头部位置,是Vibe Video路线优先联合的对象,Minimax H3则具备开源优势,只有可灵4.0相对弱势,处境“腹背受敌”最为危险。
当然,专业视频模型也在努力反向渗透,都在努力开发“编导思维”,自主规划镜头语言、设计视觉模板,都在强调“以导演的眼光扩展和精炼你的指令”。
两条路线的攻防战,目前看才刚刚开始。
结语
所以,一个可能的分层格局正在AI视频制作领域形成。前述GPT-6 Astra+ Seedance 2.5的“AI剧组”模式,正是这个分层的实证。
上游设计由通用大模型占据,Claude、ChatGPT为代表的大模型凭借语言理解和编排能力,可以将模糊的创意拆解为分镜脚本、时间线、素材调用计划,决定“要做什么”。
生成层由专业视频模型主导,Seedance2.5、可灵4.0、Minimax H3等执行具体的画面生成,其核心壁垒是物理真实感、多模态控制和工业化工作流嵌入等。
动态图形、数据可视化、界面动效等视频效果,正在被通用大模型的代码渲染功能接过去,其具备确定性、可控性和低成本的优势。
回到最初的问题,“跨界”而来的代码渲染和专业模型,到底谁更强?答案是各有所长。
未来最有效的生产范式,可能不是选择其中一条路线,而是各司其职。通用大模型决定“要做什么”和“如何改动”,专业视频模型决定“要怎么画”。
市场,正在用真金白银为它们分别定价,你认为哪一条路更有价值?
本文来自微信公众号“铑科技”,作者:鸿辰,36氪经授权发布。