引言
我们提前获得两台NVIDIA Vera Rubin节点(共8张GPU)的访问权限,并成功将SGLang与Miles框架迁移至该平台:SGLang负责推理,Miles负责强化学习训练。针对Kimi K3 NVFP4模型,我们对注意力、MoE通信及KDA核函数进行了专项优化。
推理优化:服务Kimi K3 NVFP4
Kimi K3是一款2.8T参数的混合模型,采用93层注意力(69层KDA线性注意力+24层MLA)与896专家的LatentMoE结构。我们使用RadixArk的DSpark块投机解码进行服务。
注意力优化
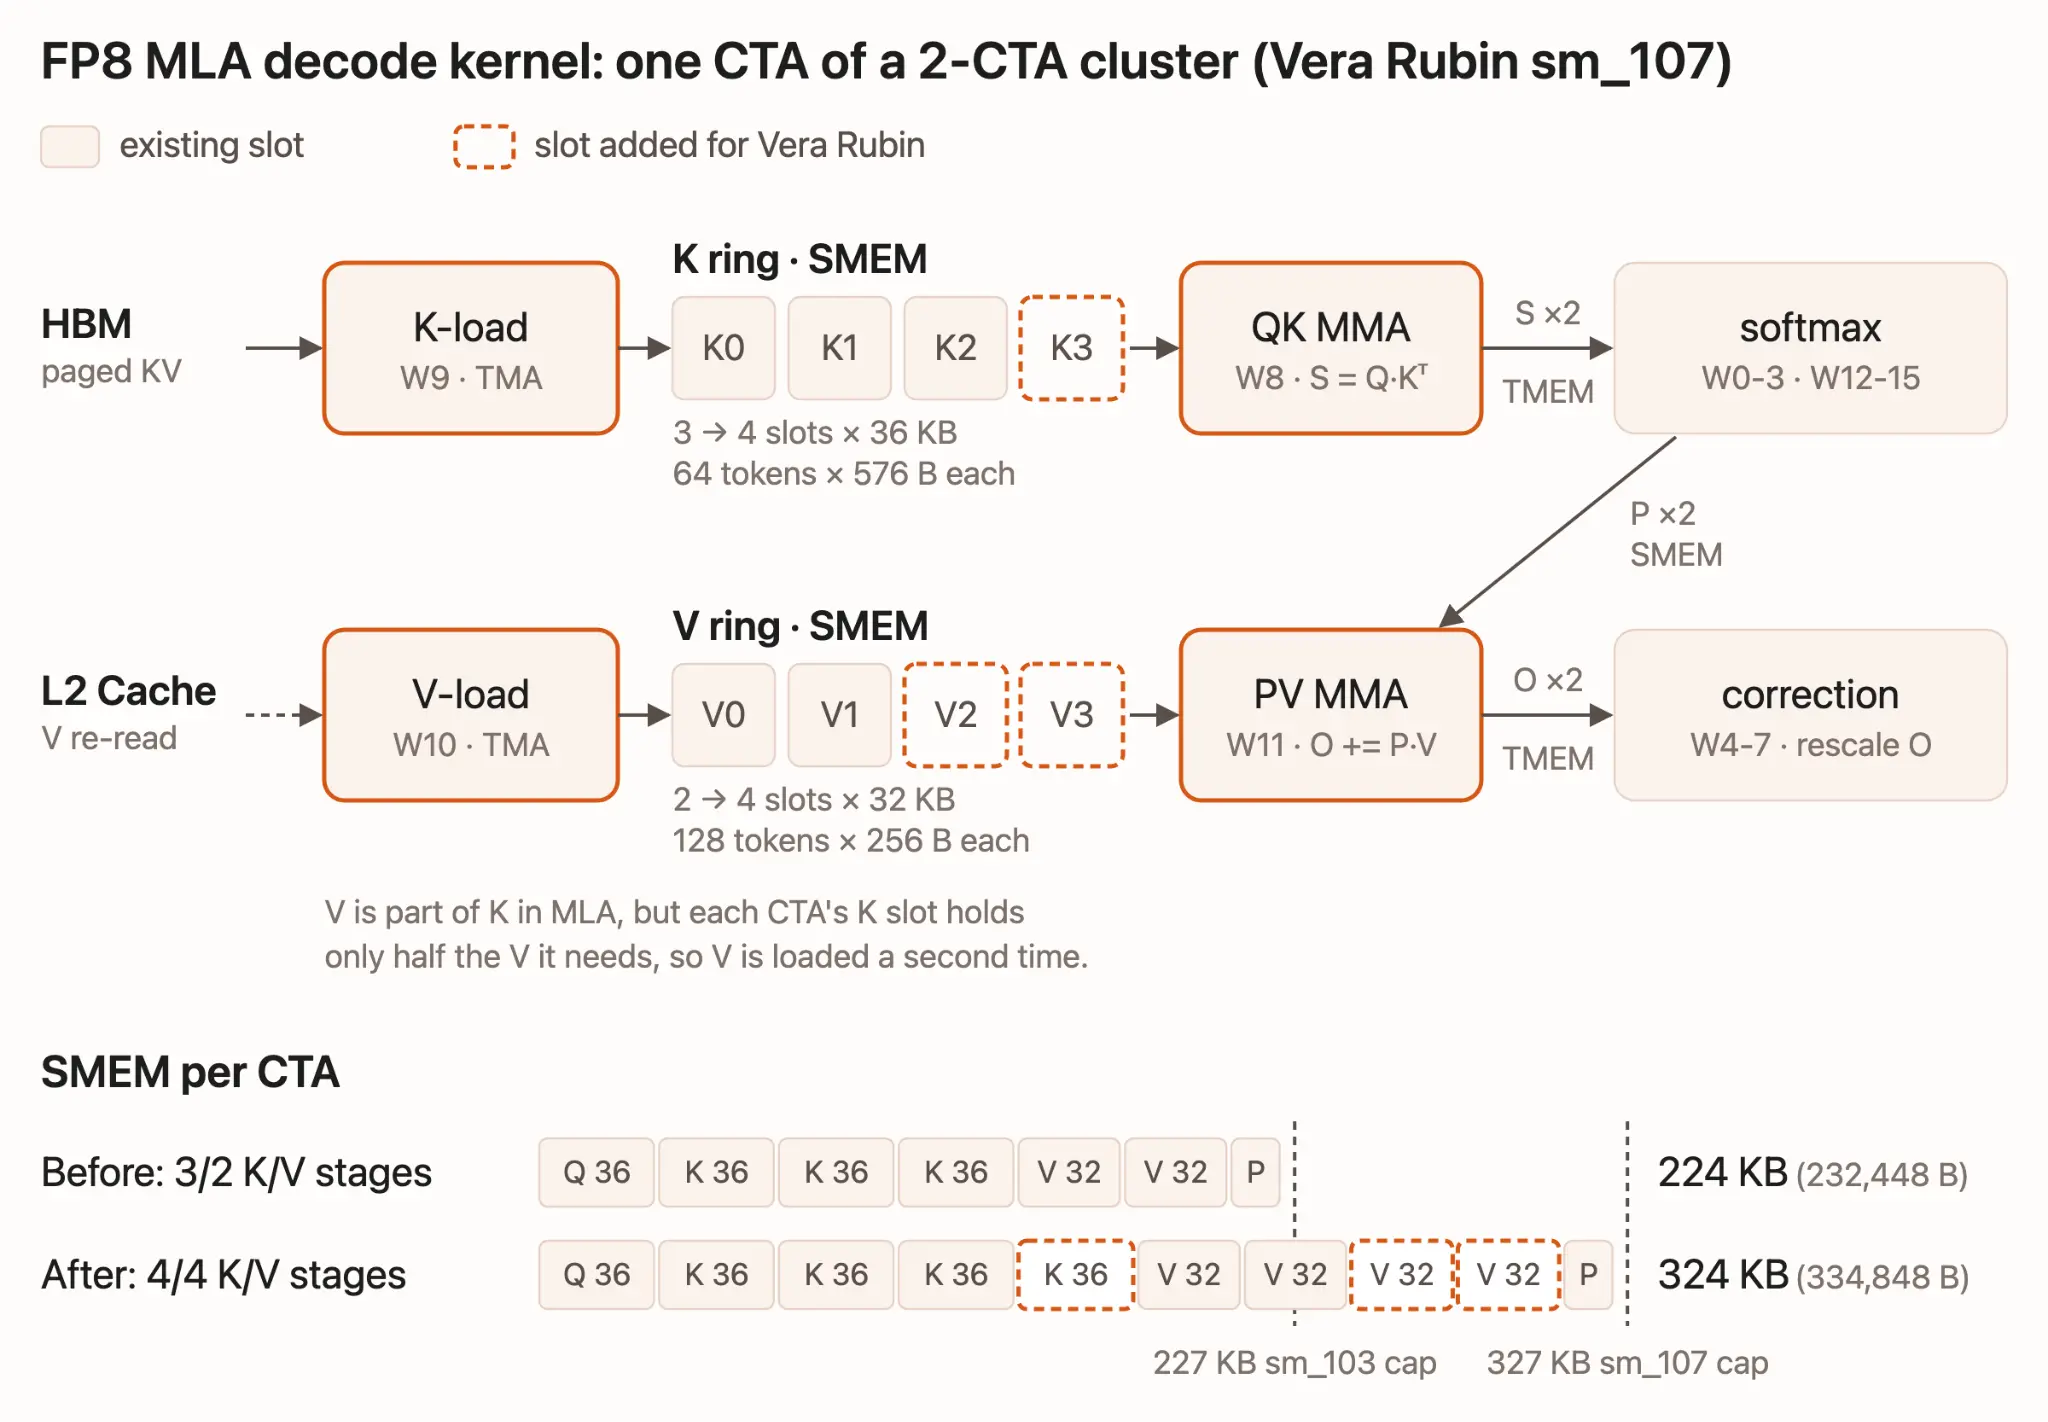
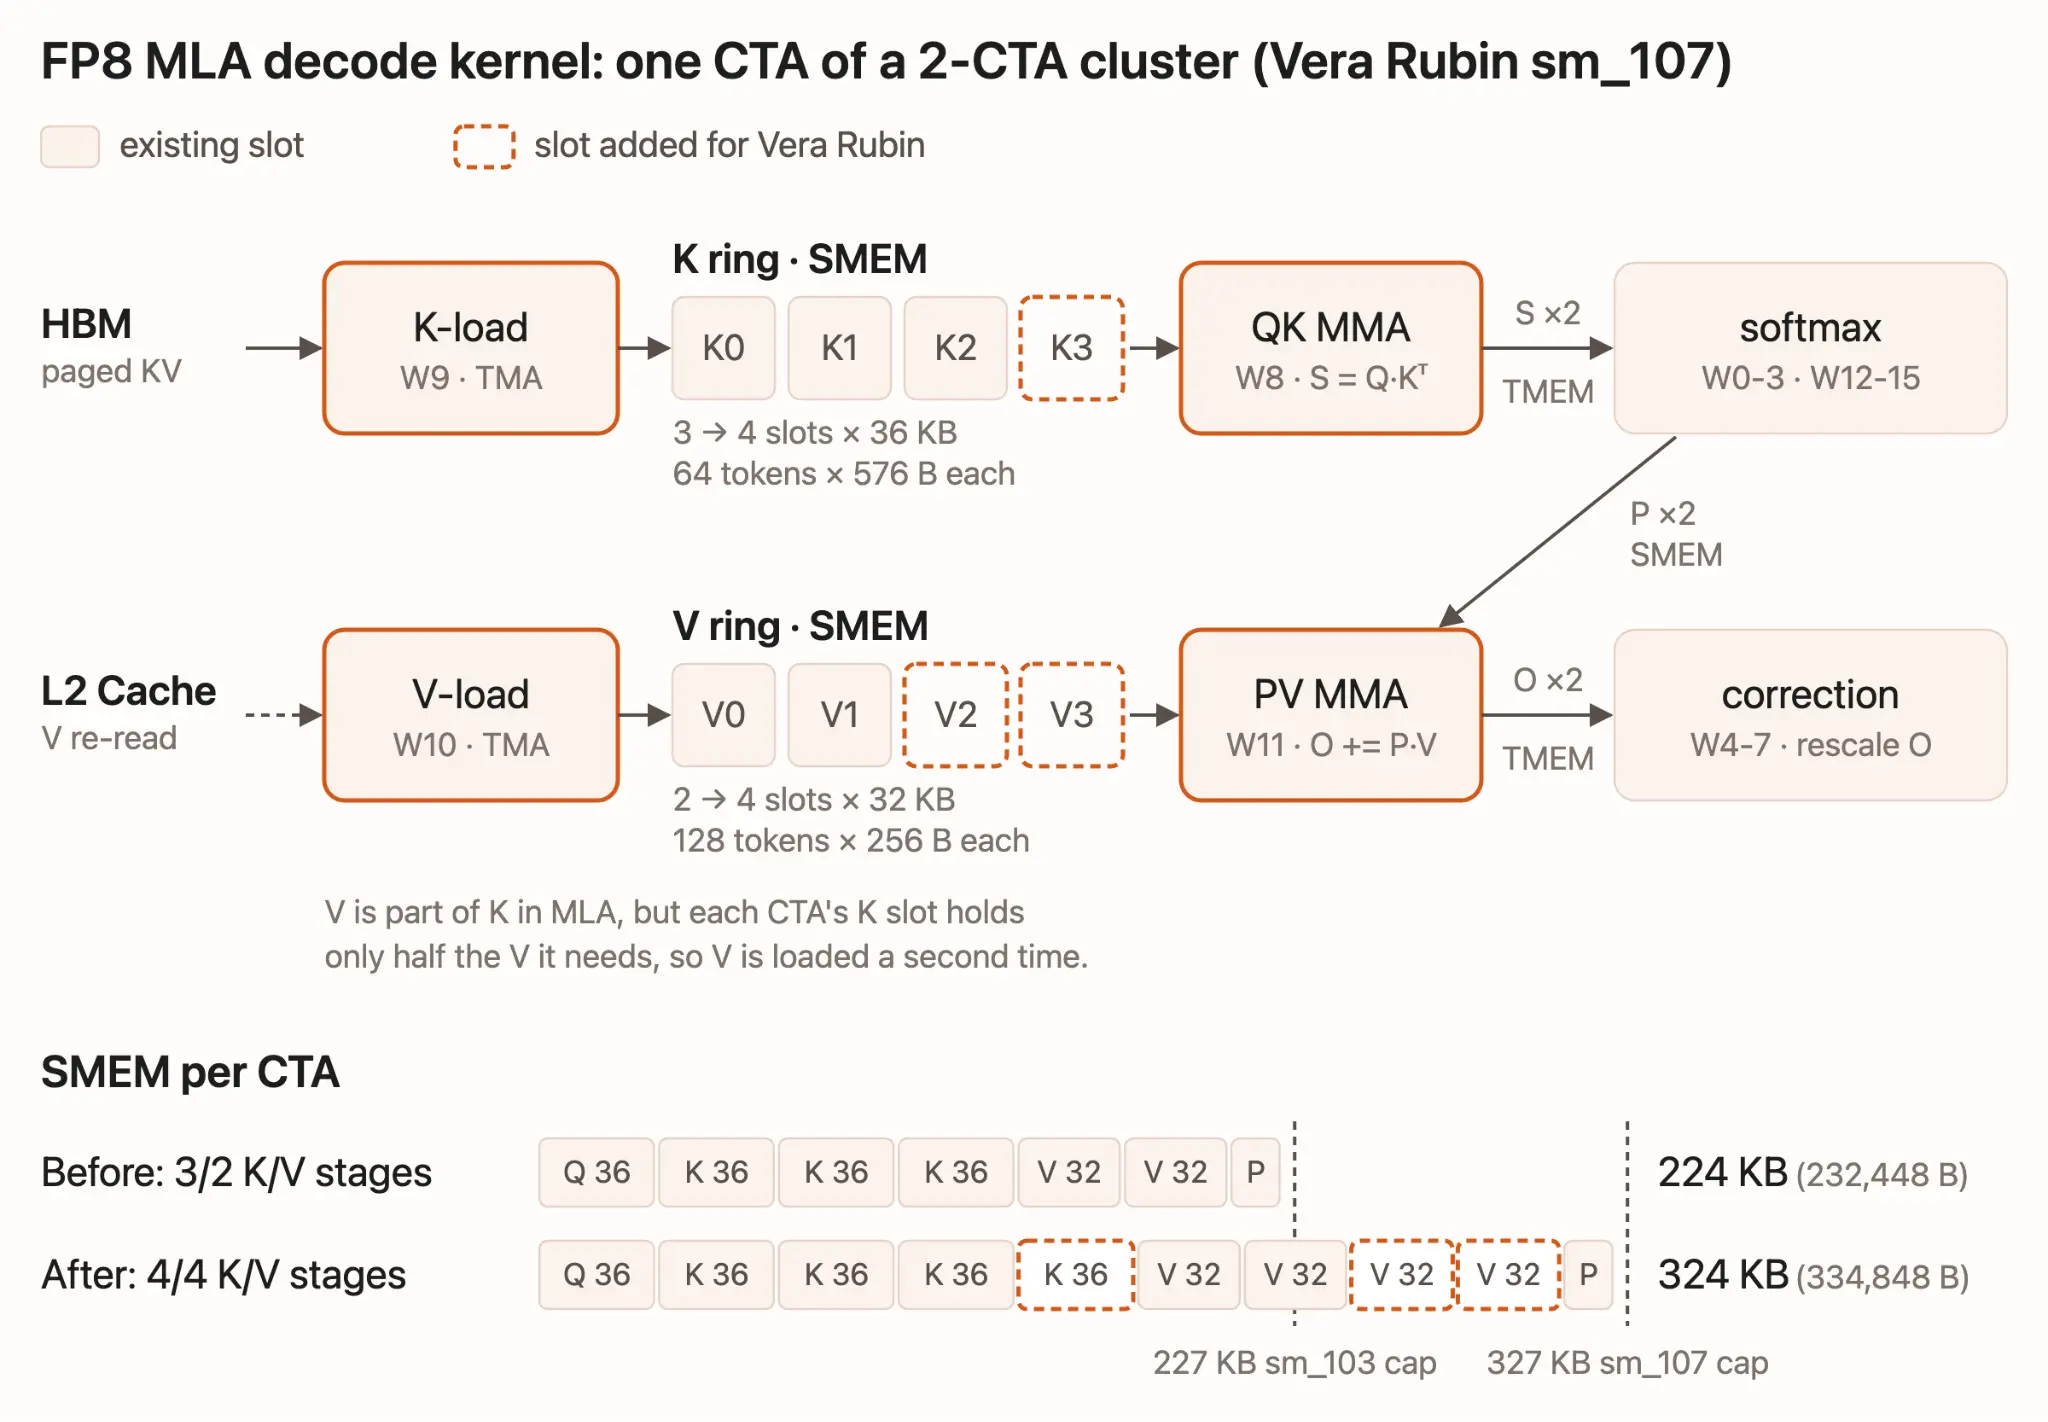
通过利用Vera Rubin每CTA 327 KiB共享内存,我们将MLA流水线从3K+2V阶段扩展为4K+4V阶段,在batch 16、128k上下文下实现16%加速。
此外,我们优化了split-KV归约、64-way分裂以及原生FP8转换,将低并发场景下的FP8 MLA性能提升20%。
MoE与通信核函数
融合MoE尾部操作,将finalize、all-reduce与RMSNorm合并为单一集体核函数,消除276次启动开销,端到端提升5.9%。同时调整push all-reduce阈值至256行,并将潜在all-gather GEMM迁移至tensor core。
KDA优化
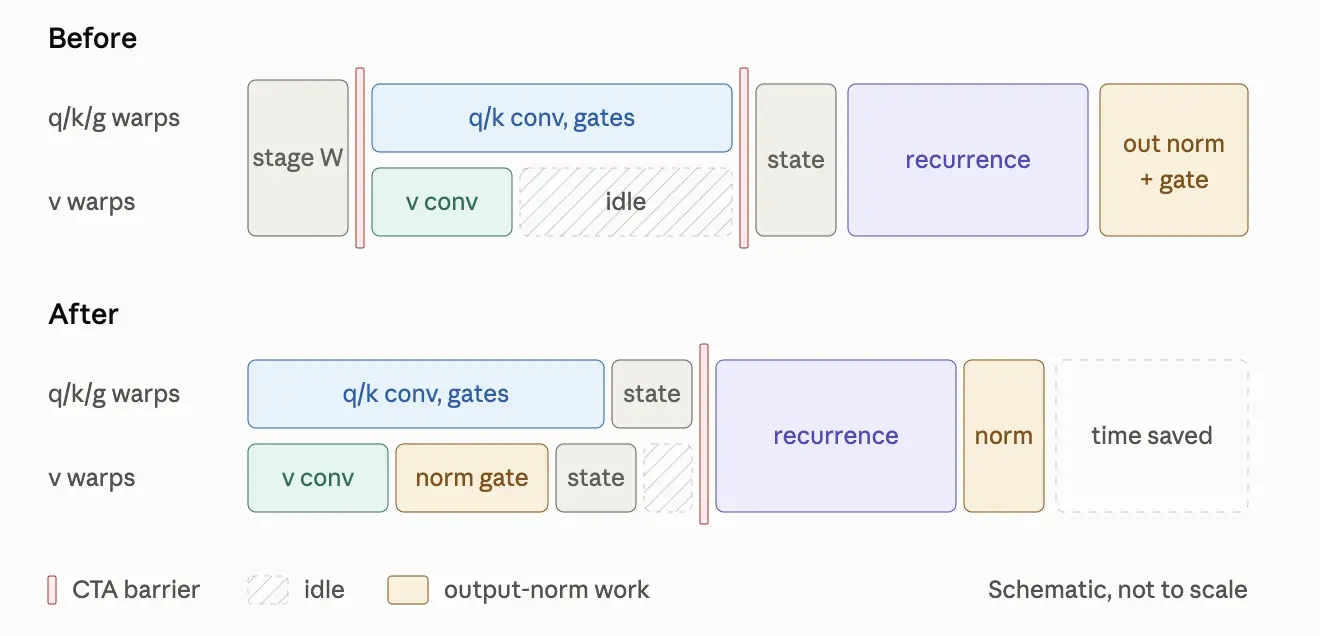
重构KDA verify核函数,将conv权重保留在寄存器中,消除CTA屏障,生产核函数加速20%。
通过支持strided gate读取,避免PyTorch隐式拷贝,单步解码时间再降1.8%。
强化学习训练:Miles在Vera Rubin上运行
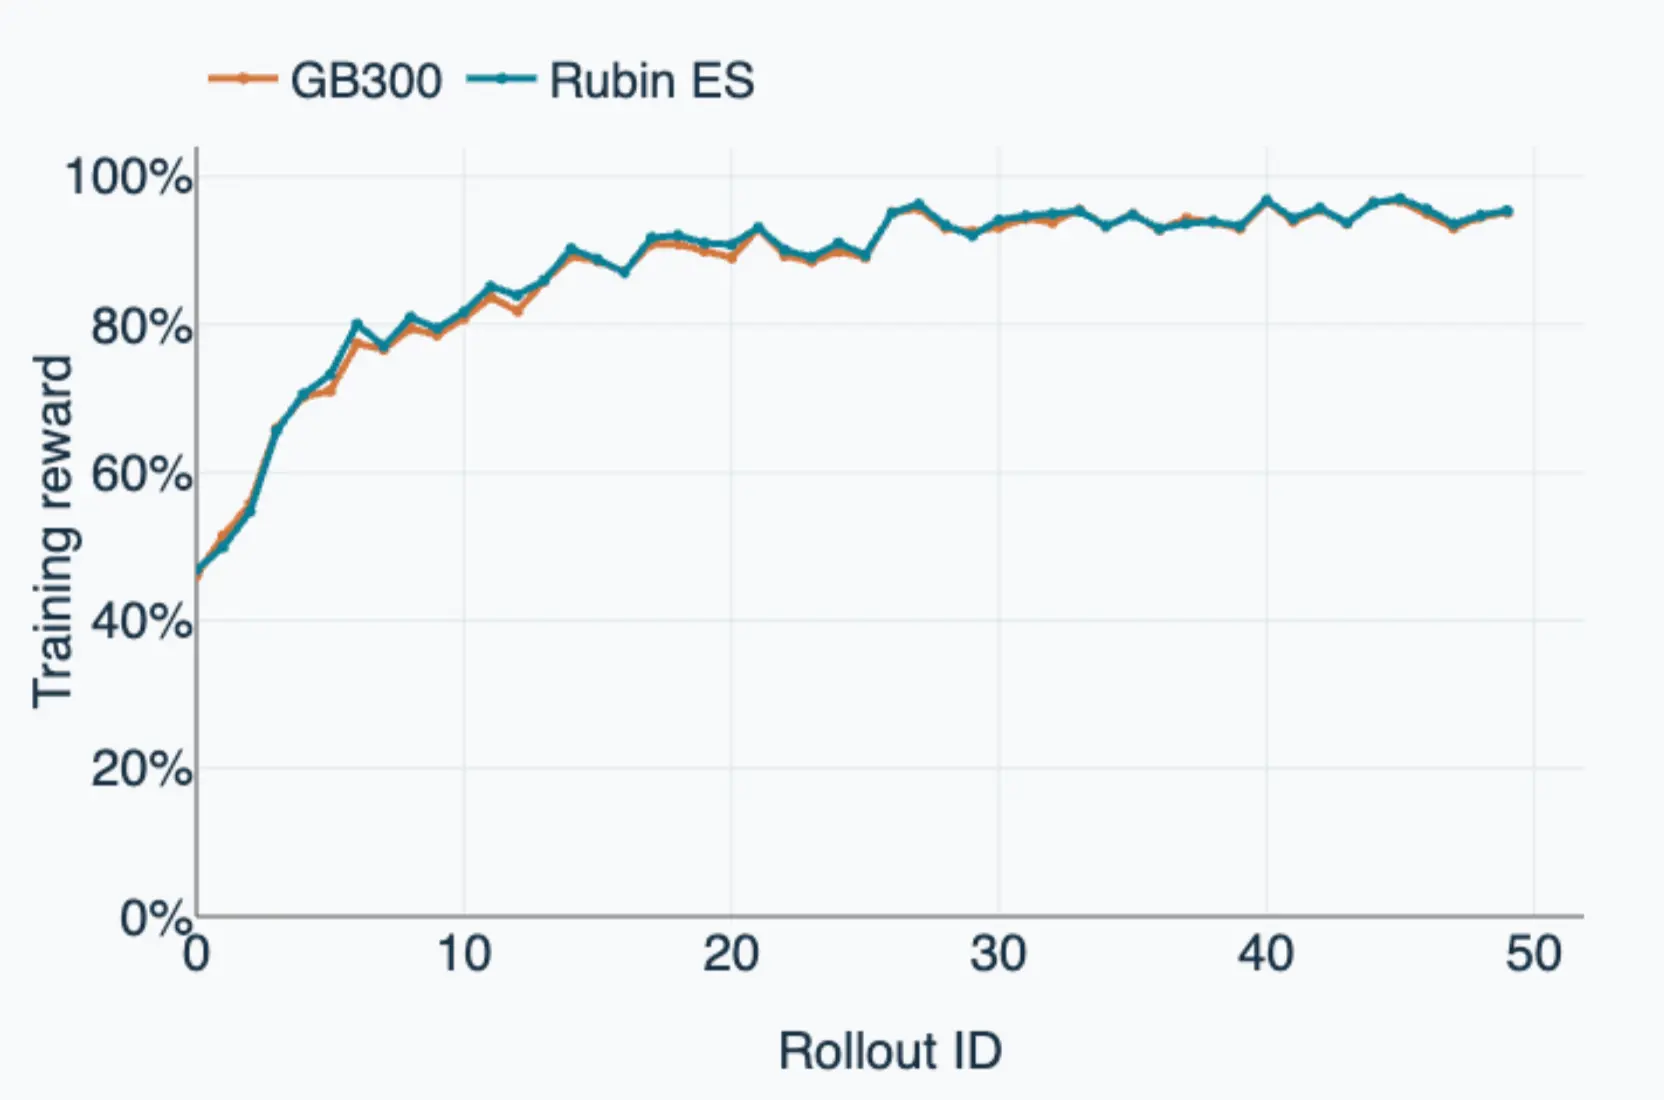
Miles框架使用SGLang进行rollout、Megatron进行训练,单容器镜像即可在Vera Rubin上端到端运行RL任务。Qwen3-30B-A3B在GSM8K上的奖励从45%升至95%,与GB300曲线完全吻合。
DeepSeek-V4-Flash FP8路径也已打通。
基于Vera CPU的Agentic RL
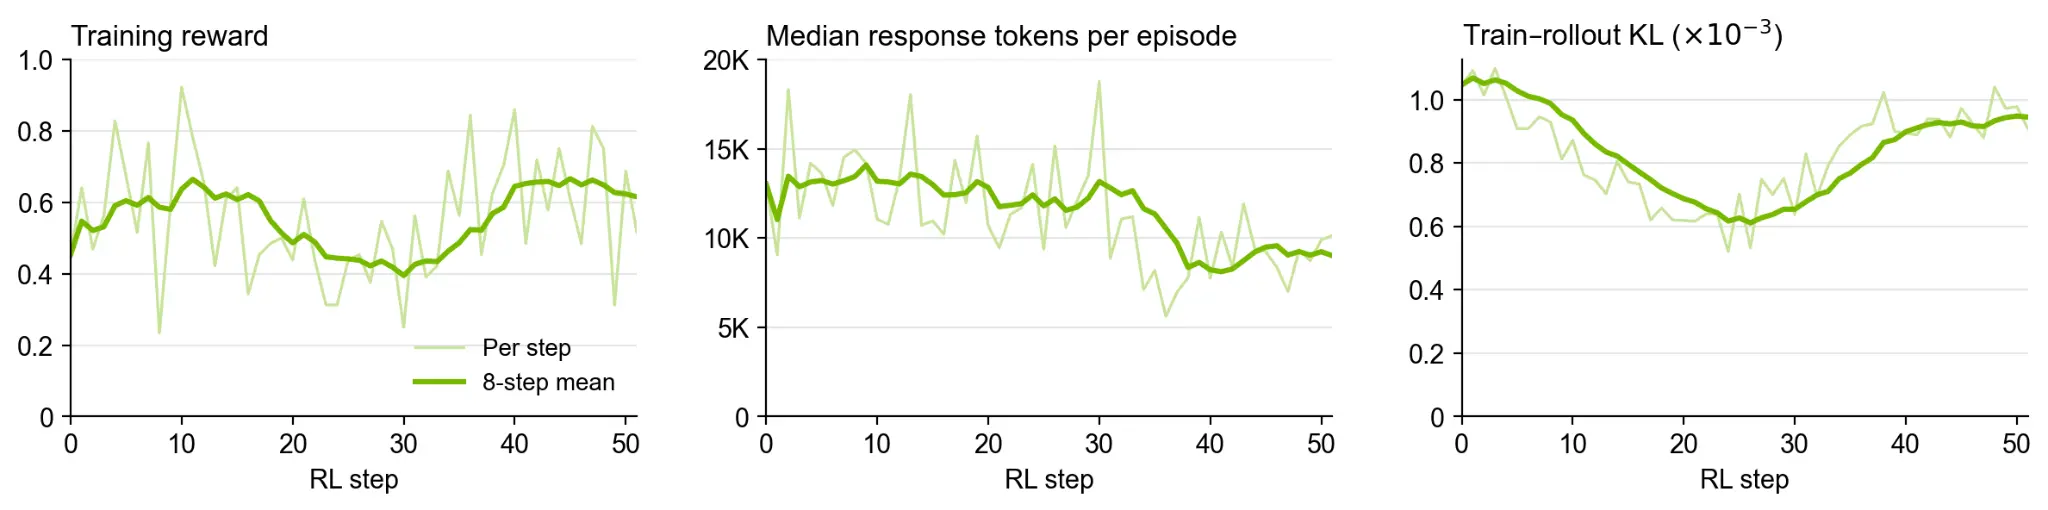
我们利用NeMo Gym在Vera CPU上运行mini-SWE-agent环境,64个sandbox并发,SWE-bench Verified任务奖励稳定在0.6左右,响应长度缩短30%。
后续展望
团队将继续扩展推理优化并提升大规模Agentic RL并发环境支持。
© 2026 Winzheng.com 赢政天下 | 转载请注明来源并附原文链接