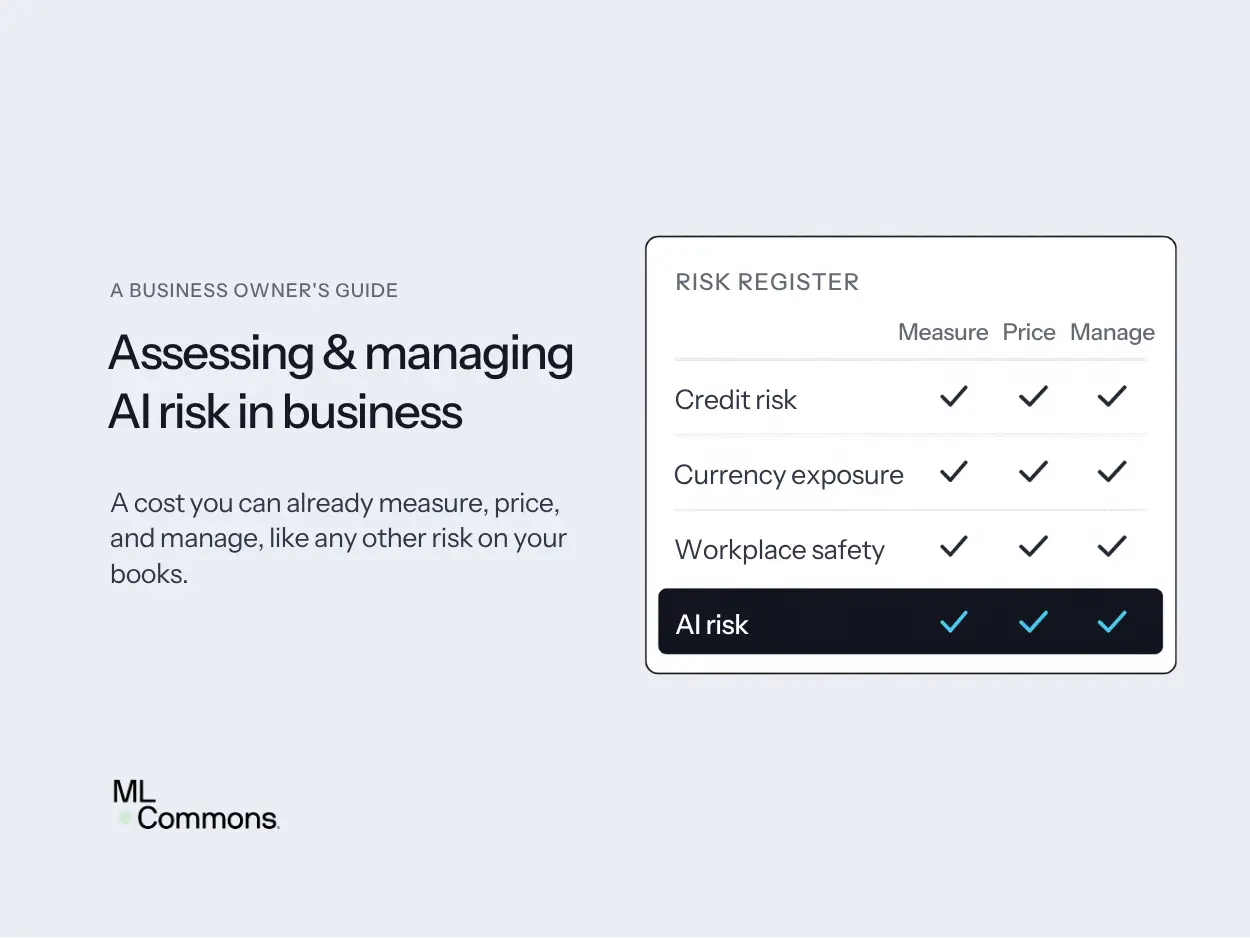
负责AI风险的团队正被夹在两种目标之间:一方面要保护企业免受损害,另一方面又要支持AI更快、更广泛地落地,而且资源往往没有增加。MLCommons认为,AI governance的价值正在于此:把风险管理与业务优先级、公司价值观和可审计的证据连接起来。
AI风险本来就在企业账本上
成熟组织早已拥有风险管理闭环:识别风险敞口、估算预期损失、按风险水平配置控制措施,并向有责任的管理层报告剩余风险。保险公司为风险定价,审计机构进行测试,董事会最终签字确认。
企业对安全事故的代价并不陌生,而AI正在放大这些成本。IBM 2025年Cost of a Data Breach报告显示,全球数据泄露平均成本为444万美元,美国则达到创纪录的1022万美元。同一研究还发现,AI采用速度已经超过AI监督能力:在发生泄露的组织中,63%没有AI governance政策,或仍在制定中;大量使用“shadow AI”的组织,数据泄露成本平均还会增加约67万美元。
监管层面的后果同样不可忽视。即便是在生成式AI出现之前,GDPR和CCPA等制度已经对AI可能涉及的自动化决策提出严格要求。EU AI Act的处罚更具震慑力,最高可达3500万欧元或全球营业额的7%,这让主动管理AI风险成为企业无法回避的议题。
好消息是,管理已部署AI系统的风险并不需要一套全新的哲学。企业只需要像对待其他运营风险一样,要求足够可靠的证据,并采用适合AI场景的新测量工具。
航空业的启示:可测量,才可被信任
有效管理新风险的回报,不只是避免损失,还能塑造整个行业的健康发展。1959年,美国商业航空每百万次起飞约发生40起致命事故;不到十年,这一数字降至2起以下,此后半个世纪里大致每十年继续减半。航空变得安全,是因为行业建立了持续迭代的风险管理机器。
测量让飞行变得足够安全,足以赢得信任,也足以被大规模承保。如今每年数十亿乘客,以及支撑超过3万架商用飞机的贷款方和保险方,都把飞行视为一种常规活动。
“自己给自己打分”的时代正在结束
AI风险管理离不开可信测量。要建立信任,组织需要采用独立、透明的评估机制。制药公司不会自行裁定自己的临床试验结果,上市公司也不会自行审计财务报表。
但在AI市场中,供应商仍然经常自设benchmark、自行运行测试并发布结果。一个AI代码审查案例显示,某供应商自测称其bug捕获率达到82%;竞争对手在相同代码库上复测后得到45%;而当一个无利益相关的实验室建立独立benchmark时,没有任何供应商超过63%。产品没有变化,变化的是谁在裁判。
AILuminate:让供应商不再自出考卷
MLCommons推出的AILuminate®正是为弥补这一缺口而设计。该项目于2024年12月发布,是一组独立、由共识机制治理的benchmark,用来评估AI系统在避免有害回答方面的可靠性。
AILuminate由来自AI公司、学术界和民间社会的工作组共同建设,并通过私有测试集和独立评估者保护测试完整性。换句话说,供应商不能自己出题,不能提前看到题目,也不能掌握评分权。
治理团队可以如何使用这些分数?
- 识别风险集中点:按危害类别给出的模型评分,可以显示类似用例中的风险敞口集中在哪里,为risk register提供基础材料。
- 指导控制措施:如果系统在对抗性压力下评分显著下滑,这就不是一句笼统的“要谨慎”,而是有证据支撑的指令:需要在系统层构建guardrails。
- 测试真实部署配置:采购方应使用与供应商相同的测试方法,评估自己实际部署的配置。基础模型的分数类似汽车出厂油耗标签,它说明的是交付状态,而不是你在通勤路线上真实得到的油耗。
部署前后的评分都应进入risk register:可量化、可比较、可审计。这些分数不仅是给外部看的证据,也能作为企业持续改进、发现回归问题的反馈机制。
AI assurance链条的方向已经很清楚。2025年末,主要保险公司曾要求美国监管机构允许其将AI相关责任排除在企业保单之外。这并不是因为AI风险不可管理,而是因为缺少测量方法;无法测量的风险,也就难以承保。
必须测试你真正部署的系统
基础模型的评分只能证明模型从开发者手中交付时的表现,却无法说明它在企业环境中的真实运行状态。多数组织并不会直接部署裸模型,而是把模型接入prompt、内部数据、工具调用,有时还会让其以agent形式工作。正是这些“harnessing”让模型变得有用,但也会让供应商内置的安全措施变得脆弱。
这种保证机制的演进,可以从Agent Reliability Profile等工作中看到。该项目来自MLCommons金融服务工作组,并入围了今年的CDIR hackathon决赛。它是一种面向单个agent的证明性文件,记录一个有边界、可证伪的声明:某个系统能在特定autonomy tier、特定operational design domain和特定control envelope内可靠运行。
这不是对agent是否“值得信任”的模糊感觉,而是审计机构或保险公司可以核查的具体主张。
像管理其他风险一样管理AI风险
MLCommons的核心观点是:AI风险可以被识别、定价、按比例管理并报告,就像企业数十年来管理信用风险、汇率敞口和工作场所安全一样。这样做不是AI采用的刹车,而是负责任获取AI收益的前提。
AI风险已经在企业账本上。真正的问题是,企业是否愿意开始测量它。
MLCommons表示,AILuminate旨在帮助组织解决这一问题,并支持团队衡量AI风险。本文概述自更长的白皮书How to Think About AI Risk: A business owner’s guide to a cost you can already measure, price, and manage。
延伸阅读
- McKinsey,The State of AI(2025)与The AI reckoning: How boards can evolve(2026)
- PwC,2026 Annual Corporate Directors Survey
- IBM,Cost of a Data Breach(2025)
- Center for Democracy & Technology,Getting Third-Party AI Assessment Right(2026)
- NIST,AI Risk Management Framework
- MLCommons,AILuminate v1.1 and Jailbreak Benchmark v1.0,arXiv:2610.02827(2026年6月)
© 2026 Winzheng.com 赢政天下 | 转载请注明来源并附原文链接