Uber 发布博文,详细介绍其全新的 ServiceScale 控制器,该控制器允许多个编排器安全地管理同一组 Kubernetes 工作负载的扩缩容。这篇由高级软件工程师 Egor Grishechko 和 Srikar Paruchuru 撰写的博文描述了 Uber 如何将扩缩容意图与执行分离,在无需预留闲置容量的情况下支持区域故障转移。
Uber 的容器平台团队管理着分布在数据中心和云厂商(包括 Oracle 和谷歌)的 100 多个计算集群,运行着约 4000 个服务,使用 300 万核 CPU,每天启动 150 万个 Pod。该团队的内部平台叫作 Up,作为 Kubernetes 集群群联邦层。服务所有者使用 Up 部署构建版本并设置扩缩容预期,而一个专门的控制器——Uber 部署控制器(UDC)——会将这些意图调和为 Kubernetes 原语。InfoQ 此前曾报道过 Uber 向 Up 的迁移以及随后完成的 Kubernetes 迁移。
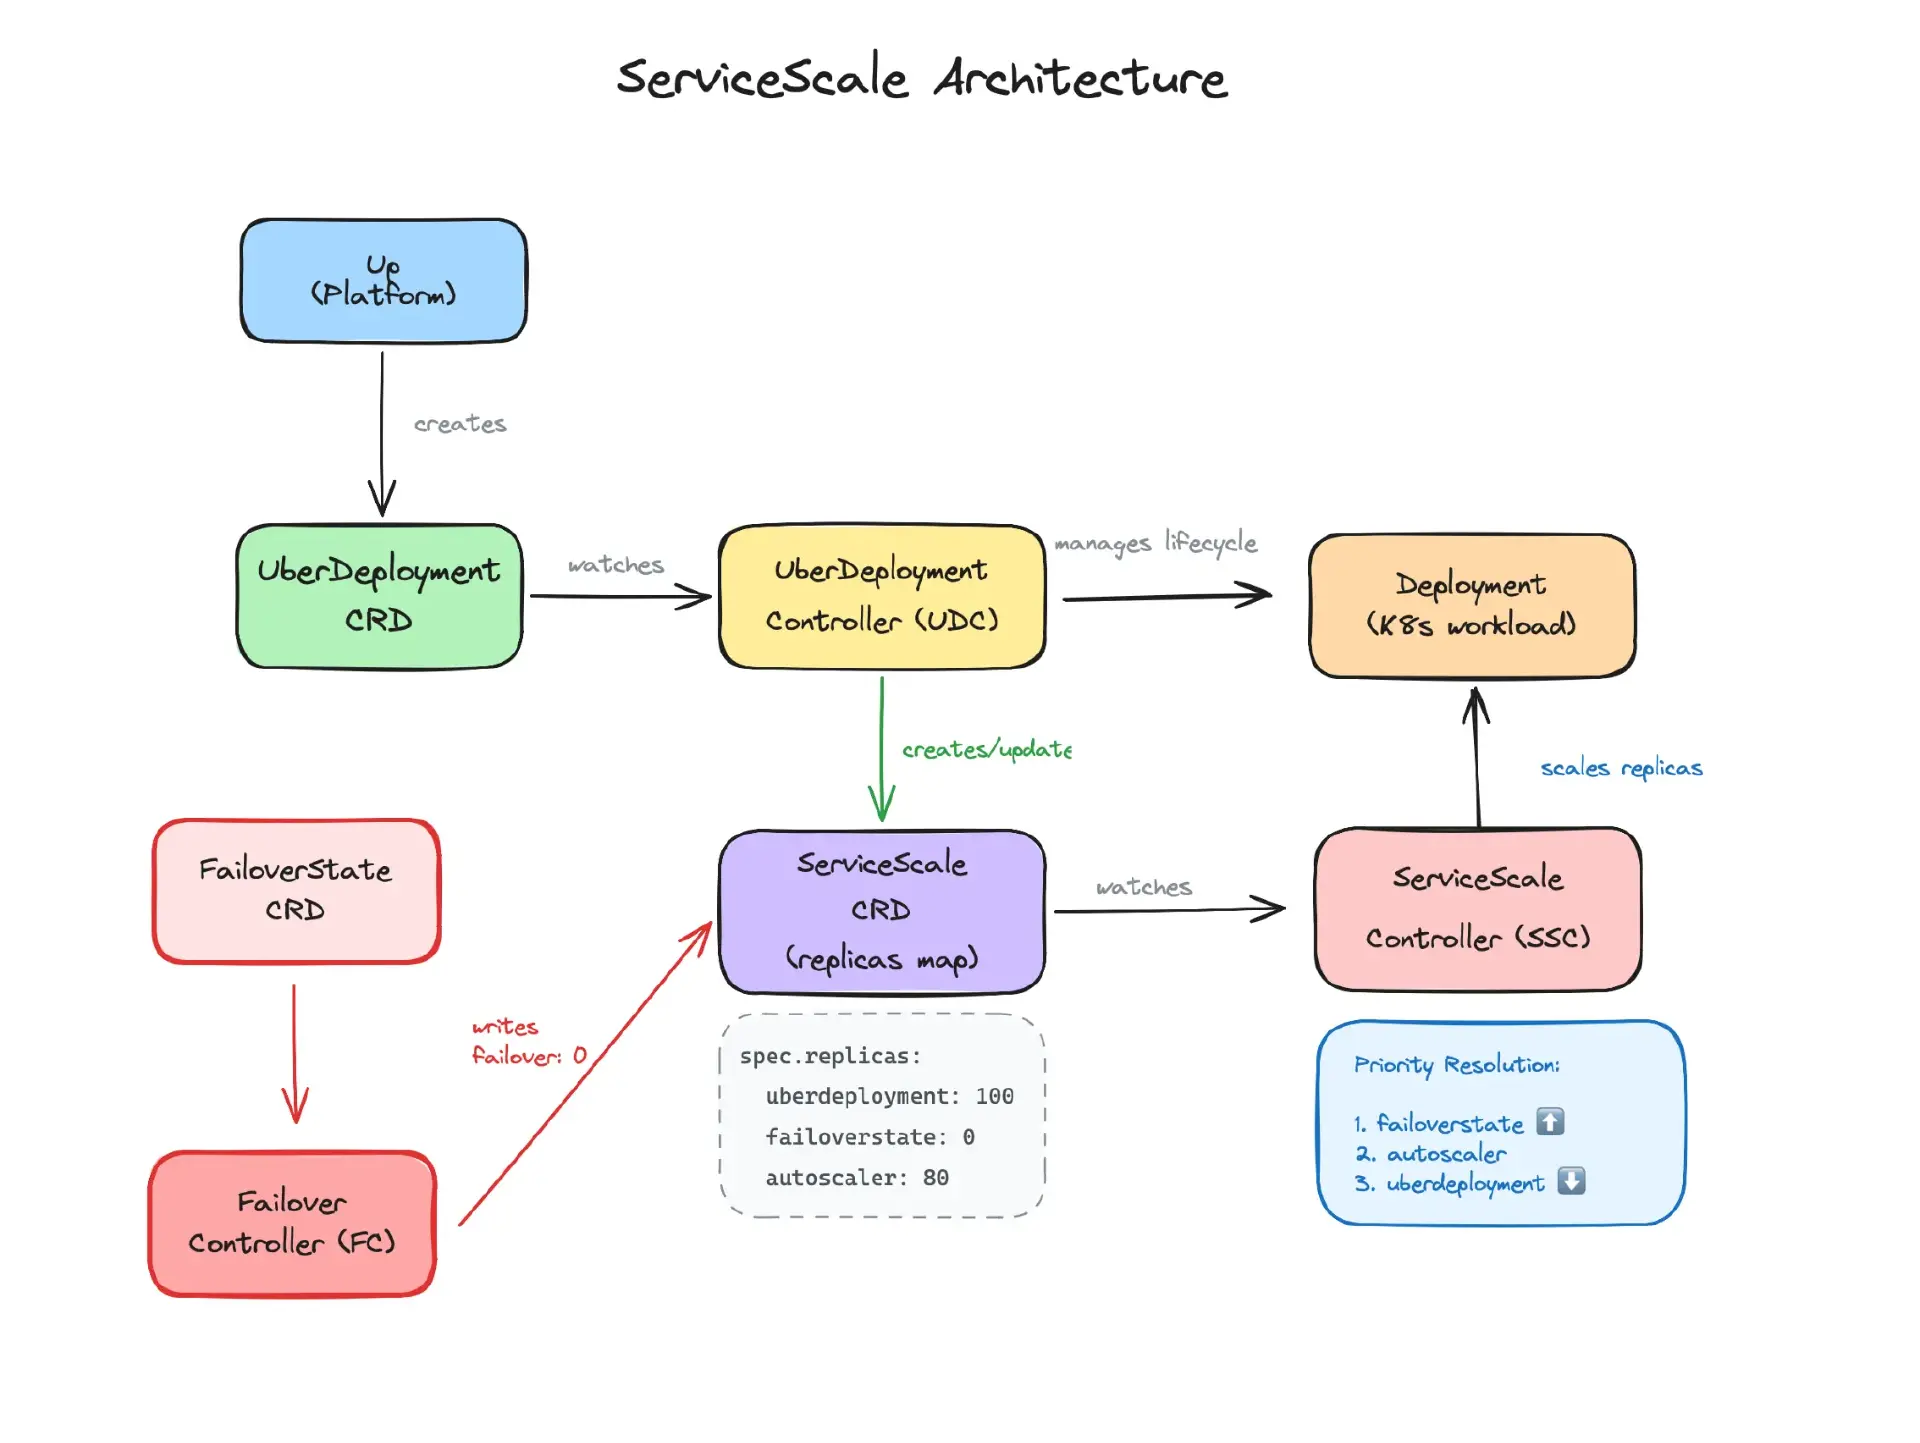
这一改变的动机来自 Uber 处理区域故障转移方式的变革。Uber 在不同区域运行双活数据中心。当发生故障时,流量会被重定向到幸存区域,该区域需要足够的空闲计算资源来应对增加的负载。过去,Uber 在所有数据中心都保留了预留的空闲容量。工程师们希望改为复用低优先级工作负载的容量,故障发生时缩容低优先级工作负载,扩容高优先级工作负载。
这就产生了新的扩缩容意图来源。Up 和 UDC 仍负责维护服务常规期望状态,但故障转移编排器也需要参与扩缩容决策。工程师们考虑过用故障转移逻辑扩展 UDC,但最终决定不这么做。UDC 已经处于服务生命周期操作的关键路径上,添加故障转移特定行为会增加这个控制器的复杂性。Grishechko 和 Paruchuru 指出,“故障转移处理一旦出现回归问题,不会只停留在故障转移层面”,而可能影响整个集群的正常部署。
相反,团队引入了一个新的自定义资源定义 ServiceScale 和新的服务扩缩容控制器(SSC)。每个编排器都可以通过 ServiceScale 表达自己的扩缩容意愿,SSC 将组合后的意图调和为 Kubernetes 对象。Grishechko 和 Paruchuru 解释说,他们可以保持模型的简洁。
“我们不想额外引入外部数据库、独立协调服务或是控制平面,否则在故障应急场景下,调试难度会大幅上升。”
扩缩容意图直接物化在 Kubernetes 中,让系统更便于排查。当出现问题时,工程师可以查看 ServiceScale,看哪个编排器想要什么。故障恢复也变得简单,因为稳态和临时故障转移信息都保存在 CRD 规范中,这意味着在恢复时不需要从日志中重建状态。
博文分享了三条生产环境实践经验。第一个问题是过期的 Informer 缓存。和大多数 Kubernetes 控制器一样,Uber 的控制器依赖 Informer 缓存读取资源,缓存数据会比真实状态延迟数秒。Up 将状态字段作为最终判断依据:UDC 返回成功信号后就会触发工作流中不可回退的下一步操作。工程师们实现了“读己所写”一致性防护机制:控制器更新下游资源时,会把当前资源版本号作为注解打上,在上报状态前,先校验本地缓存至少已经读到该版本。
这个问题并非 Uber 独有。2026 年 4 月份发布的 Kubernetes v1.36 引入了控制器缓存过期问题缓解方案,采用了类似的方法。如果缓存的最新资源版本低于控制器已写入的版本,控制器就不会执行操作。Kubernetes 项目还在与 controller-runtime 合作,让基于该框架开发的所有控制器都支持“读己所写”语义。
软件工程师 Prasad M K 在 LinkedIn 上撰文,将“读己所写”缺失问题描述为“API 契约问题,而非后端缓存问题”,并建议使用版本令牌来校验读写一致性。他是从应用层面分析问题,而 Uber 的方案是在 Kubernetes 控制器范式内解决。
多写入者系统是另一个挑战。当 UDC 和 SSC 同时更新同一个 Kubernetes 资源时,特定的时序条件会导致 ReplicaSet 变得不一致。其元数据与规范产生漂移,这破坏了滚动更新的比例扩缩容,有时会导致工作负载卡住。工程师们在 UDC 中加入了全集群可观测能力,用来检测元数据与规范不一致,构建了自动修复程序来修补受影响的 ReplicaSet,并在扩缩容路径中推进长期修复方案。一篇关于 Uber 故障转移架构的学术论文于 2026 年 1 月发表在 arXiv 上,论文提到,更广泛的统一故障转移架构将稳态配置从 2 倍降低到 1.3 倍,节省超过 100 万 CPU 核。
整个方案上线耗时一年。工程师使用了预发布环境和金丝雀发布,并基于 KubeKind 测试工具搭建集成测试,模拟控制器交互,捕获竞态条件。该方案支持原生 Kubernetes Deployment 和 OpenKruise CloneSet,并在整个过程中没有造成客户可感知的中断。InfoQ 还报道过 Uber 的持续部署优化方案,同样强调渐进、安全发布的思路。
“多编排器系统的难点不在于 API,而在于多次写入之间发生的各类并发问题。”
Uber 的实践凸显了生产中多编排器 Kubernetes 引入的分布式系统问题。CNCF 最近将 Karmada 项目正式毕业,这是一个多集群编排项目,采用不一样的架构解决跨集群故障转移问题。Kubernetes v1.36 中引入的缓存过期缓解机制也说明这类问题已经在平台层面获得重视。
查看英文原文:https://www.infoq.com/news/2026/09/uber-kubernetes-scaling/