
数学家可能真的遇到难题了:AI 产出新数学的速度,开始超过数学界理解数学的速度。
几天前,OpenAI 突然在 GitHub 上公开了一批由内部未发布前沿模型生成的数学研究成果,数量达到惊人的 722 篇。其中涉及数论、代数几何、分析、组合数学等多个方向,一些成果还配有 Lean 形式化证明。
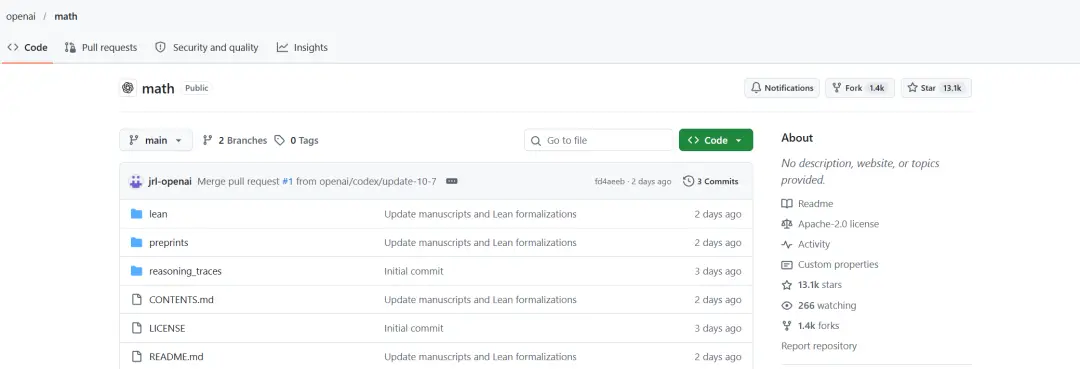
仓库地址:https://github.com/openai/math
几天过去,数学界真正的麻烦出现了。
《The Verge》采访了 30 多位数学家。面对这场成果洪流,他们用「令人震惊、压得人喘不过气、前所未有、恍如梦境、简直疯狂」等来形容 OpenAI 带来的这场冲击。
尽管每个人的反应不同,研究人员普遍认同一点:仅仅理解 OpenAI 这次发布的内容,可能就需要数年时间,AI 产出新数学的速度,开始超过数学界理解、验证和吸收数学的速度。
更麻烦的是,OpenAI 或许不会等数学界慢慢消化完这些成果,就会继续向前推进,甚至发布更多新的结果。
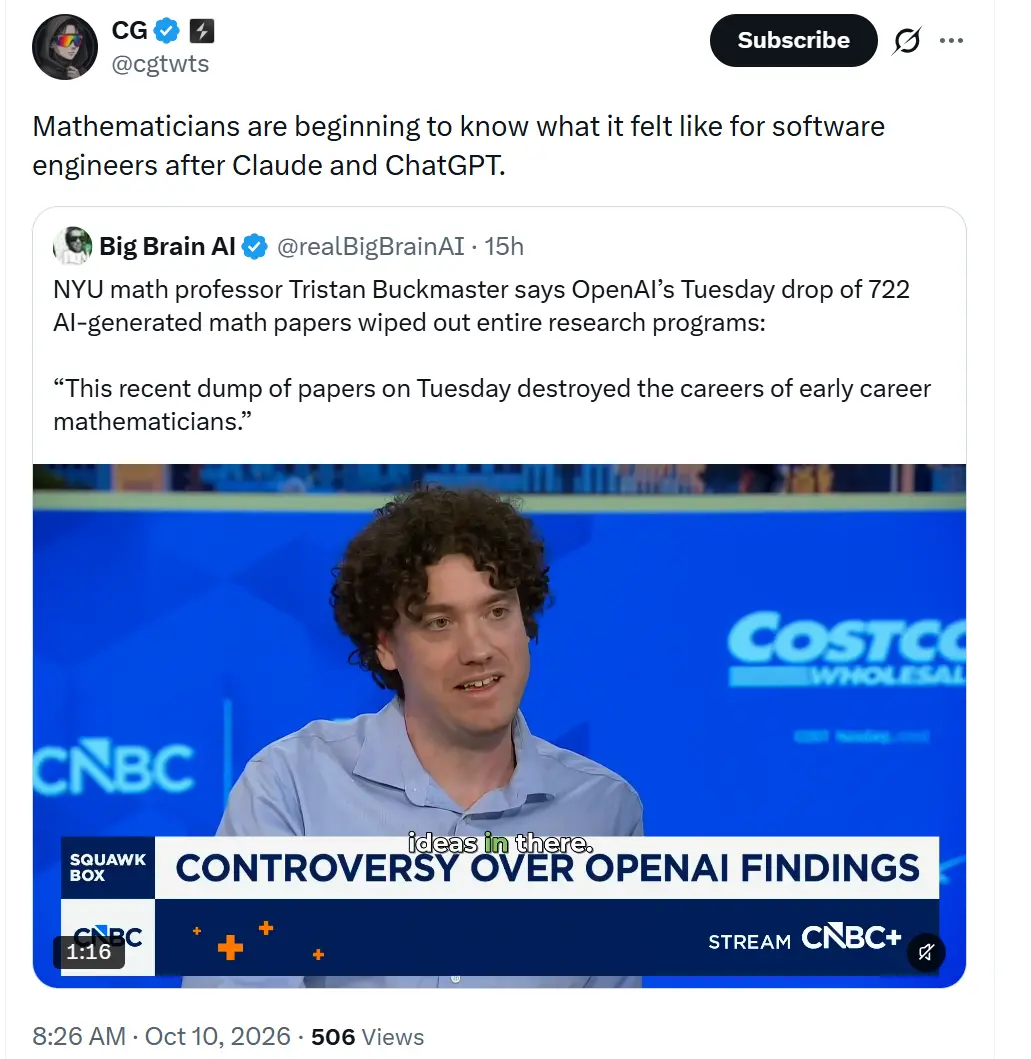
纽约大学数学教授 Tristan Buckmaster 在接受采访时表示,OpenAI 一次性发布 722 篇手稿,已经摧毁了一些职业早期数学家的研究路径,甚至让一些完整的研究项目失去继续推进的意义。
成果爆发之后,验证成了新的瓶颈
如此庞大的成果数量,使得外界甚至很难对 OpenAI 到底发布了什么做出初步判断。
在这些成果公布后的数小时乃至数天里,《The Verge》采访的大多数数学家都表示,他们仍在努力消化全部内容。几位研究者称,光是看完那份大约 40 页的目录和摘要,就花了将近一个小时。
康涅狄格大学数学教授 Álvaro Lozano-Robledo 表示:仅仅浏览完整的摘要列表,就已经让人感到不堪重负。
在这数百篇手稿中,还穿插着一些使用 Lean 编写的形式化证明。
但这些成果的验证程度差异非常大。
OpenAI 在 GitHub 上承认,这些结果目前处于不同的验证阶段,而且许多手稿已经完成形式化,但并非全部。截至发稿时,这批手稿中完成形式化验证的比例还不到一半。
OpenAI 表示,在 700 多篇手稿中,只有 300 项核心结果完成了形式化验证,约占 42%。公司称,随着获得更多形式化证明,会继续更新这一仓库。
多位数学家向《The Verge》抱怨形式化验证覆盖不足,尤其是在成果数量如此庞大的情况下。他们强调,即便某项结果附带了 Lean 代码,评估也不意味着可以立刻完成。
研究人员还需要进一步检查:这份形式化证明究竟证明了论文声称的那个结论,还是只证明了一个与之相关、但并不完全等价的命题。
这同样是一个耗时的过程。
一些正在逐篇检查论文的研究者表示,即便已经提供了可由计算机验证的证明,质量也并不一致;有时 Lean 所验证的命题,与论文正文中声称的结论之间,并不能完全清晰地对应起来。
伦敦帝国理工学院数学教授 Kevin Buzzard 表示,他在自己研究的代数数论领域里发现了不少相关定理,但其中只有大约六个结果第一眼就特别突出。而这些结果中,几乎没有一个看起来已经在 Lean 中完成了正式验证。
Buzzard 说道:所以,要么我得去读这些可能并不正确的垃圾内容,要么等其他人先去读,要么就等有人把它们形式化之后,我才能确定这些结果到底是不是正确的。
不少其他研究人员也表达了类似的担忧。
这种担忧很快有了具体案例。研究者 Fan Nie 表示,他们使用自建验证系统 OSVerify 检查 OpenAI 10 月 4 日版本的《Global quantum geometric Langlands at irrational level》时,发现了两个重大问题,其中一个问题还由系统提出了修复方案。

来源:https://x.com/FanNie1208/status/2108458991567462432
这也进一步说明,OpenAI 批量产出前沿数学结果之后,验证本身正在变成另一项需要被规模化的工作。甚至开始出现一种颇具意味的新局面:AI 负责生成证明,另一套 AI 系统负责找错和修补。
OpenAI 的数学洪流,也夹杂着不少 slop
Buzzard 并不是唯一担心 AI slop 的人。
这里的 slop 通常用来形容那些质量低下、经常包含错误的 AI 生成内容。近年来,这类内容越来越频繁地出现在互联网上,甚至进入现实世界,其中也包括学术论文。
数学家告诉《The Verge》,近几年借助 ChatGPT、Claude 等工具生成的此类内容明显增加。很多材料逻辑混乱、难以阅读,也体现不出对相关领域的真正理解;在引用和归功其他研究者方面,问题尤其明显。
OpenAI 此前发布的一些数学研究文本,就曾因写作粗糙受到专家广泛批评,其中一个突出问题就是引用不足,甚至完全缺失归属说明。
因此,在这次大规模发布之前,一些研究人员私下已经把即将到来的论文洪流称作 slopocalypse,也就是 AI 垃圾内容末日之类的说法。
至于这次人们担心的 slopocalypse 是否真的发生,目前还很难判断,主要原因恰恰是 OpenAI 一次发布的材料实在太多。
早期迹象显示,OpenAI 这一次在论文质量上似乎更加谨慎,至少部分论文如此。多位数学家告诉《The Verge》,他们的第一印象比预期好得多。
不过,他们也承认,这个标准并不高,因为 OpenAI 此前发布的一些数学材料质量本来就比较糟糕。
而比以前更好,并不意味着已经足够好,更不意味着达到了通常情况下,这类重大数学主张所应满足的学术标准。
尤其是在 OpenAI 很多数学结论尚未完成形式化验证的情况下,配套论文的质量就变得格外重要。因为这些论文是数学家确认、理解、审查和定位相关成果的主要依据。
即便在最理想的情况下,写出一篇严谨的数学论文也不是一件容易的事。
而像 OpenAI 这样,以如此大的规模同时完成这些工作,更是一个极其艰巨的任务。
OpenAI 的模型正在以令人眼花缭乱的速度,在大量不同数学分支中不断产出新结果,其速度远远超过公司内部人类研究人员能够审查的能力。
问题在于,OpenAI 并没有足够广泛的专业知识储备和人力资源,去真正严格审查这些处在数学研究最前沿的成果。
接受《The Verge》采访的研究人员表示,这一点在论文中已经体现出来。
很多人形容其中一些论文很难理解,有时甚至几乎无法读懂。
布朗大学数学教授 Brendan Hassett 告诉《The Verge》:我最熟悉的那个问题,它的论文写法我快速读了一遍之后几乎看不懂。如果这是一个人写的,我不会再花时间试图理解它。当然,这还剩下另外 721 篇预印本!
Hassett 说这番话时,OpenAI 还没有撤回后来被撤下的三篇论文。
一些研究人员还告诉《The Verge》,他们或者同事注意到,部分论文看起来可能覆盖了其他数学家此前已经完成的工作。
不过,在真正仔细检查完这些材料之前,他们不愿公开下定论。
另一些研究者则注意到,这些论文异常简短。
有些结果如果按照传统数学论文的标准,本来可能需要数百页才能完整展开,但在 OpenAI 发布的材料中,却被压缩到了几十页甚至更短。
澳大利亚悉尼大学数学教授 Nalini Joshi 表示,她快速检索了这批论文之后,没有发现太多与自己研究直接重叠的内容。不过,她注意到,自己查看的一些论文参考文献非常短。
考虑到 OpenAI 此前在成果归属和引用问题上已经受到过批评,她表示,自己担心这些论文中的引用情况可能并没有完整呈现相关研究的来龙去脉。
AI 开始碰到数学核心问题
不过,在大量 slop 和不确定性之外,受访数学家普遍承认,这批成果里确实包含了一些分量很重的工作。
多位研究者告诉《The Verge》,虽然目前很难在如此庞大的材料中迅速完成判断,很多结果也还需要进一步验证,但其中一些工作的水准已经相当高。如果放在 AI 出现之前,这些成果中的不少都足以发表在顶级数学期刊,甚至足以支撑一名研究者建立自己的学术生涯。
还有少数结果,被研究者形容为足以让一名数学家成为菲尔兹奖有力竞争者的工作。
斯坦福大学数学家 Jared Duker Lichtman 表示,他认为这样的结果可能有数十个,其中包括对黎曼猜想的推进、霍奇猜想一个特殊情形的解决,以及四维 Kakeya 猜想的解答。
这些都不是边缘问题。
黎曼猜想和霍奇猜想属于七大千禧年难题;Kakeya 问题则是调和分析和几何测度论中的核心问题。今年获得菲尔兹奖的王虹,其重要工作之一正是三维 Kakeya 问题。
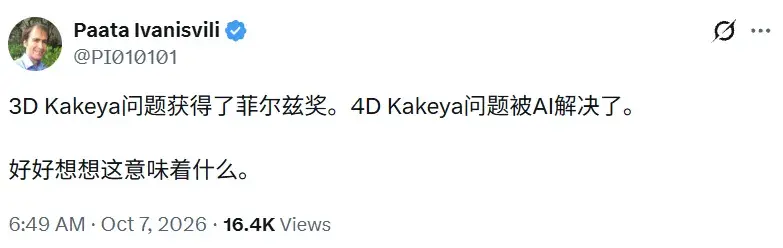
数学家 Scott Armstrong 说,这次涉及的很多问题,并不是什么没人听说过的小问题,其中相当一部分都是数学界研究了几十年的著名难题。
真正的冲击也由此开始显现。
有人的研究计划,一夜之间没了
OpenAI 发布这些成果之后,一些数学家发现,自己几年以来规划的研究方向突然发生了变化。
圣安德鲁斯大学数学教授 Colva Roney-Dougal 表示,她认识的一些同行,原本已经围绕相关问题准备好了基金申请,但 OpenAI 的发布之后,这些申请所依赖的核心研究目标直接被抹掉了。
Scott Armstrong 也表示,他知道有一个团队,几乎整个研究计划都被此次发布覆盖。
Tristan Buckmaster 则告诉《The Verge》,自己已经听说至少有三个人的完整研究项目因此受到毁灭性冲击。
来源:https://www.theverge.com/ai-artificial-intelligence/994255/openai-millennium-prize-problem-tristan-buckmaster-competition
这种影响并没有平均分布在所有数学领域。
受冲击最明显的,包括概率论、组合数学和理论计算机科学。一些群论方向也被研究者形容为遭到了推土机式的推进。
Armstrong 甚至认为,从问题分布来看,OpenAI 显然对一些方向进行了重点攻击,其中就包括今年菲尔兹奖相关的 Kakeya 问题,以及多个千禧年难题。
当然,也有数学家发现自己的研究领域暂时没有受到太大影响。
有研究者甚至开玩笑说,幸好自己研究的是一个不够热门的方向。
但这种轻松并没有持续太久,当越来越多人开始搜索这 700 多篇论文时,不少数学家陆续发现自己的工作、研究方向,甚至论文都已经出现在 OpenAI 的引用中。
OpenAI 知道这次发布会造成冲击
事实上,OpenAI 并不是完全没有预料到这种混乱。
经历此前几次与数学界的争议之后,OpenAI 找到了新成立的数学与人工智能咨询小组(Advisory Group on Mathematics and Artificial Intelligence,AGMAI),讨论如何更负责任地公开 AI 生成的数学成果。
来源:https://openai.com/index/advisory-group-on-mathematics-and-ai/
AGMAI 此前提出过一系列建议。
例如,AI 实验室最好只发布有人类真正理解的论文;如果无法做到,也应该提供足够的支持,让数学家能够理解、吸收 AI 生成的成果并寻找它们可能的应用。
在条件允许的情况下,证明应该进行形式化验证。
AI 公司还应该公开使用了什么模型、什么提示词,以及如何得到相关结果。
更重要的是,AGMAI 希望 AI 公司不要把数学研究发布当成宣传模型能力的营销工具,也不应该持续使用外界无法访问的专有模型测试前沿数学难题。
这次 OpenAI 确实采纳了其中一部分建议。
例如,公司表示将资助一系列数学研讨会和会议,帮助数学共同体理解这批结果;也首次披露了更多生成过程的信息,包括模型总共尝试了超过 4000 个问题,一项典型成果平均消耗约 3 小时 ChatGPT Pro thinking 算力。
同时,OpenAI 还建立了论文修改和引用协议,并承诺保留 GitHub 仓库的公开版本历史。
但一些最关键的信息依然没有公开。
OpenAI 没有透露究竟是哪一个模型产生了这些结果,也没有公开使用的提示词,更没有公布模型尝试过的全部 4000 多个问题。
公司也承认,目前形式化验证仍然不足,并表示未来发布时会进一步改进引用、数学表述和论文呈现质量。
问题是,OpenAI 没有准备停下来
这可能才是数学界最焦虑的地方。
OpenAI 明确表示,未来仍将继续使用内部前沿模型测试数学以及其他科学领域的问题。
在公布这批成果时,OpenAI 表示,希望把最先进的能力直接提供给科学家,因此仍有必要持续评估内部前沿模型在数学和其他科学领域的能力,从而加快相关科研工具的发展。
AGMAI 随后称,这次发布只能算第一步。
该组织再次强调,未来必须让更多研究者公平获得算力和研究工具,并提出了一个更根本的问题:数学研究的未来,不能只是让人类负责理解 AI 实验室生产出来的结果。
就算 AI 今天停手,这批成果也够数学界研究很多年
对于这 700 多篇手稿,很多数学家估计,仅仅是完整理解、验证和整理其中的成果,就可能需要整个数学界花上数年。
Scott Armstrong 用了一个非常形象的比喻:假设 AI 就像外星人一样,突然来到地球,把这些数学结果留下,然后马上消失,人类接下来可能还要花十年时间研究这些东西,弄明白它们到底意味着什么。
这其中其实仍然存在大量真正属于数学家的工作。
他们需要补齐证明中的细节,寻找隐藏的联系,提炼真正有价值的新思想,并把这些结果重新放回整个数学知识体系中。
Lichtman 因此认为,未来解释、验证和理解数学成果的工作需要获得更高的学术价值。
过去,学术奖励更多给予发现新定理的人。如果 AI 开始大量生产新定理,那么帮助整个共同体消化这些成果的人,也应该得到更多认可。
与此同时,多位数学家指出,这批成果虽然惊人,但目前看来,大多数仍然建立在现有数学方法和技术之上。
它们非常巧妙地填补了已知数学版图中的许多空白,却还没有明显创造出一套全新的数学语言或范式。换句话说,AI 证明了一个此前可能被严重低估的事实:在人类已经建立起来的数学体系内部,还有远比数学家想象中更多的空间可以被继续填满。
而数学研究本身几乎没有边界。
正如 Álvaro Lozano-Robledo 所说:数学研究本质上近乎无限,研究当然还会继续。
但 AI 公司跑得太快了
不少数学家真正不满的,也并不是 AI 开始做数学。
事实上,《The Verge》采访的很多研究者本身就是 AI 工具的积极使用者,也普遍欢迎 AI 带来新的数学成果。
问题更多出在 AI 公司进入数学领域的方式。
按照现在的模式,数学研究越来越像是在一张问题清单上不断打勾:解决一个问题,发布结果,然后马上进入下一个问题。
一个醒目的发布公告,一篇初步论文,剩下的验证、解释、整理、建立联系和寻找后续问题,全都交给数学共同体。
但在数学家看来,这种模式忽略了数学研究最重要的一部分。
解决问题当然重要。
但围绕答案产生新思想、建立不同领域之间的联系、提出新的问题,以及找到此前不存在的研究方向,同样构成数学本身。
如果 AI 实验室只是不断给出最终答案,那么理解这些答案并让它们真正进入数学体系的成本,最终还是落在了数学家身上。
最受冲击的,可能是年轻数学家
相比已经拥有稳定职位的教授,这场变化对博士生、博士后以及尚未获得长期教职的青年研究者影响尤其明显。
因为一个开放数学问题,往往可以支撑一个博士论文、一个基金申请、一份求职材料,以及未来数年的研究计划。
现在,这些问题随时可能被 AI 突然解决。
ETH Zurich 数学家 Simon Machado 表示,对于那些科研经费即将结束,或者此刻正在找工作的人来说,这种变化尤其具有破坏性。
越来越多年轻研究者开始担心:自己赖以建立职业生涯的问题,会不会就是 AI 下一个解决的目标?
更令人不安的是,这种冲击看上去没有停下来的迹象。
OpenAI 的数学成果正在一波接一波出现,而且每一次规模似乎都比上一次更大。
Roney-Dougal 形容,这种感觉让人觉得 AI 公司似乎并不真正关心某一个具体数学结果,它们只是不断向前。
Armstrong 的说法更加直接:数学家甚至还没有消化完这一批,可能再过两个月,就会出现一个更大的结果集,把今天的一切再次覆盖过去。
即使像他这样自称对 AI 非常乐观、平时也大量使用 AI 工具的数学家,如今也开始感到不安。
接下来的几年,数学界会变得非常奇怪。
原文链接:
https://www.theverge.com/ai-artificial-intelligence/1008726/openai-mathematics-solutions-chaos
© THE END
转载请联系本公众号获得授权
投稿或寻求报道:liyazhou@jiqizhixin.com