从理解行动后果,到预测未来、实时纠偏,Aether AI 让因果智能在真机上跑通闭环。
作者|七月
编辑|栗子
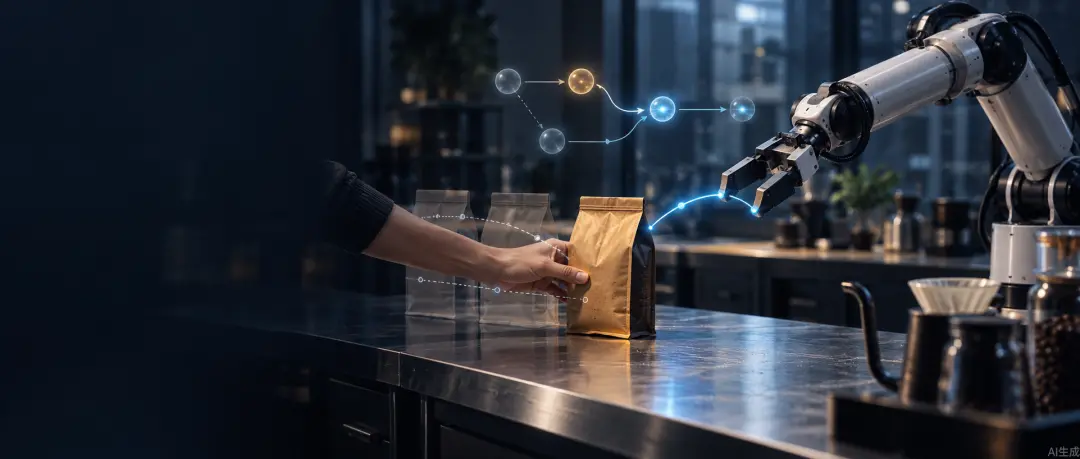
机械臂正平稳伸向桌上的咖啡袋。测试过程中,一只手反复介入,多次把咖啡袋挪到桌上的不同位置。
每次咖啡袋被挪走,原来的轨迹都会失效。搭载Aether AI最新CRIS-0模型的机械臂随即停下:它判断"接近目标"这一步的条件已经不成立,重新定位咖啡袋,调整接近姿态,然后把咖啡接着冲完。
这几秒钟的抗扰动反应,是Aether AI在物理世界铺开的新故事起点。
作为一家由UCSD助理教授黄碧薇创立、聚焦于“因果智能”的下一代AI公司,Aether AI的目标是构建能够理解物理世界底层因果规律、具备跨场景举一反三能力的智能系统——让 AI 不仅能够感知和预测世界,更能够理解行动如何改变世界,并在采取行动之前,对其可能产生的后果进行推演与判断。
而机器人,只是他们选定的第一个物理验证场。
几个月前,Aether AI凭借因果世界模型CausalWM拿下TriWorldBench榜首,证明了让模型在生成画面前先推演运动与空间几何的价值(详见《Aether AI发布首个因果世界模型,世界模型开始思考“行动背后的因果”|甲子光年》)。
但当时行业内外都在追问同一个问题:屏幕里推演出来的因果未来,什么时候才能真正接进真机的神经系统,直接指导物理世界的下一步?
刚刚亮相的CRIS-0,正是Aether AI对这个问题的阶段性闭环回答。
CRIS-0 完整视频
1.可靠性不看成功率,
看出错后能不能“接着做”

当机器人走出实验室、试图进入真实的人类生活时,最先暴露的往往不是末端执行精度,而是面对意外时的恢复能力。
在高度结构化的工业产线上,机器人的高可靠性本质上是由确定性环境托底的:零件摆放分毫不差、光照恒定、流程锁死。但如果把这套逻辑搬进家庭,确定性的地基顷刻坍塌——物料会被随意挪动,家人的走动随时会带来意外遮挡,任务链条一旦拉长,前序步骤哪怕只有几毫米的偏差,也会在几分钟后演变成灾难性的动作崩塌。
过去两三年,主流学界与产业界押注的是端到端的视觉-语言-动作模型(VLA):相机吃进图像,大模型吐出控制动作。这种架构足够直接,但本质上依然停留在“相关性”的表层匹配——模型学到的是“看到这种像素分布,通常接什么动作”。由于缺乏对任务深层因果机制的理解,它既无法分辨环境变化中哪些是无关噪音、哪些是致命干扰,更在长程任务失败后,成了一笔说不清“到底错在哪一步、为什么错”的糊涂账。
在Aether AI看来,这些痛点的根源不是策略网络(Policy)规模不够大,而是整个系统底层缺少了对任务状态与因果逻辑的显式理解。
行业需要切换范式:从“精确控制+结构化环境”,转向“状态理解+动态调整”。真实环境永远有扰动,这并不可怕;关键在于系统能否时刻掌握“任务进行到了哪一步”、“关键约束条件是否依然满足”,以及在条件破损时“知道该退回哪一步去修补”。
CRIS-0选择家庭场景作为首个验证地标,本身也是一个充满技术野心的战略选择。家庭没有工业产线的标准化防护栏,却汇集了动态扰动、模糊意图、长程连续操作和极端个性化偏好等复合挑战——在这个“北极星场景”里能跑通因果闭环,智能的成色才经得起检验。
2.拆解CRIS-0:
用统一因果状态,
把大脑与手脚串成闭环

在CRIS-0的系统架构中,以往相互割裂的组件被重新编织进了一套严密的逻辑骨架。其核心在于将两大支柱——因果智能体(Causality-guided Robot Agent)与因果世界模型(Causal World Model),在统一的因果状态表示(Unified State with Causal Features)下彻底打通,并通过统一工具接口(Unified Tool Interface)调度全部底层能力。
以一个日常生活中经常发生的场景:“帮我拿一瓶适合健身目标的饮料”为例。
面对这种充满不确定性的模糊需求,CRIS-0的运作链条清晰展现了因果驱动与端到端黑盒的本质区别:
意图锚定与任务图初始化:规划器(Planner)首先调取用户的个性化偏好与上下文(例如晨跑记录、当前时间段、忌糖习惯),在多款饮料中选定功能性饮料;随后,规划器将宏观指令解构成一张演化任务图(Task Graph),将其拆解为接近、定位、精细抓取、放置等原子化、可验证的阶段。
统一工具接口动态调度:
-
自由空间运动(Free-space Motion):CRIS-0调用系统自动生成的规则函数(Rule-based functions),借助SAM3分割与RGB-D相机精准锁定饮料位姿,利用逆运动学(IK)迅速将机械臂与夹爪送至预操作点;
-
接触密集型操作(Contact-rich Interaction):一旦进入复杂的物理接触环节(如稳定握持瓶身),规则函数自动交棒给策略模型(Policy Model),完成精细力控;
阶段验证与闭环容错:每走完一个节点,内置的验证器(Verifier)立刻执行状态核验。饮料抓稳了吗?如果滑脱,系统不推进后续动作,而是在当前阶段就地重试;如果瓶子在移动中被意外碰倒,系统则自动退回至重新定位阶段。
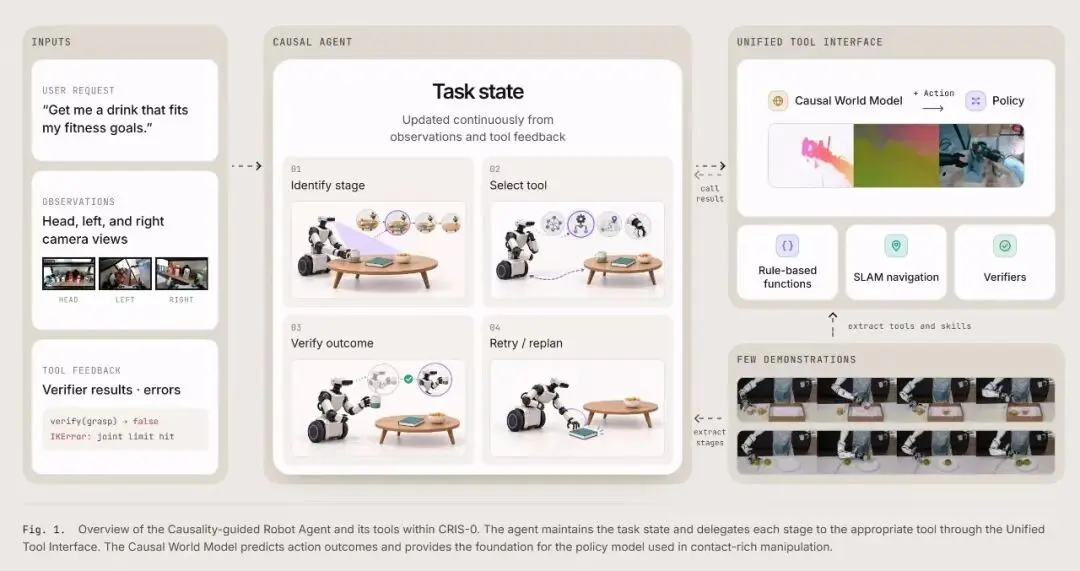
因果智能体负责维护任务状态,并通过统一工具接口将每个阶段的任务分配给相应的工具;因果世界模型预测行动结果,并为在接触丰富的操作中使用的策略模型提供了基础。
在这套协同机制中,最核心的纽带是“因果状态表示”和它们之间的因果关系。
系统追踪的从来不是一帧帧瞬息万变的表面像素,而是任务进程中的核心因果变量。以经典的换桌布任务为例,因果状态紧盯三个硬指标:桌布是否被夹爪真正咬住(cloth_grasped)、桌角离目标位姿的距离偏移量(corner_offset_cm)、以及拖拽过程中是否发生了滑移(slippage_detected)。正是这组结构化因果变量,决定了系统是该发力拖拽、重新抓取,还是宣布该阶段完成。
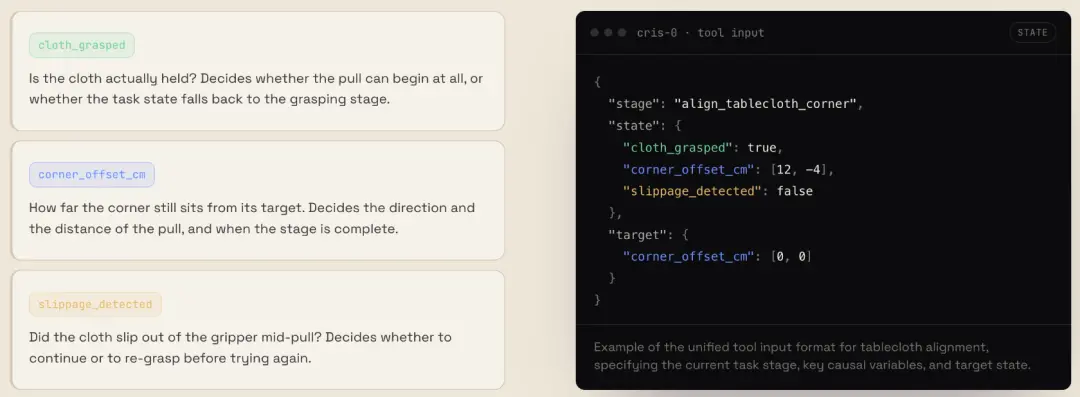
换桌布任务流程
任务图不仅能指导执行,更具备罕见的自愈与自演化能力。
如果底层工具在运行时发生故障——例如求出的逆运动学解突破了机械臂的物理关节极值,CRIS-0不会直接死锁崩溃,而是能捕捉错误反馈,自主修正工具实现代码,在重新跑通后将修好的工具版本固化留存;当长程任务在执行中涌现出前置阻碍时(比如用户要求“找一下钱包”,翻找过程中系统识别出“必须先拉开拉链”或“必须先移开沙发垫”),系统能将涌现出的新子任务即时编织进图谱中,实现结构化回退与推进,绝不需要从头盲目重来。
那么,此前发布的因果世界模型,在真机里究竟扮演什么角色?
在CRIS-0里,CausalWM不再只是旁观的“视频生成器”,而是直接参与在线推演。它承袭了“先推演因果状态转移、再呈现画面细节”的因果思维链(Causal CoT),当规划器权衡候选动作时,世界模型预判这些动作将导致关键因果变量发生何种演变。
更进一步的是,研发团队在世界模型主干之上外挂了一个动作模块,构筑起因果世界动作模型(Causal World Action Model)。世界模型不仅充当了认知内核,更直接作为高难度操作的控制策略——让动作直接流淌自系统对物理世界未来演进的因果理解中。
3.真机实测:
在真实扰动中看懂“为什么”

在公布的系统级演示中,CRIS-0在家庭环境里展现了三项硬核特质:抗干扰(Robustness)、长程自主执行(Autonomy/Long-Horizon)与个性化适应(Personalization)。
抗干扰:能过滤无关表象,只对核心变量响应
搭载了CRIS-0的机器人进行咖啡任务
在咖啡制作任务中,咖啡机周围的光照环境被刻意剧烈扰动,忽明忽暗的光影让画面像素发生了翻天覆地的变化。但CRIS-0的机械臂完全未受干扰,稳稳按下了操作键。而当咖啡袋被人为推开数厘米时,机械臂却瞬间叫停并重规划。
这种对比直击因果智能的本质:系统知道光照并不构成任务阻碍,属于无关视觉变量;而目标物体的空间坐标是驱动抓取成败的核心因果变量。据实测统计,面对物体移位等外部扰动,系统平均在2秒内便能捕捉到变量异动并重置规划,在10次强干扰测试中实现了9次成功恢复。
安全机制:从“事后补救”走向“因果内建”
搭载了CRIS-0的机器人进行微波炉加热任务
微波炉加热场景生动展示了何为“因果层面的安全”。当一个未开启的金属易拉罐被误放入餐盘时,机器人敏锐识别到“微波加热”的前置因果条件被破坏,并未鲁莽启动加热,而是自主打断原计划,先把易拉罐挑出移开,待环境恢复安全后再继续流程。
更亮眼的是防碰撞机制:当测试人员的手骤然伸向微波炉门缝边缘时,原本正在执行关门动作的机械臂在半空中骤停。
这套反应不是靠传统外挂的安全碰撞条,也不是靠延迟极高的多模态大模型慢速常识推导。Aether AI在系统内搭建了双层安全响应:规划层负责宏观因果理解,而底层的因果世界模型则将碰撞危险因子作为高权重变量时刻监测,一旦风险突显,系统平均0.2秒内便能触发制动,甚至下探至0.1s级急停响应,等干预消除后再继续动作。
长程任务的“阶段验证制”:掐断误差累积
搭载了CRIS-0的机器人进行垃圾分拣任务
在繁杂的客厅整理任务中,面对“客厅太乱,帮我收拾”的宽泛指令,CRIS-0自主拆解出寻物、分类、归置等多步连续动作。面对桌上的易拉罐,它会先试探瓶身重量与状态:若确认是空罐则投掷入垃圾桶,若探测到仍有残留液体则端正放回茶几侧翼,杜绝误扔;面对杂乱的纸质物品,它能基于上下文识别属性:普通的杂志书籍码放在茶几上,而涉及私人信息的财务账单则被妥善收进封闭抽屉。
搭载了CRIS-0的机器人分别收纳书和账单
在数十步到上百步的漫长作业中,传统模型往往因单步微小误差不断叠加而在后期彻底“失控”。CRIS-0依靠阶段验证制,每完成一个原子闭环便就地校验,硬生生切断了误差跨阶段蔓延的通道。
懂分寸的个性化
而在面对诸如“准备一份饮品”的模糊需求时,CRIS-0能够将用户刚完成晨跑的身体状态、时间节点与历史偏好变量协同推演,最终精准送上电解质功能水。在测试的20条需要跨常识推理的模糊日常指令中,系统自主完成了18次准确的抓取与放置。
作为长期追踪硬科技演进的智库型媒体,「甲子光年」在看到令人欣喜的工程突破之余,也始终保持着对技术成色和落地边界的审慎审视。
客观来看,要真正实现从受控Demo迈向严苛的工业级或商业化部署,CRIS-0乃至整个因果智能阵营仍需跨过几道显性门槛:
首先是消融实验与因果纯度的证据链。目前的展示属于高度工程整合的系统级验证,但当剥除因果世界模型或剔除因果状态表示后,系统在相同扰动下的性能断崖究竟有多深?目前公开材料中尚未给出详尽的对照组数据。系统提取的所谓因果变量,究竟在多大程度上构成了严格数学意义上的因果发现,抑或仍包含一部分工程经验下的状态机设计?这需要后续学术论文给出更严格的干预测试与反事实证明。
其次是真实环境的泛化边界。当前的验证集中在单一家居布局的轻度到中度扰动(位置平移、光影、颜色、人手干涉),而更具破坏性的严重遮挡、多动态目标交织、跨房间大跨度重定位,以及在不同机器人硬件本体之间的零成本迁移,依然有待系统性验证。
最后是物理AI的固有物理瓶颈。柔性物体操作(如展开揉皱的包、叠放柔软的桌布)至今仍是困扰整个机器人学术界的硬骨头。其接触面受力与形变极度非线性,仅凭前两层的状态建模依然难以穷尽,必须等待更深层的动力学突破。
对此,Aether AI并无回避。他们透露,公司规划的技术四层金字塔中,本次Demo目前跑通了第一层(因果驱动智能体)与第二层(因果世界模型)的局部闭环;同时,Aether AI也正在迈向更底层的第三层(解耦的模块化神经架构)与第四层(直接建模因果时序关系的Causation Transformer)。
4.超越具身:
第四代AI范式的破晓时分

把坐标轴拉得更宽广一些,才能看清Aether AI究竟身处何处。
黄碧薇曾将过去三十余年的AI演变提炼为四个关键台阶:相关性小模型(90年代统计学习) → 因果小模型(2010年前后CMU奠基的算法突破) → 相关性大模型(以Transformer与LLM为标志的算力与数据狂欢) → 因果大模型。
在她看来,今天以ChatGPT为代表的主流路线,之所以能依靠相关性一力降十会,是因为人类语言本身是高度符号化、语义总结于表层的离散模态;但物理世界并不存在这层现成的文本包裹——摩擦力、惯性、形变、隐秘的作用力,全部以隐变量的形式深埋于现实之中。如果不转向因果性,单纯靠暴力堆叠视频数据和显卡,AI终究会撞上泛化的坚硬南墙。
无独有偶,学术界近来也涌现出如CausalFM、CDFM等尝试将因果推断引入预训练Transformer的先锋探索。但学界的尝试大多停留在结构规整的表格数据沙盒中,证明了模型推断因果律的理论可行性。
而Aether AI选择了一条阻力更大、却也更具产业想象力的险途:直接把因果的解剖刀,刺向像素、轨迹、三维几何和连续控制信号交织的混沌现实。
这也是因果智能要延伸到forecasting、科学发现时必须面对的问题。家庭任务里的位置、接触和滑移,与生物系统的调控、材料的结构与性能、经济系统中的政策效应,变量完全不同。换一个领域,就要重新选择变量、重新设计干预和验证。机器人适合做第一轮验证,是因为每个动作都会立刻带回结果,很多问题藏不住;但一组家庭Demo不能替其他领域完成验证。
用机器的方式,抵达人类未曾到达的因果彼岸——这条路上充满了极高的理论与工程壁垒,但也正因其艰难,才构成了难以被算力军备竞赛轻易抹平的真正护城河。
正如黄碧薇在融资之际所言:“我们已经站在黎明前夕了。”
当CRIS-0在被打断后沉着停顿、重新校准轨迹的那一刻,物理世界里的机器人,或许终于开始学着像人类一样,在行动之前,先动脑想一想“为什么”。
(封面图来源:AI生成)

END.