视频世界模型(Video World Model)需要生成连续画面,并在用户指定动作的控制下维持场景一致性。对于基于自回归生成的视频世界模型,KV Cache 中保存着历史画面,使得生成时能够检索并重复利用此前生成的相似场景。然而随着生成的不断进行,KV Cache 的显存成本十分高昂。例如 LingBot-World-v2 生成约 5 秒、93 帧的视频,KV Cache 就需要超过 21 GiB 显存。
将 KV Cache 量化到 2-bit 是缓解这一问题的重要方向,目前已有方法将 2-bit KV Cache 量化应用于自回归视频生成,并取得接近 BF16 的 VBench 评测表现。但研究团队发现,当将这些方法应用于视频世界模型时,即使评测分数几乎不变,生成画面仍可能出现明显的闪烁、模糊和细节失真。
哈尔滨工业大学(深圳)iLearn-Lab 与新加坡国立大学 LV-Lab 的研究团队深入分析了这一现象,并提出面向视频世界模型的免训练 2-bit KV Cache 量化框架 QuantWM。该方法从注意力保护角度出发,在五种模型上显著改善量化后的视频质量,同时实现最高 6.20 倍 KV Cache 压缩。
-
论文:https://arxiv.org/abs/2609.26425
-
项目:https://quantwm-project.github.io/QuantWM/
评测分数接近不代表生成效果好
现有方法 Quant-VideoGen(QVG)已将 2-bit KV Cache 量化应用于自回归视频生成,并在视频基准上取得接近 BF16 模型的表现。但研究团队发现,在视频世界模型上,这些分数并不能充分反映量化带来的视觉退化。以 HY-World 1.5 为例,BF16 与 QVG 的 VBench Temporal flickering 分数分别为 95.62% 与 95.85%。但观看生成的视频,仍然可以观察到量化引入的严重画面闪烁与视觉退化,图 1 展示了这一反差。这说明,即使是与闪烁相关的评测指标,也未能充分捕捉视频世界模型上的量化性能退化。因此,团队结合视频可视化,以及相对 BF16 生成结果的逐帧 PSNR、SSIM 和 LPIPS,进一步分析量化造成的偏差。
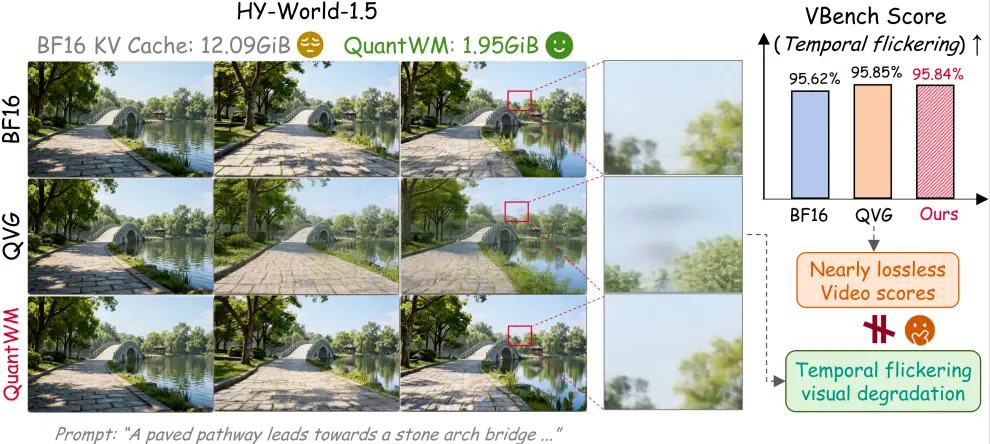
图 1 2-bit KV Cache 量化下的时序闪烁和画质下降,而视频评测指标几乎不变
误差更小的 Key,为什么反而影响更大?
研究团队进一步分析这一现象来源。KV 缓存包含 Key 和 Value。可以把 Key 理解为检索历史信息的 “索引”,Value 则是检索后读取的 “内容”。分别量化两者后发现,仅将 Key 压缩到 2-bit 比仅量化 Value 带来更明显的视觉退化。更值得注意的是,相比于 Value,Key 自身的量化误差往往更小,却仍造成了更大的输出误差。这意味着,视频质量的差异并不是因为 Key 更难量化,单看量化误差大小无法解释时序闪烁和画质下降。
为解释这一现象,研究团队进一步分析了视频世界模型中的注意力计算。当前 Query 与历史 Key 的匹配分数,决定了模型如何分配对历史信息的关注。因此,量化 Key 引入的量化误差可能改变这些分数的相对排序,让模型转而关注另一帧、另一个空间位置。如图 2 所示,对于同一个 Query,量化前后注意力分数最高的历史时空位置发生了变化,有时甚至跨越了不同帧。对连续生成而言,这种偏移可能扰动模型对历史场景的利用,进而影响画面稳定性,造成时序闪烁和画质下降。因此,研究团队指出当压缩 KV Cache 时,也要保护模型查找历史信息的方式,并以此为基础提出了一种新的视频世界模型 training-free 2-bit KV Cache 量化框架 QuantWM。
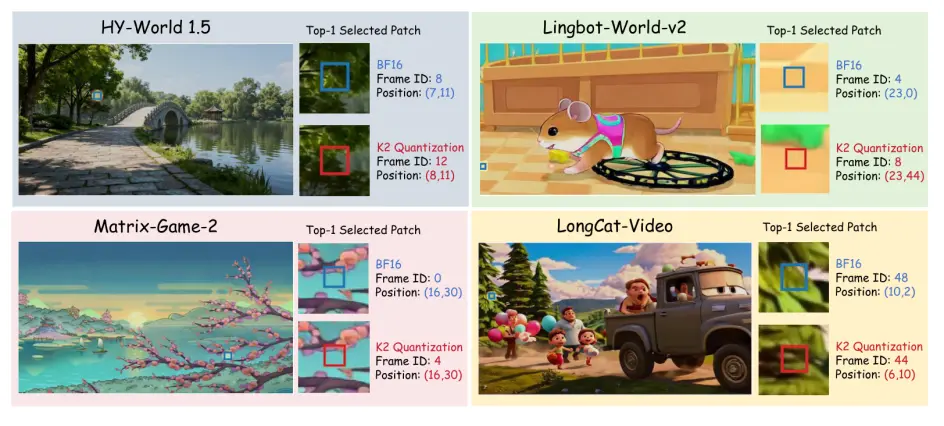
图 2 同一个 Query 在 Key 量化前后可能选中不同历史帧或图像块
第一步:选择量化后更合适的聚类中心
QuantWM 的第一个设计是量化敏感性感知聚类(QSAC)。在 QVG 中,每个 Key 被分配给一个聚类中心,中心保留较高精度,两者之间的残差则进行 2-bit 量化。研究团队认为,距离最近的中心,不一定能得到量化后最合适的结果。残差的动态范围,以及误差落在哪些通道上,都会影响最终的注意力分数。QSAC 先利用 Query 敏感性加权的距离筛选候选中心,再结合各残差组的动态范围及其敏感性,估计 INT2 量化可能引入的注意力扰动,并据此选择中心。这样,聚类中心分配充分考虑残差压缩到 INT2 后可能产生的注意力扰动,从量化阶段减少更有影响的误差。
第二步:用少量信息补偿关键方向
即使经过 QSAC,2-bit 量化存在仍不可避免的误差,最直接的方案是对注意力 logits 进行误差补偿,但是保存全量的量化误差非常昂贵。团队观察到,历史 Query 的能量往往集中在少数方向上。例如,LingBot-World-v2 的一个层仅用前 8 个主方向,就覆盖了约 71% 的 Query 能量,这使得补偿可以重点保留其在这些主方向上的分量。基于此,QuantWM 进一步引入主子空间注意力补偿(PSAC),PSAC 以低秩形式保存 Key 量化误差在这些主方向上的分量,并在缓存重构时补偿 Key,从而修正后续计算的注意力分数。实验中采用 8 个主方向,并将补偿系数量化为 INT8,以控制额外存储开销。两项设计均使用已经生成内容的历史 Query 统计,不需要重新训练模型,能够直接接入视频世界模型的生成流程。
五种模型验证:画质改善,缓存显著缩小
团队在 Matrix-Game-2、LingBot-World-v2、HY-World 1.5 三个视频世界模型上验证 QuantWM,并进一步在 LongCat-Video 和 Causal-Forcing 两种视频生成模型上验证其泛化能力。在 480p、93 帧生成视频对比中,QuantWM 的 PSNR、SSIM 和 LPIPS 上均优于 QVG 与 KIVI,同时,可视化内容显示 QuantWM 生成视频的质量显著提升,时序闪烁、模糊等现象得到改善。在 VBench 的五个评估维度上,QuantWM 在各模型中均取得所比较量化方法的最佳平均排名。此外,论文还进一步报告了 720p 和 1 分钟长视频的评估结果,分别验证了更高分辨率下的生成质量和长视频生成下的视频基准表现。
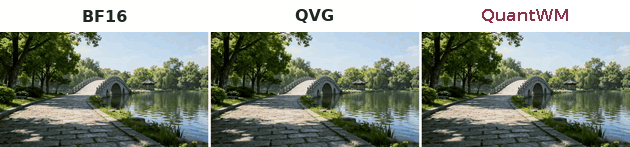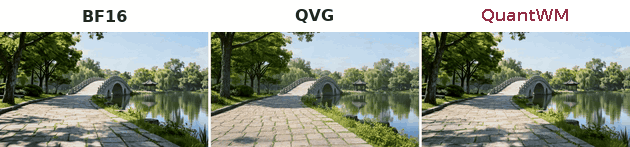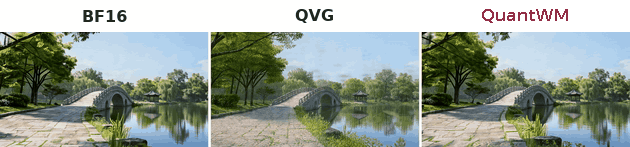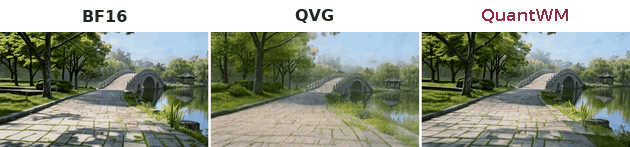
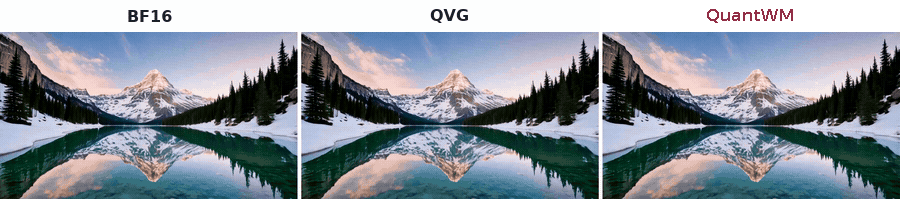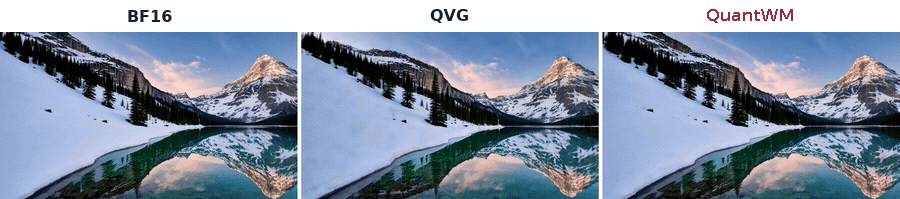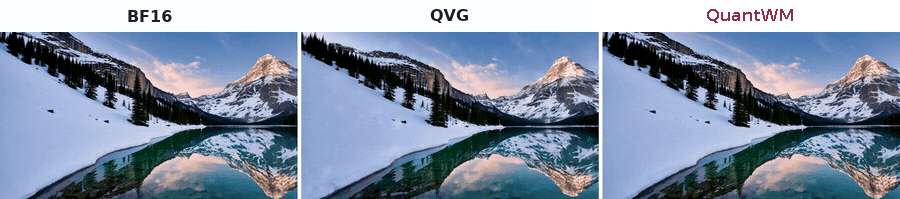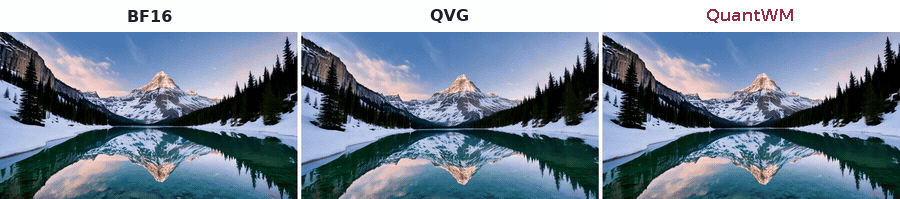
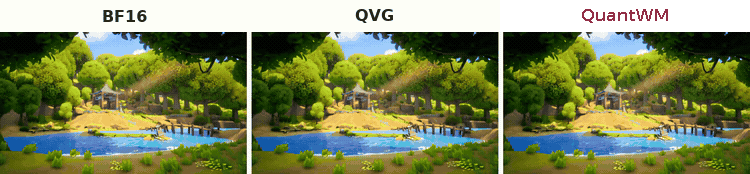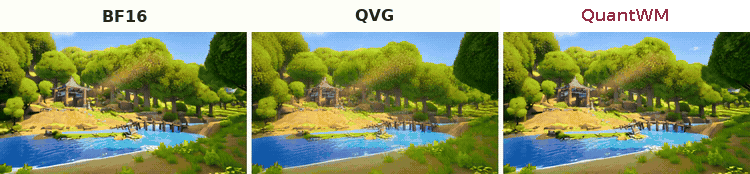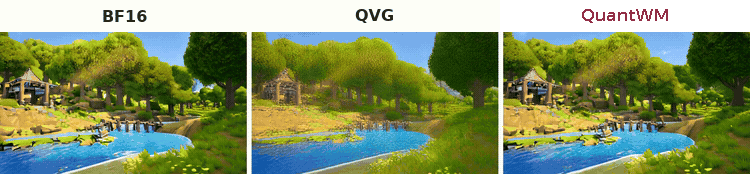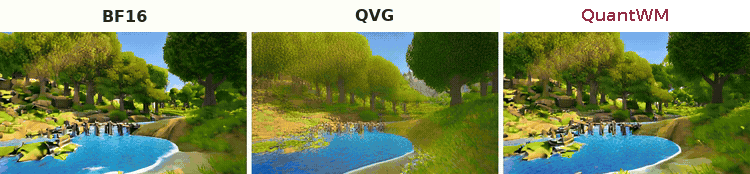
图 3 BF16(左)、QVG(中)、QuantWM(右)生成视频对比(上:HY-World-1.5,中:Lingbot-World-v2, 下:Matrix-Game-2)
注意力分析进一步表明 QuantWM 能够减少量化引起的历史时空位置选择偏移。如表 1 所示,在 Matrix-Game-2 上,最高分历史 token 相对 BF16 的选择变化比例,从 53.88% 降至 10.19%,HY-World 1.5 上则从 61.36% 降至 13.92%。
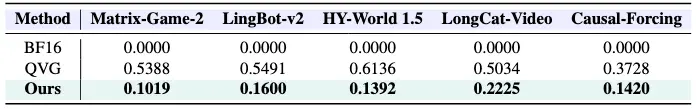
表 1 最高分历史 token 选择差异对比
系统实现方面,QuantWM 设计专属 Triton 内核,在考虑聚类中心、量化参数及补偿信息等额外开销后,实际 KV Cache 压缩最高达到 6.20 倍,如图 4 所示。
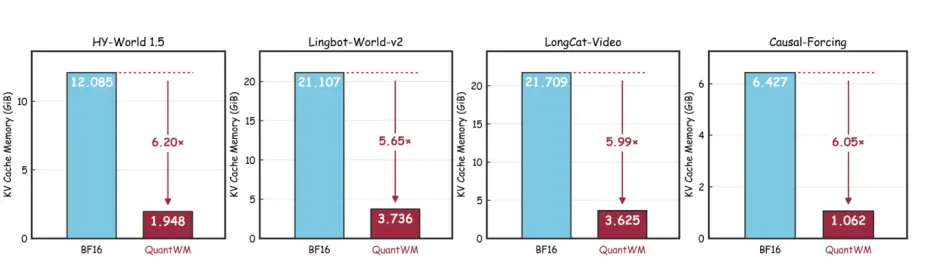
图 4 480p 93 帧视频下的 KV 缓存显存占用,最高压缩 6.20 倍
结语
QuantWM 揭示了视频世界模型低比特 KV Cache 压缩中容易被忽视的问题。即便视频评测分数接近,并不意味着量化后仍能稳定利用历史场景信息。因此,面向视频世界模型的压缩研究,需要结合基准指标、实际视频表现,以及模型对历史信息的利用方式进行多方位评估。
作者信息:
本研究由哈尔滨工业大学(深圳)iLearn-Lab 张淼教授团队与新加坡国立大学 LV-Lab@NUS 颜水成教授团队合作完成。
iLearn-Lab 张淼教授团队长期聚焦于模型压缩、高效训练及推理相关研究。
LV-Lab@NUS 颜水成教授团队长期专注于视频生成、世界模型、AGI 相关研究。
共同一作 Jiaqi Zhao 赵家奇(博士生)与 Xiaobin Hu 胡晓彬(高级博士后)。
© THE END
转载请联系本公众号获得授权
投稿或寻求报道:liyazhou@jiqizhixin.com