2026年10月初,全球半导体与人工智能领域抛出了一份让人倒吸一口凉气的市场统计数据:
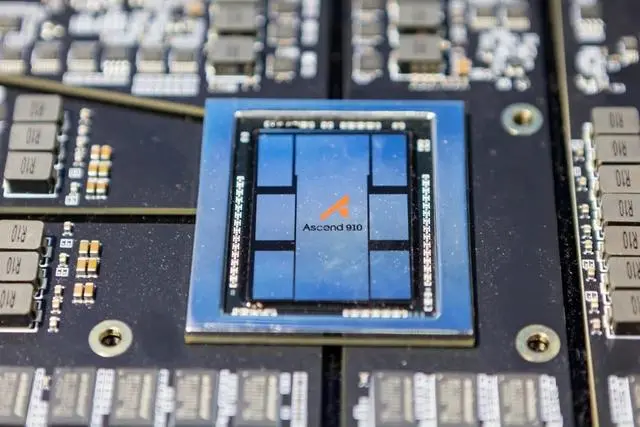
在中国的 AI 芯片市场,华为昇腾系列芯片的份额大幅突破 50%,一举压过英伟达,登顶榜首!而英伟达的份额,从四年前的 95% 跌落至 8% 以下。
把时间倒回到 2022 年,美方相继祭出高算力芯片禁令,雷蒙多与硅谷巨头们自信满满地以为切断了 A100/H100 供应,就能把中国 AI 打回“算力原始时代”。
那时的英伟达在大脑皮层写满了垄断的傲慢,而华为昇腾在自家的土地上也仅占区区 3%。
谁也没想到,仅仅过了一千多个日夜,这场被寄予厚望的“封锁剧本”居然拿错了台词,演变成了科技史上最具讽刺意味的“反向搬砖”——禁令不仅没能饿死中国 AI,反而把全球规模最大、增速最猛的 AI 算力市场,拱手送交给了中国自研生态。
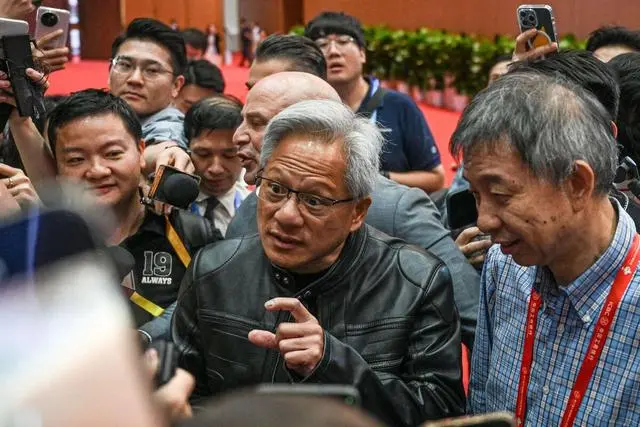
连英伟达 CEO 黄仁勋近期在接受采访时都只能无奈摊手,坦言他们几乎已经“把中国市场让给了华为”,公司财务预测里甚至对向中国销售先进芯片抱有“零期待”。
仅 2026 财年一季度,英伟达就因为出口管制砸了手里的资产,吞下近 45 亿美元的减值损失;而华为今年的 AI 芯片预计营收已冲破 120 亿美元大关。
这不仅仅是一次简单的市场份额洗牌,而是一场由禁令倒逼出来的全栈科技大奇迹。
一、 “特供阉割卡”的溃败:豪华跑车装上了草坪机发动机
英伟达是怎么在短短四年里,把 95% 的绝杀盘打成 8% 的溃退盘的?
答案很残酷:它试图用“阉割版特供芯片”来考验中国大厂的智商。
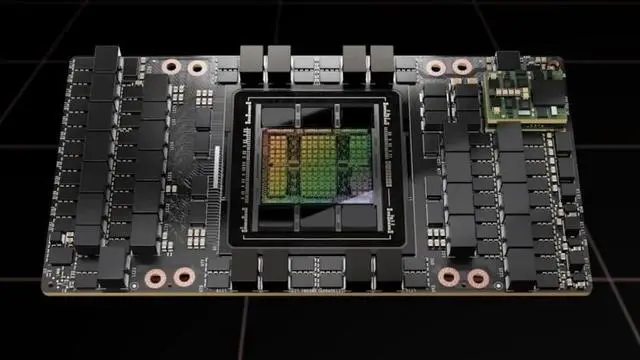
禁令收紧后,英伟达为了不放弃中国市场,推出了符合合规要求的“特供卡”H20。
这颗芯片的戏谑之处在于:为了遵守美方对算力峰值的限制,英伟达把它的算力核心阉割到了 H100 的 20% 左右,但为了维持大模型的基本吞吐,又不得不保留了超大显存和高带宽。
这画面就像什么?这就好比英伟达把一辆原本能跑 350km/h 的顶级法拉利,拆掉引擎换成了一个 1.0L 的草坪机发动机,却装了一个极其宽敞的后备箱,然后开价 1.5 万美元一辆,不打折!
H20 芯片
最开始,急于买卡救急的国内互联网巨头们忍辱负重采购了一批。但很快,云厂商和算力团队的精明精算师们算清了这笔账:用 H20 做大模型训练,算力太弱导致训练周期拖得无限长;拿去做推理,单卡价格又贵得离谱。
买 H20,无异于“花天价买瘸腿马”。
当华强北与中关村里的 H100 水货溢价从几倍一路崩塌,当云巨头们不再抱有“抢购受限版芯片”的侥幸,一个历史性的临界点被触发了:砸下数百亿资本支出的买家们,彻底放弃了英伟达,转身将算力底座全量切向国产。
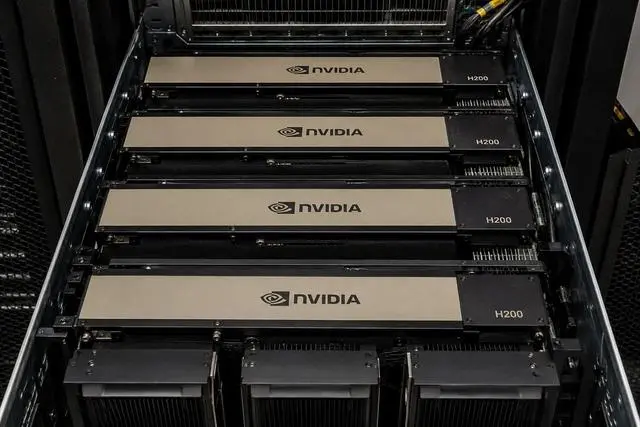
H200
二、 换维解题:当“单点极致”撞上“系统工程”
面对这场逆袭,华为轮值董事长徐直军在最新的公开发言中非常坦诚:如果单比一颗芯片的物理先进制程,由于客观环境限制,我们确实还有差距。
但 AI 算力的战争,从来都不是单挑,而是万人兵团的阵地战。
训练一个千亿甚至万亿参数的大模型,就像盖一座几百米高的摩天大楼。英伟达的顶级芯片确实是个“满分高考学霸”,单卡计算速度快到飞起。
但在真实的大模型集群里,几万张卡同时工作,只要有一张卡因为过热掉线,或者卡与卡之间互相通信写信“卡顿”,整个集群的训练就会瞬间瘫痪。
中国半导体和云计算产业,演化出了一套极其硬核的系统工程解题思路:
1)底座早在 8 年前就已埋下:
华为早在 2018 年就推出了达芬奇架构(DaVinci),把标量、向量、矩阵三种计算单元融在一颗 AI 核心内部,为大模型的密集矩阵计算打下了物理基础。
2)高速公路自己修(HCCL & 灵衢):
华为打造了 HCCL 集合通信库与灵衢(UnifiedBus)总线协议,通过全无阻塞胖树拓扑结构,构建了数据无损的高速公路网络。
3)“群殴战术”与超强容错:
DeepSeek 在内蒙古等数据中心直接部署了超过 16 万张华为昇腾加速卡。华为通过软硬一体的网络隔离与秒级自愈机制,让万卡集群在长达数月的连续训练中,稳定运行率和线性效率达到了夸张的 99% 以上!
“一颗不够强,就用一万颗无缝连起来补”。 当单卡峰值的微弱差距被庞大集群的高效吞吐彻底抹平,硅谷依赖多年的“单芯片制程护城河”,被中国工程师用大规模异构集群给硬生生推平了。
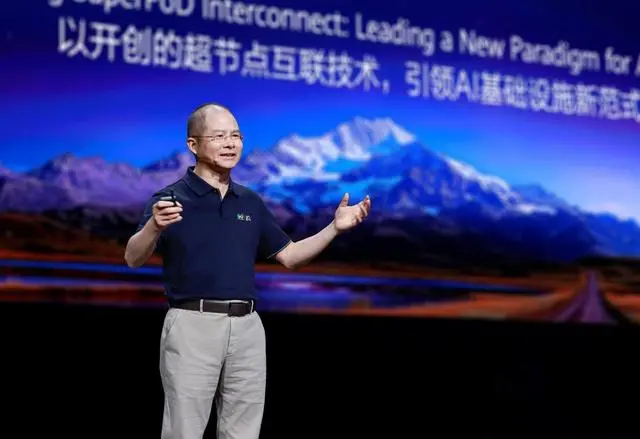
徐直军在 Huawei Connect 2025 讲超节点互联
三、 拆掉 CUDA 的围墙:万米高空的“换机翼”奇迹
业界曾经流传着一句名言:“阻碍大家离开英伟达的不是硬件,而是 CUDA 生态。”
15 年来,全球数百万程序员写的 AI 代码,都深度绑定了英伟达的 CUDA 软件栈。要求程序员抛弃习惯、重写几万行底层代码?那几乎是不可能的任务。
华为的破解策略堪称神来之笔:它没搞门槛极高的“全新语言”,而是做了一个“智能外挂翻译盒”。
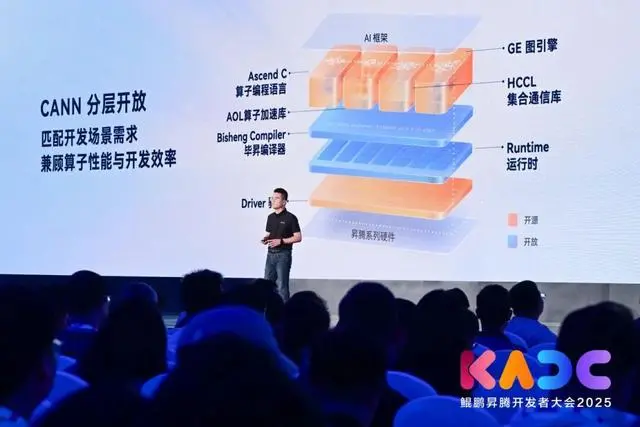
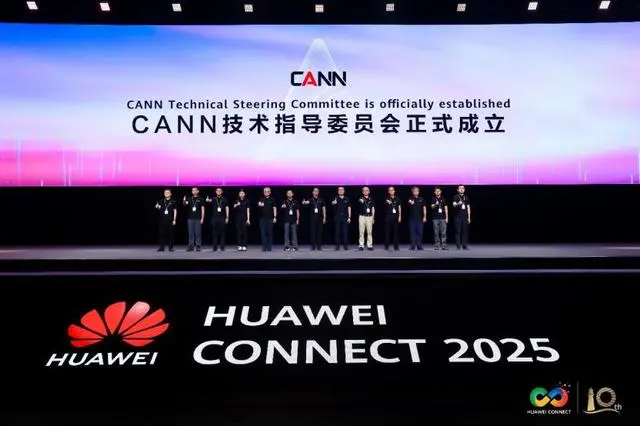
通过 CANN(异构计算架构) 与 Torch-NPU 的深度优化,开发人员只需要把开源框架 PyTorch 代码里的设备申明从 cuda 改为 npu,其余上万行深度学习逻辑完全不用动,底层硬件便能由 CANN 接管高效运行。2025 年 8 月,华为更是将 CANN 底层全面开源,如今开源社区里非华为的开发者数量早已超越了华为自家工程师。
有了生态垫底,各大互联网巨头上演了云计算史上最惊心动魄的一幕——“万米高空换引擎”。
阿里云百炼、通义千问、字节跳动、DeepSeek 等主流大模型底座,在不中断几亿普通用户日常访问的前提下,将底层算力彻底移植到了国产算力栈上。在用户毫无察觉的毫秒间,中国 AI 基础设施完成了从“单点卡脖子”到“全栈自立”的跨越。
四、 终局与展望:全球 AI 算力“双轨制”的诞生
从演化经济学的视角来看,美方的断供禁令,本质上做了一件极其违背商业规律的事:它强行切断了中国资金向硅谷的输血,逼着中国每年几百亿美元的算力采购预算,像山洪暴发一样灌溉给了华为、寒武纪等本土半导体企业。
造血循环一旦建立,研发、卖卡、获利、升级的飞轮就彻底转了起来。
这一场“断供 4 年”的博弈,最终反向催生出了一个前所未有的格局:全球 AI 算力体系彻底走向了“双轨制”。
一轨是西方阵营基于英伟达硬件与 CUDA 的封闭壁垒;
另一轨,则是中国基于华为昇腾、开源 CANN 以及顶尖大模型算法打造的软硬一体化全栈生态。
当 DeepSeek、通义千问等原生大模型在国产算力底座上迭代得越来越丝滑,这套“中国算力 + 中国模型”的组合拳,正展现出极高的性价比与供应链安全性。
科技历史总是充满了戏剧性的反讽: 那些曾经被用来封死门窗的铁板,最终却被被围困者拆下来,打造成了通往下一代工业革命的航母甲板。
这场算力大洗牌已经越过了临界点。接下来,当国产算力不仅能满足本土需求,开始向全球市场溢出时,硅谷又该拿什么来接招呢?