假设你想做一场社会实验,看看一场媒体宣传能不能扭转正在发酵的舆论。现实里,这个实验几乎没法做。你不能让同一群人把同一段经历再过一遍,一次投放宣传,一次什么都不做,然后比较两种结果。大模型驱动的社会模拟看上去提供了一条出路。智能体可以扮演真实人群,在模拟的社交平台上发帖、转发、改变立场。但真正用它来做研究,很快会碰到两个问题。
问题一:擅长单一时间步,长程推演失焦。大多数平台擅长的是「截面」:给一群智能体发一份问卷,看回答的分布像不像真实人群。可社会现象是在时间里慢慢演化出来的,研究者要的是在同一段历史的某个时刻插入干预,再和没有干预的那条历史做对比。
问题二:研究者意图难以过程性融入。越来越多的系统把整个研究流程交给智能体端到端完成,研究者只在最后看一眼报告。模拟跑偏了、设定有问题,人很难中途插手。
社会模拟能跑通一次,但真正的实验需求没有被满足。
来自上海创智学院、复旦大学、伦敦国王学院与牛津大学等高校的研究团队推出了 SocioVerse2,将模拟从横截面式的问卷调查扩展为一段可干预的纵向过程,把研究过程从跑一次出结果扩展为研究者可迭代的树状研究脉络,并把支撑这一切的人群、环境与工作流封装成一套开源的社会科学智能体基础设施。
-
论文地址:https://arxiv.org/pdf/2609.24911
-
代码仓库台:https://github.com/sii-research/SocioVerse2
-
项目主页与在线工作台:https://socioverse.fudan-disc.com/
跑通一次模拟,不等于完成一个实验
过去两年,LLM 社会模拟平台大致沿两个方向演进。
一个方向关于「人和 AI 怎么分工」。早期的沙盒由研究者手工搭建,信息怎么流动、谁和谁交互,全部事先写死。最近的一批平台走向另一端,把选题、建模、跑实验到写报告整条流程交给智能体。
另一个方向关于「模拟拿来干什么」。从验证模型能不能复现已知的群体行为,到追问一个从未发生过的条件会带来什么后果。
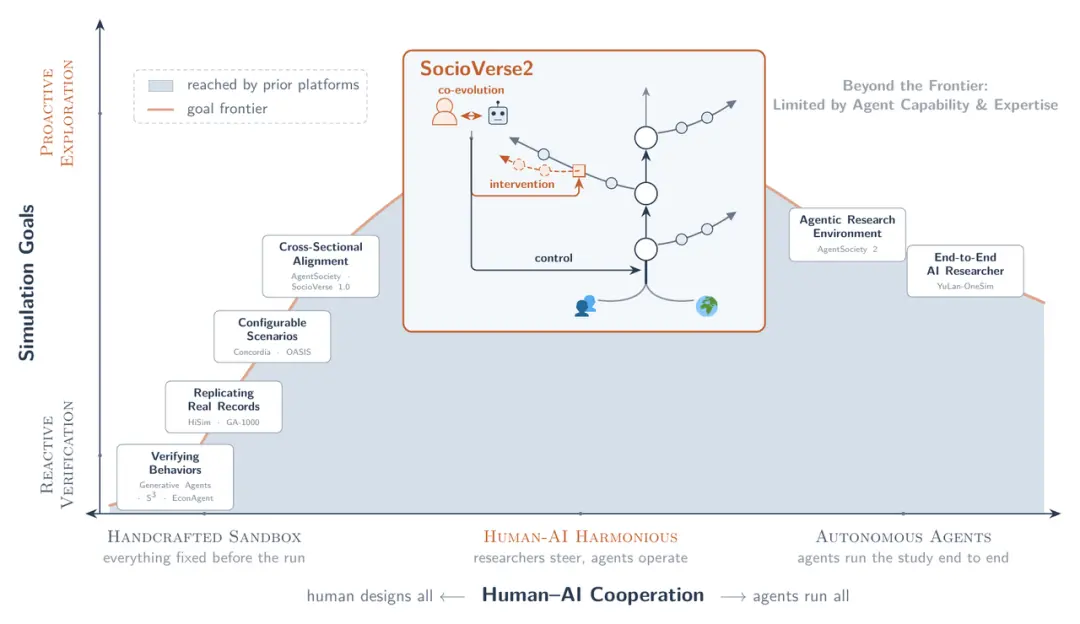
图 1|现有 LLM 社会模拟平台分布在两条轴上:横向看人与 AI 如何协作,纵向看模拟要回答什么问题。手工沙盒和全自动智能体分处两端,SocioVerse2 位于中间偏上的位置。来源:原论文 Figure 1。
问题出在全自动的那一端。对自主研究系统的一些深入分析表明,端到端跑完研究流程的智能体可能会编造结果、偏离自己声称的计划。反过来,人的介入效果很明显。多项研究发现,在研究流程的每个阶段加入研究者反馈,能显著提升智能体产出的研究质量,面向经济学等实证社会科学的系统也开始在关键节点设置人工决策关口。
研究团队据此提出,社会科学需要的不只是更自动化的社会模拟器,而是一种人和智能体一起演化的研究方式。
一棵研究树:两条回路和一套基础设施
SocioVerse2 沿用了 Lewin 场论的一个经典判断:一个人的行为,由这个人和其所处的环境共同决定。整套系统围绕「人群」和「环境」这两个可以独立替换的部分展开,再加上一个把两者映射成行为的「行为函数」。
在此之上,团队用一棵树来组织整个研究过程。
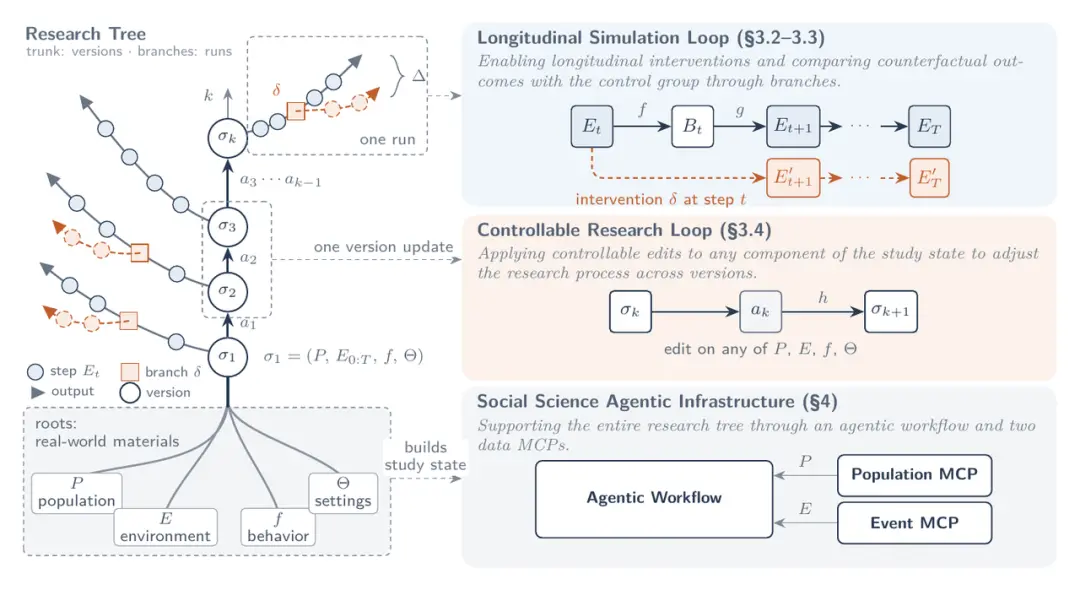
图 2|SocioVerse2 的整体框架,画成一棵研究树。树根是基础设施,负责把真实人群和真实环境数据装配成第一个研究状态。树干是研究回路,每一次修改让树干长高一节。树枝是模拟回路,每个版本长出一次逐步运行的模拟,干预会在枝上分出反事实分支。来源:原论文 Figure 2。
这棵树有三个部分,也对应 socioverse2 的三项贡献。
树枝是纵向模拟回路。同一群智能体在不断变化的环境中一步步行动,每一步的行为又改写下一步的环境。研究者可以在任意一步插入干预,让模拟分出一条反事实分支。
树干是可控研究回路。整个研究,包括用哪群人、什么环境、哪种行为模型、什么参数,被看作一个可以编辑的状态。研究者或智能体每提出一次修改,研究就进入一个新版本。
树根是社会科学智能体基础设施。一套技能化的研究流水线,加上两个提供真实人群和真实环境数据的服务,支撑上面两条回路。
在同一段历史上,分叉出实验组和对照组
先看树枝。
在 SocioVerse2 里,一次干预是写进环境设定里的一条声明:在第几步、对哪一部分环境、做什么操作。它可以是一次政策调整,比如某个街区新增了公交站,也可以是一条广播,比如一则只推送给部分人群的新闻。
干预在那一步所有智能体行动之前生效,并被记录在案。事后任何一条指标曲线的拐点,都能对照当时发生了什么。
更关键的是分支。SocioVerse2 用「回放」来生成分支:新分支的前若干步不重新调用大模型,而是直接读取父模拟已经记录下的每个智能体的每个动作,原样重演一遍。环境会走到完全相同的状态,每个智能体也带着完全相同的记忆,直到分叉点之后才开始各自决策。
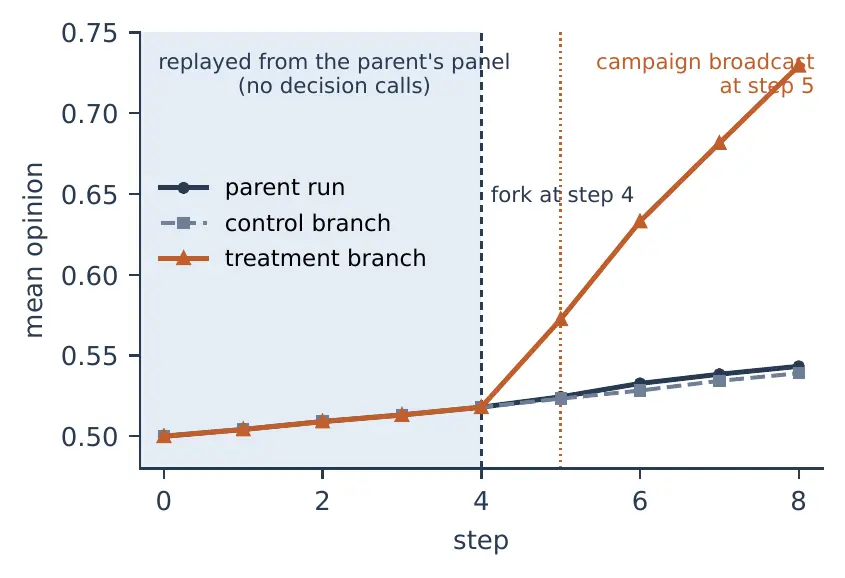
图 3|一个舆论扩散研究中的分支示例。两条分支通过回放共享前四步的历史,处理分支在第 5 步加入一次媒体宣传,对照分支保持不变。分叉之后两条曲线的差异,只能归因于这次宣传。来源:原论文 Figure 4(b)。
由于两条分支用的是同一群人、同一个行为模型、同一个随机种子,历史在分叉前完全一致,它们之间的差距就只能来自那次干预。这正是开头那个「现实里做不了」的实验。
同一套机制还有两个附带好处:已经跑完的模拟可以零成本地延长到更长的时间跨度,被中断的模拟也可以从断点继续。
研究者握着的不是否决权,而是编辑权
再看树干。
很多「人在回路」的设计里,人的角色是审批:智能体提出方案,人点同意或者否决。SocioVerse2 换了一个思路,让研究者拥有编辑权。
智能体可以根据上一轮模拟的结果提出修改,研究者也可以在任何阶段、对任何部分直接动手,形式可以是一句自然语言指令、一份补充材料,或者直接改代码。
论文把每一次研究过程的修改分成三类:(1)沿原研究设定继续实验,这保证了回路随时可以撤销;(2)只改环境,就得到了上一节说的分支,继承原模拟的全部历史;(3)其他任何改动,比如换一群人、换一种行为模型,都会生成一个全新的版本,从头运行,用来比较不同的研究设计。
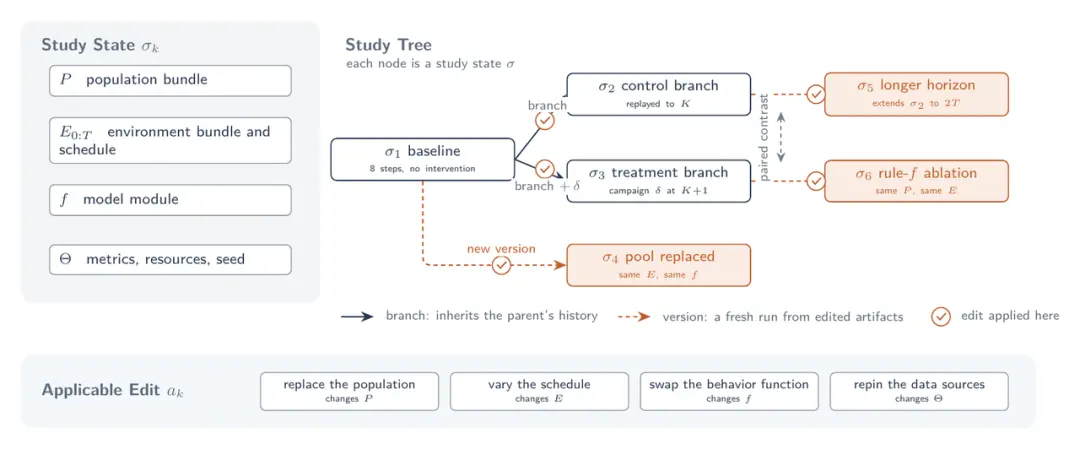
图 4|可控研究回路形成的版本树。每个节点是一个研究状态,编辑可以来自研究者,也可以来自智能体,每个版本都保存完整的工作区快照。来源:原论文 Figure 5。
每个版本都会完整保存当时的代码、数据、轨迹和报告,所以任何一个早期结果都能回溯、重跑。人群、环境和行为模型彼此独立,一项研究可以只动其中一项、其余保持不变,逐个排查到底是哪个因素在起作用。
5 个人口采样源和 21 类信号源,
变成随取随用的基础服务
最后是树根。
研究流程被拆成七个可复用的技能,从确认研究意图、搭建人群和环境、运行模拟,到撰写报告和迭代。每个技能完成后都会暂停,等研究者决定是否继续。研究者可以打开自动模式,但有四件事始终要回到人手里:新建研究前确认意图,修改已有研究时决定是新建版本、原地修改还是开分支,调用大模型前确认预期成本,以及使用需要逐次授权的数据服务。
数据则以两个标准化服务(MCP)的形式提供。
人群服务继承了 SocioVerse 1.0 的真实用户池,并额外接入了三个开放人群数据集,统一在一套人口学字段下。研究者给出目标人口分布,服务会跨数据源挑选、拼接、按分布加权对齐,对没有数据源覆盖的属性做带标注的补全,最后交付一群带稳定身份的研究对象。
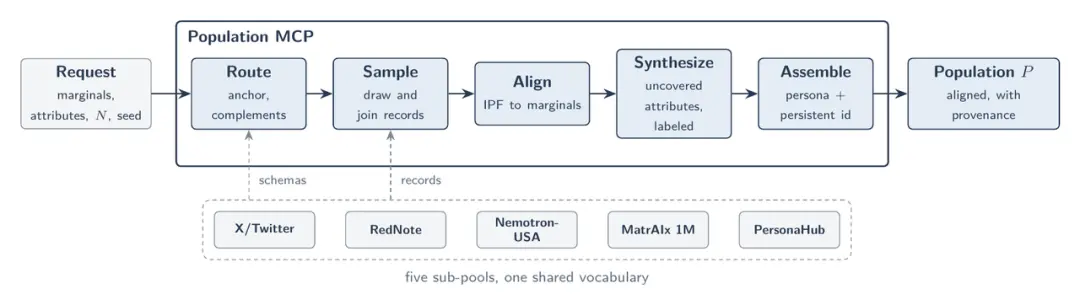
图 5|人群服务的一次调用流程:路由、采样、对齐、合成、装配。来源:原论文 Figure 7。
环境服务汇集了宏观经济、金融市场、新闻趋势和人口调查四类共 21 个数据源,并且保证「时点安全」:模拟到某年某月,只能看到当时已经公开的数据,杜绝提前偷看答案。这对后面的预测类实验至关重要。
七个案例:从复现 ABM 行为实验,
到宏观经济指数预测
论文用三组、共七个案例检验这套框架。值得一提的是,每个案例里的对照组和消融实验,本身就是研究树上的一个版本或一条分支。
先确认模拟本身靠得住。在谢林隔离实验、SIR 传播、鸟群动态等 10 个经典的基于规则的模型上,团队把手写规则换成大模型决策,三个大模型的一致性得分在 0.885 到 0.900 之间,而规则模型自己重复跑的一致性上限是 0.911。在社交媒体舆论案例中,300 个大模型驱动的核心用户配合 700 个规则驱动的普通用户,在全部 15 组对比里都比纯规则模型更贴近真实的舆论走势,而成本只随核心用户数增长。
再把模拟放进真实的政策场景。在芝加哥隔离案例中,19,235 个加权智能体在 781 个真实人口普查区上迁居。从被随机打乱 15% 的 2010 年格局出发,15 步之内黑人与白人的居住隔离指数从 0.716 回升到 0.782,普查真实值为 0.835,亚裔与白人的指数收敛到 0.435,几乎与普查值 0.434 重合。
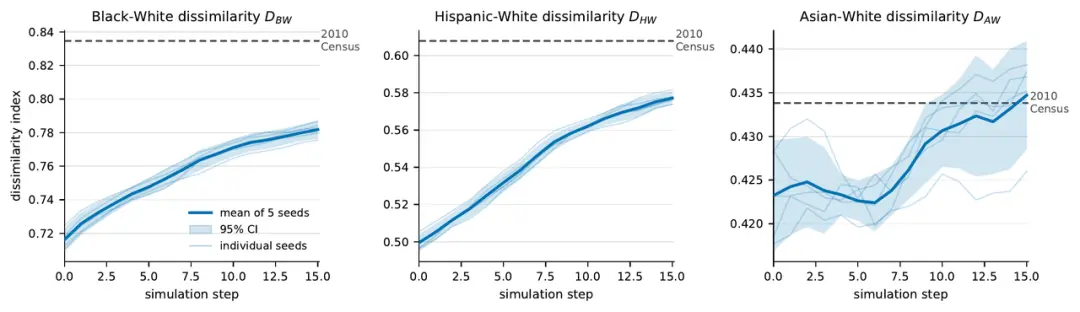
图 6|芝加哥三项居住隔离指数在 15 步内的变化,虚线为 2010 年普查值。来源:原论文 Figure 13。
药品集采案例把国家药品集中采购看作一场三方博弈:政府定规则,企业报价,医疗机构申报需求并执行采购。在 7 轮集采、325 个药品市场上,让三方同时学习策略,政府福利、企业利润和医疗机构效用的中位数同时提高,其中福利和利润比最强的仅企业建模基线分别高出 27.2% 和 33.9%。
最后,挑战还没有答案的问题。消费者信心案例用微观数据校准的 5000 户家庭扩展出 25 万户模拟人口,在美国、欧盟和日本 75 个月的回测中,全面领先 12 种传统预测方法,优势集中在疫情、通胀、俄乌冲突这类剧烈冲击的月份。采购经理指数案例让 300 家模拟企业按月填写问卷,在模型训练数据截止日期之后、它不可能"背过答案"的 32 个月里,对指数每月涨跌方向的判断准确率达到 58.6%,高于市场一致预期的 51.7%。
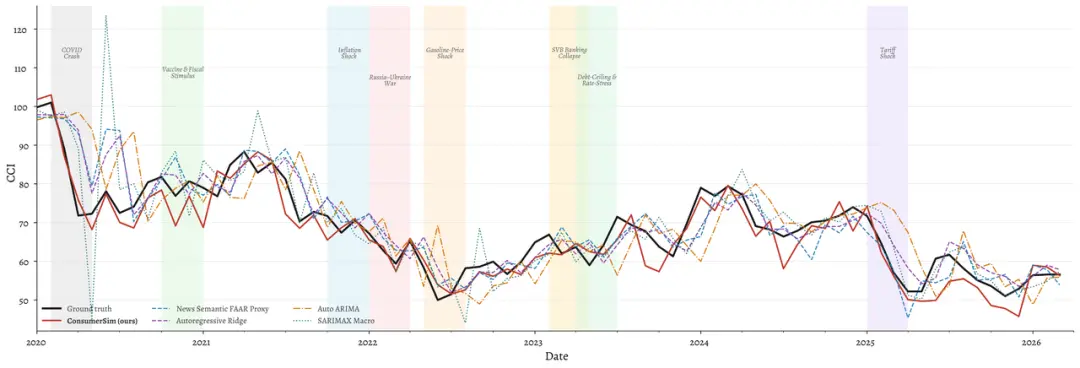
图 7|2020 年初到 2026 年 3 月,美国消费者信心指数的官方数值(黑线)、SocioVerse2 的模拟值与几种代表性基线。来源:原论文 Figure 15。
写在最后
SocioVerse2 想回答的,其实是一个关于分工的问题:当智能体已经能完成越来越多的研究步骤,人应该站在哪里。它给出的位置是研究树的树干。智能体负责跑模拟、查数据、写报告,研究者负责决定这棵树往哪个方向长。让研究者不仅仅是过程的旁观者,更是社会实验的导航员。SocioVerse2 的运行框架已经开源,并提供面向非计算背景研究者的在线工作台。欢迎各位体验!
© THE END
转载请联系本公众号获得授权
投稿或寻求报道:liyazhou@jiqizhixin.com