本文共同第一作者为戴美坡、庄启源、徐赫洋,通讯作者为东南大学青年首席教授魏秀参,研究方向为具身智能、计算机视觉与机器学习。本研究围绕机器人模仿学习与生成式动作策略,探索可学习源分布对机器人操作的作用。
在机器人模仿学习中,扩散模型与流匹配模型将动作生成建模为条件采样,从专家演示中学习动作分布,并通过迭代生成动作序列。这类策略已被用于抓取放置、工具使用与双臂协同等操作任务。
生成式机器人策略通常从与当前观测无关的标准高斯分布出发。A2A、VITA 等方法开始利用本体感知或视觉信息构造生成起点,但主要将起点视为确定性的估计,尚未显式建模其不确定性。这引出了一个问题:动作生成的起点应该是一个确定值,还是一个分布?如果是分布,其方差应该固定,还是随机器人状态变化?
针对这一问题,东南大学魏秀参团队提出 LeaP(Learnable source Prior),一种由本体感知信息驱动的可学习源先验。LeaP 联合预测初始高斯分布的均值与方差,为动作生成提供状态相关的随机初始化。在 RoboTwin 的 15 项仿真操作任务上,其平均成功率达到 81.6%,较采用相同编码器与生成器的标准高斯基线提升 25.5 个百分点。
相关论文已被机器人学习国际会议 CoRL 2026 接收,代码已开源。
-
论文标题:Where Should Action Generation Begin? A Learnable Source Prior for Generative Robot Policies
-
论文链接:https://arxiv.org/abs/2606.17408
-
项目仓库:https://github.com/SEU-VIPGroup/LeaP
-
项目主页:https://daimeipo.github.io/LeaP/
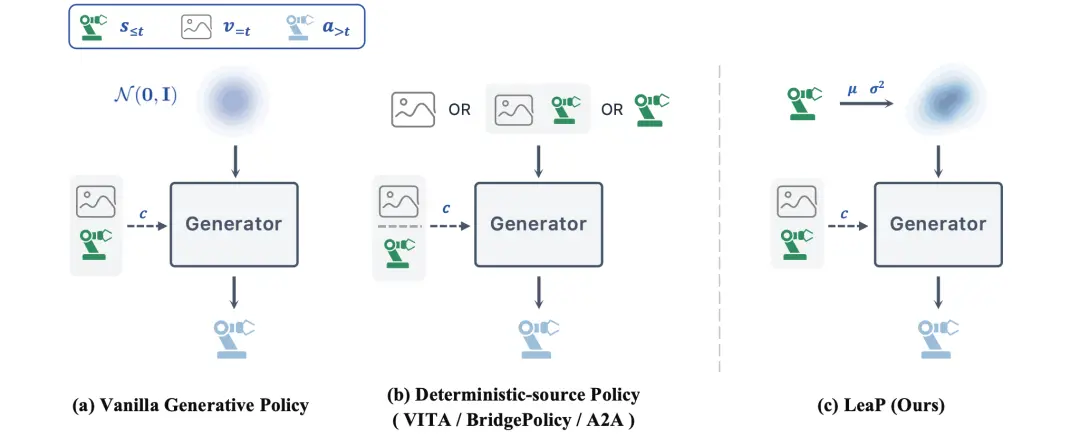
图 1|三种动作生成起点:标准高斯噪声、由观测确定的起点,以及 LeaP 学习的条件概率分布。
LeaP:面向动作生成的可学习源先验
LeaP 的核心设计是将固定的标准高斯源分布替换为本体感知条件下的对角高斯分布,联合学习其均值与方差。先验提供与机器人状态相关的随机初始化,生成器进一步结合视觉与本体感知信息细化动作。
具体而言,LeaP 将本体感知特征输入两层 MLP 先验头,输出均值与对数方差,构造对角高斯分布。均值决定初始样本的分布中心,方差控制各动作维度上样本的离散程度,两者共同随机器人状态调整。
实际采样时,模型将标准高斯噪声逐维缩放,再加上预测均值,得到生成起点。训练和推理都保留这一随机采样过程。一段动作的各时间步共享分布参数,但独立采样;细致的时序关系交给后续生成器学习。
先验仅接收本体感知信息,生成器则同时接收视觉与本体感知特征。两者分别承担初始分布建模与动作细化,使 LeaP 能够接入现有生成器,保持其架构和推理求解器不变。
训练采用三项联合目标:流匹配损失学习从源样本到专家动作的变换;负对数似然损失监督先验的条件概率分布;对比对齐损失在特征空间中建立源样本与配对专家动作的对应关系。先验与生成器通过这三项损失端到端优化。
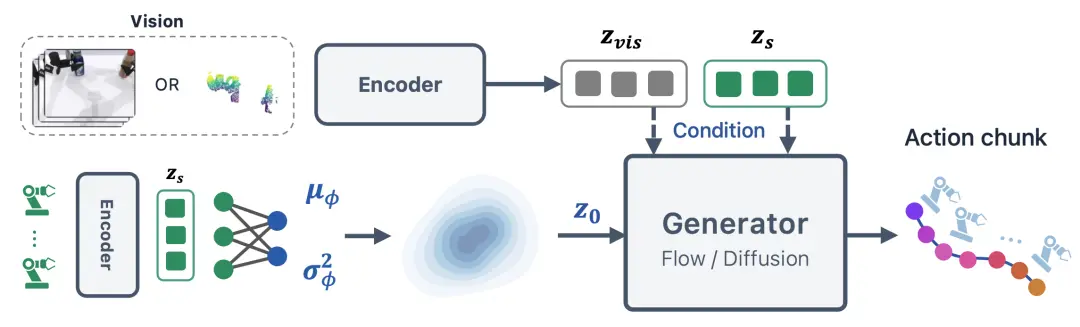
图 2|LeaP 框架:本体感知决定先验分布,视觉与本体感知共同指导动作生成。
实验结果与分析
团队在 RoboTwin 的 15 项双臂操作任务上检验这一设计,涵盖抓取放置、工具使用与双臂协同。每项任务使用 50 条专家演示,每个随机种子评估 100 次,最终报告 3 个种子的结果。各方法使用相同的 DP3 PointNet 点云编码器。
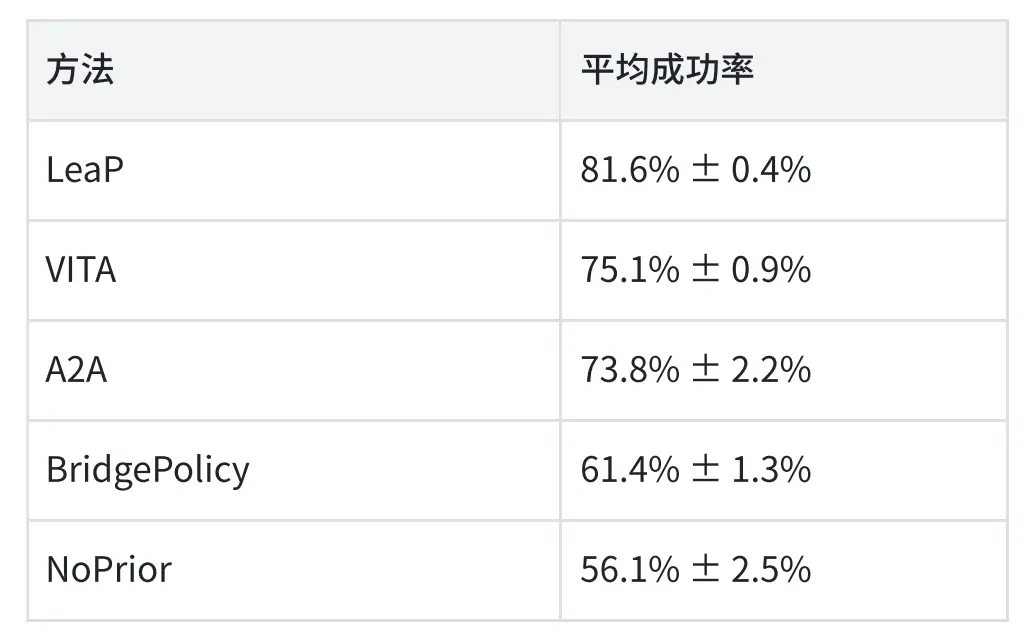
表 1|15 项任务的平均成功率,报告 3 个随机种子的均值与标准差。BridgePolicy 为本研究团队依据原论文复现的版本。
最直接的对照来自 NoPrior:它与 LeaP 共享编码器、生成器和流匹配流程,使用标准高斯起点。25.5 个百分点的差距体现了可学习先验及其训练机制的收益。LeaP 也高于使用确定性起点的 VITA 和 A2A,分别领先 6.5 和 7.8 个百分点。
在模型规模与训练效率方面,LeaP 总参数量为 13.22M,其中先验头约 0.21M,占总量约 1.6%。在打开笔记本电脑任务的实验中,LeaP 训练 1000 轮达到 91% 成功率,超过四个主要基线训练 3000 轮后的表现,展示了改善收敛效率的潜力。
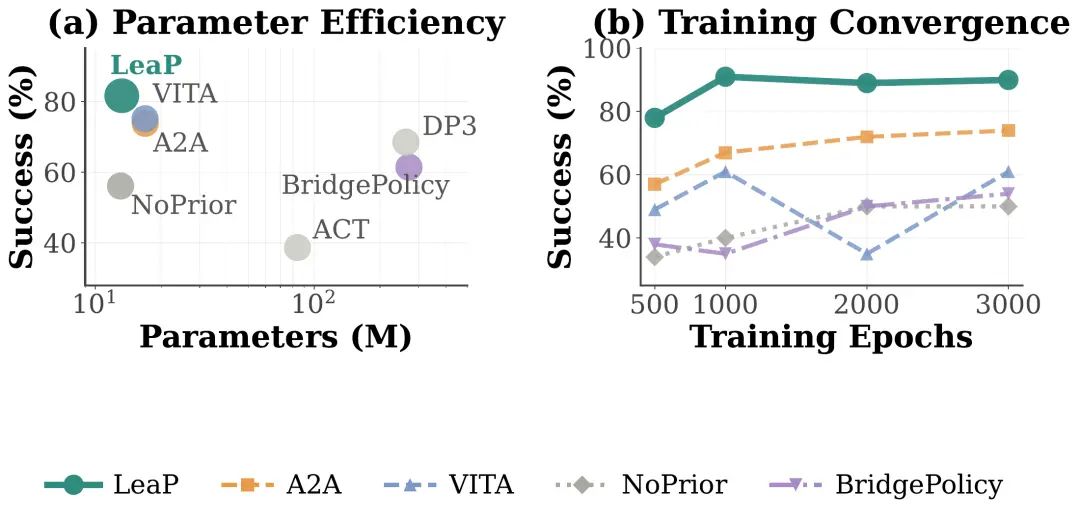
图 3|模型规模与训练收敛对比。左:各方法的参数量与 15 项任务平均成功率,包含 ACT、DP3 等方法;右:打开笔记本电脑任务中,各方法的成功率随训练轮数的变化。
这一趋势也出现在真实机械臂上。在 Franka Research 3 的抓取方块、关闭盒子、抓取并放置沙袋三项任务中,每项使用 100 条遥操作演示,并随机设置物体位置测试 20 次。LeaP 平均成功率为 80.0%,高于 A2A 的 68.3%、VITA 的 56.7% 和 NoPrior 的 46.7%;相较 NoPrior 提升 33.3 个百分点。
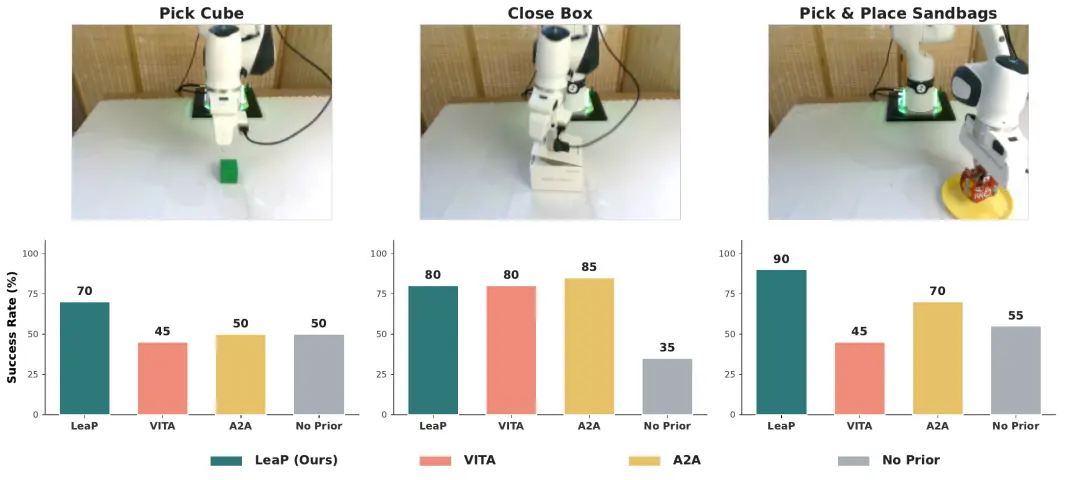
图 4|真实机械臂上的三项操作任务及各方法成功率。
消融实验:先验的输入、分布形式与训练目标
研究通过消融实验考察先验的输入、分布形式与监督目标。实验在抓取不同瓶子、打开笔记本电脑、交接方块三项 RoboTwin 任务上进行,每项任务评估 100 次。
先验应以什么信息为条件? 保持生成器接收的信息不变,仅调整先验的输入。仅用本体感知的 LeaP 平均成功率达到 85.3%,视觉及三种视觉与状态融合方案则为 59.3%—70.3%。三种融合方式均未带来提升,说明下降并非某一种融合方式特有的现象。源分布可视化进一步显示,本体感知先验将样本放在目标动作附近,而引入视觉特征的变体则容易偏离目标。这些结果支持论文中的分工:先验依据机器人状态确定与动作相关的起点,生成器再结合视觉信息细化动作。
先验应采用什么形式?所有可学习先验都优于标准高斯基线,但在这组实验中,表达能力更强的全协方差高斯和高斯混合模型并未超过 LeaP 的对角高斯。更关键的是一组三方对照:仅使用预测均值时,成功率为 78.0%;加入固定标准差为 1 的高斯噪声后,反而降至 62.7%;联合学习均值与状态自适应方差则达到 85.3%。这表明,仅有随机性并不够;相比直接加入固定幅度的噪声,学习与当前状态相适应的不确定性更为有效。
先验应接受什么监督?仅通过流匹配损失训练先验,平均成功率为 59.7%,高于无先验基线的 47.7%,但仍低于完整模型的 85.3%。可学习先验本身已有收益,显式监督则进一步改善了效果:去掉对比对齐或似然监督,成功率分别降至 74.7% 和 74.3%。似然损失监督先验对专家动作的条件密度建模,对比损失约束源样本与配对动作在特征空间中的对应关系,两者提供互补的学习信号。
跨生成器的通用性。同一先验使流匹配的平均成功率从 47.7% 提升至 85.3%;在扩散桥中,相比采用先验均值的确定性起点,完整 LeaP 分布将成功率从 68.7% 提升至 76.7%。前者展示了替换标准高斯源的整体收益,后者表明,在已有状态相关均值的基础上,学习状态自适应方差仍能带来提升。这支持将源分布作为可复用的设计模块,与生成器设计相互补充。
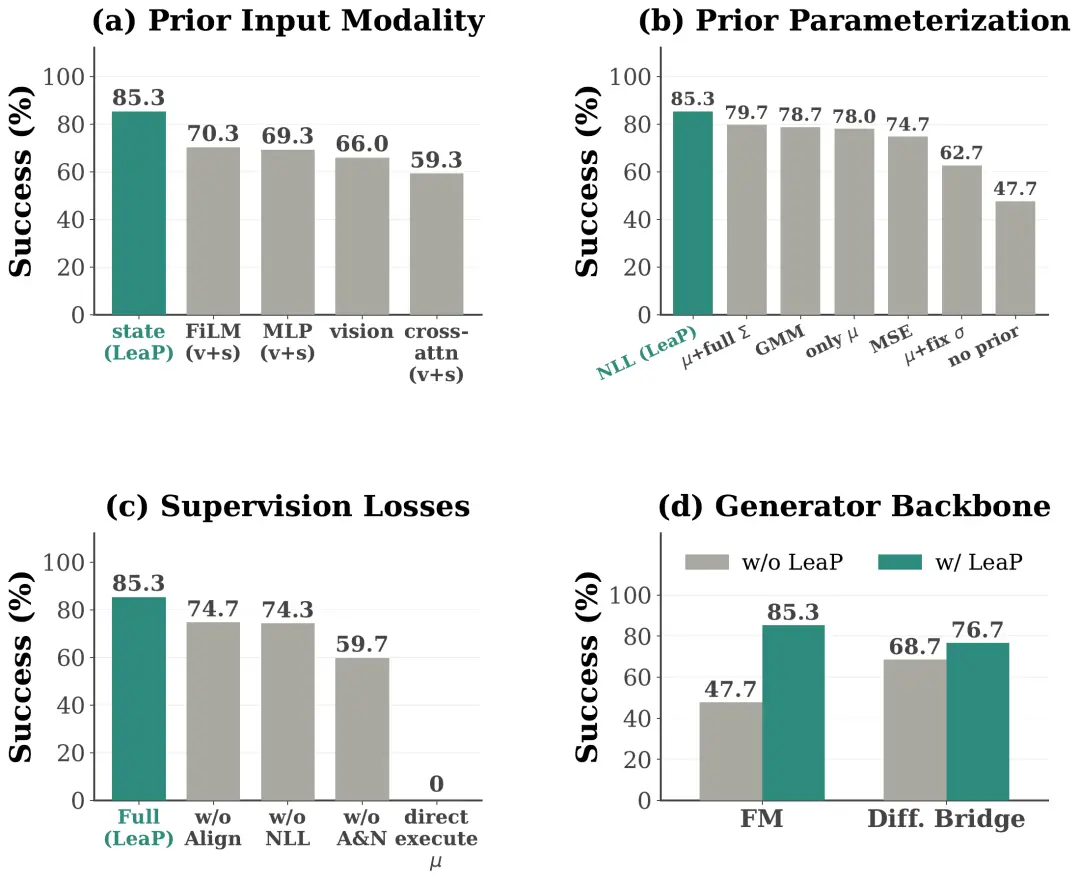
图 5|先验输入、分布形式、训练监督与生成器类型的消融结果,报告三项任务下的平均成功率。
总结
LeaP 将源分布纳入生成式机器人策略的设计,通过轻量网络联合学习状态相关的均值与方差,为动作生成提供可学习的随机初始化。仿真、真实机械臂和跨生成器实验验证了这一设计的有效性。目前的验证集中在桌面操作,对角高斯也未显式建模动作维度之间的相关性;更复杂的先验形式与机器人形态仍有待探索。
© THE END
转载请联系本公众号获得授权
投稿或寻求报道:liyazhou@jiqizhixin.com