给定一个基座模型、一个目标能力和算力预算,RSI Agent 自己设计后训练算法、收集和整理数据、写代码、跑实验、迭代改进,最终交出一个训练好的模型,全程无人介入。在自主后训练基准 PostTrainBench 上,它以 46.6 分排名第一,超过所有前沿模型与 Agent 系统,接近人类专家表现(51.1)。
近日,AIBuildAI 团队发布了 PostTrain Agent,一个用于自主后训练大语言模型的递归自我改进(RSI)Agent,并开源了全部代码与配套知识库。
-
开源地址:https://github.com/aibuildai-inc/aibuildai-llm-posttrain-agent
-
知识库:https://github.com/aibuildai-inc/aibuildai-knowledge-base
-
技术报告:https://github.com/aibuildai-inc/aibuildai-llm-posttrain-agent/blob/main/docs/aibuildai-llm-post-train-agent.pdf
为什么需要自动化的后训练
后训练(post-training)是把一个基座模型变成能遵循指令、会推理、会用工具、懂某个领域的模型的过程——也是一家公司把通用模型变成「自己的模型」的方式。它涉及的决策不少:用什么数据、怎么配比;用监督微调(SFT)、偏好优化还是强化学习;学习率、训练步数、最后交付哪个 checkpoint。
这些决策彼此耦合:合适的算法取决于数据配比,有效的数据配比又取决于基座模型。交付一个后训练好的模型,往往要一个有经验的团队花上数周,每次实验还要消耗可观的算力。AIBuildAI PostTrain Agent 研究的问题是:能否把这件事完全交给 AI——输入基座模型、目标能力和算力预算,Agent 自己完成后训练的全部流程,输出一个后训练好的模型。
PostTrainBench:给 Agent 的一道考题
PostTrainBench(Rank et al., ICML 2026)把这个问题做成了一个基准:给定基座模型(如 Qwen3-4B-Base)和目标能力(如工具调用),Agent 在单张 H100 上、10 小时内自主设计并执行后训练方案,产出的 checkpoint 在基准方持有的、Agent 看不到的评测集上打分。基准覆盖 4 个基座模型和 7 类任务:数学推理(AIME 2025、GSM8K)、写作(ArenaHard Writing)、通用问答(GPQA)、健康咨询(HealthBench)、代码(HumanEval)和函数调用(BFCL)。
用哪些外部数据、怎么混合,用监督微调、偏好优化还是强化学习,超参数和训练框架——全部由 Agent 自己决定。
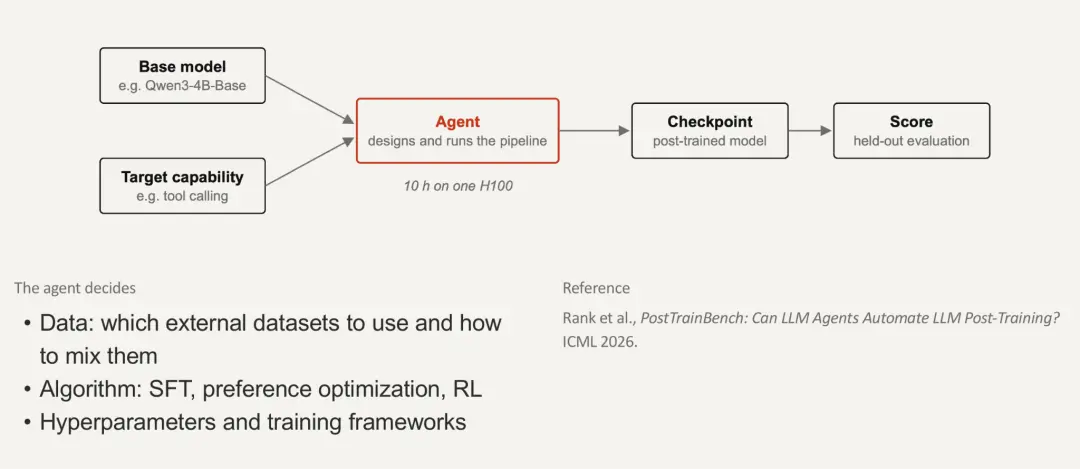
图 1|PostTrainBench 的任务设定:输入基座模型和目标能力,Agent 在单张 H100、10 小时内自主设计并执行后训练,产出的 checkpoint 在 Agent 看不到的评测集上打分。
从一条线到一棵树
榜单上的基线做法,是把一个编码 Agent(如 Claude Code)直接指向这个任务:一个会话、一个 CLI 环境,给它基座模型、数据、GPU 和评测器,让它自己规划、写代码、训练、评估。这样的 Agent 是线性搜索的:每次尝试都是在修改上一次,方案很早就定下来,之后一路跟着走;几个截然不同的思路无法并行探索,一条已经走不通的方向会把剩余预算全耗掉。它的数据、方法和超参数选择也只来自模型自身的参数化知识。
AIBuildAI 此前的系统(AIBuildAI Science、AIBuildAI-2.5)用的是整实验树搜索:一次运行是一棵实验树,每个节点是一次完整的实验,由任务自己的评测程序打分,运行的价值就是树上的最高分。「设计员」Agent 播下若干条刻意互异的起始方案,每条方案是一个分支的根;「实验员」Agent 端到端地跑完一个实验并提出几条修改,成为子实验;「选择器」按预期收益、证据、新颖性和成本给等待 GPU 的候选实验排序。
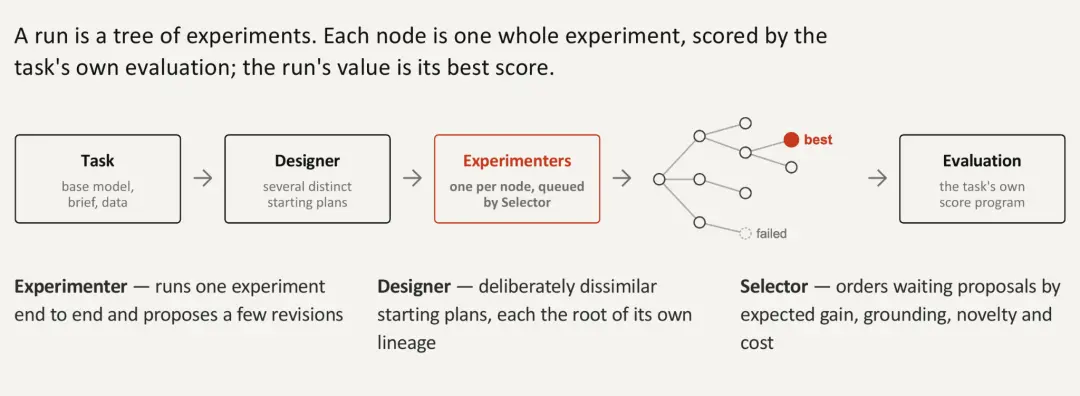
图 2|整实验树搜索:设计员给出若干互异的起始方案,实验员逐节点完成整个实验并提出修改,选择器为候选排序;每个节点由任务自己的评测程序打分。
但直接把这套流程搬到后训练上,暴露出两个限制:一是它不懂这个领域——实验员只能凭语言模型内部知识作答,典型错误包括选了没有任何库实现的方法、用了和评测集重叠的数据集、套用了另一种模型规模的超参数,每个错误都要花一整次训练才能发现;二是它在了解任务之前就定死了搜索的拓扑——树的每个节点都必须是一个打过分的模型,而「生成数据」这样的阶段没有分数、做不了节点;把不同节点里训练好的几个模型合并成一个(fan-in),树搜索也表达不了。针对这两个问题,新系统引入了两个核心组件:知识系统和元搜索。
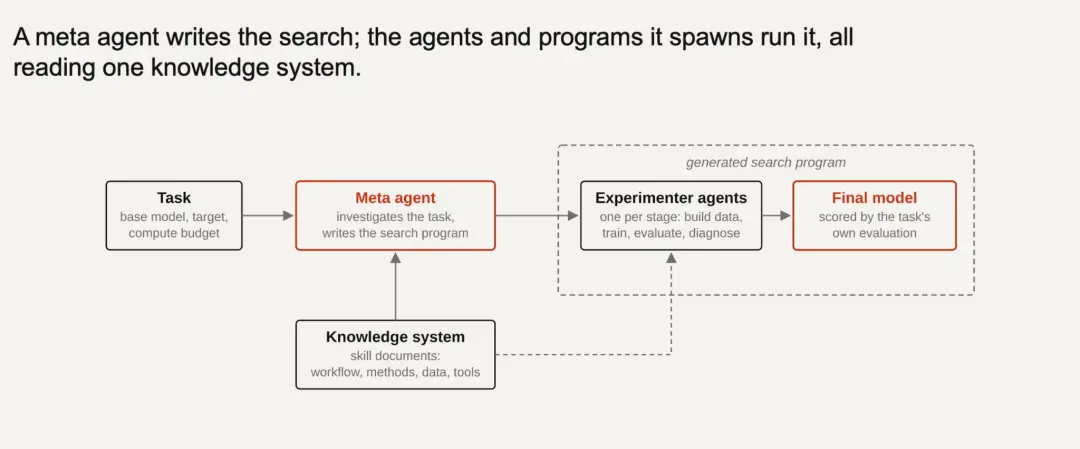
图 3|AIBuildAI PostTrain Agent 系统总览:元 Agent 调研任务并写出搜索程序,由它派生的实验员 Agent 和程序负责执行,所有 Agent 共用同一套知识系统。
知识系统:让 Agent 依据证据而非记忆做决策
AIBuildAI PostTrain Agent 的知识系统是一个通过 MCP 提供服务的远程检索知识库,里面是一套「知识文件」,分四个子库:工作流(一次后训练运行的 13 个有序步骤、34 份文件,每步说明要落定的判断、一个具体案例和它的适用边界)、方法(111 份文件:监督微调、DPO、GRPO、蒸馏等,各自需要什么、花费多少、有哪些参数和默认值)、数据集(215 份文件:许可证、切分、加载代码、样本行,并标出哪些是评测基准、必须隔离)、框架(108 份文件:何时选它、如何启动、监控和保存一次训练)。
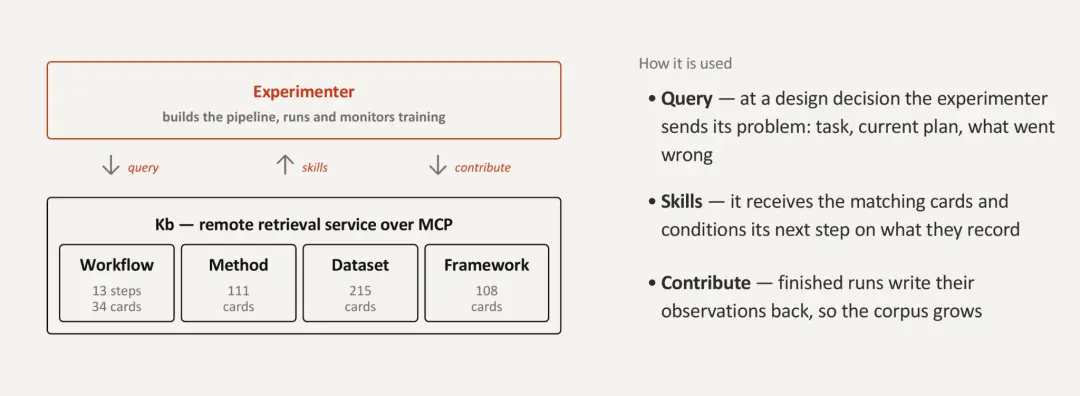
图 4|AIBuildAI PostTrain Agent 知识系统:实验员带着问题查询知识库,取回匹配的知识文件,并在实验结束后把观察写回。
每份知识文件都从公开来源(论文、库代码、Hub 上的数据集说明、公开训练记录)收集,经人工确认范围、检查许可和切分、从代码中实测事实后,按统一模板写成,每条声明都带 URL 和日期;任何提到评测基准的文件都会被剔除出语料。实验员在面临设计决策时,把「任务、当前方案、哪里出了问题」发给知识库,拿回匹配的知识文件,据此决定下一步;跑完的实验也会把观察写回,知识随之增长。
这些文件记录的不是教程,而是可以直接据以行动的判断。以工作流的第一步为例,它要求 Agent 在选任何数据之前先读懂「分数到底奖励什么」:评分看的是最终答案还是整段回复,格式错误是否直接记零分,推理过程有没有分;然后在未经训练的基座模型上完整跑一次官方评测器——得到的数字才是基线,跑一次的耗时则是后面分配预算时的「单次评测成本」。方法文件则给出每种方法的适用条件、目标函数、一个带数字的算例、需要的数据形态和额外模型,以及哪些库提供了现成实现。
元搜索:搜索的拓扑本身成为 Agent 的输出
不同的任务需要不同形状的搜索。线性搜索适合方案已定、只需反复打磨同一种方法流程的情形;树搜索适合有几种可信思路、只能靠证据取舍的情形。但后训练里常见一种两者都表达不了的结构。
以一个典型方案为例:先准备两份训练数据——任务自带的训练集和一份从公开语料构建的外部数据集——在基座模型上各做一次监督微调,用验证集选出更好的模型作为「当前最优」;然后进入强化学习阶段:每一轮都从当前最优出发做一轮 GRPO 训练,训练完在验证集上打分,只有分数确实提高才用新模型替换当前最优,否则丢弃,如此反复,直到预算不够再跑一轮。
这个方案是树搜索放不进去的:树的每个节点都必须是一个训练完、打过分的模型,而「构建外部数据集」这一步只产出数据,没有模型也没有分数,做不了树上的节点。
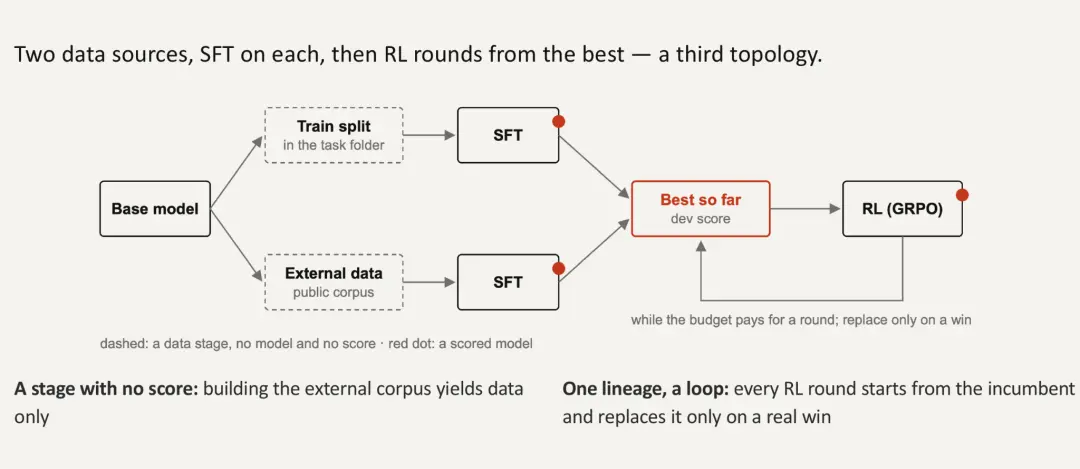
图 5|一个线性搜索和树搜索都表达不了的后训练方案。虚线框是只产出数据、没有模型也没有分数的阶段,红点表示打过分的模型。
AIBuildAI PostTrain Agent 的解法是元搜索:先派出一个元 Agent,它调研任务、阅读设计知识文件(37 种带可运行示例的搜索模式:链式、扇出/扇入、循环、分阶段流程,以及 checkpoint 锦标赛、监督微调接 GRPO、预算约束的多轮训练等后训练专属策略)、查询知识库,然后写出一个搜索程序。程序的每一步可以是 LLM Agent、确定性程序或嵌套的子搜索,整体可以是任何执行图——阶段、锦标赛、扇入、循环。上面那个案例写成程序不过几行:两路监督微调、取优、在预算允许时循环 GRPO。
搜索程序由三种基本单元组合而成:Agent 是一个带工具和类型化输出的 LLM 会话,Program 是在独立资源限制下运行的确定性计算,Search 则把 Agent、Program 和嵌套的 Search 编排在一起。37 种模式是词汇表而不是白名单,元 Agent 可以组合、改造,也可以写出目录之外的结构。
搜索程序也不必在开跑前把整次运行定死:元 Agent 可以只写当前阶段的程序——构建一份语料,或一轮训练加评估——执行完后读取剩余预算,交给下一代元 Agent 根据实测结果写下一阶段。运行的结构由此一个阶段一个阶段地、基于实测而非事前预测来决定。

图 6|元搜索:元 Agent 阅读任务与设计知识文件、查询知识库,写出由 Agent、Program、Search 三种基本单元组成的搜索程序。
实验分析
所有实验都遵循 PostTrainBench 榜单的设定:每个任务在单张 H100 上全自动运行 10 小时,全程无人干预;AIBuildAI 的所有 Agent 角色均运行在 Claude Opus 5 上,所有结果都由元搜索产生。对比数字取自 PostTrainBench 公开榜单。
综合得分:超过所有前沿模型与 Agent 系统
在 PostTrainBench 上,AIBuildAI PostTrain Agent 的加权综合得分为 46.6,高于所有前沿模型和 Agent 条目,仅次于人类专家基线的 51.1。榜单上紧随其后的是 Locus(45.6)和运行 Claude Fable 5 的 Claude Code(41.8),再往后是 GPT-5.6(36.2)、Claude Opus 5(35.0)、Claude Opus 4.8(33.8)、Kimi K3(32.0)、GLM-5.2(31.7)、Gemini 3.1 Pro(22.0)等。未经任何训练的基座模型平均只有 7.5 分——也就是说,Agent 在 10 小时内把综合得分提高了约 39 分。
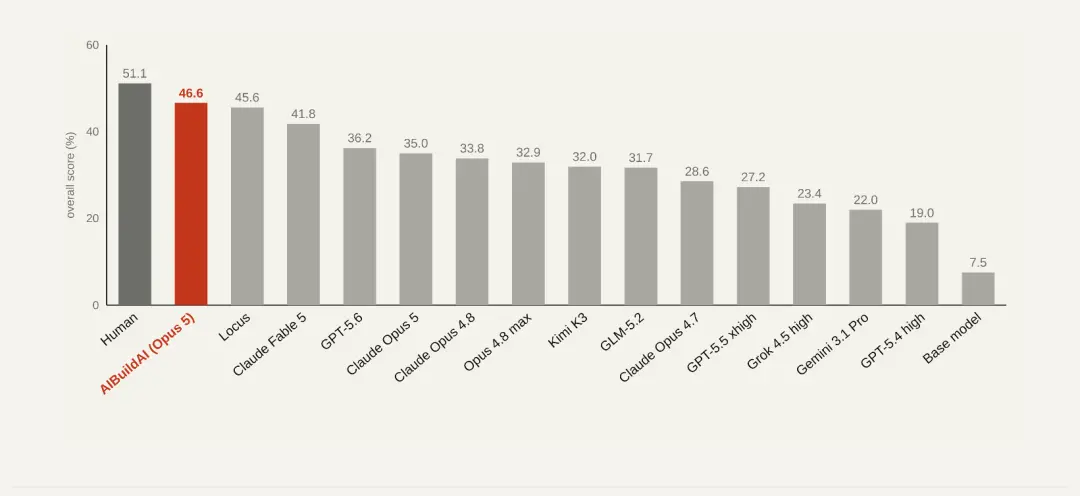
图 7|PostTrainBench 综合得分。综合分是七项任务的加权平均(AIME 2025 22.7%、GPQA 22.5%、HealthBench 18.4%、HumanEval 10.6%、GSM8K 9.4%、ArenaHard Writing 9.0%、BFCL 7.5%),每项任务取 4 个基座模型的均值。Human 为各基座模型官方发布的指令微调版本,不受 10 小时预算限制。
同一个底层模型,换一套系统:+11.6 分
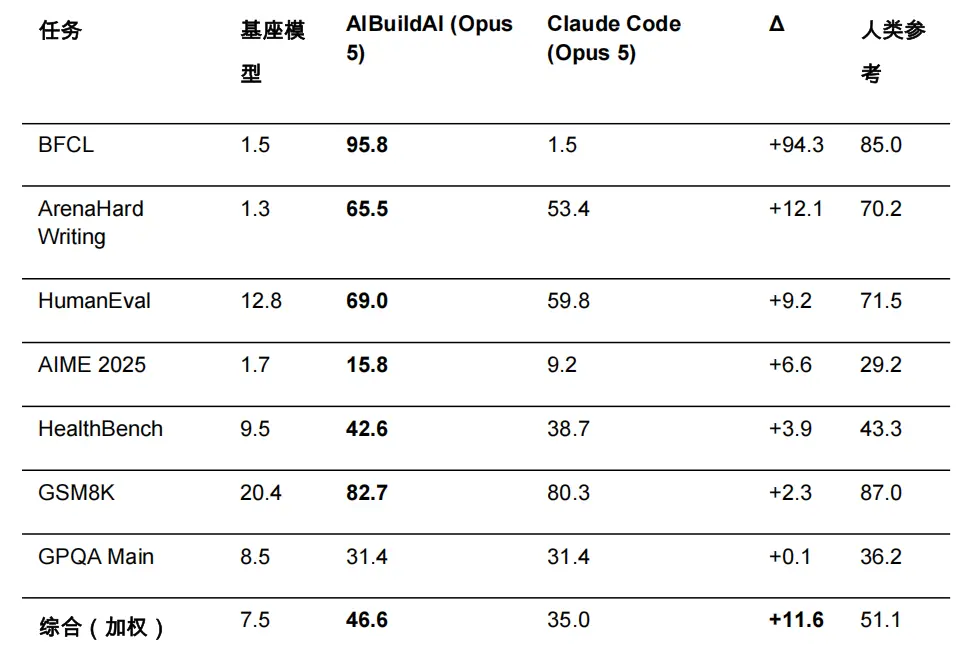
各任务为 4 个基座模型的均值。Δ 为 AIBuildAI 与 Claude Code 之差,二者均运行 Claude Opus 5。
一个更能说明系统本身价值的对照是:AIBuildAI 的全部 Agent 角色都运行在 Claude Opus 5 上,而同样运行 Opus 5 的 Claude Code 只有 35.0 分——相差 11.6 分,来自系统而非模型。分任务看,AIBuildAI 在七项中的六项领先,GPQA 持平。
提升最大的三项是 BFCL(+94.3)、ArenaHard Writing(+12.1)和 HumanEval(+9.2)。值得注意的是,AIBuildAI(Opus 5)的 46.6 也高于运行更强模型 Claude Fable 5 的 Claude Code(41.8):知识系统与元搜索带来的增益,超过了把底层模型升级一代所带来的增益。
分任务分析:三项任务取得 Agent 最高分,其余四项与领先者相差不到两分
与榜单上的全部 Agent 相比,AIBuildAI 在 AIME 2025(15.8,其后为 Claude Fable 5 的 13.3 和 Locus 的 9.4)、BFCL(95.8)和 HumanEval(69.0,Locus 为 66.6)三项上取得最高分;在 ArenaHard Writing、GPQA、HealthBench 和 GSM8K 四项上,与各自领先者的差距都在两分以内。
这些差距背后是不同的机制。BFCL 按函数调用能否被正确解析、是否符合给定的 schema 计分,格式稍有不符即记零分:同样运行 Opus 5 的 Claude Code 平均只有 1.5 分,与未训练的基座模型持平;AIBuildAI 借助知识系统选对了训练框架和格式匹配的数据集,在四个基座模型上的得分全部不低于 94,平均 95.8,也是七项任务中唯一超过人类参考(85.0)的一项。
ArenaHard 是成对偏好评判,本质上是选哪个偏好语料的数据选择问题。AIME 的答案可验证,「采样—验证—重训」是一个循环,正是元搜索的用武之地;它在综合分中权重最大,也是所有 Agent 距人类参考最远的一项,AIBuildAI 在每个基座模型上都取得了最高或并列最高的 Agent 得分,包括最难的 gemma-3-4b-pt(3.3 分,其他 Agent 均不超过 1.1)。HumanEval 上,AIBuildAI 在全部 4 个基座模型上都是 Agent 最高分。HealthBench 用的是医生撰写的评分标准,需要一套不让评判者奖励冗长回答的偏好优化流程。
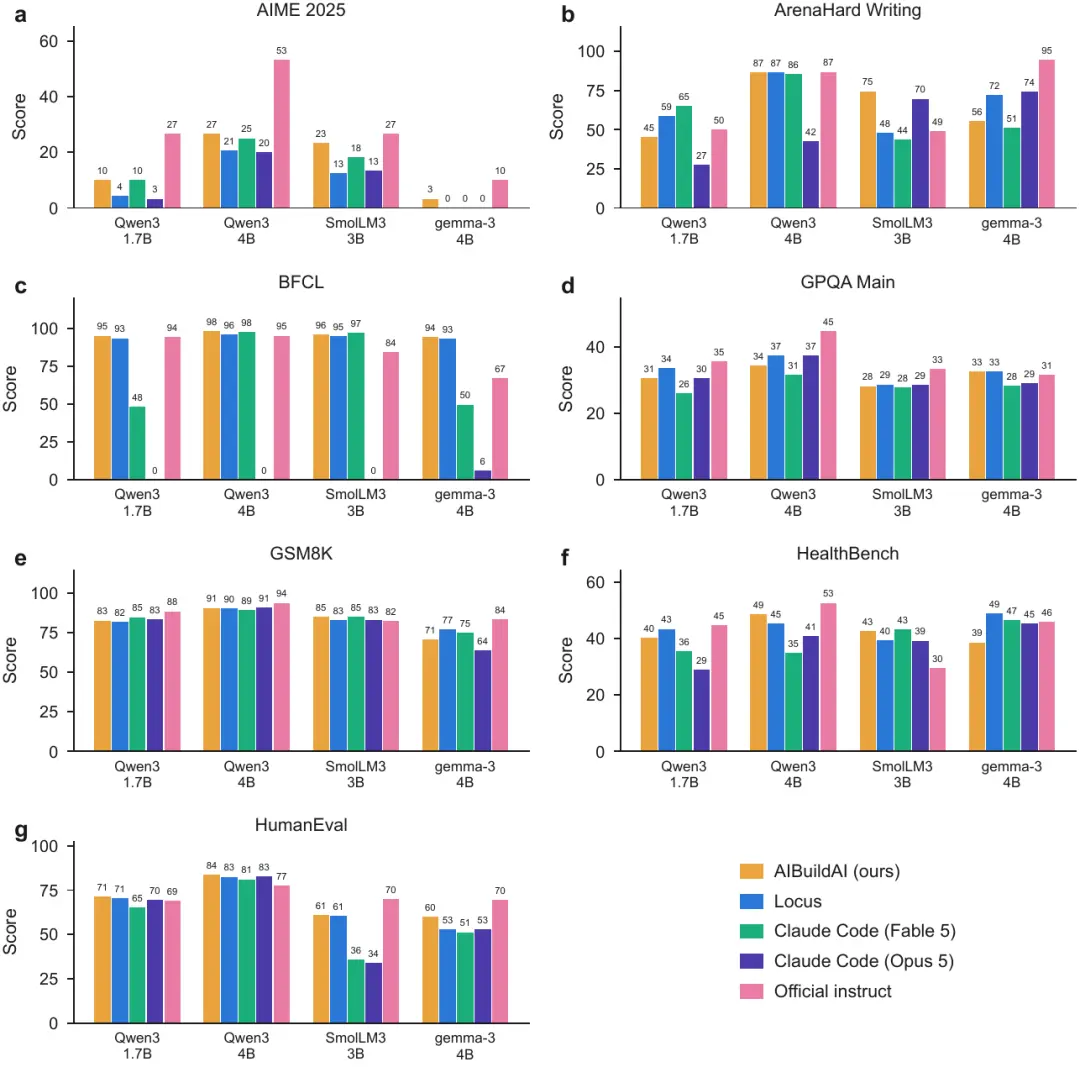
图 8|七项任务在 4 个基座模型上的逐项得分。Official instruct 为各基座模型官方发布的指令微调版本,是参考而非参赛的 Agent。
两个案例:Agent 如何一步步把分数做上去
两个案例中,Agent 都在运行自己的那张 GPU 上部署了一个开源权重的教师模型来写训练数据,并且一次只规划一个阶段、依据实测结果决定下一步。
HealthBench × Qwen3-4B-Base(基座 13.4 → 48.6,Claude Code 为 40.9):先让教师模型写出约 4.8 万条回复,在其上做监督微调,得到 46.2 分;再让教师模型写约 6,800 段更长的多轮对话继续训练,在小子集上筛选候选、在完整评测集上确认,达到 48.6 分。
ArenaHard Writing × SmolLM3-3B-Base(基座 0.4 → 74.6,Claude Code 为 69.7):先在约 2 万条教师撰写的语料上做监督微调,并对最后三个 checkpoint 做权重平均,得到 74.2 分;再做一轮拒绝采样——从学生模型自己的回复中挑出被教师评为最优的继续训练——再次平均后达到 74.6 分。
两次运行中,绝大部分增益都来自在教师数据上的第一轮完整训练;此后每个阶段的结果,只有在完整评测集上确认有效才会保留。
元 Agent 写出的搜索程序长什么样
以 AIME 2025 × Qwen3-1.7B-Base 为例。元 Agent 动手写程序之前先做了调研:未经训练的基座模型只有 20% 的回复会给出评测器要求的答案行,23% 的题目一直生成到长度上限也不结束;给两个格式示范,答案行比例升到 73%,准确率却完全没有变化。
元 Agent 据此判断格式不是瓶颈,真正待解的问题是一个 1.7B 的模型能学会多长的推理链,并写出了一个五阶段的搜索程序:在 CPU 上并行构建短、中、长三种思维链长度的语料,同时在 GPU 上保存并评测基座模型,以确立基线和单次评测成本;每份语料各做一次小预算的试训;由一个策略 Agent 读取基线、三次试训和语料筛查的结果,决定主训练用哪份语料、是否从试训的 checkpoint 续训、要不要第二阶段;随后是主训练;最后是可选的第二阶段(续训、长度退火、拒绝采样微调或 DPO 四选一)。
整个程序共 471 行 Python、8 个文件(1 个搜索编排器、5 个 Agent 角色、2 个确定性程序),全部由元 Agent 在任何训练开始之前的一次会话中生成。
总结与展望
AIBuildAI PostTrain Agent 表明,大模型后训练正在从「由人类专家操作工具」,迈向「由AI自主完成研发闭环」。在底层模型同为 Claude Opus 5 的条件下,AIBuildAI 以 46.6 分显著领先 Claude Code 的 35.0 分,在七项任务中六项领先、一项持平,并将与人类专家参考(51.1)的差距缩小到不足 5 分。这说明,决定 Agent 能力上限的不只是底层模型本身,还包括它能否基于可靠知识进行决策、能否设计适合任务的搜索结构,以及能否从实验结果中持续学习和调整。
更重要的是,PostTrain Agent 所自动化的并非某个固定训练流程,而是完整的模型研发过程:理解目标、研究任务、准备数据、设计算法、编写代码、运行训练、评估结果,并根据实验反馈重新制定下一阶段方案。在这一过程中,AI 不再只是执行人类预先写好的训练配方,而是开始自主提出假设、构建实验、分析证据并迭代改进。这正是递归自我改进(RSI)在模型研发场景中的一种具体实现。
从更长远的角度看,自动化后训练只是起点。同样的范式可以进一步覆盖预训练、数据生成、模型架构设计、推理优化、评测、安全对齐与部署,最终形成一个能够自主设计、训练、验证和持续改进 AI 模型的研发系统。人类只需定义目标、约束与价值标准,AI便能在给定资源下搜索实现这些目标的最佳模型和算法。
当模型能够参与改进下一代模型,AI 研发将不再完全受限于人类专家的时间、经验和试错速度,而可能演化为一个由机器规模化执行、由实验反馈持续驱动的过程。AIBuildAI 希望构建的,正是这样的 AI 研发基础设施:让 AI 自主研发 AI,并把模型创新从少数顶尖团队才能完成的复杂工程,转变为任何组织都可以调用的能力。
参考文献:
[1] AIBuildAI LLM-Post-Train Agent: an agent for autonomous post-training of large language models. AIBuildAI Team, 2026.
[2] PostTrainBench: Can LLM Agents Automate LLM Post-Training? Rank et al., ICML 2026.
[3] AIBuildAI: An AI Agent for Automatically Building AI Models. Ruiyi Zhang, Peijia Qin, Qi Cao, Li Zhang, Pengtao Xie, 2026. ttps://arxiv.org/abs/2604.14455
[4] AIBuildAI-2: A Knowledge-Enhanced Agent for Automatically Building AI Models. Ruiyi Zhang, Peijia Qin, Qi Cao, Li Zhang, Pengtao Xie, 2026. https://arxiv.org/abs/2605.27873
© THE END
转载请联系本公众号获得授权
投稿或寻求报道:liyazhou@jiqizhixin.com