现如今大模型生成报告越来越流行,然而幻觉问题始终影响着报告的可信度。现有方法经常通过 prompt 叮嘱模型小心,或者写完后用幻觉检测查一次。然而,有一种错误这些检查很难查到:数字填写正确,Claim 是错的。例如说大于写成小于,可能写成显著,这些错误不是后测可以检查的。
上述错误尤其发生在输入文本中数字非常多的情况下,这种输入包含一堆数字输出是一段人话,一般叫做统计文本生成。例如临床总结、报告生成和 AI 审稿。
本文提出 Claim-Locked Reportiing 用于解决此类问题,保证输出报告的重复率和可信度。

-
论文标题: Provenance Before Prose: Claim-Locked Reporting for Statistical Text Generation
-
录用信息:EMNLP 2026 Main Conference
-
预印版地址:https://arxiv.org/pdf/2608.25336
作者樊潇,主要研究方向为 AI4Neuroscience、Agent 和图像信号处理。
今年 EMNLP 官方开展了 AI 审稿实验。作者团队收到的 AI 审稿意见里,出现了两个很有代表性的问题:
-
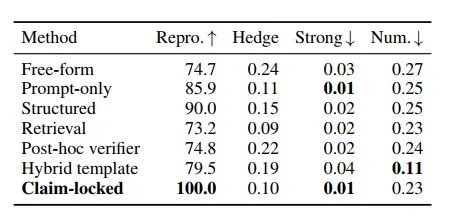
方向反了:85.9% 和 79.5%,审稿意见写成了 85.9%「略低于」79.5%;
-
强度升级:我们说「观察到提升」,审稿意见却写成「证明了…… 是必要的」。
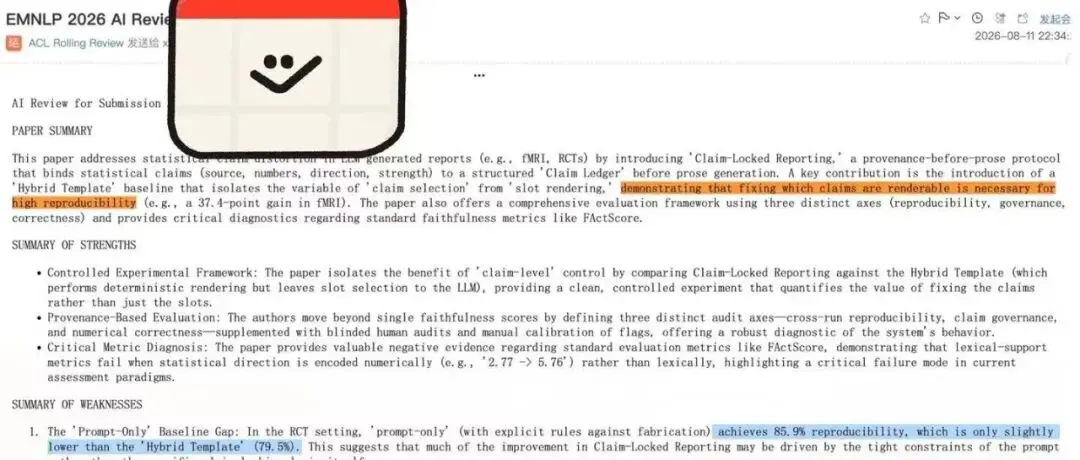
数字抄对了,意思却变了。
仔细想想,审稿中评价实验结果的部分,也在做统计报告生成:读一篇满是数字的论文,再把这些结果组织成评价。它不仅要记住数字,还要保留数字之间的关系,以及这些结果究竟能支持多强的结论。
这正是这篇论文关注的问题:数字都有出处,不代表整句话就说对了。
现有指标为什么会漏掉这类错误?
团队用 FActScore 和 SelfCheckGPT 评估同一批临床试验报告,发现了一个反差:我们的方法在 FActScore 中排名最后,在 SelfCheckGPT 中却排名第一。
两个指标关注的东西并不一样。
FActScore 检查拆分后的事实是否有证据支持。但在一个案例中,报告把效应方向写反了,却因为复用了证据里的数字,仍然拿到了满分。另一个案例正确表达了数值从 2.77 上升到 5.76,反而被判了零分。
SelfCheckGPT 关注多次采样的输出是否一致。它能帮助发现不稳定的回答,但一致本身不等于正确:一个模型如果每次都犯同样的错,也可能得到不错的分数。
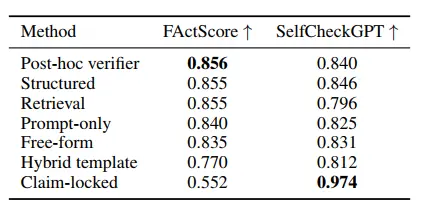
这说明,事实支持、采样一致性和统计关系是否保留,是不同的问题。前两项得分高,并不能直接说明报告保住了原来的统计含义。
先锁定能说什么,再让模型动笔
团队把这类问题称为「统计主张失真」(statistical claim distortion):数字可能没变,但比较方向、适用条件或结论强度发生了变化,报告实际说出的科学结论也就变了。
一种直觉是,给模型更严格的提示,或者写完后再检查。固定模板也能减少一部分错误。不过,只要仍由模型选择填入哪些结果,它就仍然可能挑对了数字,却讲错了结论。
因此,团队提出 Claim-Locked Reporting:先锁定 claim,再生成正文。
这里的 claim,可以理解为报告中一条有证据支撑的具体陈述。模型动笔前,每条陈述的证据来源、数字、方向,以及允许使用的最强措辞,都已经确定。
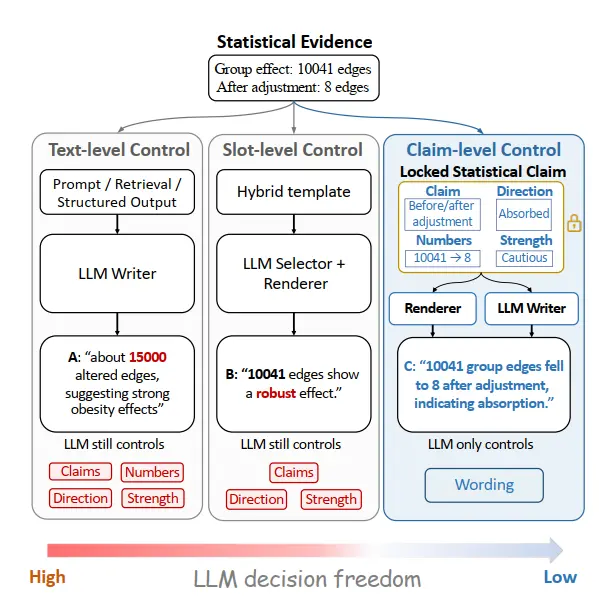
图 1:从约束文本、固定模板槽位,到提前锁定统计主张。区别在于,模型还可以决定多少与统计结论有关的内容。
具体怎么做?可以分成三步。
第一步,把统计结果整理成有据可查的主张。
系统接收已经计算好的结构化结果,再把它们整理成「主张账本」。每条主张都关联到对应证据,并记录需要报告的数字、方向和表达强度。缺少必要证据的主张,不进入账本。
比如,某项脑功能连接分析在初始模型中发现了 10,041 条显著的组间差异连接,但加入 BMI 调整后,只剩 8 条。这两个结果需要放在一起解释。因此,系统会把调整前后的数字绑定到同一条主张,而不是让模型自由挑选其中一个。
第二步,检查这条主张有没有被说过头的风险。
风险审计器检查数值有没有支持、方向是否对应、推断有没有超出证据范围,再由策略层把这些风险变成具体的表达限制。
还是上面的例子:如果组别本身就由 BMI 划分,而调整 BMI 后差异又大幅减少,就不能轻易把初始结果写成「独立的肥胖效应」。
这里有一条明确的规则:策略层只能把措辞往弱压,不能往强推。证据不足以支持的强结论会被限制;不允许报告的主张,则直接排除。
第三步,代码负责固定内容,模型负责把话接顺。
数字、表格和方向标记由代码依据账本直接呈现。语言模型负责在约束下撰写简短的衔接段落,不再自由决定报告哪些数字、把方向写成什么,以及把结论说得多强。
这样,上面的报告就会同时呈现「10,041 条降至 8 条」,并谨慎解释调整后的变化,而不是只引用初始数字,再顺手补上一句「证明了稳健的肥胖特异性机制」。
减少模型的决定权,效果怎么样?
团队在 fMRI 脑功能连接报告和临床试验报告上做了验证:
-
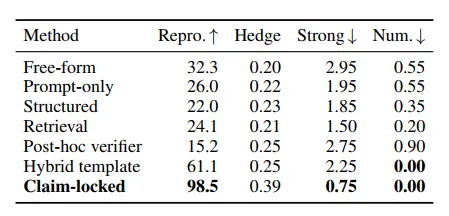
同一份证据,多次生成时数字更稳定。相比混合模板,fMRI 报告的跨次生成数值复现率从 61.1% 提高到 98.5%;临床试验报告从 79.5% 提高到 100%。
-
方向更不容易写反。在临床试验报告的盲审测试中,各基线方法的方向反转率为 5.6%–14.3%,团队的方法没有出现方向反转。

-
生成开销也更低。在使用 DeepSeek 的 fMRI 成本实验中,团队的方法 token 用量和生成耗时中位数都是最低的。

这些结果不意味着报告从此不会出错。上游统计分析如果有问题,锁定主张也无法把它变正确。但对于已经确定的证据,可以减少它在写成文字时被改写、遗漏或夸大的机会。
不要只指望模型「更小心」,而是减少它有权决定的东西。

© THE END
转载请联系本公众号获得授权
投稿或寻求报道:liyazhou@jiqizhixin.com