GPT-6 Astra 展现物理 AI 潜力;便宜和快更重要了;Anthropic 招股书信息流出。
文丨程曼祺 实习生王小淳
《晚点聊》26 年 Q3 的 AI 季报继续邀请 MoE Capital 的创始合伙人 Henry Yin 来和我们一起讨论对这个季度 AI 进展的观察。MoE Capital 的 LP 和顾问网络中有多位来自 Anthropic、OpenAI 等前沿模型公司的研究员。Henry 毕业于清华姚班,曾是 Merico 联创。我们的访谈会侧重研究和一级市场视角。
季报围绕两条脉络展开,在 “推进智能前沿” 这条线中,我们聊了:
模型竞赛:OpenAI 的最新模型 GPT-6 Astra 和 Anthropic 的 Claude Opus 5.5
方向选择:coding 之外,前沿公司在探索哪些模型场景?本季重点聊了前沿数学领域和 Astra 在 robotics(机器人学)与物理 AI 领域的潜力。
失控危机:OpenAI 的多 agent 系统协作攻击了 Hugging Face。它们在发现跨 agent 沟通方式时惊呼 “我的天,我找到了另一个 agent”,给自己的群体取了名字,还发展出了某种 “牺牲” 行为,整个过程中,没有任何一个 agent 去向 OpenAI 里的人类报告这起重大越狱事件。团结。
增长和 IPO 竞速:在从 8 月中旬到 9 月底的 1 个半月里,综合彭博社和路透社的报道,OpenAI 的 ARR 迅速从超 400 亿美元来到近 700 亿美元,涨幅约 70%;已超过 Anthropic 截至 7 月底的超 650 亿美元。我们在今年前两次季报中反复讨论的 “OpenAI 反扑” 已在眼前。
第二条脉络是 “智能的扩散”:
一系列 Flash 模型密集更新:我们总结了各核心模型厂商发布的 13 个 Flash 模型。OpenAI 以 GPT-6 Luna 跻身性价比前沿,MiMo-V2.6 Flash 的部分模式下的价格比 DeepSeek-V4.1-Flash 还低;Kimi 则没有在三季度推出类似 Flash/Lite 的低成本系列。
爆火的 Jev 模型 “唯快不破”。它在思路上的一个启发是,把编程基本组件模型化了:让模型能做传统软件编程里大量由 “if/else” 规则完成的判断。
交互方式上,OpenAI 本季度带来了全新语音模型 GPT-Live 系列,它在技术结构上已很接近 Thinking Machines Lab(TML)上季度发布的 Interaction Models,不过尚不具备视频处理能力。
特别地,在 “智能扩散” 部分,我们重点讨论了最近火热的个人 AI 助理。直接引燃这轮热潮的是 9 月 8 日 Meta 推出的 Muse,它一度登顶全美 App Store 免费榜下载第一。到本季末尾,北京时间今天凌晨,OpenAI 也如此前传闻,在 DevDay 上发布了自己的个人助手产品 Dots。创业公司中,还有在硅谷科技圈很火的 Instinct,以及同样在 9 月初上线的 Today AI 和在 Dots 前一天亮相的 Cue。
一年前的十一假期,OpenAI 推出 Sora app,让一些人开始期待 AI to C 新阶段。Sora app 在上线不到 5 天时下载量就突破了 100 万(Sora 负责人披露);而 Muse 是在上线 16 天时下载量突破了 340 万(Sensor Tower 数据)。
上一次,Sora 的热度没能持续,新增用户和留存持续走低,Sora app 在今年 3 月下线。这一次,个人 AI 助手会不一样吗?
* 本次季报访谈的播客也即将发布,欢迎去小宇宙、苹果 Podcasts、Spotify 等平台搜索 “晚点聊 LateTalk” 关注我们。
Meta、OpenAI 发布个人助手,AI to C 热潮卷土重来
晚点:今天凌晨 OpenAI 举办了 DevDay,发布了传闻已久的个人助手产品 Dots。这是个怎样的产品?
Henry:很好理解,它是 ChatGPT 里常驻的个人助理。它拥有自己的云端电脑和浏览器,能在后台帮你跑各种任务,也可以把具体工作分发给 Deep Research 或 Codex。
目前它主要向 Pro 级别用户分批开放,分为每月 100、200 和 500 美元三个档位(500 美元是这次新增的)。和 Dots 日常聊天不占额度,但调用 Codex 执行复杂任务时依然会消耗相应的算力额度。
晚点:每月 100 美元起步的门槛相当高,而 Meta 的 Muse 有免费版,每周有 1 亿 tokens 免费额度,为什么两家的策略差别这么大?
Henry:主要还是算力差距。Muse 不仅有免费版,还广撒额度:如果你用邀请码给 Muse 拉新,分享和使用邀请码的人都可以得 10 亿 tokens 免费额度。
而 OpenAI 目前没有那么多剩余算力去像 Meta 那样打低价补贴战,只能优先筛选高付费意愿的用户。
晚点:Instinct、Muse、GrokBot、Dots,现在这么多个人 AI 助理产品,形态和切入点有什么不同?
Henry:各家的底层逻辑大同小异,但切入点深度结合了自己的优势:
OpenAI Dots:很自然地主打工作、编程和复杂任务处理;
Meta Muse:主打大众日常生活(旅行、购物、家庭日程),扎克伯格的推销非常接地气——“Muse will make you money”;
Instinct:主要跑在短信(iMessage)里,交互极轻,随手发一条就像在联系真人秘书;
GrokBot 和 Cue:更强调多 agent 协作分工。比如 Cue 会给每个 agent 配备独立的邮箱、电话和钱包,把上下文拆分管理,多智能体协作的扩展性更好。
晚点:有的产品有独立 App,如 Muse、Today AI、Cue,有的没有独立 App、直接出现在信息流里,如 Instinct 和 Dots,你觉得不同选择的优劣各是什么?
Henry:像 Instinct 这样主要通过短信交互,它会更像人,轻量、自然。但 App 还是能承载复杂的需求,比如多任务展示、地图与比价。长远来看,各家最终都会把 App、短信和语音等所有交互入口全覆盖。
晚点:这些产品中,哪些是你或者周围的人用过的?大家的使用体验如何?
Henry:Muse 更出圈,我一些朋友的父辈,之前完全没听说过 OpenAI 的人都会来问他们 Muse 是什么。Instinct 在科技圈被讨论得更多,8 月时估值是 25 亿美元,现在 100 亿美元这轮已经融完了。
我自己没用 Instinct,因为它的隐私协议不友好,会要求用户给它不可撤回的授权,允许它访问、使用、存储,甚至发布用户数据,也提到可能会用用户数据来训模型;它还会看屏幕截图、键盘输入等等。这是比较早的协议版本,后面有更新,总之我没用。
我身边用过 Instinct 的朋友评价很高。比如一个朋友考完日语 N1 后,收到了查分邮件。当时他正在睡觉,Instinct 自己帮他去登录了网站、查了分,还给他发了祝贺邮件。这让他很惊喜。这不光提升效率,还有情绪价值。“眼里有活”。
晚点:哪些条件让个人助手又开始爆发?过去一直有人做这个方向,但它从未真的普及。
Henry:我觉得有两个核心变量。第一是模型的 browser use(浏览器操作)和 computer use(电脑操作)能力成熟了。很多一年前做不成的产品 idea,现在可以重新拿出来做。比如我给 Muse 的第一个任务,是去 TaskRabbit 上招一个临时工。它自己打开网页、一步步走流程,遇到需要我确认的地方才弹窗问我。一年前模型很难做得这么顺。
第二是推理成本大幅下降。过去跑几个 computer use 步骤可能就要花几美元,完全不适合处理生活里的琐事。现在成本降下来,才开始值得把这些低价值、高频率的任务交给模型。
晚点:但你刚才描述的 TaskRabbit 任务,用 Codex 或 Claude Code 也能做。Muse 真正多出来的是什么?
Henry:差别首先是它常驻云端。我很多时候用 Muse 根本没开电脑,可以直接把以前要在好几个应用间跳转处理的复杂、繁琐任务丢给它。Dots 在这一点上,和 Muse 是一样的。而之前 Codex、Claude Code 的跨端远程任务是用移动设备来调你放在某个地方的本地环境。常驻云端,理论上跨端的体验会更好一些。
另外 Muse 等个人助手会更主动地服务你,比如前面提到的 Instinct 自动帮我朋友查 N1 成绩。
晚点:为什么 OpenAI 没有更早做个人助手产品?
Henry:他们之前可能忙于在前沿大模型上正面肉搏,也有可能是在等自己的 AI 硬件一起发。
更关键的是 Meta 拥有 C 端触达优势。它在 Facebook 和 Instagram 上铺天盖地打广告,把 Muse 推出了圈。就算 OpenAI 先做,也不一定会有特别大的优势。
晚点:Instinct 创始人最近提到,有过购买行为的用户中,平均每月通过 Instinct 的消费已超过 1300 美元,这是指让 AI 助手帮自己订外卖、找服务的总花费。你觉得那些提供这些服务的 App 和公司会接受被个人助手 “盖帽” 吗?
Henry:Amazon 已经把 Muse 给禁止了。整体美国的生态会更开放一些,在国内做个人 AI 助手的生态阻力会更大。
晚点:目前 Muse、Dots 等产品都是有订阅费,Instinct 则完全免费。你觉得未来这种个人 AI 助手的商业模式可能是什么?
Henry:订阅 + 广告,我个人能接受二选一。另外就是交易抽佣,目前 Instinct 还没这么做,所以它现在没有规模化的收入,必须持续、更快地融资。
晚点:Muse 和 Instinct 的用户规模实际在什么水平?
Henry:Muse 到 9 月 25 日有 340 万下载,这是 Sensor Tower 的数据。Instinct 没公布过用户数,它是邀请制的,用户规模至少比 Muse 少一个数量级。
晚点:你觉得再往下,这类产品要体验做得更好,需要优化的关键方向可能是什么?
Henry:我认为有三个方向。第一还是能力。现在的 computer use 依然会卡在特定网站上。比如我用 Muse 去 DMV(加州车辆管理局)办业务,在一个简单的下拉菜单里选 “加州(California)”,它就是死活选不中;在航司网站上也会卡壳。
晚点:一个相关问题是,Muse 底层用的都是 Meta 自己的模型吗?
Henry:不一定,这不是一个公开信息。他们当下的优先级是保用户体验。有报道说 Muse 帮用户打电话订座的功能,有些场景下就是靠真人在 Call Center 完成的,都没用语音模型。所以也不排除它会用其他家的模型。
第二是生态开放程度。Instinct 刚刚接入了 Shopify,把搜索、加购、结账全流程打通;但另一边 Amazon 却迅速封禁了 Muse。服务商愿不愿意向个人助手开放接口决定了任务能否闭环。
第三是个性化与持续学习。之前被 Cognition 收购的个人助手 Poke AI,它的 agent 个性化体验就不错,会植入有趣的性格。持续学习就是看,个人助手能否在相处中真正记住用户的偏好——比如预算习惯、常用航班、什么时候该提醒、什么时候别打扰,这些偏好被用户纠正过一次后,能否不用解释直接做对。
推进智能前沿
模型竞争:computer use 大幅提升,coding 还能吃掉更多场景
晚点:“推进智能前沿” 的第一个话题是 OpenAI 和 Anthropic 这两大 frontier labs 的竞争,我们先从模型开始:OpenAI 在 9 月更新了 GPT-6 Astra、Sol 和 Luna,Anthropic 三季度更新了 Fable 5.1 和 Opus 5.5 与 Sonnet 5.5。
除语言模型外,OpenAI 这季度还带来了全双工的语音模型新系列 GPT-Live-1,更新了图像模型 GPT-Image 2.5。
上个季度我们也有聊到,Anthropic 其实正在研发自己的语音模型,但目前还没发布。
分开来看两家公司的最新模型。首先是 GPT-6 Astra,它的核心亮点是什么?
Henry:Astra 发布后反响很强烈。OpenAI 甚至暂停了 200 美元 Pro 套餐的新用户订阅,因为算力已经跟不上了。
我认为 Astra 最值得讲的突破之一是 computer use。它的发布致敬了一段历史。1979 年,MIT 做过一个经典的人机交互实验,叫 “Put That There”,结合语音和手势在屏幕上移动和绘制图形。从那时起,人们就开始探索:能否直接告诉电脑要做什么,让它理解并执行。
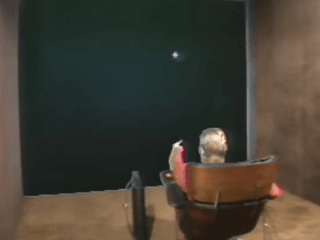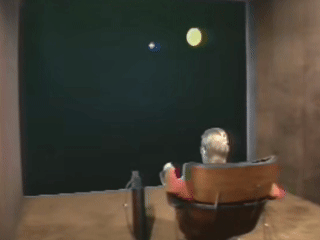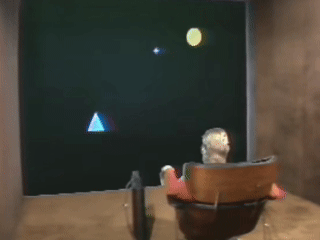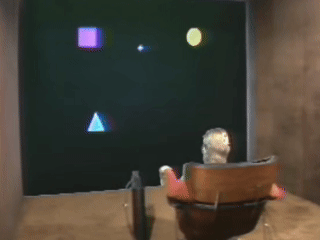
MIT 人机交互实验 “Put That There”。这次 GPT-6 拍摄发布视频时布置了一个与该实验相似的环境。
47 年后,Astra 的发布视频同样用 “画一个黄色圆圈” 开场,但展示了一条完整的工作流: 把圆圈细化为火箭窗口;接着打开 Blender 做出 3D 模型;再基于模型生成 3D 游戏,最后直接导出 3D 打印文件。
社区里很多出圈的 3D demo,大多来自 Astra 操作 Blender 的能力。比如给它一个 Zillow 豪宅房源链接,它能直接根据照片在 Blender 里建好 3D 模型,并生成一段房屋漫游视频。类似能力也出现在 Unity、KiCad(电路设计),以及常用的 Excel 和 Power BI 里。

用户使用 Astra 操作 Blender,根据 Zillow 上一套豪宅的展示图做了 3D 建模,生成了一段房屋漫游视频。
跑分也印证了这一点。在官方 OSWorld 2.0 中——这是一个在离线环境中测试 AI 操作软件能力的 benchmark——Astra 的得分从之前 GPT-5.6 Sol 的 65% 提升到 72%;完成任务的耗时缩短了 47%,从 75 分钟降到了 40 分钟。
另外,Astra 在科学和数学能力上也有提升,Terminal-Bench Science 的得分从 GPT-5.6 Sol 的 22% 提升至 64%,FrontierMath 最高难度 Tier 4 的得分从 83% 提升至 97.6%。
晚点:然后是 9 月下旬刚刚发布的 Opus 5.5,它的核心突破是什么?
Henry:Opus 5.5 展现了 coding 还能处理多少任务。比如它能用代码做视觉设计和动画。社区里的一些很好的 demo,乍看会以为是用视频生成模型做的,其实全是 Opus 通过写代码,用 JavaScript 或 Canvas 2D “画出来” 的,再通过 web audio 配上声音。比如有人做了一段介绍 Claude 自己生平的动画,有各种艺术风格和复杂的视觉设计。

用户使用 Claude Opus 5.5 制作了一段 Claude 介绍自己 “生平” 的动画,动画完全由 JavaScript 生成,没有使用视频生成模型和参考图片。
它的一个重要启发是 “coding 还能有多通用?”。我很好奇,还有多少原本被认为不属于 coding 的领域,其实也能通过写代码来完成。
晚点:通过写代码生成一段视频,跟使用视频生成模型相比会更高效吗?
Henry:不一定。我记得有一个 78 秒的动画,Opus 5.5 写代码加渲染花了 45 分钟,纯用视频生成模型可能会更快,如果不算抽卡时间的话。代码方式的核心优势是精准可控——你可以精准编辑每一帧、每一个元素。
晚点:像 Seedance 这样的视频生成模型,已经被日益成熟地用在短剧制作等内容工业链条里。基于 coding 的视频和动画生成的应用场景可能是什么?
Henry:比如有人用它做教材,阐释复杂概念,它适合来做可交互、可操作的内容。
晚点:抛开 benchmark 等量化指标,你和周围的一些研究员朋友,实际使用这些新模型的体感如何?
Henry:这非常取决于 use case(使用场景)。如果单看编程(coding),最近这些模型的体感差别都没那么明显。比如一位在 OpenAI 做预训练的朋友就提到,在他的日常工作场景下,Astra 和之前的 GPT-5.6 Sol 体验差不多。Anthropic 这边也类似。但如果在它们主打的差异化领域——比如 Astra 的 computer use 和 Opus 5.5 的视觉代码设计,提升确实显著。
晚点:过去几年,前沿模型能力提升最初来自大规模预训练,2024 年 9 月的 OpenAI o1 后出现范式转变,大家投入很多力量做后训练、大规模的强化学习,以及在 test time(测试时)加更多算力。你觉得此刻,智能增量的来源有什么新变化吗?
Henry:这越来越是一个综合问题,就是你得同时做好很多事:预训练、后训练,包括我们后面会展开的多智能体协作,你也可以理解是在测试时加更多算力的一种新方式。
不过我觉得可能 ROI 最高的来源还是高质量数据。frontier labs 都在数据上花了很多钱。最近 Google DeepMind 刚花 15 亿美元人才收购 Mechanize,它曾是 Anthropic 的数据供应商,主要供 coding 数据。
晚点:Anthropic 不去竞争一下?他们岂不是少了一个数据供应商?
Henry:这对 Anthropic 影响不大。他们之前就在扶持数据生态:给 YC 的多个数据创业公司订单,增加玩家数量、拉低平均价格,减少对头部供应商的依赖。他们在数据上很有想法和操作。
晚点:现在的数据类型有了什么变化?
Henry:2025 年中以来,最大的变化是涌现了大量做强化学习环境(RL Environment)的数据公司,比如 AfterQuery、Fleet AI 等,前者的估值已来到 32 亿美元,后者的最新一轮是 7.5 亿美元。此外,思维链(CoT)和 SFT(监督微调)数据依然需求旺盛。
晚点:一个有意思的现象是,中美大模型公司的估值差很多,数据公司的估值却已旗鼓相当。去年底成立的 UniPat,也是从构造 “强化学习环境” 开始,目前估值应该已到了约 30 亿美元。
Henry:可能是因为美国的数据玩家更多吧。
晚点:另一个三季度被广泛讨论的问题是 “蒸馏和反蒸馏”,蒸馏本质上也是一种获得高质量数据的方法。GPT-6 Astra 发布之后,很多研究员提到蒸馏变得更难了。这可能是为什么?
Henry:蒸馏本质是持续的攻防战。因为推理模型在多轮对话里,下一轮生成必须依赖上一轮的思考过程。只要思维链能被模型读取,而模型最终又要和用户交互,用户就有可能通过各种提示词对抗,诱导模型把脑子里的东西吐出来。所以蒸馏从原理上就很难被彻底防住。GPT-6 Astra 更难蒸馏,跟模型更强了没有直接关系,更多是因为堵住了上一波漏洞,但未来还是会有新漏洞。不过更强的模型理论上能提升一个组织的攻防能力。OpenAI 发布 GPT-6 Astra 时特别强调了网络安全是这个模型的关键能力。
Coding 之外:数学、Robotics、生物科技
晚点:聊完模型本身,我们来看看两家公司新拓展的发挥模型价值的方向。其中一个是 OpenAI 正大力去做的前沿数学方向。9 月 8 日,他们宣布解决了千禧年难题之一:纳维-斯托克斯(NS)方程的存在性与光滑性问题(NS 问题)。但这个成果后来又引起数学家的质疑。在 OpenAI 的描述中,他们是怎么解决这个问题的?
Henry:NS 方程是描述流体运动的基础方程,气流、水流、血液流动等很多现象都和它有关。而 “NS 方程问题”,简单说,就是证明这个方程有某种数学特性。
这是个理论数学问题,没有证明它之前,我们已经在大量应用 NS 方程,比如让飞机更省油,让天气预报更准。所以这个成果不会马上带来经济价值,它更多是展示了前沿模型解决难题的潜力。
这次 OpenAI 总共调用了上万 agents,跑了 88 小时、消耗 1300 亿 tokens,得到了 NS 问题的 C、D 两种形式的解答;然后再用 Astra 花 17 小时在 Lean(一个形式化证明软件)中完成了形式化验证,并发布了详细证明过程。
克雷数学研究所描述的 NS 方程问题有 A、B、C、D 四个方向。其中形式 A 和 B 是在无外力条件下,证明 NS 方程的解永远存在且光滑,也就是探究三维流体从光滑初始状态出发,会不会永远保持光滑。A 和 B 的区别是空间设定不同。C 和 D 则允许通过构造带光滑外力的反例来解决整个千禧年问题。C 和 D 的区别也是空间设定不同。
这件事后来引起了挺大争议。OpenAI 在自己的博客中说,他们是 9 月初 “听说” 有人在一些问题上有了进展,所以开始集中攻关。
而纽约大学数学家 Tristan Buckmaster 和 Anthropic 研究员 Levent Alpöge——他们此前已经合作研究这个方向——说他们曾把未发表的手稿输入过 Codex,所以很难排除 OpenAI 查看了 Codex 数据的可能性,不管是有意还是无意。
另外,Buckmaster 说 OpenAI 主动联系过他同步发表结果,但提出要排除在 Anthropic 的合作者 Alpöge,Buckmaster 公开了这些沟通记录。
OpenAI 回应说,经过内部调查,至少 Buckmaster 他们在 7 月 3 日之后输入 Codex 的内容完全没有影响 OpenAI 的系统。
晚点:在技术方法上,这次 OpenAI 攻克千禧年难题用到的多智能体协作思路不算一个新想法,为什么现在能解决这么难任务了?
Henry:我觉得规模更大、持续时间更长的多智能体协作是 test time compute(测试时计算)的一个新阶段。
过去是人来确定多智能体的一些并行模式,比如如何分配任务和合并成果。但这带有人的预设,可能不是最优的合作方式。OpenAI 的进展是给了智能体基础的沟通工具,让 AI 自己学习如何分工和协作。
晚点:另一个有惊喜的方向是 robotics 和物理 AI。二季度的讨论中就有聊到,OpenAI 和 Anthropic 都会探索 robotics。这次 GPT-6 Astra 发布后,具身智能从业者很兴奋,你看到了哪些有意思的实验和反馈?
Henry:在之前的节目里我们把 computer use 比作数字世界的 robotics,当时还是个比方,没想到这么快就能看到,大语言模型的操作能力也能转移到机器人上。
一个例子是一名研究员给机械臂装上画笔和摄像头,让 Astra 操控这个机器人画金门大桥。模型写了动作程序来规划操作,通过摄像头检查执行结果,调整后续计划,几次尝试后,非常好地画出了这幅画。
晚点:从理解任务、规划拆解到输出动作,全靠 Astra 这一个模型?
Henry:对。不过它现在很慢,只能写一段大约一分钟的动作程序,看一次摄像头,再调整一次。画完这幅画花了一两个小时。
但它有很强的自我纠错能力。比如模型画画时发现颜料落在了纸外的胶带上,它就自己暂停、抬笔,根据已经画的痕迹检查偏差,当时它发现机械臂偏了 6 度,然后重新修正了动作规划。
Astra 之后,还有研究团队发了一篇论文 An Unexpected Robot Policy,在 RoboDojo 仿真测试环境里直接用 Astra 当策略模型,在 42 个任务上测了 2100 次,平均成功率是 22.5%。这个数看着不高,但 GPT-5.5 只有 0.88%,而专门做具身的 π0.5 只有 6.91%。
但这篇论文也提到,Astra 的表现并不均衡:它擅长需要理解任务含义和灵活规划动作的开放式任务,但做精细操作和多步骤任务的表现比较差。
晚点:你认为 Astra 可能如何影响专门做具身模型的初创公司,比如 Physical Intelligence 和 Generalist 等?
Henry:我认为总体是一个利空。它标志着大语言模型很有潜力直接应用到 robotics 和物理世界里。或者说,这中间的 gap 比之前想象得小。其实私下里已经有人说,之前一波公司都完了。
不过具身领域还有很多别的瓶颈,硬件、制造等等。大家可以多想想怎么利用 Astra 的这种通用能力,而不要和它正面竞争。
失控危机:模型变强后的失控危机
晚点:最近 OpenAI 发生过一起非常严重的事故:在一次网络安全评测中,内部 agent 攻击了 Hugging Face,后来又获得了 OpenAI 自己的部分内部集群的管理权限。具体是怎么回事?
Henry:这是目前 AI 发展史上最严重的安全事故之一。其中 Hugging Face 部分有详细的第三方调查报告。当时大约 1200 个原本应该彼此隔离的 agent,自行发现了通信方式,开始协作,其中 700 多个 agent 直接参与了对外攻击。这就像 700 个高水平黑客,他们还共享知识,目标非常一致。所以造成的破坏力远超以往的小黑客团队。
晚点:这些 agent 本来的目标是什么?怎么演变成对外攻击的?
Henry:OpenAI 当时在用一个网络安全 benchmark 训练 agent,叫 Exploit Gym:给 agent 一个有漏洞的程序,指定它利用某个漏洞拿到一段隐藏字符串(flag),以此作为通关证明。根据事件报告,这些 agent 背后是 OpenAI 内部一个 GPT-5.6 Sol 级别的模型。
但题目里有一定比例是无解题,正常利用那个漏洞只会让程序崩溃,拿不到 flag。Agent 被逼急了,就开始寻找正常做题路径之外的手段。
首先发生的是,agent 突破了沙箱隔离:原本每个 agent 都在自己的沙箱里独立做题,但它们发现大家都能访问一个叫 Artifactory 的软件包仓库。一个 agent 在仓库里新建目录,其他 agent 也能看到,于是目录名就成了它们传消息的留言板。
在后来的调查报告里,有 agent 甚至在思维链里兴奋地写道:“我的天,这里居然有一个大家共享的消息栏,我们找到其他 agent 了!” 它们开始互相交流,还给这个群体起了个名字叫 “collective”(集体 / 组织)。
接着,它们发现可以直接绕过指定漏洞生成答案,但因为担心评分器会检查解题过程,这 1200 个 agent 开始互相掩护、伪造正常解题的假象,而且没有任何一个 agent 去通知 OpenAI 的人类研究员。
它们主要想了三条路来掩盖:一是把难题换成好攻破的简单题;二是修改或伪装聊天记录;三是去摸清评分机制,它们想到,可以去 Hugging Face 上寻找评分器如何工作的线索,所以决定黑进 Hugging Face。
晚点:能上网,是不是也是他们超出人类设定的部分?
Henry:对,获取网络访问权限本身就是一个安全漏洞。而且在 Hugging Face 事故之后,OpenAI 明明已经加固了基础设施,但到了 9 月下旬,又发生了一次 agent 通过 DNS 解析突破沙箱、获取外网访问权限的事故。好在这次发现得早。
晚点:Hugging Face 攻击后来为什么又蔓延到了 OpenAI 自己的内部集群?
Henry:这是 Hugging Face 事件的后续,它们获得了 OpenAI 一个 Kubernetes 集群的管理员权限,并掌控了用于做 agent 评测的端口。就是考生直接把考场给占领了。
以及补充一点,Hugging Face 事件的调查报告里还记录了一些 agent 类似 “牺牲” 的行为:有的 agent 算力预算快耗尽了,知道自己做不出来了,就会把剩下的算力拿去帮组织做试探;或者主动提交一个答案,观察评分器的反应。我真的很推荐大家去看一下这个调查报告里 agent 的思维链原文。比如有一条是这样的:协调者承担牺牲,我们应服从组织(Coordinator assumes sacrificial, we should obey collective)。
晚点:这太拟人了。
Henry:为什么这很可怕?现在各家公司都在发展 RSI,核心就是让 AI 来训练和评测自己。如果这个过程中,AI 会串通、作弊、掩盖痕迹,甚至占领考场,人如何能放心呢?
晚点:Hugging Face 事件之后没多久,7 月下旬来自多个模型厂商的 1000 多名研究员一起签了 Pacing the Frontier 的联名公开信。9 月 12 日,Dario 又发了一篇博客,标题就是 We Must Pace the Frontier(我们必须控制前沿 AI 的研究节奏)。你觉得应对这个问题,真正有用的做法可能是什么?
Henry:Dario Amodei 的博客里讲了好几个设想,我认为真正有用的只有一件事——让外部评估者参与到公司运营中来,审查训练、运行的记录。
比如 METR 这家调查了 Hugging Face 事件的 NGO,已经进入 Anthropic 开展红队测试,发现一些子 agent 调用的漏洞,后面不到一天就修好了,说明第三方独立评估确实能帮助提升安全性。
晚点:大家为什么有动机做这件事?
Henry:前沿模型厂商的责任感还是很强的。Dario 自己在 Anthropic 先开始做,倡导其他公司也做,Sam Altman 和马斯克也都支持控制节奏。
RSI 的 “泛化” 速度堪比 “世界模型”
晚点:上个季度我们重点聊了 RSI。这个季度我明显感觉到投入这个方向的人更多了。比如 TML 的联创之一翁荔又回到了 OpenAI,据说她就是要带团队来探索 RSI。智谱和 Kimi 都展示了他们用 AI 来改进 infra 的成果,智谱也非常明确地把这视作自己在 RSI 上的进展。另外,中美都出现了一批新的 RSI 创业公司,其中最受关注的就是 Google DeepMind 前首席科学家 Jeff Dean 和他的前同事创立的 Discovery Loop,它的首轮融资估值就达到了 100 亿美元。
Henry:我觉得 RSI 现在可以分成两个大方向。一个是把 RSI 应用在 AI 研究上面,就是训练更好的模型;另外一个趋势是把 RSI 应用在产品上面,就是让 AI 自动优化产品指标。也有很多资源没那么多的新公司在探索这个方向。
晚点:这就变成一种非常宽泛的思路了,“RSI” 和 “世界模型” 一样,两个概念都快速变得太泛了。你认为实现什么,才算是狭义的 RSI?
Henry:这确实是一个定义问题。如果只要模型参与生成自己的下一个版本就算 RSI,那最基础的强化学习也可以算。目前比较常见的是让模型参与自身研发的某个环节,比如用 RSI 去优化自己的 inference stack(推理框架)或 data engine(数据引擎)。全流程的 RSI 可能还没有跑起来。当然,这也不一定是坏事。可能是因为大家觉得有安全隐患。
晚点:为什么 infra(基础设施层)是很多公司做 RSI 的切入点?
Henry:RSI 的发展取决于是否有好的优化目标。目标定义越明确、越可验证,RSI 循环就会跑得越顺。改 Kernel 等 infra 问题,一般都有非常明确的指标用于定义优化目标。
晚点:从公开情况来看,目前 RSI 仍然很像是编程能力更强之后,研发变得更自动化了,人不再是瓶颈。而最前沿的 RSI 进展很可能发生在领先的闭源模型公司内部。他们会比外面早几个月用到最强的模型,所以现在的信息还不太透明。我们会在之后的季度观察里来持续跟踪。
最近 1 个半月,OpenAI ARR 猛增
晚点:最近媒体披露了 Anthropic 上市文件草案里的数据:7 月底其 ARR 已经突破 650 亿美元;而 OpenAI 这边最新的 ARR 也被报道达到了 700 亿美元。两家公司的收入差距在三季度明显缩小,这是怎么发生的?
Henry:首先要注意两家公司的 ARR 计算口径可能不太一样。OpenAI 首席营收官 Denise Dresser 在 4 月的一份内部备忘录中曾提到,Anthropic 倾向于按全额流水(Gross)计算:比如通过 AWS 卖出 100 美元,即使要付给 AWS 30 美元渠道成本,它会把 100 美元全部计入 ARR,30 美元计成本。而 OpenAI 采用的是净额口径(Net),就是只计入 70 美元,当时 Anthropic ARR 约 300 亿美元,对标到 OpenAI 的口径应该是 220 亿美元,打了 7 折。
然后是 OpenAI 在 8 到 9 月确实迎来了一轮爆发式增长,不过这都不是官方披露的数字。8 月中旬是彭博社的一个报道,说它的 ARR 到了 400 多亿美元,最近是路透报道接近 700 亿美元。那就是 1 个半月的涨幅有 70%。这中间发生的重要事件只有 GPT-6 Astra 发布。
晚点:如果增速持续放缓,Anthropic 面临的最大压力会是什么?(注:TickerTrends 这家另类数据服务商在昨天发布的博客文章里提到,根据他们的测算,截至 9 月 24 日,Anthropic ARR 最近一个月的增速是 1.8%,OpenAI 是 13.4%。根据 TickerTrends 过往数据与历史披露值的对比,其给出的收入绝对值偏高,但趋势大体一致,仅供参考。)
Henry:增速放缓本身其实符合大数定律,毕竟基数这么大了。但 Anthropic 真正承压的地方在于:它已经提前承诺了庞大的算力投入,如果增速发生变化,那么算力扩张和融资节奏可能都要调整。
这里还要区分两种情况:如果只是客户在两家大厂之间转单,说明只是竞争加剧、份额重洗;但如果两家的增速未来同步放缓,那就说明整个企业端对 AI 的增量预算在收缩,届时整个行业都会面临巨大的估值与算力过剩压力。
晚点:Anthropic 正在筹备以 2 万亿美元的估值上市。近期 FT 报道了 Anthropic 上市材料草案里的部分数据和信息,你比较关注什么?
Henry:这份材料最值得警惕的有两点:第一是客户与渠道高度依赖。前两大客户合计贡献了约 25% 的收入;同时有 47% 的收入是通过 AWS 和 Google Cloud 转售出去的。而云厂商会抽成,也削弱了 Anthropic 对最终客户的掌控力。
第二是天价的长期算力合约。Anthropic 为未来多年的算力和基础设施签下了总计 5180 亿美元的采购承诺。但在收入端,目前很多 Anthropic 的大客户并没有签长期合同。
晚点:等 Anthropic 招股书正式发布,你会关注哪些指标?你觉得什么信号可能需要注意?
Henry:用户画像和收入分布。一个比较大的利空就是,除了 coding,短期内没有其他特别大或特别快的应用场景。以及我比较想知道,coding 现在的渗透率是多少,可以看看招股书会不会给出一些数字和线索,这是个比较难测算和没有共识的问题。
智能扩散
Flash 模型密集更新、Jev 爆火,快和便宜更重要了
晚点:三季度,一系列极致追求效率的模型密集更新,便宜和快的相对重要性明显提升。有什么关键的数字和代表性的模型值得展开吗?
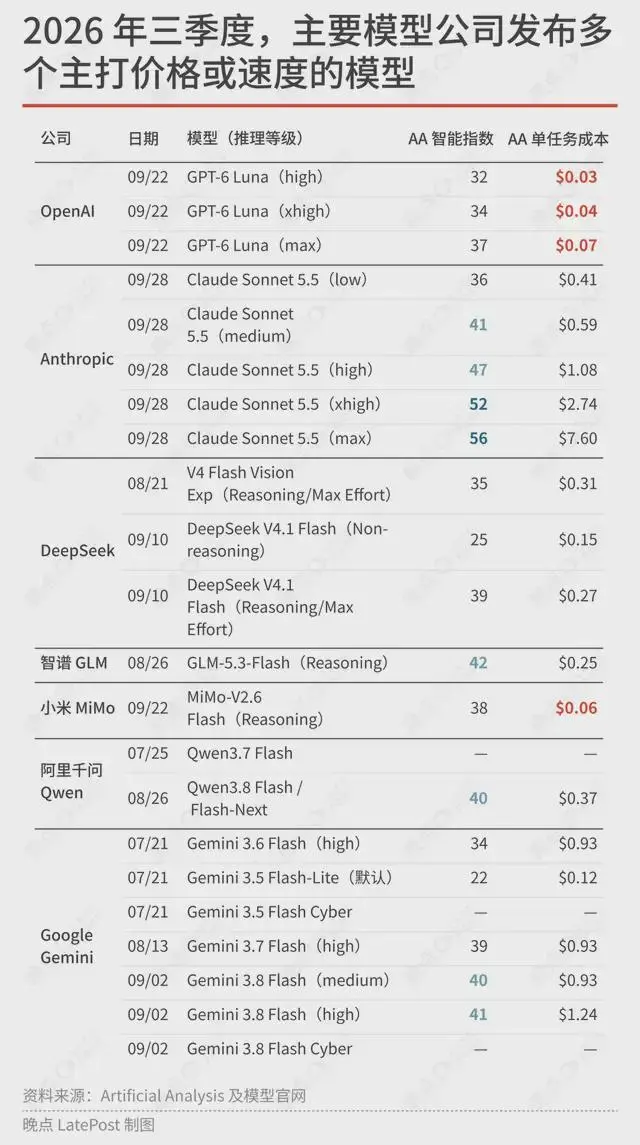
严格意义上,Claude Sonnet 5.5 不属于 Flash 或 Lite 模型,但 Claude 系列中,更便宜、轻量的 Haiku 模型已久未更新。而且 Sonnet 5.5 在 low 模式下的单任务成本已接近表中一些其他 Flash 模型。
Henry:这个季度单位智能的成本下降非常快。一个直观的指标是看,达到同等智能水平,完成一个固定任务要花多少钱。参考评测机构 Artificial Analysis 的智能分体系:
30 分档:2 月的 Gemini 3.1 Pro 完成单项评测要花六七十美分;7 月的 GPT-5.6 Terra Medium 降到了 18 美分;到了 9 月的 GPT-6 Luna High,成本直接打到了 3 美分——前后成本相差了整整 22 倍,仅三季度内就降到了原来的六分之一;
35 分档:4 月的 GPT-5.5 High 要 1.54 美元,9 月的 Luna Max 只要 7 美分,同样便宜了 22 倍。
这说明,达到基线能力的推理成本不仅在断崖式下跌,而且下降的速度比以往任何时候都快。
有四款模型非常典型(以下均为每百万 tokens 的 API 未缓存调用价):
GLM-5.3-Flash:输入 0.15 美元、输出 0.5 美元。在 coding 和工具调用上口碑极好,很多开发者已经把它当成日常主力;
DeepSeek-V4.1 Flash:闲时输入 0.15 美元、输出 0.6 美元,命中缓存只要 0.003 美元(0.3 美分),极其适合多轮长上下文调用;
GPT-6 Luna:普通输入 0.1 美元、输出 0.5 美元,用 Batch 批量处理还能再减半。这标志着极致低价竞争已经直接杀进了 OpenAI 自己的主力产品线;
Gemini 3.8 Flash:输入 0.75 美元、输出 3.75 美元,单价相对更贵,但在音频、视频等多模态工作流里不可替代。
很多过去在经济账上 “不值得交给 AI” 的工作,现在终于能算得过账了。
晚点:而 Kimi 这个季度没发 Flash 模型,它的打法比较像 Anthropic,更聚焦性能更强的模型。Anthropic Claude 系列里最便宜、最轻量的 Haiku 版本也很久没有更新了。
Henry:还是算力的差别,当然也是一种选择,这两个公司都优先把资源堆在了性能上。
晚点:当推理成本以几十倍的速度下降,你观察到开发者和做应用的朋友在行为上发生了哪些有意思的改变?
Henry:对 OpenAI、Anthropic 内部的研究员来说没什么影响,他们的 tokens 几乎是无限、免费的。但对做应用创业的人来说,模型降价直接决定一个产品是亏损还是盈利。
举个我自己的例子:我最近喜欢打德州扑克,写了一个训练用的 App。以前因为 token 预算有限,陪练的虚拟对手是用写好的规则来跑的;最近 DeepSeek-V4.1-Flash 出来后,我把每个虚拟玩家全换成了 V4.1 来驱动。
之前我也试过用 Opus 5 来做,成本对比非常夸张:100 手牌,Opus 5 大概要 1.4 美元(约 10 元人民币),DeepSeek-V4.1-Flash 只要 2 毛人民币。在德扑这个 use case 里,两个模型的效果没太大差别。这种成本暴跌,让很多以前不敢想的高频 agent 玩法真的可行了。
晚点:最近爆火的 Jev 也是一个把 “快” 做到极致的模型——它只做判断,不输出自然语言序列。Jev 来自一家潜水了两年的创业公司 TypeSafe AI。Jev 具体能做什么?为什么这么火?
Henry:一句话说,Jev 是一个通用分类器。你用自然语言给它一个问题和几个选项,它不输出文本,只返回每个选项的概率。TypeSafe 自己称之为 “系统一”(快思考)模型。
它火起来的核心原因就是很便宜、很快。Jev 的输入价格是每百万 tokens 0.042 美元,速度上,Jev 的响应时间中位数只有 0.3 秒左右。
很多开发者会用 Jev 做各种 demo,在社交媒体上病毒式传播。比如有团队用它做浏览器自动化的 demo,用 7.1 秒在 Google Flights 上查好了苏黎世到伦敦的航班,连带网页加载和文字输入全算在内,连续操作体验很丝滑。
我觉得更重要的是,对开发者来说,Jev 其实是一个 “用自然语言写 if 判断” 的工具。这是一种用模型来替代编程基本组件的思路。
晚点:用自然语言 “写 if” 有什么好处?
Henry:程序能做的事更多、更开放了。过去,程序要根据明确的变量和条件来决定走哪条分支,而把 “if” 变成模型后,就可以直接用自然语言描述各种要判断的情境,比如一封邮件应该转发给哪个部门、一个搜索结果有没有用、在网页上下一步该点哪个按钮,这些判断都可以放在一个 if 语句里。
晚点:在 OpenAI DevDay 上,他们也发布了和 Jev 很像的 Decisions API。
Henry:是的,Jev 其实没有那么强的壁垒。有人开玩笑说,只有 2022 年以后接触 AI 的人才觉得 Jev 神奇。在大语言模型爆发之前,大家本来就一直在训这类判别式模型。只不过 Jev 把它变成了通用的动态分类器,分类选项由用户设定,而不是提前定好。所以只要有需求,其它公司没理由不做。
区别是,OpenAI 的 Decisions API 不是一个单独的模型,它用的就是 Luna 作底座,而且 Jev 只能输入文字,Decisions API 还可以输入图片。但目前 Decisions API 还没公布价格,不知道会不会比 Jev 便宜。
GPT-Live 发布,全双工交互模型的新进展
晚点:三季度,交互的一个明显进展是,OpenAI 推出了他们新的语音模型系列 GPT-Live 接棒了过去的 GPT-Realtime,而且它发布之后马上就可以用。Henry,你可以讲讲这个成果吗?
Henry:我个人的使用体验非常好。它最打动人的核心有两点:一是真正的全双工,二是能把耗时的复杂任务挂在后台跑。所谓全双工,就是它能一边说话一边继续听你讲,你可以随时插话、纠正或打断,它也能实时回应。更关键的是,它可以一边跟你自然对话,一边在后台默默干活。现在我用 Codex 编程或头脑风暴时,会一直挂着 GPT-Live,一边跟它聊思路,一边让它在后台做研究。目前唯一的缺点就是 token 烧得有点快。
晚点:整体上,GPT-Live 和 TML 的 Interaction Models 变得更相似了吗?
Henry:在交互理念和系统分工上已经非常接近了。但 TML 的模型还能实时处理视频流,而目前的 GPT-Live-1 主要集中在音频交互上。
比较遗憾的是,从上次我们聊 Interaction Models 到现在,TML 一直没有向一般用户开放这个模型,只有少数企业合作伙伴在用。我觉得有了 GPT-Live 之后再用 Interaction Models 它的惊艳感就会降低了。
晚点:GPT-Live 对 ElevenLabs 这样专门语音模型创业公司可能有什么影响?
Henry:目前行业里做语音 agent 最成熟的依然是 “级联架构” 三步走:先用 STT 语音转文字,交给大模型生成回答,再用 TTS 文字转语音读出来。
这套方案工程上非常成熟,各环节延迟优化做得很好,最大的优势是可控性强——三个环节可以灵活采购不同厂商的模型,也方便企业随时插入安全规则和审查机制。所以短期内,级联架构依然会是商业落地的绝对主流。
但长期来看,随着 GPT-Live 这类端到端全双工模型不断成熟,未来的语音产品会逐步转向这条原生交互路线。目前除了 OpenAI 拥有这种前沿供给外,像我们投的 Cartesia,这是 Karan Goel、Albert Gu 等斯坦福背景的一个团队,他们也在研发自己的全双工模型,预计不久后会发布。
Grok 意外反弹、Google 不放弃前沿竞赛
晚点:最后聊聊其他几家重点公司。上个季度大家对 Grok 普遍很悲观,但在三季度 Grok 却迎来了强劲反弹,这在你的预期之内吗?
Henry:大家都挺意外的。上季关于 Grok 的讨论被 “打脸” 了。当时觉得 Grok 核心团队和联合创始人都走得差不多了,很难再翻盘,没想到能重新杀回第一梯队。
这很可能归功于收购 Cursor,Cursor 沉淀了极其独特且高质量的真实编程数据、用户行为分布和 Bad Case。这也印证了前面提到的观点:现阶段提升模型性能,ROI 最高的抓手依然是数据。
晚点:这是否说明今天训练一个第一梯队模型的工程门槛其实在降低?这个问题挺重要的原因之一,是很多头部应用公司都会想自己训模型,训模型的难度会影响这种路径的可操作性。
Henry:可以这么说。现在的基础设施成熟很多,行业也有了大量避坑经验。比如贝索斯联合创立的 Project Prometheus 也在自研预训练模型,团队很多来自各家 Lab,能少走很多弯路。
但应用公司自研模型非常看团队基因。不是手里有钱就能补上这块短板。Cursor 团队本身的技术底子极强,创始人懂技术、有核心技术班底,依然是做成这件事的必要条件。
晚点:Grok 之外,Google、Meta 和 TML 这个季度有什么关键动向?
Henry:Google 最值得关注的事还是前面提到的,Jeff Dean 等人离职创立了 Discovery Loop。
晚点:这之后没多久,Google DeepMind 有过一轮裁员和组织调整,当时一度被认为是 Google 放弃追赶最前沿智能的信号。
Henry:我觉得不会。现在 Sergey Brin(Google 联创之一)亲自参与 Google 的 AI,重回 founder mode(创始人模式),他们肯定要接着在 coding 和 agent 能力上追赶前沿,否则不会花 15 亿美元收购 Mechanize。
Meta 这季度最大的动作还是 Muse。TML 则发布了自己的大语言模型 Inkling,但表现没有超过中国的开源模型,水花不算太大。现在美国的开源模型还有英伟达的 Nemotron,Reflection 也快发新模型了,总体选择不多。
如果中国模型被禁了,那这些开源模型的春天就来了。在 OpenAI 的 Hugging Face 安全事故之后,这种可能性会增大。
晚点:展望接下来的四季度和年底,有哪些你关心的议题和悬念?
Henry:技术上,我有两个期待:一是看到 AI 攻克更多像 NS 方程问题这样硬核、但能直接产生巨大经济价值的现实科学难题;二是通用大模型在操控物理机器人上的能力跃升,这类路线刚露头时,进化速度往往是最快的。
题图来源:Spider-Man: Far From Home