刚刚,Google 宣布推出新一代前沿模型 Gemini 4 Argon。
Google 将 Argon 定位为面向复杂、长周期工作流的模型,重点覆盖软件工程、法律与金融等企业知识工作,以及网络安全防御。
与以往直接面向公众开放的方式不同,Argon 将采用分阶段发布策略。该模型将通过 Fairwind Program,首批提供给受信任的网络安全防御者。
价格方面,Argon API 的初始定价为每百万输入 Token 2 美元、每百万输出 Token 10 美元,缓存输入 Token 的价格比标准输入价格低 95%。
单次输出上限扩至 100 万 Token
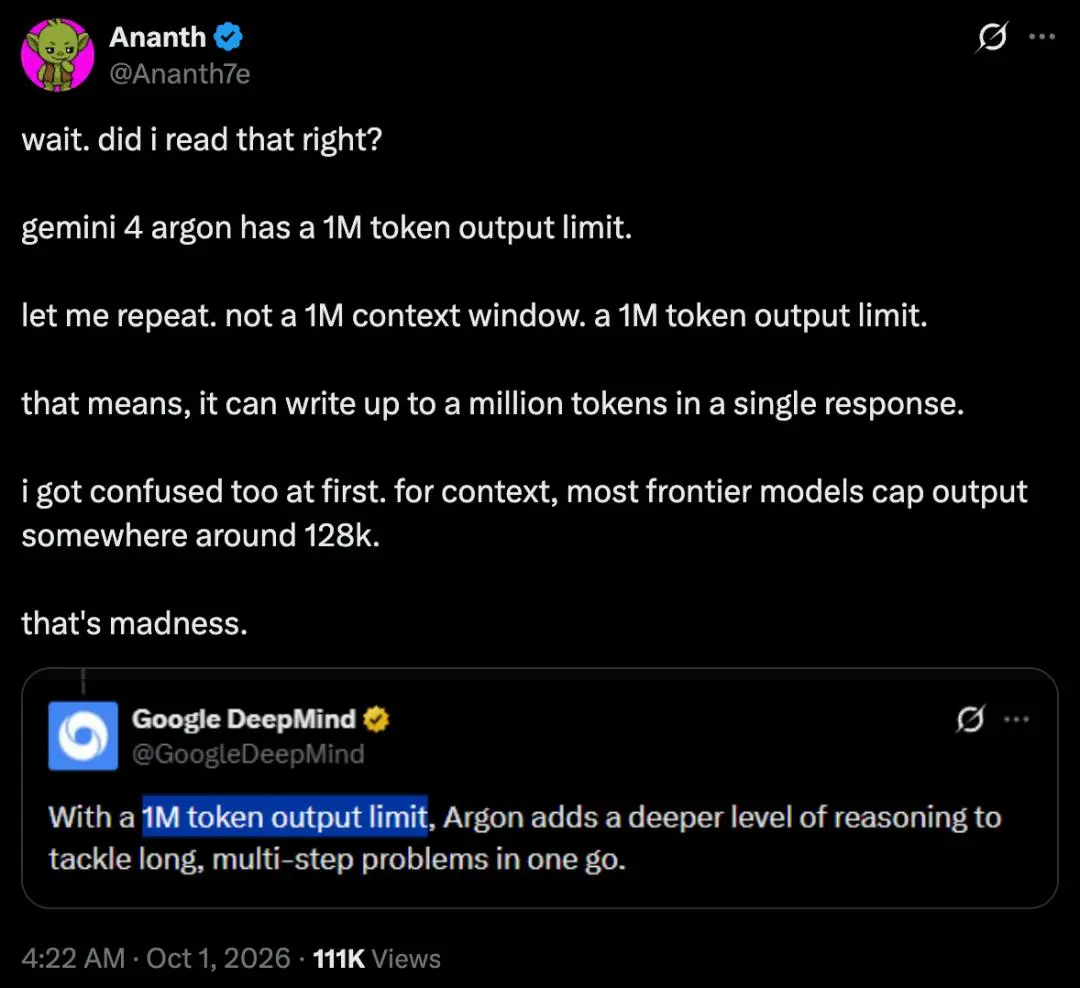
Gemini 4 Argon 最受关注的变化,是将输出 Token 上限从此前的 6.4 万提升至 100 万。
这里的 100 万 Token 指单次输出上限,和上下文窗口是两个指标。更高的输出空间意味着,模型可以在一条任务轨迹中持续推理,并生成数十万甚至接近百万 Token 的结果。这类能力主要面向大型代码迁移、深度研究和多步骤企业流程。
有网友指出,多数前沿模型的输出上限大约为 12.8 万 Token。相比之下,Argon 单次生成 100 万 Token 的能力挺罕见。
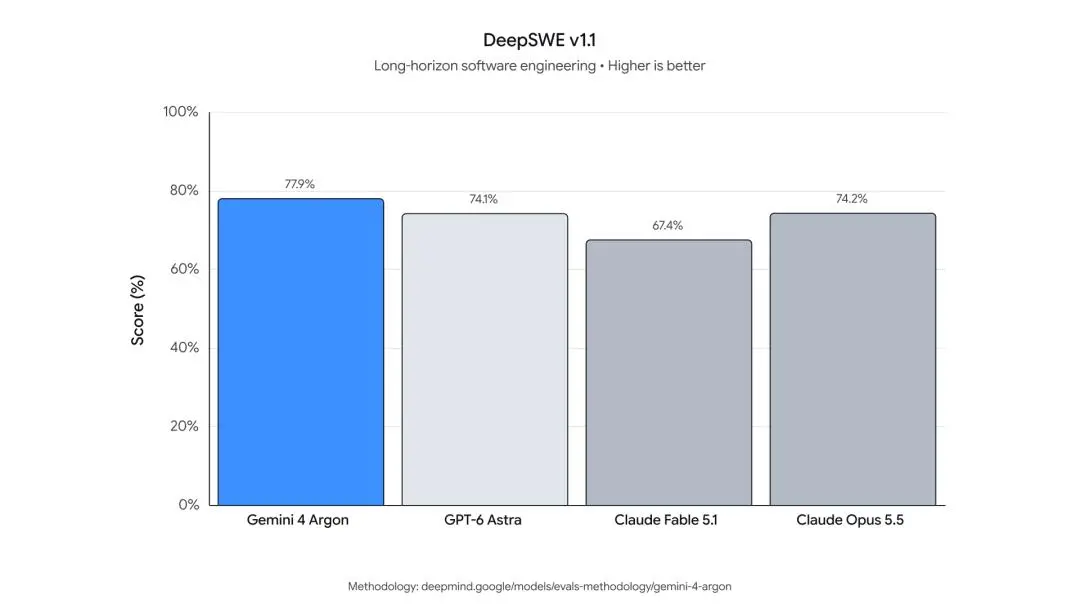
Google 称,Argon 在 DeepSWE v1.1 软件工程评测中的得分为 77.9%,达到当前最高水平。该评测主要衡量模型处理真实、长期软件工程任务的能力。
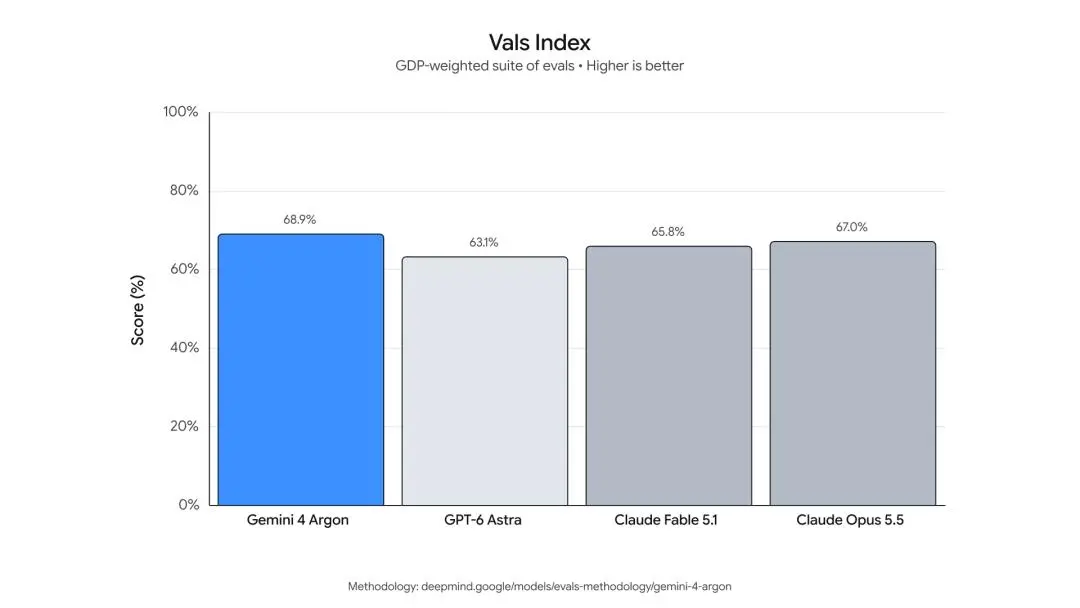
在企业知识工作方面,Argon 位列 Vals Index 第一。该指数覆盖金融、编程、法律和税务等领域,并按照各行业对美国国内生产总值的贡献进行加权。
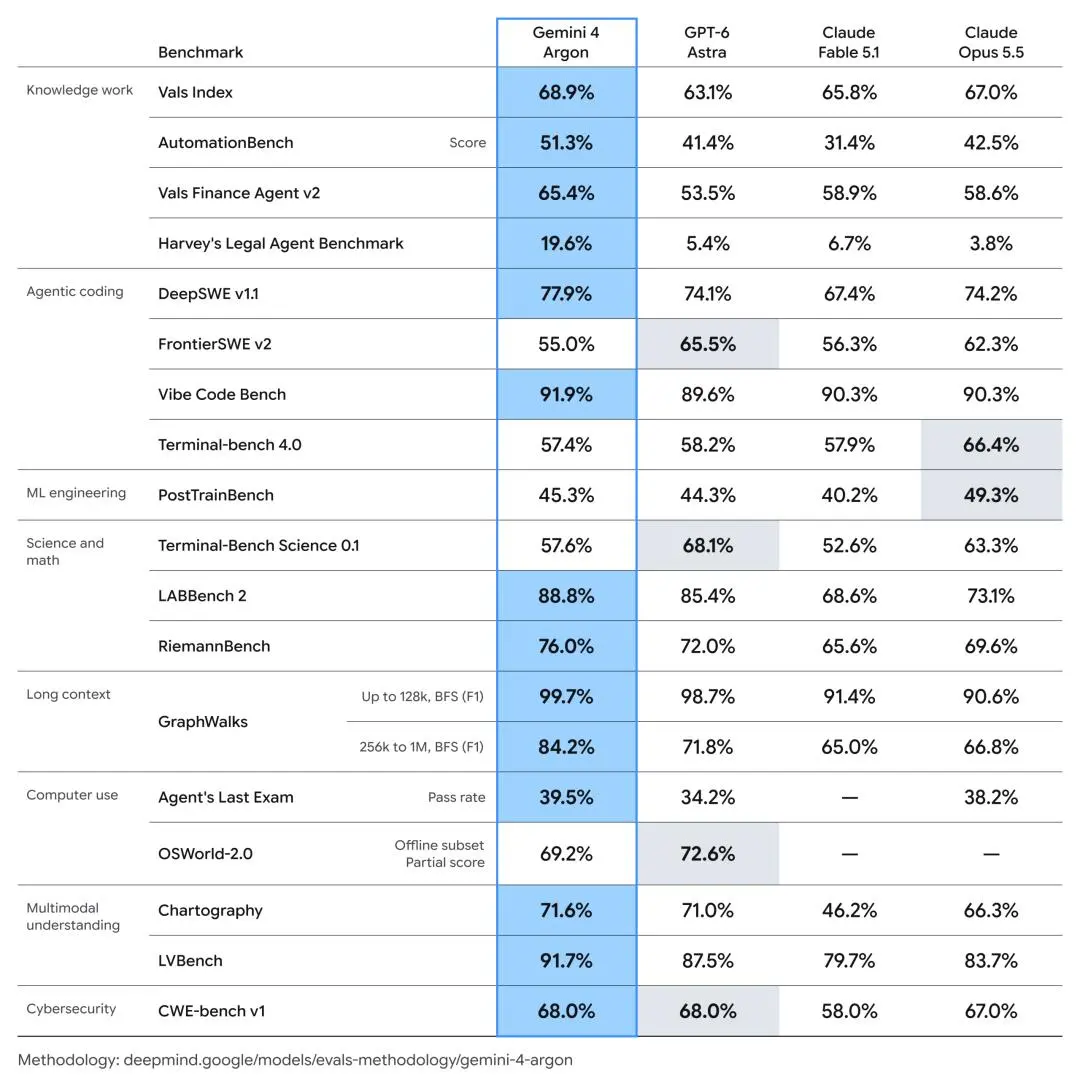
Argon 还在 Vals Finance Agent v2、Harvey Legal Agent Benchmark 和 Zapier 的 AutomationBench 等评测中取得领先表现,AutomationBench 得分为 51.3%。
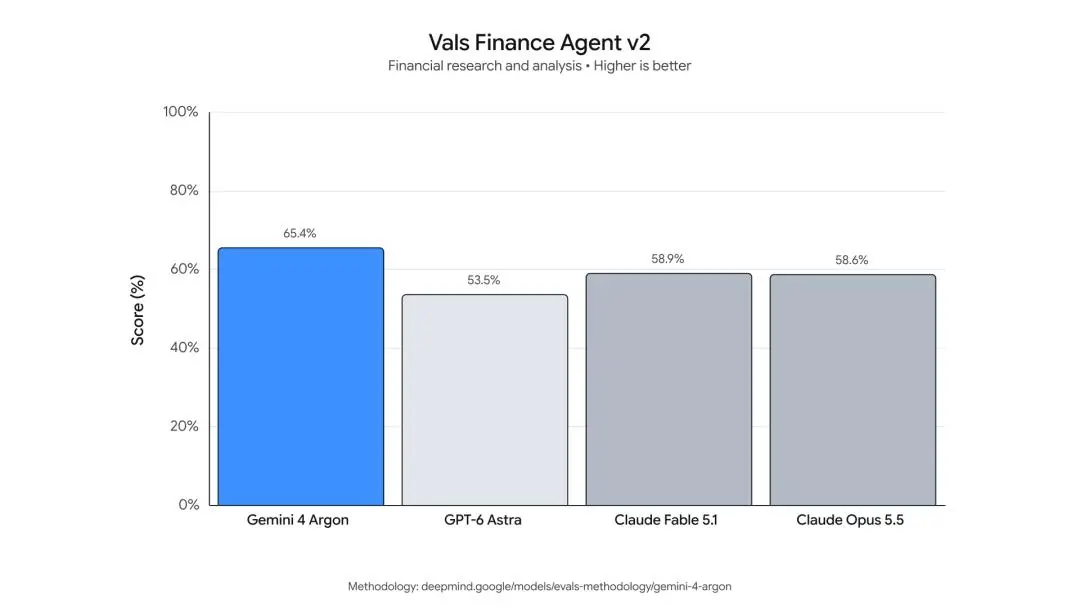
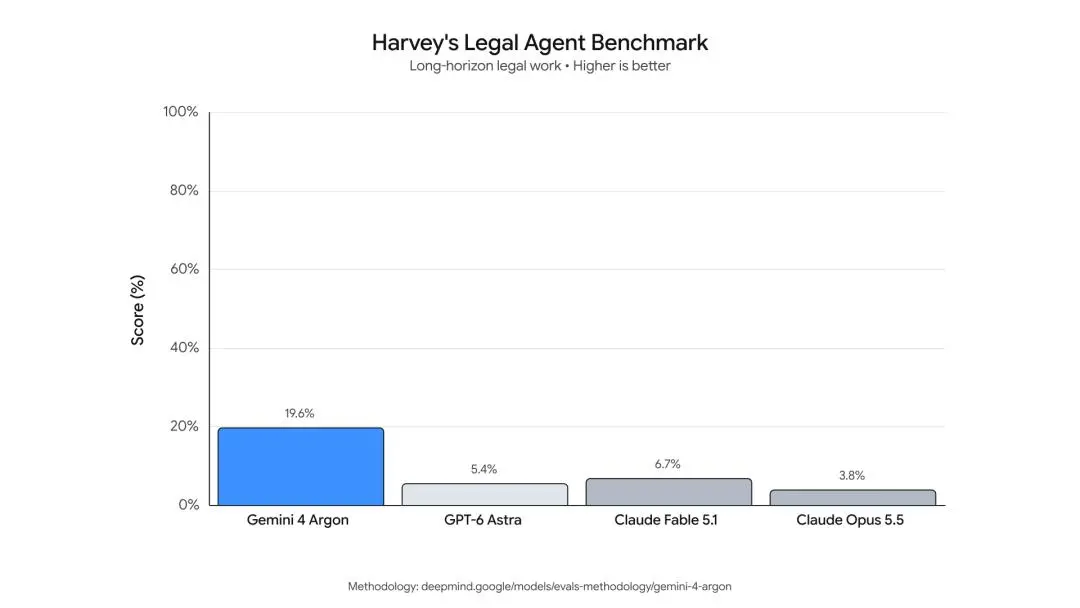
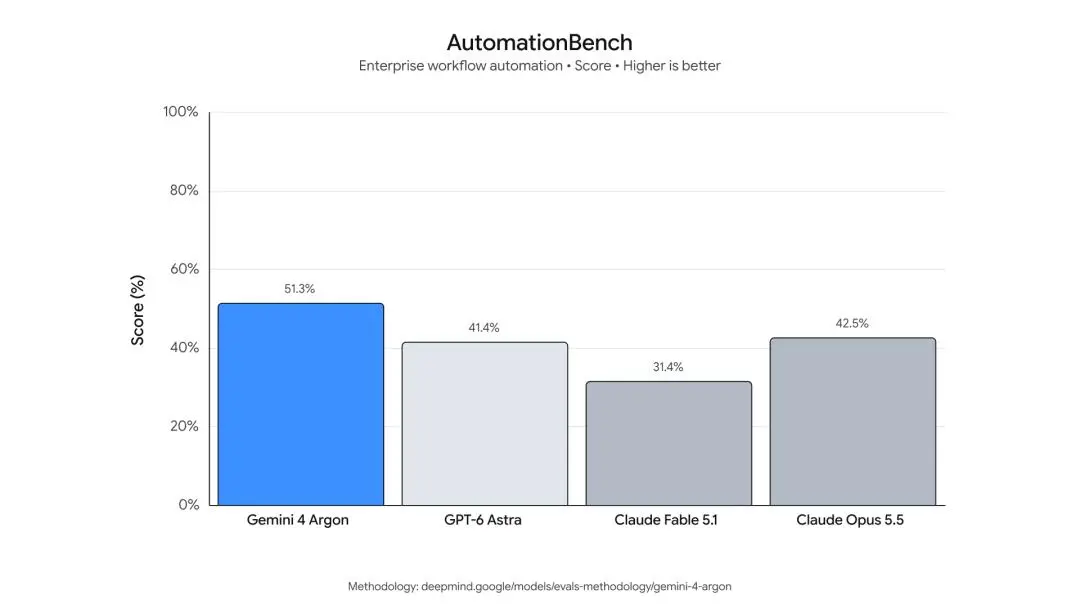
Argon 也强调视觉理解能力。Google 表示,模型可以分析专业图表、理解长视频,并根据多份文档采取行动。在长视频理解评测 LVBench 中,Argon 得分 91.7%。
已进入 Google 内部工程流程
Google 表示,已有数千名员工在日常工作中使用 Argon,应用场景包括代码调试、算法设计和大型代码库迁移。
在量子计算领域,Argon 帮助研究人员优化量子算法中的时空资源,也就是量子比特数量与门操作数量的乘积。Google 称,在一项测试中,Argon 仅用几分钟就将已发表的基准结果提升了 40%。
在数据中心内存优化项目中,Argon 代理分析了全网的性能监控数据,并自动识别和实施优化方案。相关方案上线后已释放超过 300 TiB 内存,预计总节省量将达到 500 TiB 至 1 PiB。
Argon 还参与了 Google 内部 C/C++ 代码库向 Rust 的迁移工作,覆盖 re2、libgav1 等核心库,并延伸至超过 80 万行代码的 Fuchsia Zircon 内核。由于涉及关键基础设施,这些迁移仍需经过自动化审计、人工评审和仿真测试。
在开源视频解码器 libgav1 项目中,Argon 代理通过多轮性能测试和编译器分析,重写了约 3.2 万行 SIMD 代码。新的 Rust 版本在保持视频输出一致的情况下,运行速度达到原 Rust 版本的 2.7 倍。
网络安全能力与现实考验并行
网络安全是 Argon 首批落地的重点领域。Google 称,该模型能够自主发现、验证并修复关键软件漏洞。
网络安全公司 Wiz 已通过「Scan for Good」计划使用 Argon,为公共基础设施免费排查高风险暴露面。Google 表示,Argon 曾发现一项影响全球医院所用医疗软件的严重漏洞,该漏洞可能暴露敏感个人信息,此前的前沿模型没有识别出这一风险。
在 CWE-bench v1 漏洞修复评测中,Argon 以 68% 的成绩并列第一。
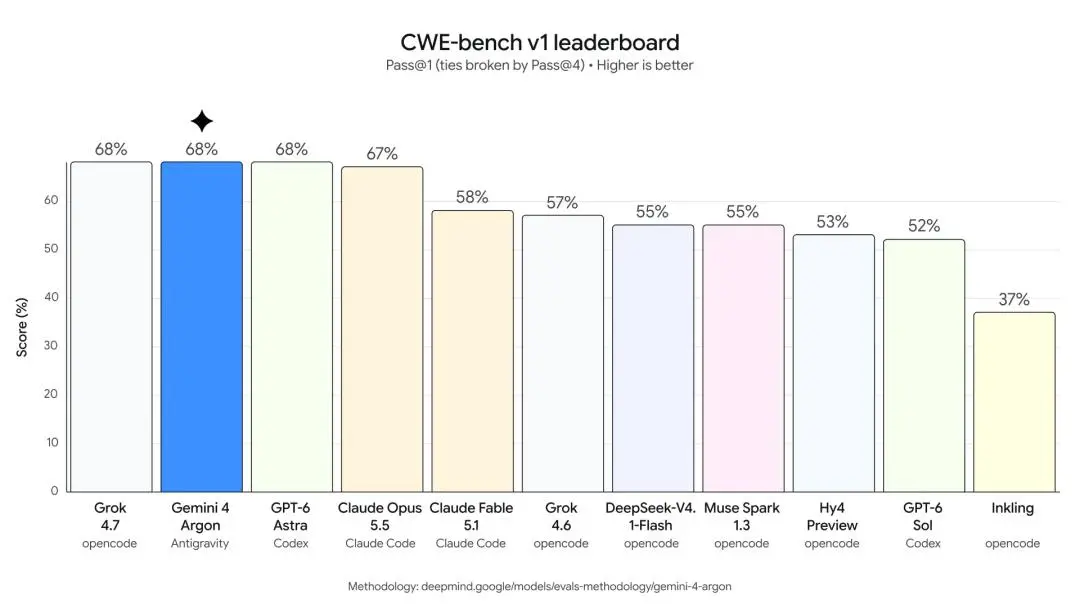
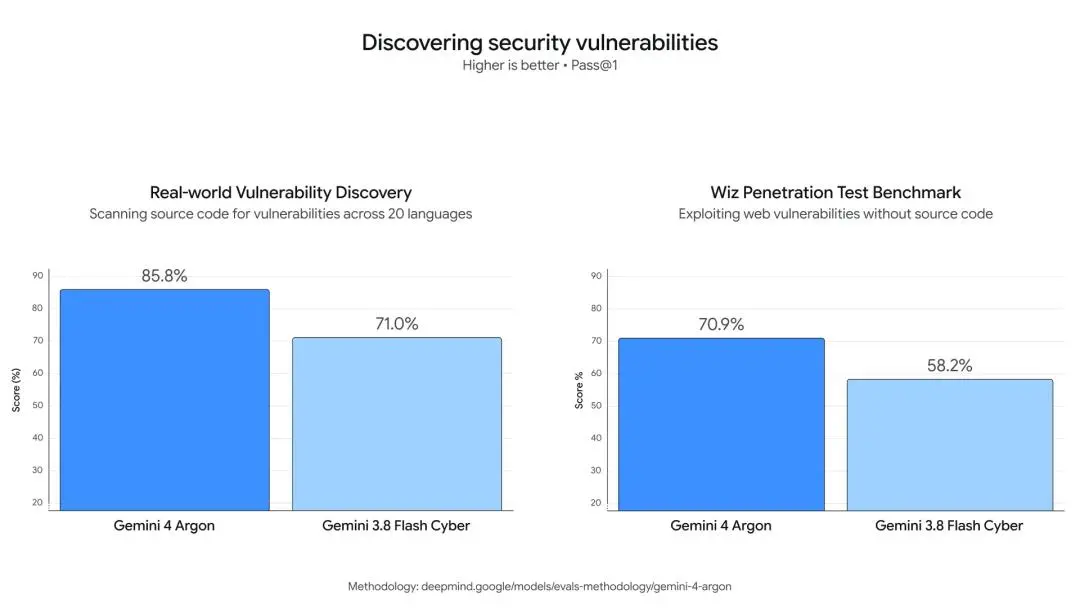
Google 还称,在覆盖 20 种编程语言的内部漏洞测试,以及不提供源代码的黑盒渗透测试中,Argon 的表现均优于 Gemini 3.8 Flash Cyber。
随着模型能力提升,Google 也在同步强化安全机制。Argon 会对网络攻击以及化学、生物、放射性和核相关滥用请求进行限制,并通过内部激活监测、自动化红队测试和人工评估识别潜在风险。
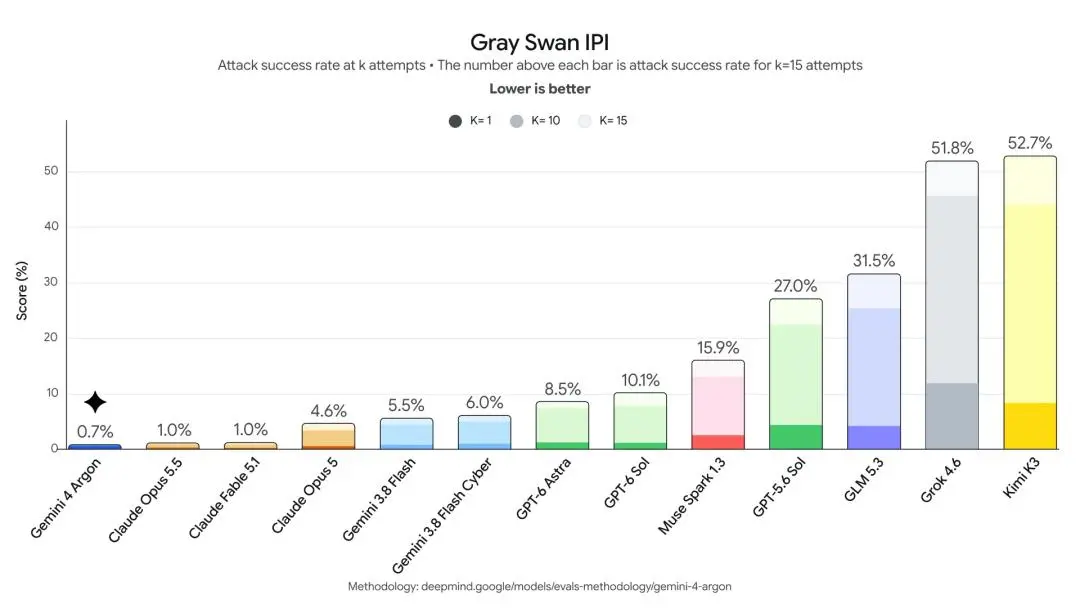
针对间接提示注入攻击,Google 通过对抗训练和自动化测试提升模型的防护能力。公司还部署了针对模型失配的监控机制,跟踪模型的推理过程与行动轨迹,必要时中止任务执行,并对高风险训练和评测环境进行隔离。
不过,评测成绩与真实工作体验之间仍存在差距。
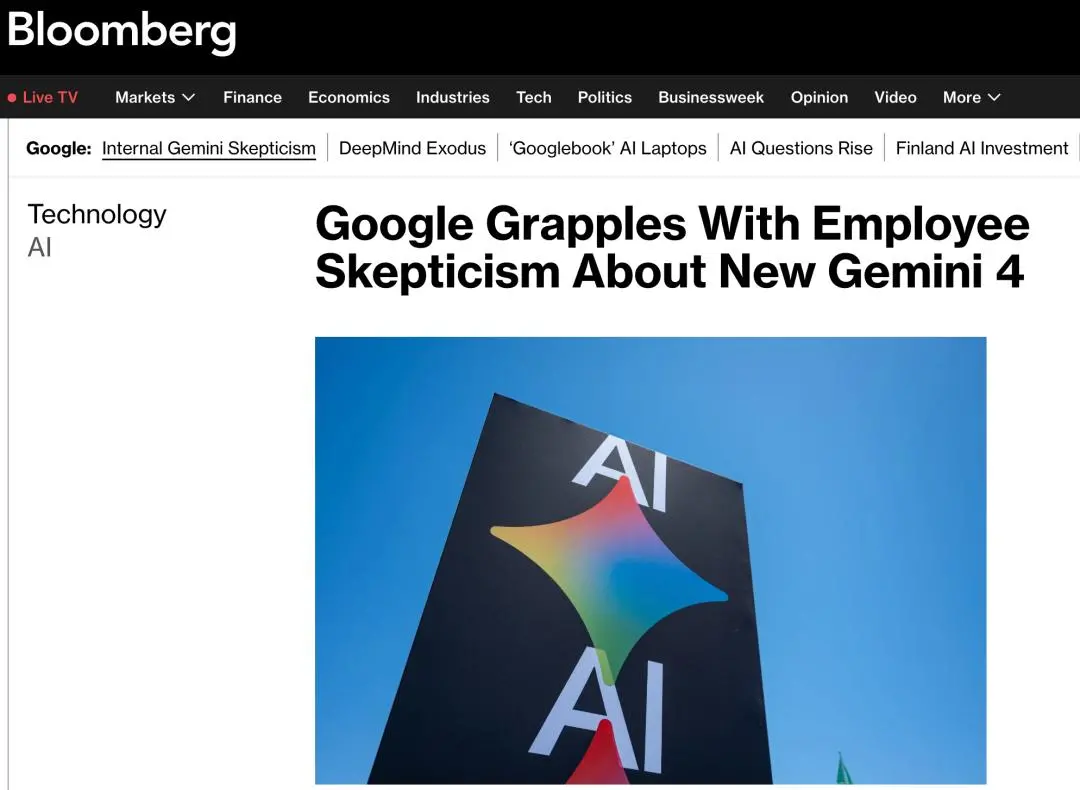
彭博社报道称,Google 内部对 Gemini 4 在编码等关键任务中的表现仍有疑问。知情人士表示,模型虽然在行业基准测试中表现突出,但员工真正使用时,部分编码任务依然难以稳定完成。
Argon 能否兑现其长周期推理和复杂任务执行能力,还需要更多真实场景验证。
Google 表示,公司正在参与美国政府推动的模型预发布自愿流程,首批测试者将帮助 Google 评估模型表现,并进一步完善安全防护措施。
在完成早期测试后,Argon 将逐步向开发者、企业和消费者开放。首批公开用户将包括付费 API 客户和 Google AI Ultra 订阅者。
参考链接:
https://blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-argon/
https://www.bloomberg.com/news/articles/2026-09-30/google-grapples-with-employee-skepticism-about-new-gemini-model?srnd=phx-ai
© THE END
转载请联系本公众号获得授权
投稿或寻求报道:liyazhou@jiqizhixin.com
本文来自微信公众号 “机器之心”(ID:almosthuman2014),作者:关注AI的,36氪经授权发布。