NAND 是一个被“技术诅咒”的行业:正如海豚君在前篇《NAND天性 “多产”,闪迪凭什么守 80% 毛利率?》中所说,AI 爆发前的 NAND 就是典型的大宗生意——产能由市场无情出清,技术领先换不来溢价,只能“亏得比别人少”,销量增长的红利被降价全部吞噬。
根源在供给端太多产:靠单一晶圆上向上堆叠、横向缩孔,从 BiCS5 到 BiCS11 五代,闪迪每片晶圆的 bit 产出 每代 增加 54%,年化复合约 27%。
也就是说,哪怕一分钱扩产(CapEx)不花,bit 产能每年也会自动膨胀近三成。3D 转型期更是一次性猛增,供给一度远超需求,这让“轻资产”NAND 生意在下行周期比“重资产”DRAM 更惨烈。
而 AI 的爆发,正在重写 NAND 的剧本。本篇报告中,海豚君重点关注AI 浪潮究竟给 NAND 下游需求带来了怎样的结构性重塑?
以下为详细分析
1. AI 浪潮究竟给 NAND 下游需求带来了怎样的结构性重塑?
AI之前的消费电子周期中,“话事”需求场景——手机、PC、传统服务器等核心下游增长平稳可预期,缺乏爆发变量,所以周期的大起大落,实质由供给端的无序扩产与急剧收缩主导。
需求增长来自三大动能:单机容量升级、新兴市场渗透,以及固态硬盘(SSD)对机械硬盘(HDD)的存量替代,缓步而稳定。
稳定的需求,配上刚性提升供给,导致NAND 属性被困在经典的“硅周期”中:供过于求、价格暴跌 → 原厂减产,低价同时刺激单机容量升级 → 供需再平衡、价格回升 → 原厂在高利润下追高扩产 → 再次陷入产能过剩。
只要 NAND 摆脱不了“外围零件”的定位,这个死循环就打不破。唯一出路,是出现一个不太看价格、且与 GPU 算力部署直接绑定的新场景——这正是后来 AI 浪潮所扮演的破局者角色。
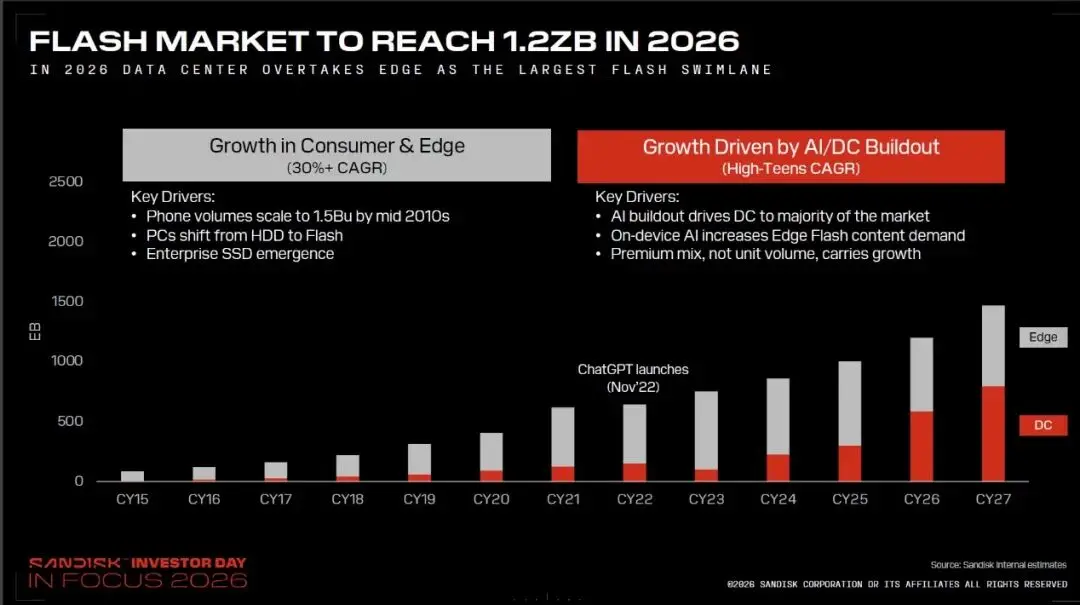
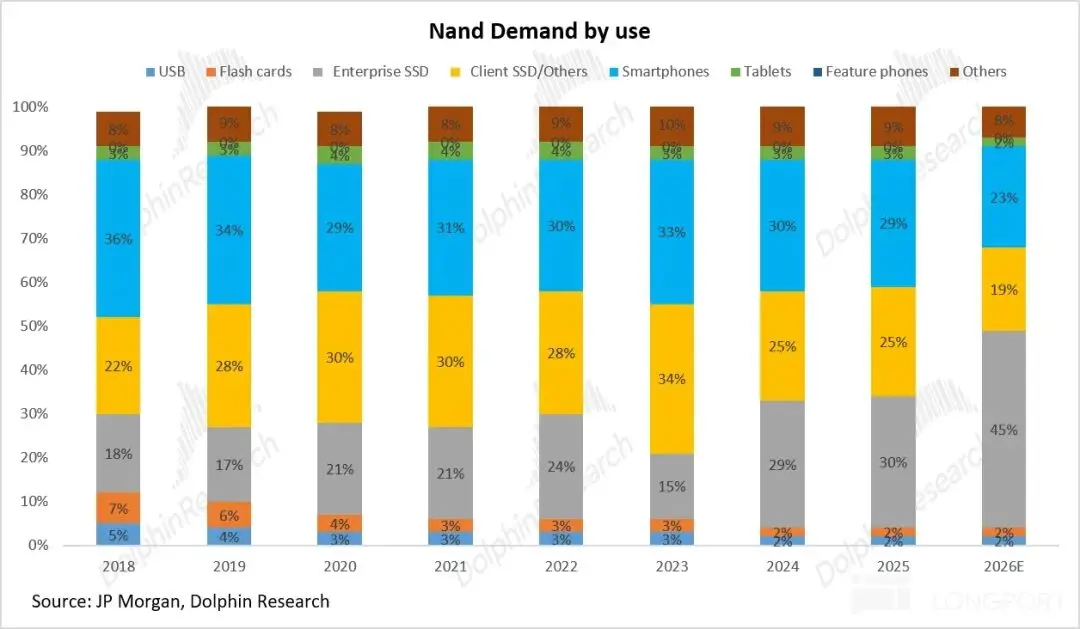

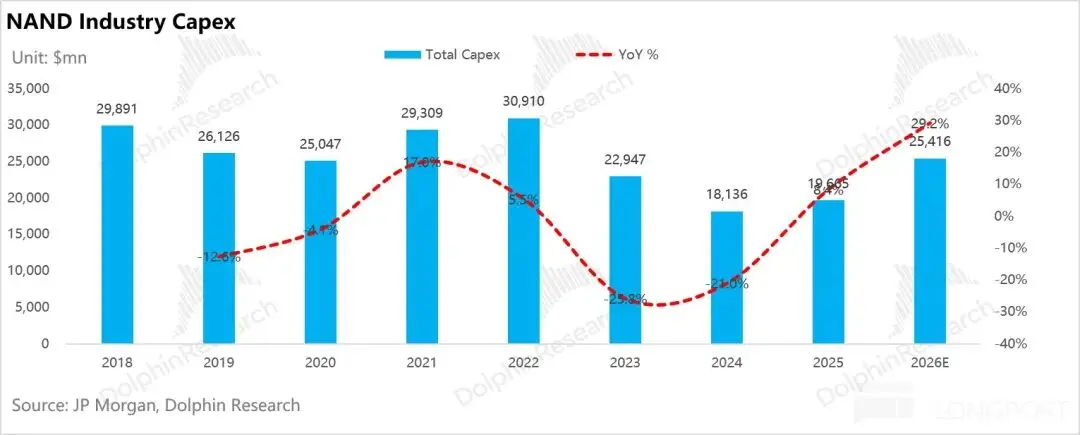
第二阶段(2025 年之后):AI 推理驱动的结构性爆发
2026 年是 NAND 历史上最具标志性的分水岭:数据中心占 NAND 总需求的比重,从 2025 年约 30% 跃升至 2026 年约 45%,历史性反超智能手机(同期收缩至约 23%),成为最大终端基本盘。
驱动 NAND 需求的主角,从对价格高度敏感、库存大起大落的消费电子,换成了以 TCO(总拥有成本)和算力回报(ROI)做决策、对价格脱敏的云服务商。
云厂商关心的不再是“这季度颗粒够不够便宜”,而是“能否按时拿到足额的高性能 eSSD,保证未来三年 GPU 基建不掉链子”。从“短期压价”转向“长期保供”,正是原厂推行 NBM(新型长协模式)的需求侧基石。
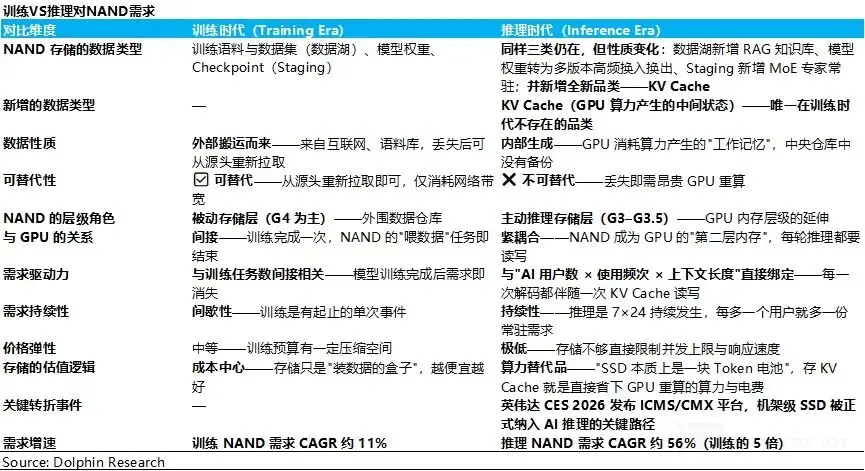
伴随基本盘切换,AI 重心“由训转推”,更让 NAND 的角色质变:
AI早期,NAND 只是外围的“数据仓库”:把训练语料、模型权重、防宕机的 Checkpoint(存档)等静态数据,放在 GPU 能快速调取的近端。这些数据可替代性极强——丢了从数据湖重新下载即可,只花带宽和极少电费,不必动用昂贵 GPU 重算。
但推理时代,计算变成高并发、持续性的“动态消耗”——存储需求与“AI 用户数 × 使用频次 × 上下文长度”强绑定。更关键的是,NAND 首次存储“计算的中间产物”。
长文本推理产生的庞大 KV Cache 不是外部搬来的静态数据,是 GPU 大量消耗算力后生成的“工作记忆”。它一旦丢失,中央仓库没有备份,只能再花昂贵的 GPU 算力和电费重算。
存储的价值第一次可以直接折算成“算力与电费”。正如闪迪所说——SSD 本质上已经进化为一块“Token 电池”:Token 是已经做过的功,与其丢弃重算,不如“充”入硬盘;存 KV Cache 就是帮云厂商省电、省算力。
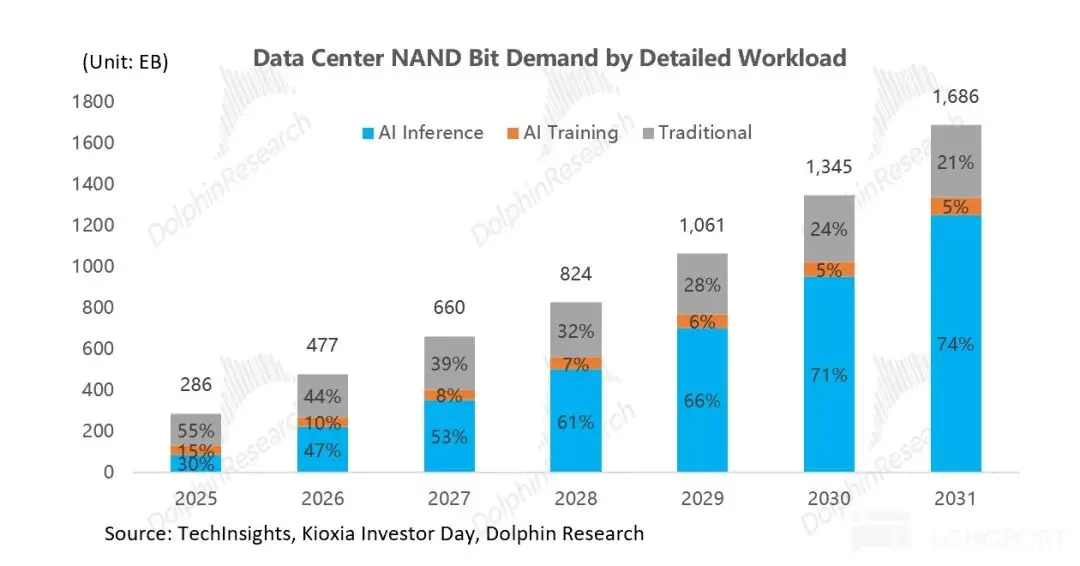
铠侠的预测也印证了这一趋势:数据中心 NAND 总需求将从 2025 年的 286 EB 增至 2031 年的 1,686 EB(CAGR 34%),且内部结构极度分化:
AI 推理: 从 2025 年的 86 EB 激增至 2031 年的 1,251 EB,CAGR 高达 56%;占数据中心 NAND 需求的比例也从 30% 攀升至 74%。
AI 训练与传统负载: 同期 AI 训练的 CAGR 仅 11%,传统云工作负载(以 CPU 为主)仅 14%。
推理需求的增速是训练的 5 倍——本轮 NAND 超级行情,将主要由推理需求的爆发主导。

先看 NAND 在 AI 数据中心的主要应用:
① KV Cache 卸载——NAND成GPU 的上下文存储层
AI 推理时,GPU 必须为每个 Token 实时计算并维护 KV Cache(模型的“工作记忆”)。但早期架构中它是“算完即弃”的消耗品:一轮对话结束,或 GPU 要腾显存服务下一个用户,HBM 里的 KV Cache 就被清空。
于是用户一旦追问,或多人并发调用同一份超长文档,系统只能把上下文重新喂给 GPU,从头做一次昂贵的 Prefill(预填充)。
Prefill 是推理第一步:GPU 一口气通读全部输入、算清 Token 间的关联(Attention 机制),再生成一遍 KV Cache——这是整个推理中最吃算力、最费电的环节。

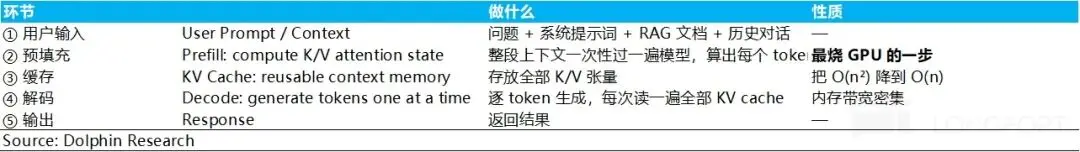
过去“用了就丢”,是因为两笔账算不过来:
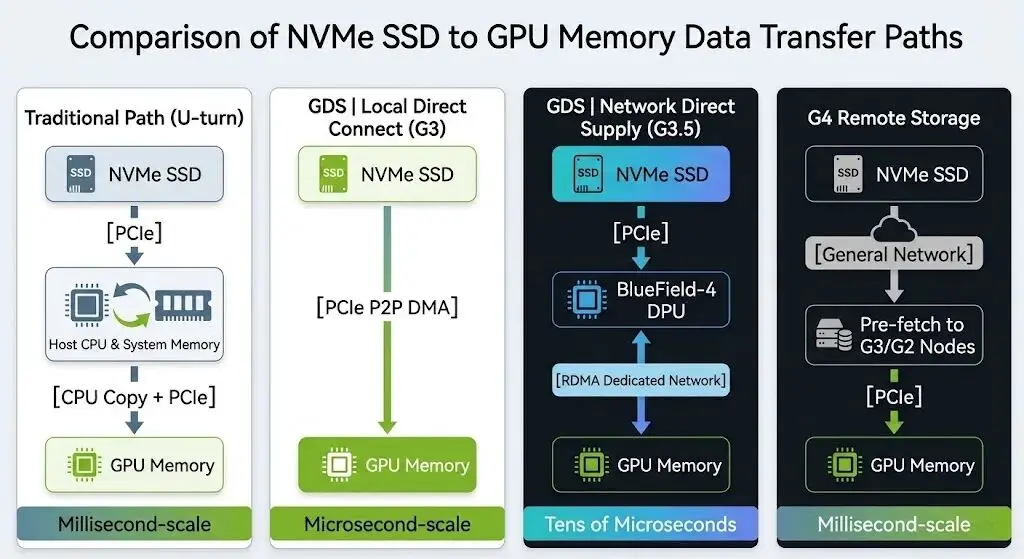
a. 重算比存起来更便宜: 早期(如 GPT-3 时代)上下文只有 2K Tokens,KV Cache 很小,GPU 零点几秒就能重算完;而存进硬盘要经 CPU 和内存中转、在 PCIe 上“折返跑”,来回耗时甚至超过重算。
b. HBM 又小又贵:GPU 自带显存“寸土寸金”,必须留给当前活跃的计算任务,不可能长期保管已下线用户历史记忆。
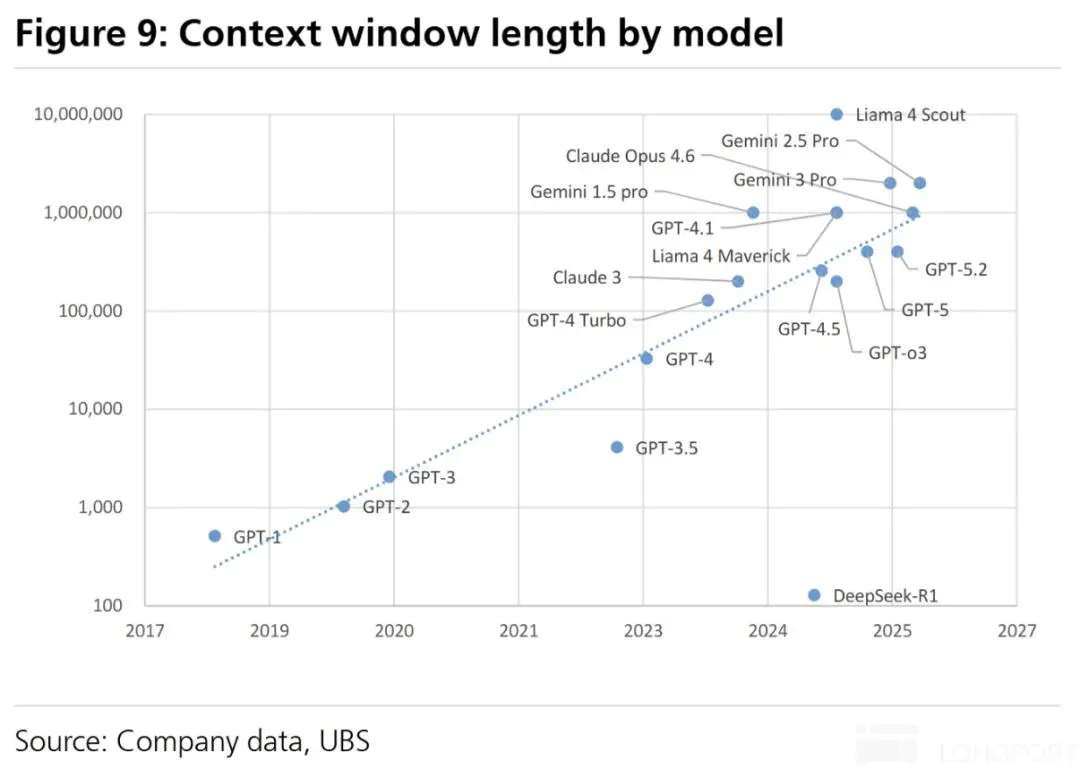
但长文本时代推翻了这笔账:从 2020 年 GPT-3 的 2K Token 到 2026 年主流模型的百万级上下文,六年暴涨 500 倍。重算一次百万 Token 的 KV Cache,要让昂贵的 GPU 满载跑好几秒,有算力与电费代价。
这直接促成 KV Cache 的“再定性”:英伟达 ICMS(推理上下文内存存储)架构,正式把它从“算完即弃的临时缓存”改定义为“AI 原生持久数据”。
现在,临时缓存变长久缓存,这个账是否算得过来?
a. 容量约束: 算法压缩也赶不上KV Cache膨胀速度
第一个条件,是 HBM 的扩容速度远追不上 KV Cache 的膨胀。
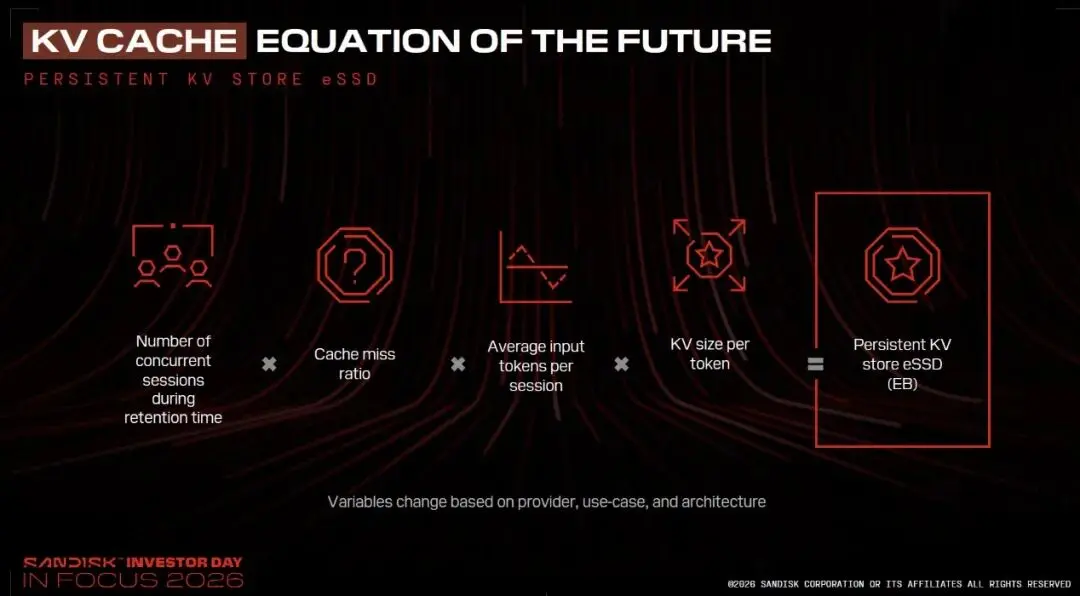
KV Cache 总量 = 上下文长度 × 并发会话数 × 单 Token 存储量。目前,前两个变量都在被急剧放大:
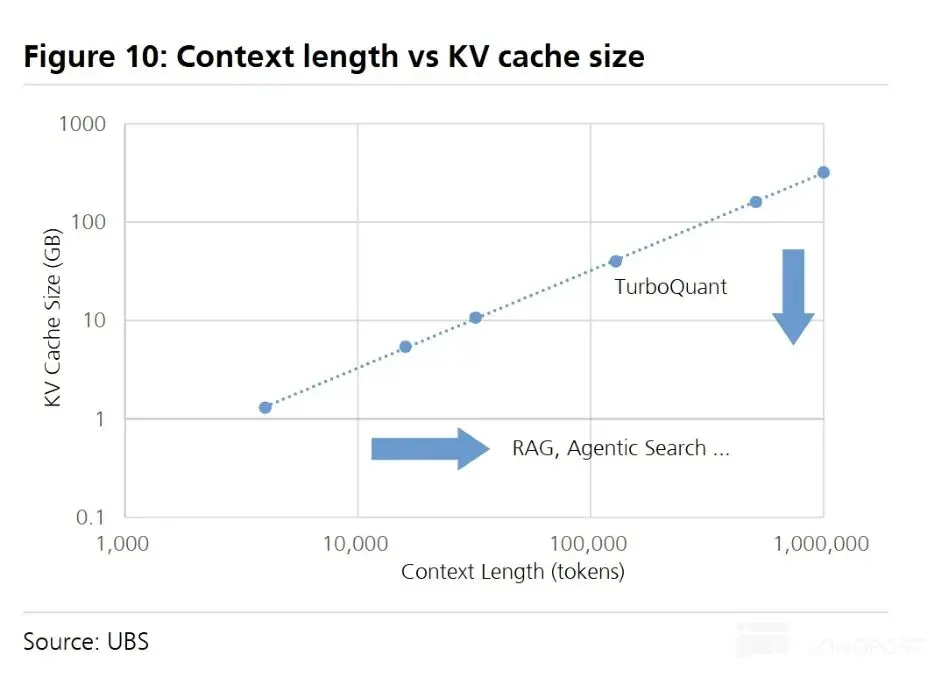
上下文长度每年翻倍以上:主流模型从 4K、128K 快速演进到 1M+,KV Cache 随之线性放大。
并发与推理轮次爆发——正被三种应用架构急剧放大:
a. RAG(检索增强生成): 问一句话,后台塞进两本书。系统把检索到的大量文档拼接到输入端,送进 GPU 的 Token 远超原始提问,单次任务的 KV Cache 直接拉爆。
b. Agentic Search: AI 从“一问一答”变成自主循环的“规划—调用—评估—再检索”。多步任务把单次 Token 消耗从数百个拉到上百万个。
c. Multi-Agent: 多个 Agent 并发协作,每个独立生成 KV Cache,存储需求随数量成倍叠加。
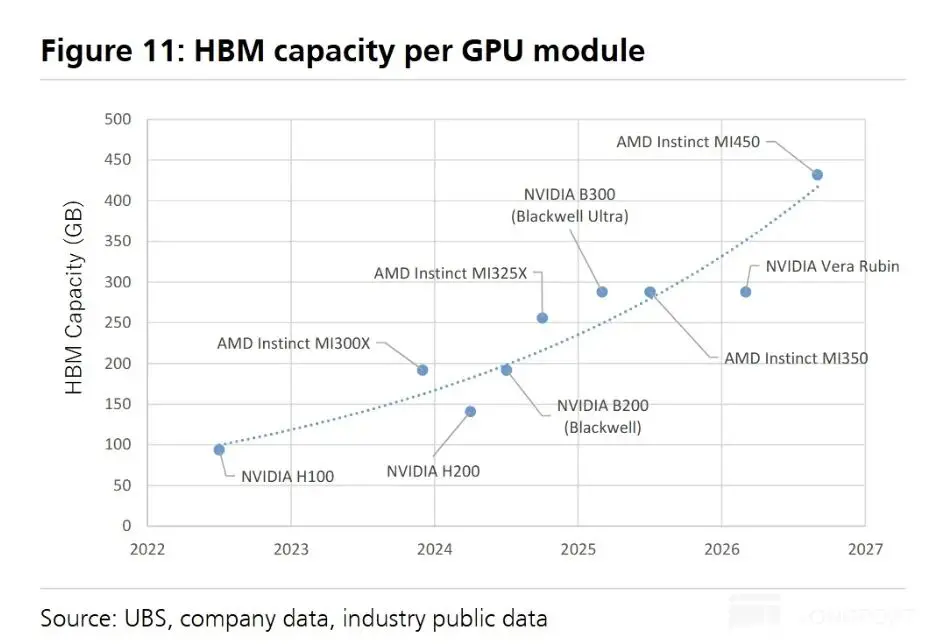
模型厂商每年至少把上下文扩大一倍,HBM 的物理扩容却接近极限:单卡容量约 2-3 年才翻一倍,红利还在放缓。

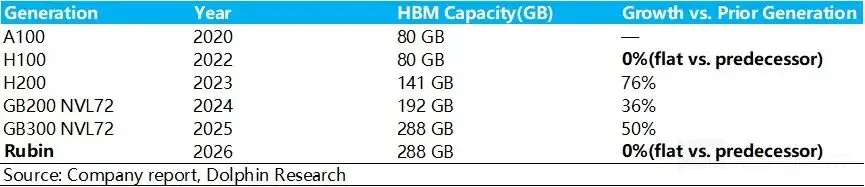
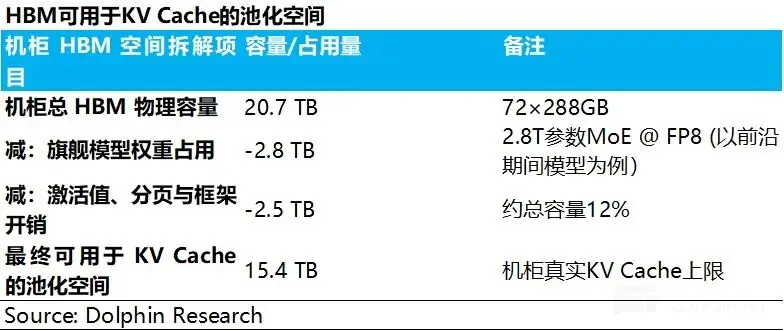
判断 KV Cache 会不会溢出,要以单个推理机柜的可用 HBM 池为单位。以 Rubin NVL72 的21T的HBM容量为例:
部署 2.8T 参数的旗舰 MoE 模型,FP8 下权重占约 2.8 TB;再扣掉激活值、分页与框架开销(约占 12%,约 2.5 TB),真正能给 KV Cache 的池化空间上限约 15.4 TB。
不压缩时,10 万 Token 约占 40 GB。即便用最前沿的压缩算法(如谷歌 TurboQuant,16 位压到 3 位、约 5–6 倍无损压缩),100 万 Token 仍要占 67–80 GB。
也就是说,一台造价约 500 万美元的机柜,极限只能同时服务 193–230 个百万 Token 级长度得会话。对企业级云服务而言,这意味着极低的算力变现效率(ROI)。
一旦上下文扩到 500 万 Token,或并发突破这一阈值,机柜级 HBM 池会迅速触顶。因此把 KV Cache 从 HBM 逐级卸载到 DRAM 再到 NAND,往后看是一场必然之路。
b. 便宜,也是致命吸引力
哪怕 HBM 容量勉强够用,用它长期留存 KV Cache 在经济上也不成立:HBM4 约 16 美元/GB,eSSD 约 0.3-0.4 美元/GB,前者是后者的 40-50 倍。用它去放几小时都不调一次的“温/冷 KV Cache”,是极度的资源错配。
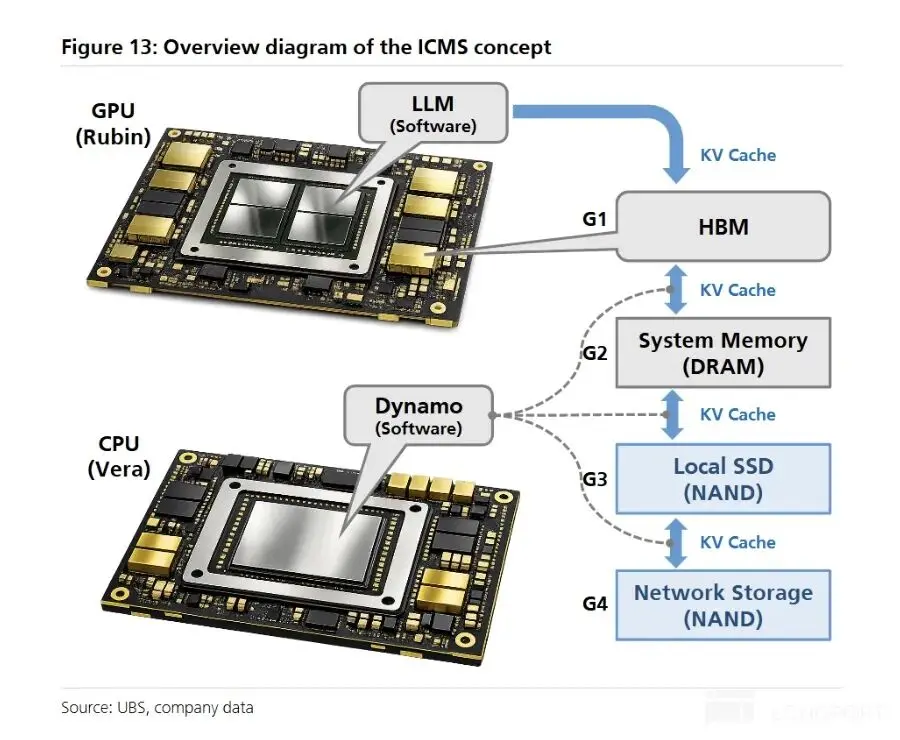
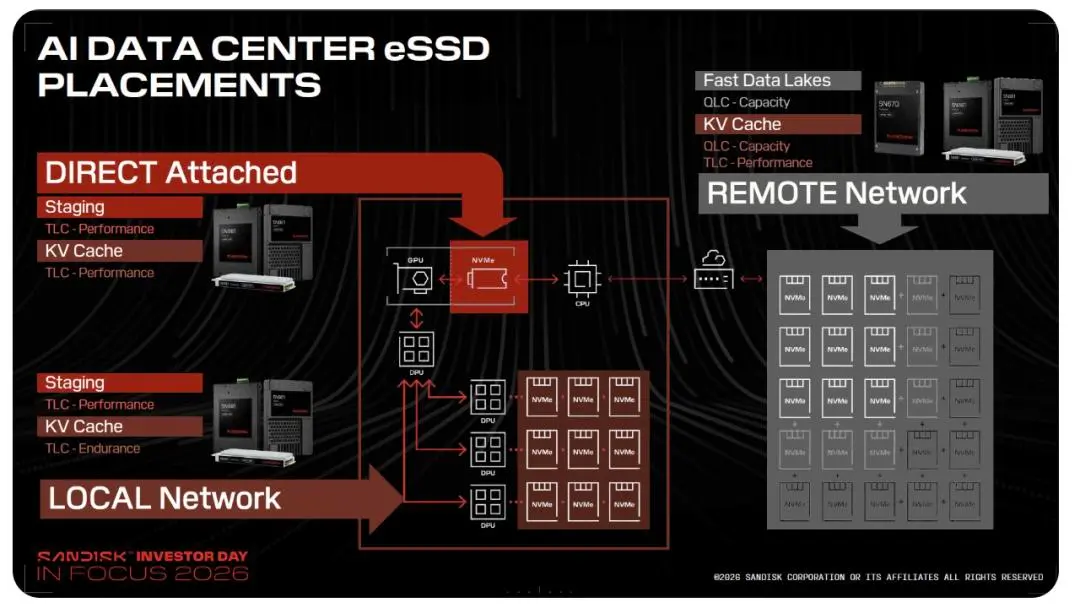
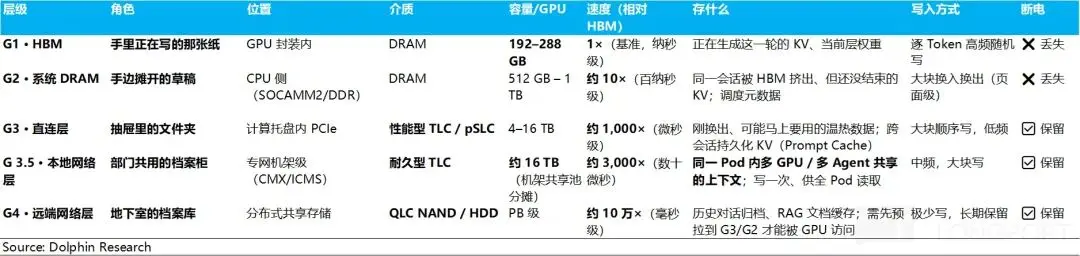
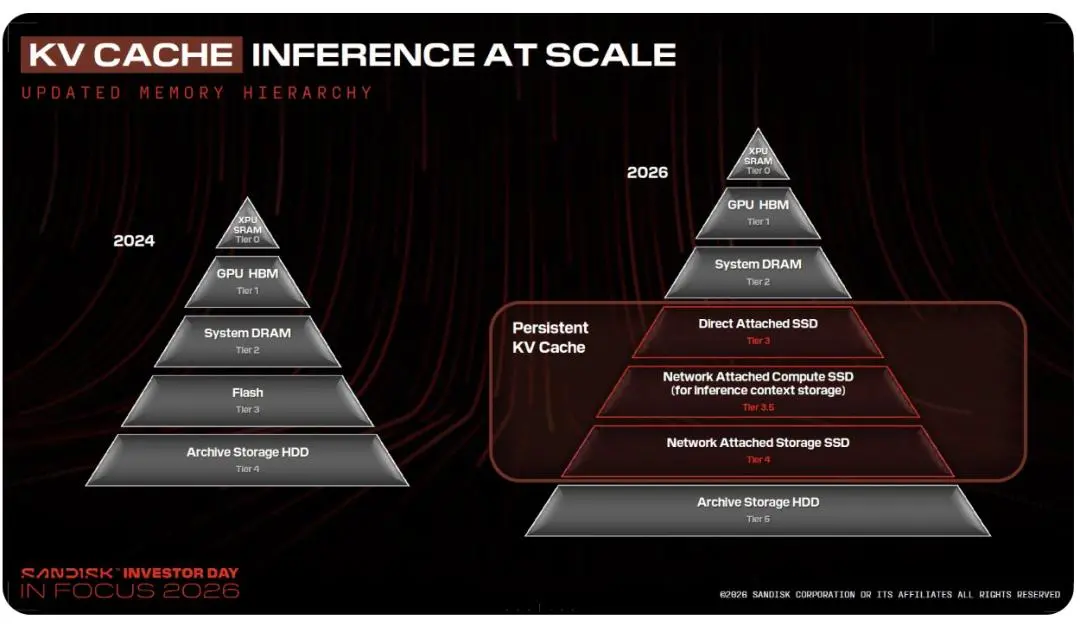
为此英伟达确立了新的分层内存架构:G1 HBM → G2 系统 DRAM → G3 本地 SSD(NAND)→ G4 共享网络存储(NAND/HDD),由 NVIDIA Dynamo 在软件层统筹,让 KV Cache 在各层间透明迁移。
英伟达估计,大规模多智能体推理下每个 GPU 模组最高需要 16 TB 的 KV Cache,因此在 Rubin 平台构建了 ICMS/CMX 上下文存储层,位于 G3 本地 SSD 与 G4 共享存储之间,定义为 G3.5 层——因为 G3 容量有限、不能跨节点共享,撑不住多智能体的大规模复用。
CMX 单层容量约 16TB,是单卡 288GB HBM 的近 60 倍——NAND够便宜,才能做到量大不贵。
c. 改用NAND,时延上来得及吗?
卸载值不值得,最终看 TTFT(首 Token 时延)——只有“从 SSD 读回来”的时间和成本低于“用 GPU 重新算一遍”,卸载在商业上才成立。
GPU Direct Storage(GDS)是跨越门槛的关键:它绕过 CPU 和 DRAM,通过 PCIe/RDMA 在 eSSD 与 GPU 的显存之间修一条直连高速路。
据公开验证,GDS 结合压缩技术可把 KV Cache 的恢复时延改善 10 倍,让超低时延的上下文交付在工程上成为现实。
NAND存储KV Cache的数据类型:“共享型记忆”和高频复用
即使跨过容量与成本的门槛,KV Cache 要卸载到 NAND里,还需满足两个条件:
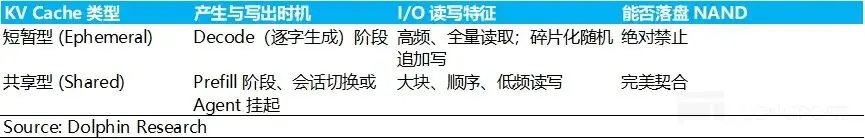
条件一:必须是共享型缓存
a. 短暂型缓存(逐字生成的草稿):HBM承载
AI 逐字回答(Decode 阶段)时,每吐一个字都要全量重读历史上下文。此时强行写 SSD,一是带宽不够、会卡死 AI“说话”的节奏(速度墙),二是高频碎片化追加写几周就能耗尽企业级硬盘的寿命(寿命墙)。所以这类草稿禁止落盘,必须留在 HBM 显存中。
b. 共享型缓存(静态打包案卷):NAND来存
只有当 AI 刚读完超长提示词(Prefill 阶段)、用户切出对话或 Agent 挂起任务时,产生的才是算完、可整段打包写出的完整上下文。它“块大、顺序、低频”,像整箱搬运定稿档案,与 NAND 大块连续读写完美契合,这类数据才可以NAND层。
条件二:高频复用才能“值回票价”
除了可用,经济也要可行:卸载净收益 = 复用次数 × (重算算力成本 − 读回成本) − (写入成本 + 占位存储成本)
GPU 重算既费电又费算力,已算好的缓存从 SSD 读回,只要被复用 1 到 2 次就能盈亏平衡。挑战在于硬盘空间同样稀缺,只有高频复用的上下文,才值这个存储占位。
这最终浓缩为一个核心指标——缓存命中率:命中率越高,边际服务成本越趋近于零。新请求进来时,系统通过“前缀比对”去硬盘取回备份,跳过最烧钱的 Prefill 重算。
正如 Manus 团队指出的:命中缓存的 Token 比未命中的便宜约 10 倍。普通大模型命中率在 40%–70%(MiniMax 71%、Z.ai GLM5 约 40%),多步执行的 Agent 场景则长期企稳在 95% 以上(DeepSeek 实测 98.7%),实现“写一次、读上千次”的红利。
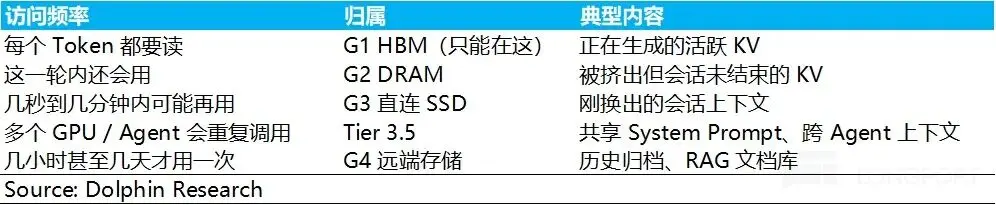
实际使用中,对话变长或 GPU 换用户都会产生中断,当前 KV Cache 就可让出HBM空间。如果这些会话还会被再次调用就可存到 NAND中,服务恢复时再载入。
典型卸载场景包括:用户阅读停顿、跨周期历史回溯、Agent 挂起的长空隙、超大规模并发共享,以及企业级知识库调用。

KV Cache 分层: AI 推理对存储拉动不是单点,而是从高性能闪存(pSLC/TLC)到海量温冷存储(QLC),连同 DRAM 与 HBM,把整条企业级存储产品线一起拉起来。
这条通路上,各类存储分工明确:
DRAM(G2)承接活跃任务的“热溢出”: 它是 HBM 的直接缓冲带,收容同一场活跃会话中因显存触顶放不下的 KV 数据。速度快,会话不卡顿,但断电丢失。
NAND(G3–G4)主导高价值资产的“持久复用”: 跨过断电可保留的门槛后,数据进入非易失闪存主导的持久化复用链路,并沿介质特性逐级下沉:
a. G3 直连层(pSLC/性能型 TLC): 承接刚刚换出、随时可能被重新唤醒的温热会话上下文。
b. G3.5 本地网络层(耐久型 TLC): 承接同一算力集群内,需跨节点高频共享的 System Prompt 与 Agent 状态。
c. G4 远端归档层(大容量 QLC/HDD): 承接海量、极低频调用的 RAG 企业知识库与历史对话归档。
② Staging 场景:TLC 与 pSLC 的刚性基本盘
据闪迪测算,Staging(类似候场类数据,等待被HBM随时调用) 占 2030 年 AI 数据中心 NAND 需求的 40%,是最大的单一板块,且全部由 TLC(含 pSLC)包揽。
打个比方:从数据湖调出的数据,先存在紧贴 GPU 主板的高速 NVMe SSD 缓冲区(G3 直连 SSD)。像厨师案板旁的切菜盘——食材从冷库取出先放手边,不必每切一刀跑一趟冷库。
a. 训练侧 Staging:突发覆盖写
核心任务是给模型做“定时存档”(Checkpoint)与数据集暂存。训练万亿参数大模型时,单次存档高达 TB 级,且每隔几十分钟就要滚动保存一次。
虽然现在能让 GPU“边算边存”(异步存档)、不必停工干等,但这么大规模的集中落盘依然会严重挤占带宽;存档拖得越久,对计算流水线的干扰越大。
所以训练侧 Staging 面对双重约束:既要扛住反复覆盖写入的磨损,又要把写入窗口压到最短。
b. 推理侧 Staging:高并发读取
推理侧 Staging 的三大任务,共同特征是读密集、写极少:
模型冷启动与弹性伸缩:训练机可按月连轴转,但推理机却要随早晚高峰频繁调节容量和开关机,而内存又断电即失。所以新节点上线,都要靠本地 SSD 的强连续读取带宽把参数瞬间搬进空显存,实现“秒级接客”(一天可能触发数十次重载)。
多模型/多版本动态常驻:生产节点常需同时伺候几十 TB 的“全家桶”(不同尺寸、精度、版本)。单卡显存(288GB)和系统内存与之差一到两个数量级,唯有 4–16TB 直连 SSD 装得下整套工具箱。让极少调用的旧模型霸占昂贵显存是错配,下沉至 SSD 换入换出才是最优解。

面对这种极端的 I/O 强度,各类介质逐一被淘汰:
HBM & DRAM:成本极高且容量稀缺,必须留给活跃的 KV Cache;更致命的是 DRAM 断电即失,而 Checkpoint 的意义恰恰是“系统崩溃后还能恢复”。
HDD:吞吐量跟不上 GPU 突发的大块写入,且受体积与功耗限制,根本进不了 GPU 计算托盘所在的机柜。
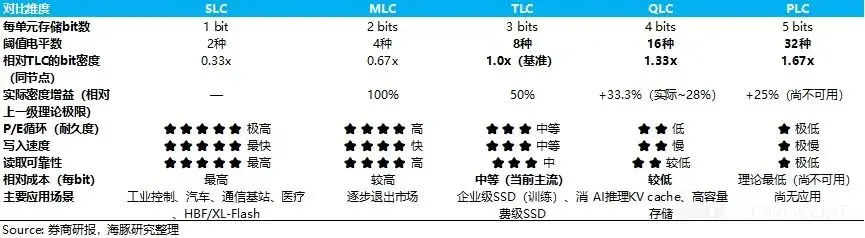
QLC:擦写寿命约为 TLC 的十分之一(QLC 约 1,000 次,TLC 约10,000 次)。Staging 是 AI 存储栈中写入最重的环节,QLC 寿命会迅速耗尽——这是硬约束,而非成本权衡。
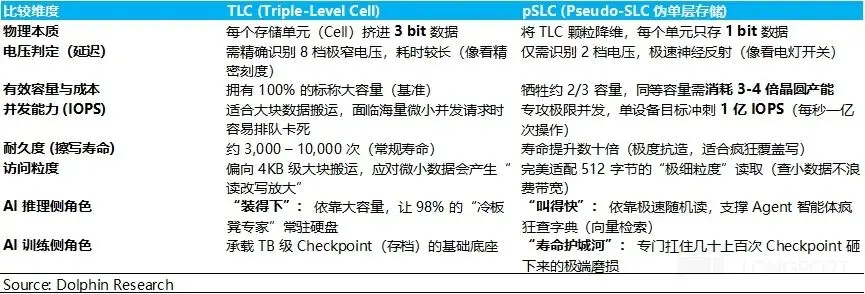
这样,TLC 正好适合 Staging,但TLC在部分场景下还不够,由此衍生出pSLC:
pSLC,是把 TLC 或 QLC 颗粒当 SLC 用——本可存 3 bit 或 4 bit 的 Cell 只存 1 bit。换来更长的耐久度和更低的写入延迟,代价是牺牲约三分之二有效容量。
直接后果是:要达到与标准 SSD 相同的有效容量,需要 3-4 倍晶圆产出。核心触发场景是 RAG 与 Agentic Search 的高频向量检索。
AI 智能体做大规模向量检索新特征(如下),逼着 NAND 必须以高速 pSLC 模式运行:
a. 找得太碎(访问粒度极细): AI 搜索知识库时往往只需比对一小串特征(几百字节)。但标准 TLC SSD 是个“死脑筋”,哪怕只要一个字,也得把整页(4KB)全读出来,浪费读取带宽。
b. 问得太密(并发强度极高): 现在的 AI 会自己做计划、调工具、反复查资料,单次任务瞬间裂变成成千上万个密集的“查字典”请求。标准 TLC SSD 在高并发下迅速排队饱和。
c. 边读边写(读写双向承压): AI 智能体会一边查一边更新索引、记录中间状态。这种“一边翻书一边做笔记”的强度会让普通 TLC 寿命快速耗尽,而 pSLC 寿命是它的十几倍。
但承载这一层的下一代直连架构——NVIDIA Storage-Next(G2.6 层,位于 G2.5 CXL 内存之下、G3 本地 SSD 之上)——仍处在英伟达主导、与铠侠等厂商协同定义规格的阶段。
它的定位,是在 DDR与本地 SSD 之间新增一层 直连GPU的pSLC 存储层,让 NAND 具备接近 DRAM 的 IOPS 与访问粒度(512B 细粒度随机访问),同时保留低成本、大容量优势。

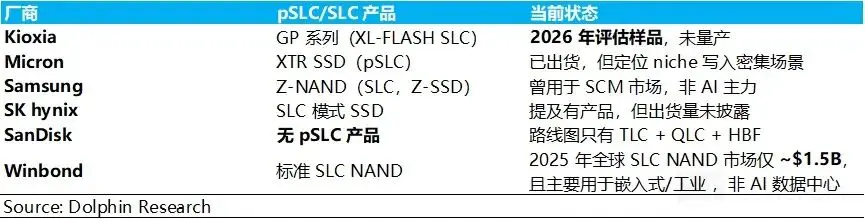

③ Fast Data Lake 场景:QLC 的主战场
如果说 GPU 直连 SSD 是案板旁的“切菜盘”,存储需要读写双能。 G4 远端网络层的 Fast Data Lake(快速数据湖)就是 AI 数据中心的“远端中央总仓”,以读为主:以 PB 级容量装下 AI 运转所需的全部“家底”——训练语料、多模态数据集、各版本模型权重、RAG 知识库和推理回流日志。
按闪迪 2030 年的需求拆分,Fast Data Lake 约占 AI 数据中心 NAND 需求的 25%,几乎全部由 QLC 承载。
核心问题是:QLC 能否替代 HDD?海豚君认为需从以下维度分析:
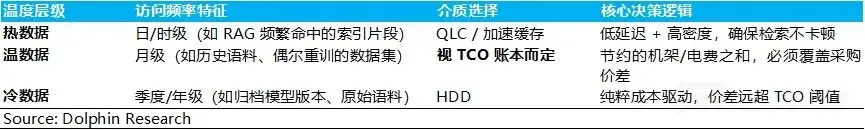
a. 热数据——QLC 稳坐主位
正在被 CPU/GPU 高频消费的数据(如正在处理的训练集、等待检索的 RAG 知识库),需要极高的数据吞吐量。
HDD 的机械磁头寻道延迟(毫秒级)与 AI 所需的微秒级响应差了两个数量级,从一开始就被物理排除。QLC 凭借超大容量和读写带宽,在此层是替代的绝对主力。
b. 温冷数据:HDD坐主桌
对于“存着备查”和“历史归档”类数据,是否放入 QLC 取决于两个维度:
①供给侧扰动:短期“假性替代”
短期 HDD 将出现 300EB 至 400EB 的供给缺口。当前部分云厂商用 eSSD 临时兜底,造成了“加速替代”的假象。
但 HDD也能用类似SSD的技术持续拉升产能,被 eSSD 临时接管的纯容量需求回流 HDD,替代逻辑变弱。
②经济账:QLC涨价后算不平
短期因缺货有替代迹象,但后续QLC因热数据层的替代是刚需,导致QLC涨价。当下HDD 的每 GB 价差已飙升至 20–25 倍。在稳冷层数据存储中,QLC反而难取代HDD。后续要QLC出现大容量低成本的产品面世后,替代概率才可能加大。
因此 QLC 替代 HDD 绝非单向线性推进,而是分化为三种叙事:
a. 性能关键路径(热数据)上,替代已经完成且不可逆;
b. 温冷归档层,高昂价差阻断了正常置换,目前的“替代份额”更多是 HDD 缺货逼出的“临时补位”,未来面临回流风险;
c. 长期胜负手在于大容量高密度QLC 量产,能否靠极致“空间与能耗压缩”,在 TCO 上跨过 2-3 倍的替换红线。
据闪迪业绩会,超大容量 QLC 在 FQ4'26(2026 年 4-6 月)刚产生首批收入,FQ1'27 进入早期爬坡。闪迪预计 QLC 占整体 bit 出货的比例,从 2025 年约 20% 升至 2026 财年末的 40%,主要由 Stargate (超大容量QLC)在云厂商放量驱动。

④ HBF: 需求上行期权
在传统 AI 存储层级中,紧贴 GPU 的 HBM虽有百纳秒级延迟与超高带宽,但受 DRAM 制程限制,单堆栈容量小、成本高;再往下到 NVMe SSD,延迟与带宽又出现严重断层。
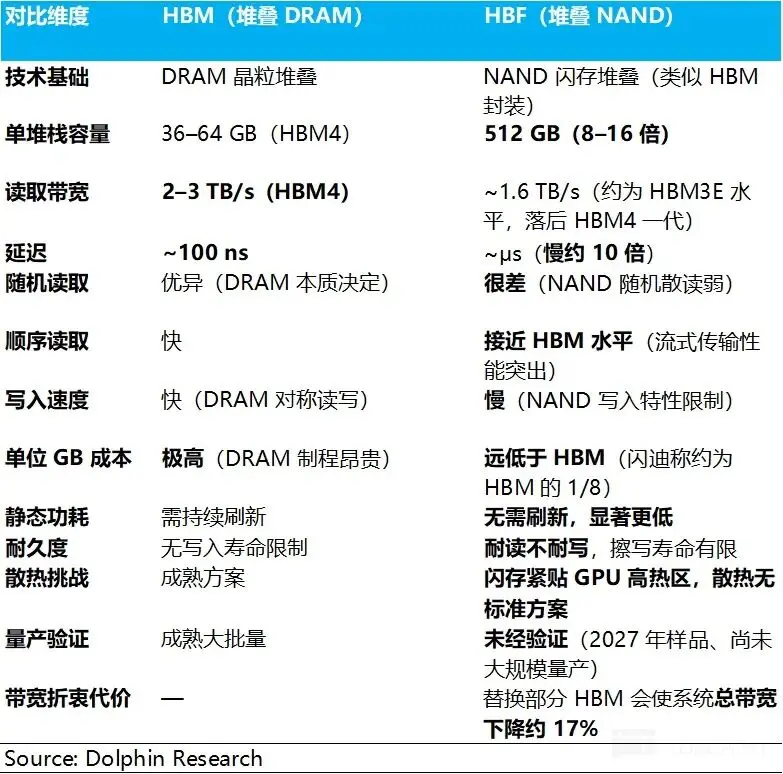
NAND厂商现在在努力推新品:HBF(High Bandwidth Flash)——它的结构基本是HBM的复刻:多层堆叠、TSV贯通连接上下、与XPU共同封装,只是把DRAM颗粒换成了NAND颗粒
闪迪正开发的 HBF,号称堆叠 16 层 NAND、在维持 HBM 级带宽的同时把容量放大 8 倍。(参考:从 HBM 限高到 NAND 加量,英伟达 vs 存力到底谁拿捏谁?)。

HBF 与 HBM 并非简单替代关系,而是基于物理特性的优劣互补:
HBF优势是容量大,成本低,但短板同样明确:微秒级延迟让它反应偏慢,不擅长细碎的随机散读;且有物理擦写寿命上限,只能当“只读参考书”,扛不住高频写入。
此外 HBF 仍在工程推进期:2026 年下半年进入试产建线、预计 2027 年商业化,但紧贴高发热 GPU 部署的散热标准仍待确立。
由此形成分工:
HBM 专注“性能至上”,是旗舰 GPU 的绝对标配,负责对延迟极敏感的预填充(Prefill)阶段、高频读写的活跃 KV Cache,以及要求最高对称读写带宽的训练任务。
HBF 主打“容量为王”,接管以顺序读取为主的常规推理、需单机容纳全量模型的长文本与 MoE 场景,以及读多写少的温冷 KV Cache 卸载,让中低端 GPU 甚至未来的边缘设备也能跑超大模型。
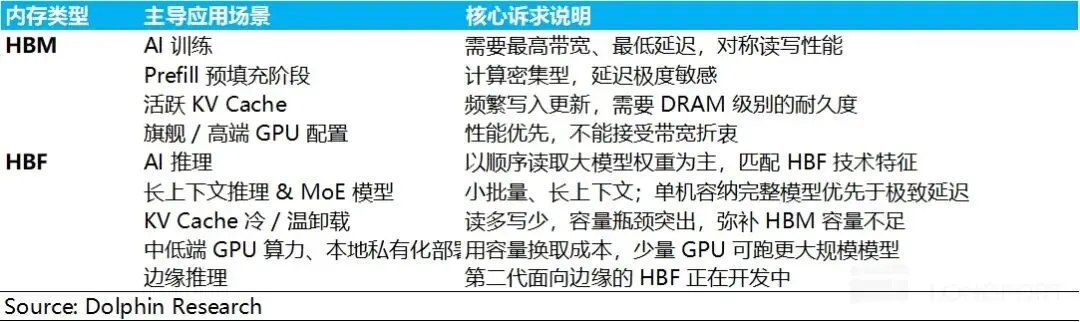
因此海豚君认为,HBF 不是颠覆 HBM,二者共存互补——HBM 管延迟敏感的热数据,HBF 管容量饥饿的温数据。未来HBF的使用渗透还要继续观察。
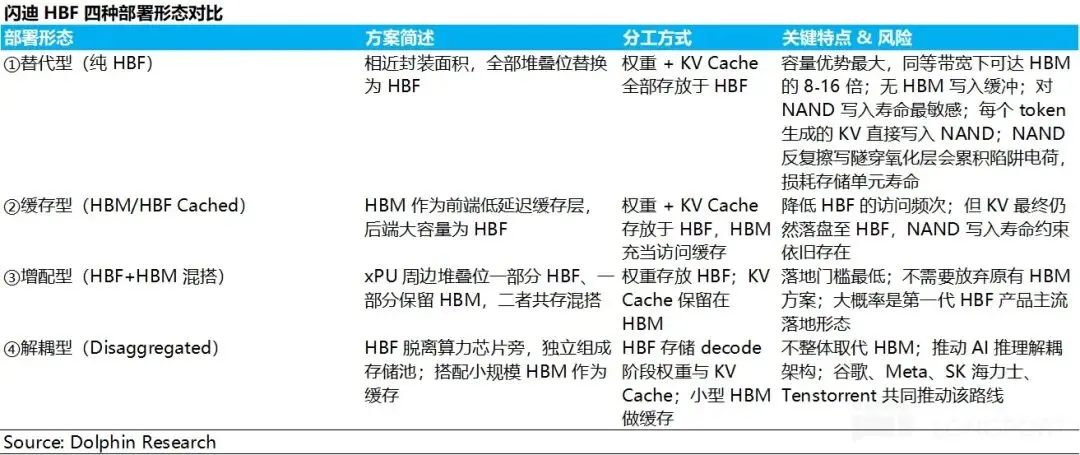
闪迪将 HBF 分成四种部署形态,具体定义可见《AI 推理大爆发,“悲催” 闪迪真有凤凰涅槃?》。海豚君认为,③ 增配型(HBF+HBM 混搭)和 ④ 解耦型(池化)落地可能性最大。
增配型的逻辑最简单:HBM 不撤,HBF 加进来一起用。GPU 厂商不用大改,HBM 继续干擅长的活,HBF 在旁边装权重和冷 KV 缓存。SK 海力士新提的 H3 架构就是HBM和HBF混搭——2027 年量产、2028 年客户上车,是目前阻力最小的路。
解耦型则是把 HBF 从 GPU 旁独立出来,像硬盘柜一样池化部署、通过网络连接计算单元。这是未来大方向——NVIDIA 的 CMX 方案推的也是类似的机架级存储池;但它要求网络架构跟着升级,预计 2028 年之后才可能成为实际选项。

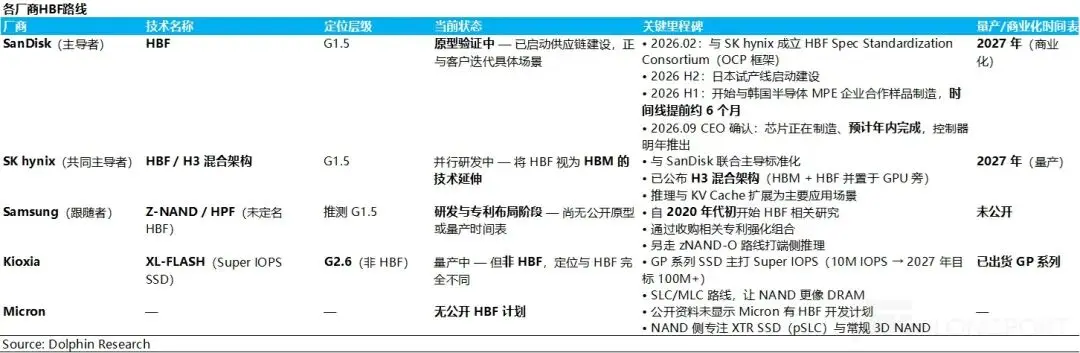
从各厂商路线来看,HBF 目前仍处于标准联盟阶段,尚未进入 GPU 厂商(特别是 NVIDIA)的官方架构标准中。
闪迪与 SK 海力士是当前唯二的实质推动者:双方已于 2026 年初成立标准联盟并建起试产线,比原计划提前半年——预计2026年底造出芯片,明年推控制器,2027 年冲刺量产。
谷歌、英伟达、AMD 等最早要到 2028 年才可能作为客户采用,但采用≠定义——HBF 真正进入 GPU 厂商的架构体系,还要过标准认证、参考设计集成、生态适配等关卡。
其他厂商:三星有专利储备,但未公开原型与时间表;铠侠走 XL-FLASH 路线(G2.6 Storage Next),与 HBF 不直接竞争;美光暂无公开计划。
总体看,HBF 产业化时间线虽在加速,但格局本质是“存储厂商在推动,GPU 厂商尚未上车”。真正的分化要等 2027 年样品表现,以及 2028 年头部客户是否正式将其纳入系统设计。
总结:
AI 对 NAND 的重塑,不只是把需求曲线抬高一个台阶,确实有希望打破“硅周期”宿命: “算力部署与推理负载主导”下,NAND 也从“外围零部件”变成“计算路径上的必需品”。
在“由训转推”与长上下文时代,用NAND存 KV Cache 是保存昂贵的 GPU 算力与电费资源,SSD 一定程度上就是“Token 电池”。
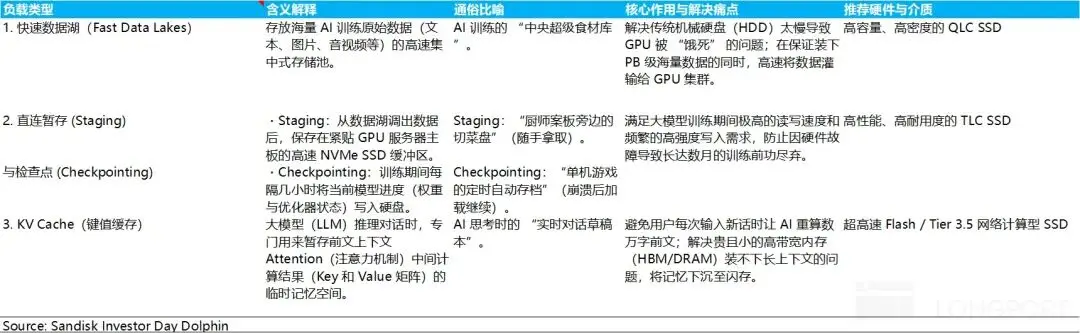
据闪迪测算,2030 年 AI 数据中心 NAND 出货量将达 1.2 ZB(较 2026 年增长约三倍),三大核心负载分工明确:
a. Staging 暂存层(占比 40%):贴近 GPU 的极高强度 I/O 缓冲区,受极端覆盖磨损与高并发限制,由高性能 TLC(及 pSLC)垄断。
b. KV Cache 卸载层(占比 35%):推理时代全新增量,承载HBM 溢出的动态存储容量,由 TLC/QLC 梯次承接。
c. Fast Data Lake 快速数据湖(占比 25%):远端中央数据总仓,由大容量 QLC 稳坐主位。
按 NAND 类型计,TLC 占 66%、QLC 占 34%:占比最大的 Staging 因写入强度,天然排斥 QLC,TLC 稳占基本盘;QLC 聚焦数据湖与温冷 KV Cache 卸载。
这三类负载的演进方向恰好相反:数据湖向“更便宜”走(QLC 容量放大),Staging 与热路径则向“更快更耐用”走(TLC 乃至 pSLC,牺牲约三分之二容量换取 10 倍耐久性)。
而这波涨价的“超级行情”还能飞多久?站在当前估值节点,涅槃后的闪迪是否仍有向上空间?海豚君将继续在下篇为您拆解,敬请期待!

本文来自微信公众号 “海豚投研”(ID:haituntouyan),作者:海豚君,36氪经授权发布。