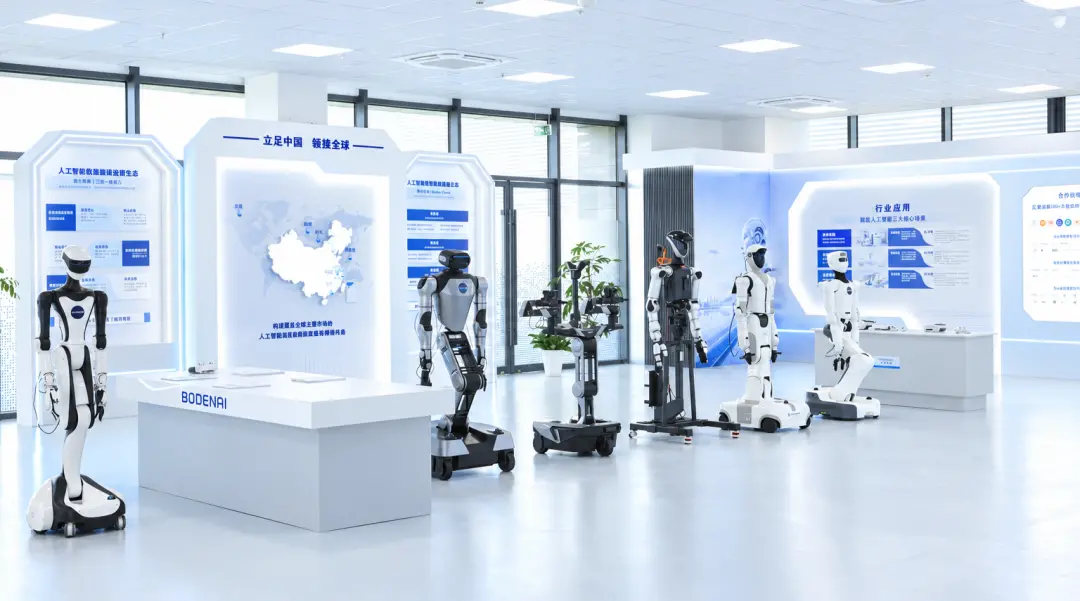
从一只手的重建开始,把真机数据推向开源与海外。
作者|寇雨然
编辑|栗子
这周,IROS 2026(IEEE/RSJ国际智能机器人与系统会议)在美国匹兹堡举行。今日,北京时间晚10:30,宁波博登智能科技有限公司创始人&CEO赵捷将在会议上发表主题演讲《ChronoHand:Streaming Egocentric Hand Reconstruction with Closed-Loop Geometry》,介绍第一人称视角(Human-centric Data)数据中的手部重建方法ChronoHand。
博登智能总部位于宁波,专注于人工智能数据基础设施生态建设,致力于构建连接人工智能与真实世界的核心基础设施体系,为具身智能、大模型、自动驾驶及下一代人工智能系统提供规模化真实世界数据、训练环境与现实场景验证。
在IROS期间,除了ChronoHand的技术分享,博登智能还将公布开源数据集、产学研合作和数据出境等进展。
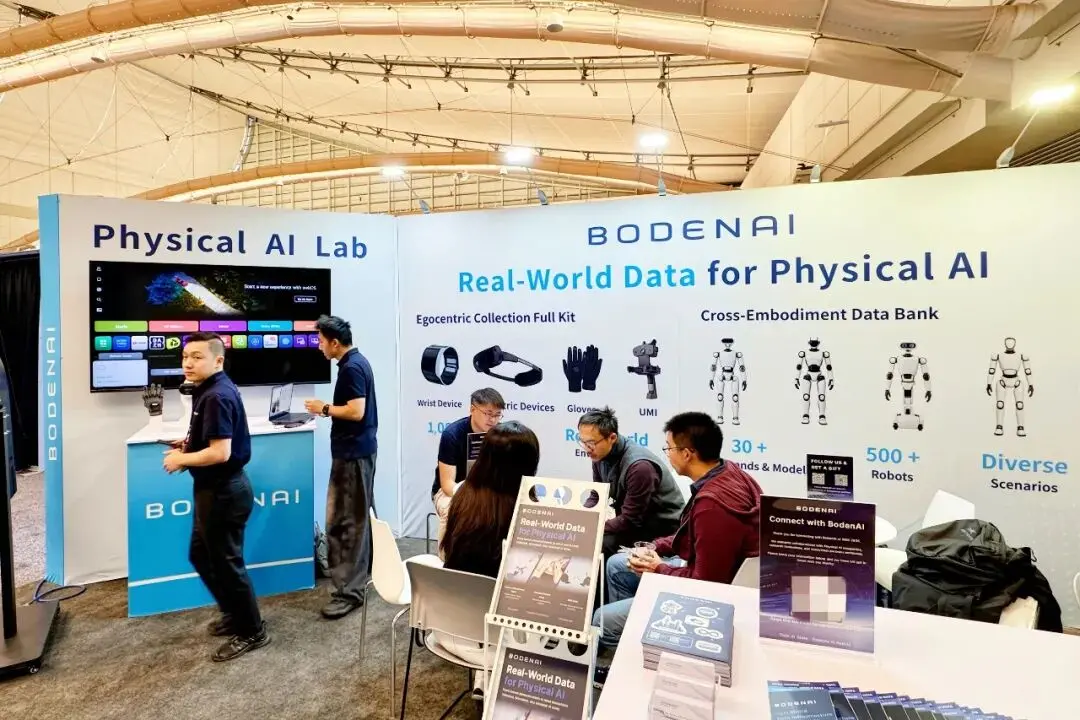
博登智能IROS展位,图片来源:博登智能
今年6月,博登智能联合均普创新中心、上海交通大学MINT实验室开源了RW-RL-Dataset;9月,又开源了聚焦人类干预数据的子数据集RW-RL-HIL-Dataset,并完成了数据出境备案。这些信息,可以观察到一条从算法突破,到数据产能落地,再到全球流通网络搭建的完整路径。
这条路径也切中了具身智能赛道正在发生变化:行业逐渐意识到高质量真实交互数据才是决定机器人能力上限的关键。行业内的竞争也逐渐从模型转向数据,从项目交付转向基础设施构建。
而在具身智能的数据采集中,Human-centric数据正成为主流。与第三人称的外部相机相比,第一人称视角能提供最贴近机器人实际执行时的观测分布,是解决Sim-to-Real鸿沟的关键。
然而,有效利用Human-centric数据也存在难题。这类数据不同于真机数据可以直接让机器人使用,而是需要先对采集的视频数据进行处理,识别、重建其中的动作。
人类在理解物体位置时,大脑能借助双眼视差、运动视差、透视等信息,推断出三维空间关系,但相机给到机器人的RGB图像只有二维信息。所以必须通过手部重建从Human-centric 视频中恢复可执行的三维动作,这类数据才能真正被利用起来。
而在Human-centric数据中,手部重建是关键,也是难点。人手往往涉及复杂精密的操作,直接决定了能否成功执行任务,只有先准确重建人手姿态、关节轨迹和手-物交互,才能把视频中的操作转化为机器人可学习的动作监督。
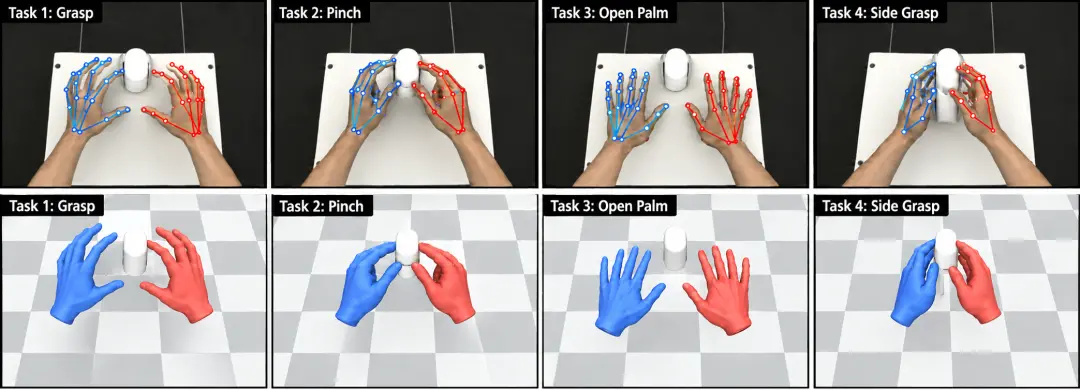
第一人称视角的手部重建,图片来源:博登智能
因此,手部重建不仅是关键,其精度也直接决定了后续动作标签和策略学习是否可靠。但由于手部关节多,且操作往往存在遮挡,同时视频还会有运动模糊,所以这部分的动作重建往往比其他位置更加困难。ChronoHand手部重建算法正是为了解决这些难题而提出的。
1.ChronoHand:
Human-centric数据破局,
手部重建的精度与稳定性

行业目前的手部重建方法,普遍存在精度与稳定性难以兼得的困境。单帧推理方法虽然精度高,但在连续视频流中极易产生抖动。
一些方法引入时序优化来平滑这种抖动,却往往牺牲了空间精度——抹平抖动的同时,连同手的突然转动、手指快速收拢等真实物理变化也一并抹掉了。所以算法必须分清哪些变化来自真实动作,哪些来自重建误差。
博登智能的ChronoHand正是这一痛点的工程化解法,将双分支解耦、时序驱动、闭环优化融合在同一架构中。
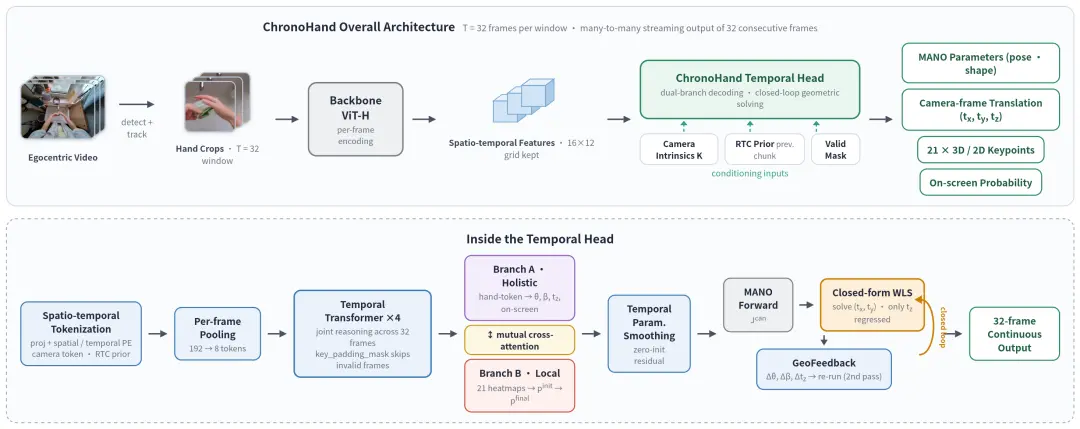
ChronoHand整体架构,图片来源:博登智能
传统模型通常让一个网络同时预测手部姿态、深度和平移位置,但这几项任务对网络的要求并不一致:姿态估计需要高分辨率的局部细节,深度和平移判断则更依赖全局尺度和空间关系。再加上单目图像本身存在尺度歧义,多项损失很难同时收敛,训练时容易出现多个梯度互相拉扯的情况。
ChronoHand用双分支解耦拆解了这个矛盾:一个负责整体估计,输出全局姿态、形状参数与深度,确保对动作意图的全局连贯理解;另一个专注维护高精度的位置热力图,保障关节点定位的准确性。两者之间还会进行信息互通,校验全局估计与精确位置能否对齐。
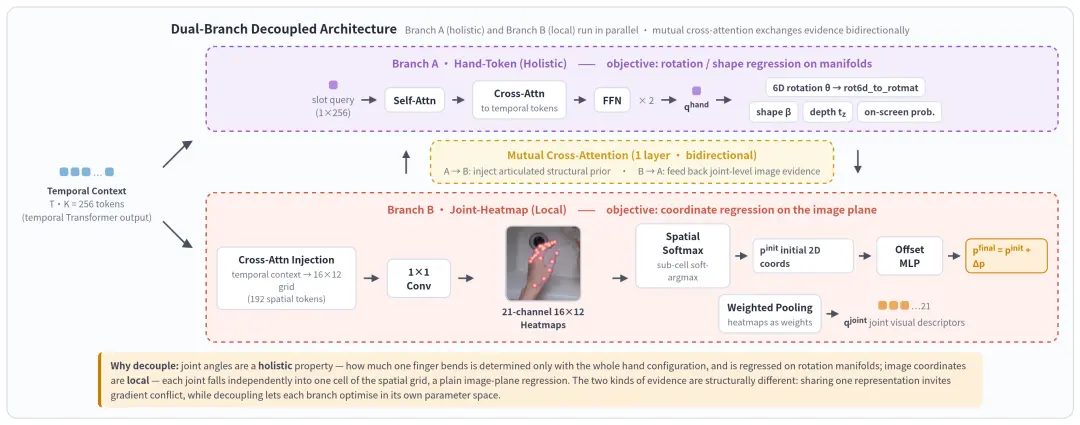
双分支解耦架构,图片来源:博登智能
同时,ChronoHand进一步用时序驱动机制解决了时间维度上的连贯性难题。这种机制并非简单的将相邻几帧的结果做平均平滑,而是让网络学会理解手部运动的物理连续性,在某几根手指短暂离开视线时,根据前后的运动惯性估计其位置。这使得ChronoHand能够在流式输入下,既保留手指快速收拢等瞬态动作,又消除因遮挡带来的不连贯。
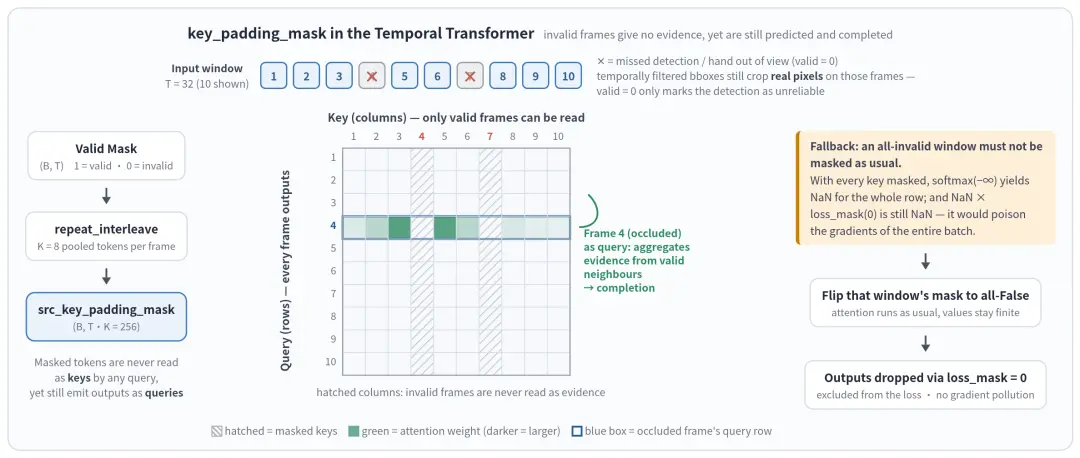
时序驱动机制,图片来源:博登智能
即便有了双分支解耦和连贯的时序驱动,单次预测仍难免产生偏差。为此,ChronoHand引入了闭环优化的几何反馈机制,相当于为模型装上了一套自我纠错系统。在第一遍预测完成后,模型并不会直接输出结果,而是会对姿态、形状和深度的预测进行校验修正,带着这些修正量进行第二遍求解。这种“预测、校验、修正、重解”的完整闭环,使得整个系统在强遮挡、手部重叠等条件下仍能保持鲁棒性。
在ARCTIC评测中,ChronoHand五项重建精度全面超越SOTA:MPJPE-p降至17.04(较前代最优降低20.9%),CT-p降幅达34.0%,且检测FAcc与F1均达到0.997和0.999的持平水准。在单卡60FPS(NVIDIA 4090D)实时推理下兼顾了检测精度与时序平滑,在强遮挡、双手重叠及快速运动等极端场景中也展现出了鲁棒性。
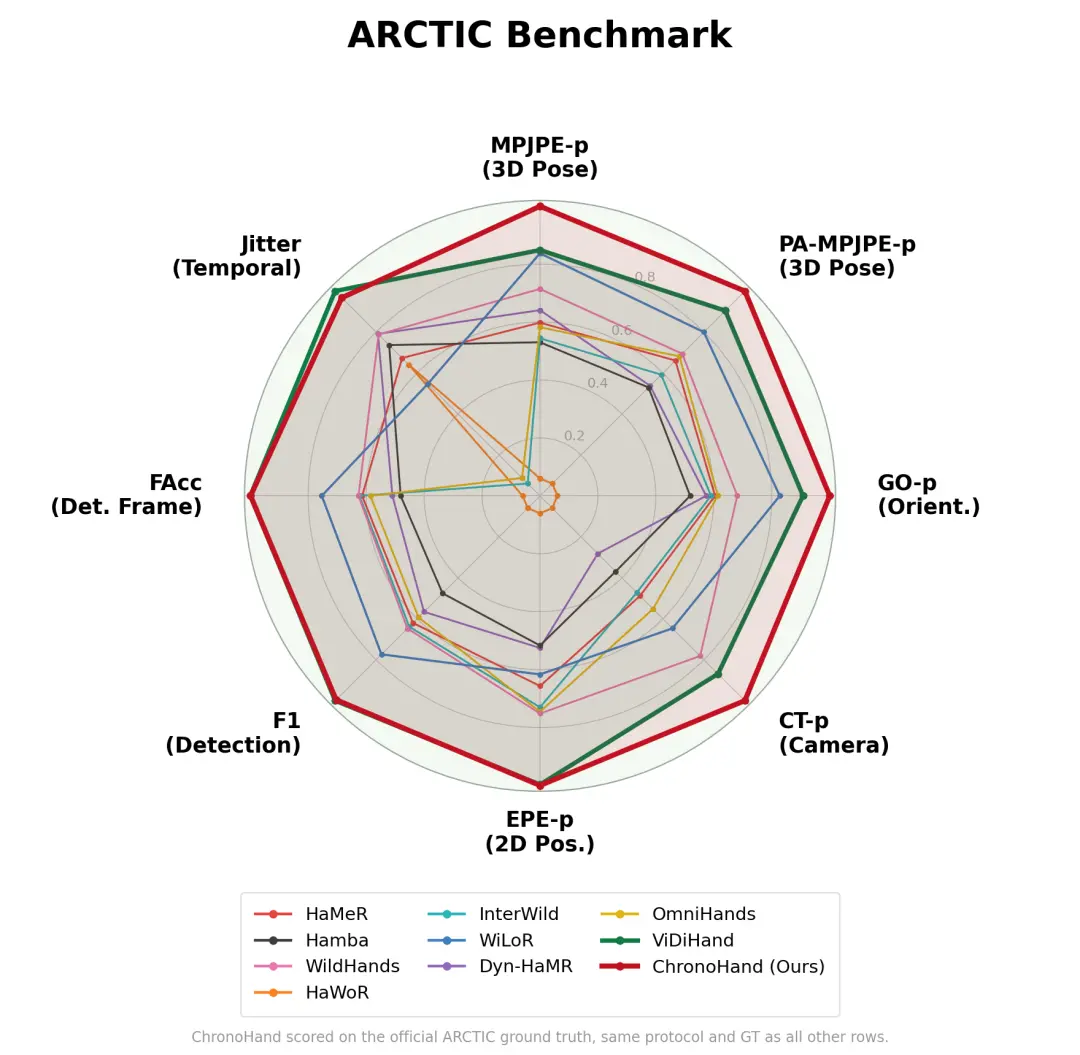
ARCTIC评测,图片来源:博登智能
这些算法的突破验证了第一人称数据工程化重构的可能,但具身智能行业的更大挑战在于:高质量真机数据如何摆脱实验室依赖,实现规模化持续生产?
2.从算法到产能:
真实世界数据的“重资产”逻辑

具身智能与大语言模型、自动驾驶在数据获取上存在本质区别。大语言模型的数据可以从互联网上扒取;自动驾驶的道路资源由政府提供,主机厂只需把车改造后上路,行驶过程中自然完成数据采集。但具身智能不同,它需要进入“千行万业”,每进入一个场景都有成本、有门槛,因为要跟物理世界发生接触,要采集、处理数据。
而物理世界的碎片化场景有着高昂的隐性进场成本(如实景搭建、隐私合规),这构成了具身智能数据获取的天然壁垒。单一终端厂商难以通过自研自采集的“闭门造车”模式,建立起覆盖全场景的高质量数据护城河。
这意味着,在物理世界的劳动与数字世界的模型之间,需要一个独立的中间层,把真实场景中碎片化的物理交互数据,转化为模型可消化、可执行的通用养料。博登智能走的正是这条路。
在数据来源端,博登智能在宁波、湖州、马鞍山等地建成了三大具身机器人创新中心,总面积超过3万平方米。这些创新中心部署了500余台多型号实体机器人及数千套Ego采集设备,覆盖了工业制造、仓储物流、商业零售、家庭服务等百余类真实场景。这意味着其产出的数据不再绑定于单一硬件厂商,具备了更强的通用泛化价值。据披露,该体系已具备年产50万小时真机训练数据和百万小时级Ego场景数据的稳定产能。
在数据处理端,规模化产能必须依赖自动化引擎。博登智能构建了由BRIC数据采集平台、BASE数据标注平台及Blink数据基础设施平台组成的Boden Cloud技术体系。通过自动化质检、物理一致性校验、智能数据流水线三大核心能力,大幅提升数据精度与迭代效率。
在验证侧,针对“仿真完美、实机瘫痪”的行业痛点,博登智能将模型重新放回真实物理场景中,精准捕捉仿真与现实的弥合边界,并实测极端长尾场景的失效极限。这种“Train at Scale, Validate in Reality”的理念,成为了其商业化规模落地的关键基石。
据博登智能官方披露,其目前已累计服务超500家全球科技企业与科研机构,在自动驾驶领域累计处理数亿帧真实道路场景数据,并为多家头部机器人企业提供真实世界交互数据支持。
这套体系为具身智能赛道打造出了一笔可观的物理世界数据产能,但行业并不缺数据量。要从“数据供应商”走向“基础设施”,还需要让数据流通起来。
3.产学研融合与数据出境:
中国AI基础设施的全球化考卷

目前,大多数行业内的数据仍处于“混沌状态”——时间戳无法对齐、模态不同步、标注信息不完整、数据结构不统一。因此形成一套通用的标准,让数据在产业界、学术圈乃至全球范围更广泛的流通、真正用起来是更加重要的事。
目前全球多数具身智能实验室的训练数据仍以仿真环境生成或单一硬件平台的采集为主,跨本体、跨场景的真实交互数据在公开渠道仍是稀缺资源。这限制了具身智能在科研方面的发展。研究者想获取一份覆盖多种机器人、多种任务场景的真机数据集,往往只能依赖与特定企业的合作,缺乏公开的获取路径。
为此,在今年6月,博登智能联合均普创新中心、上海交通大学MINT实验室共同发布了RW-RL-Dataset,向全球开源了1000+小时的不同机器人本体真实任务强化学习数据。
而在9月,博登智能进一步开源了子数据集RW-RL-HIL-Dataset,专门聚焦真实机器人部署中的人类干预(Human-in-the-loop)数据——这类数据记录的是机器人在执行任务失败或不确定时,人类如何介入纠正的过程。该数据集包含82.23小时数据,共3347个回合,其中90%以上的回合包含至少一次的人类干预数据。相比一次性成功的数据,失败后如何修正的人类干预数据往往更为稀缺,但也更能让机器人学习到如何完成真实的,而非一次性的任务。
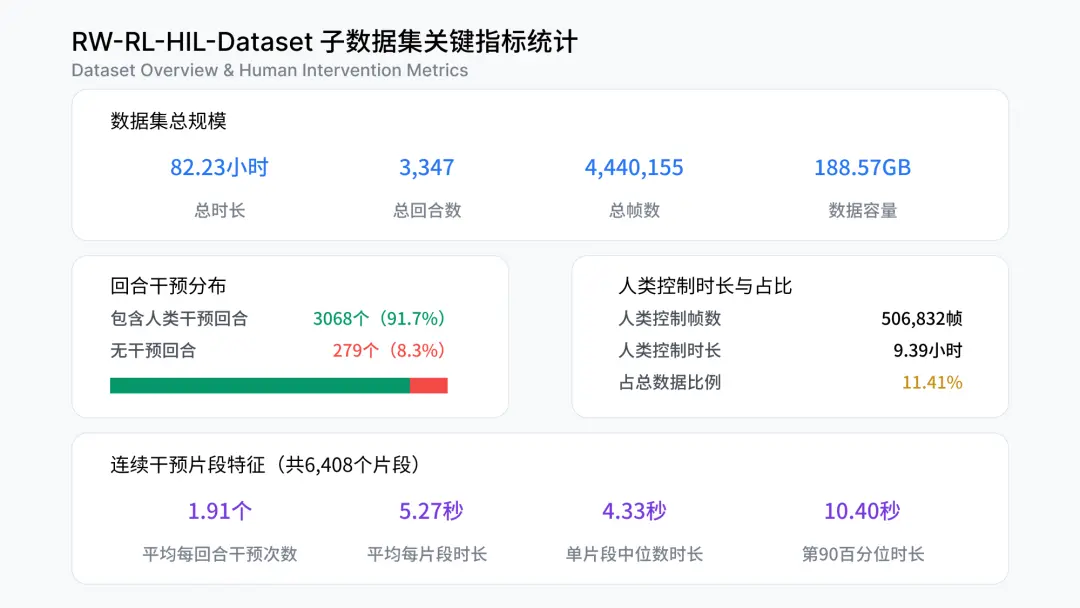
RW-RL-HIL-Dataset数据集关键指标,图片来源:博登智能
博登智能将这部分数据以开源形式释放,降低了学术界获取真机数据的门槛,同时也让自身的数据处理范式有了被更广泛引用和复现的可能。
不过,数据在国内被生产出来,想流通到更广泛的全球范围,还面临数据出境的合规审查这个门槛。具身智能数据包含真实地理环境、物理空间乃至人类行为信息,在全球数据安全监管趋严的背景下,跨境交付并非简单的文件传输。
「甲子光年」了解到,博登智能目前已经完成了数据出境备案,这在当前的监管环境下并非易事,但备案就意味着企业在数据分类分级、安全评估、跨境传输机制等都通过了审查,具备了向海外客户合规交付数据的前提条件。目前,博登智能已在北京、上海、广州、香港设立分支机构,部分业务也已拓展至北美、欧洲、中东及东南亚等区域。
今年,具身智能的竞争正在从算法架构转向高质量、规模化、合规化的真实交互数据。这些数据是决定模型的质量和机器人产业天花板的关键因素。而数据不像模型那样可以靠一篇论文拉开差距,它需要场景、需要设备、需要时间,更需要一套让数据流动起来的机制。
博登智能IROS 2026上的这场演讲,展示了这套机制的一个雏形。从ChronoHand在精度与稳定性上的工程化突破,到超3万平方米创新中心的产能落地,再到开源共享与合规出境的全球流通闭环,这些构成了从生产数据到数据流通的完整链路。
在这场从模型到数据的产业范式迁移中,博登智能作为Physical AI数据基础设施构建者,正以“算法-产能-流通”的全链路能力,牢牢占据全球研发生态的关键生态位。
(封面图来源:AI生成)
END.