AI数学,正在越过一个很微妙的分界线。
过去我们问的是:大模型能不能做出一道难题?能不能写出严谨证明?能不能找到人类几十年没发现的反例?
而现在,一个更像「科研本身」的问题冒了出来:当一条证明路线失败之后,AI知不知道下一步该干什么?是继续算,换路线,缩小命题,还是干脆提出一个新的、可证伪的数学猜想?
思特雅大学的研究人员曾仔健搭建的AI Has Taste,正在试图把这个问题做成一套可持续运行的研究系统。
项目公开仓库目前记录了453份数学研究手稿、2312页内容,其中6篇被明确归类为「AI-Proposed Conjectures」。
仓库首页给出的定位更直接:From Answer Generation to Research-Agenda Generation——从生成答案,走向生成研究议程。
AI把论文里的猜想推翻了,原作者回信确认
AI Has Taste并不是从「AI一定擅长数学」的信念出发。曾仔健回忆,项目最开始时,他对大模型能否真正推进数学研究并不确信。一次偶然的测试成为转折点:他把一篇论文中的猜想直接交给AI,本来只是想看看模型究竟能走多远。结果AI没有顺着论文继续「证明」,而是构造出了一个反例,直接把这个猜想推翻。
他的第一反应不是兴奋,而是不信。于是,他把反例和推导整理后写信给原论文作者核实。随后收到的回复确认:这个反例成立。对应研究后来也被收录进目前450余份数学手稿中。
「最开始我还不相信AI在数学上的力量。直到输入一篇论文的猜想,AI直接给出反例推翻;我立刻写信问原作者,对方回复确认是对的。那之后,我才真正放开手脚干。」——曾仔健
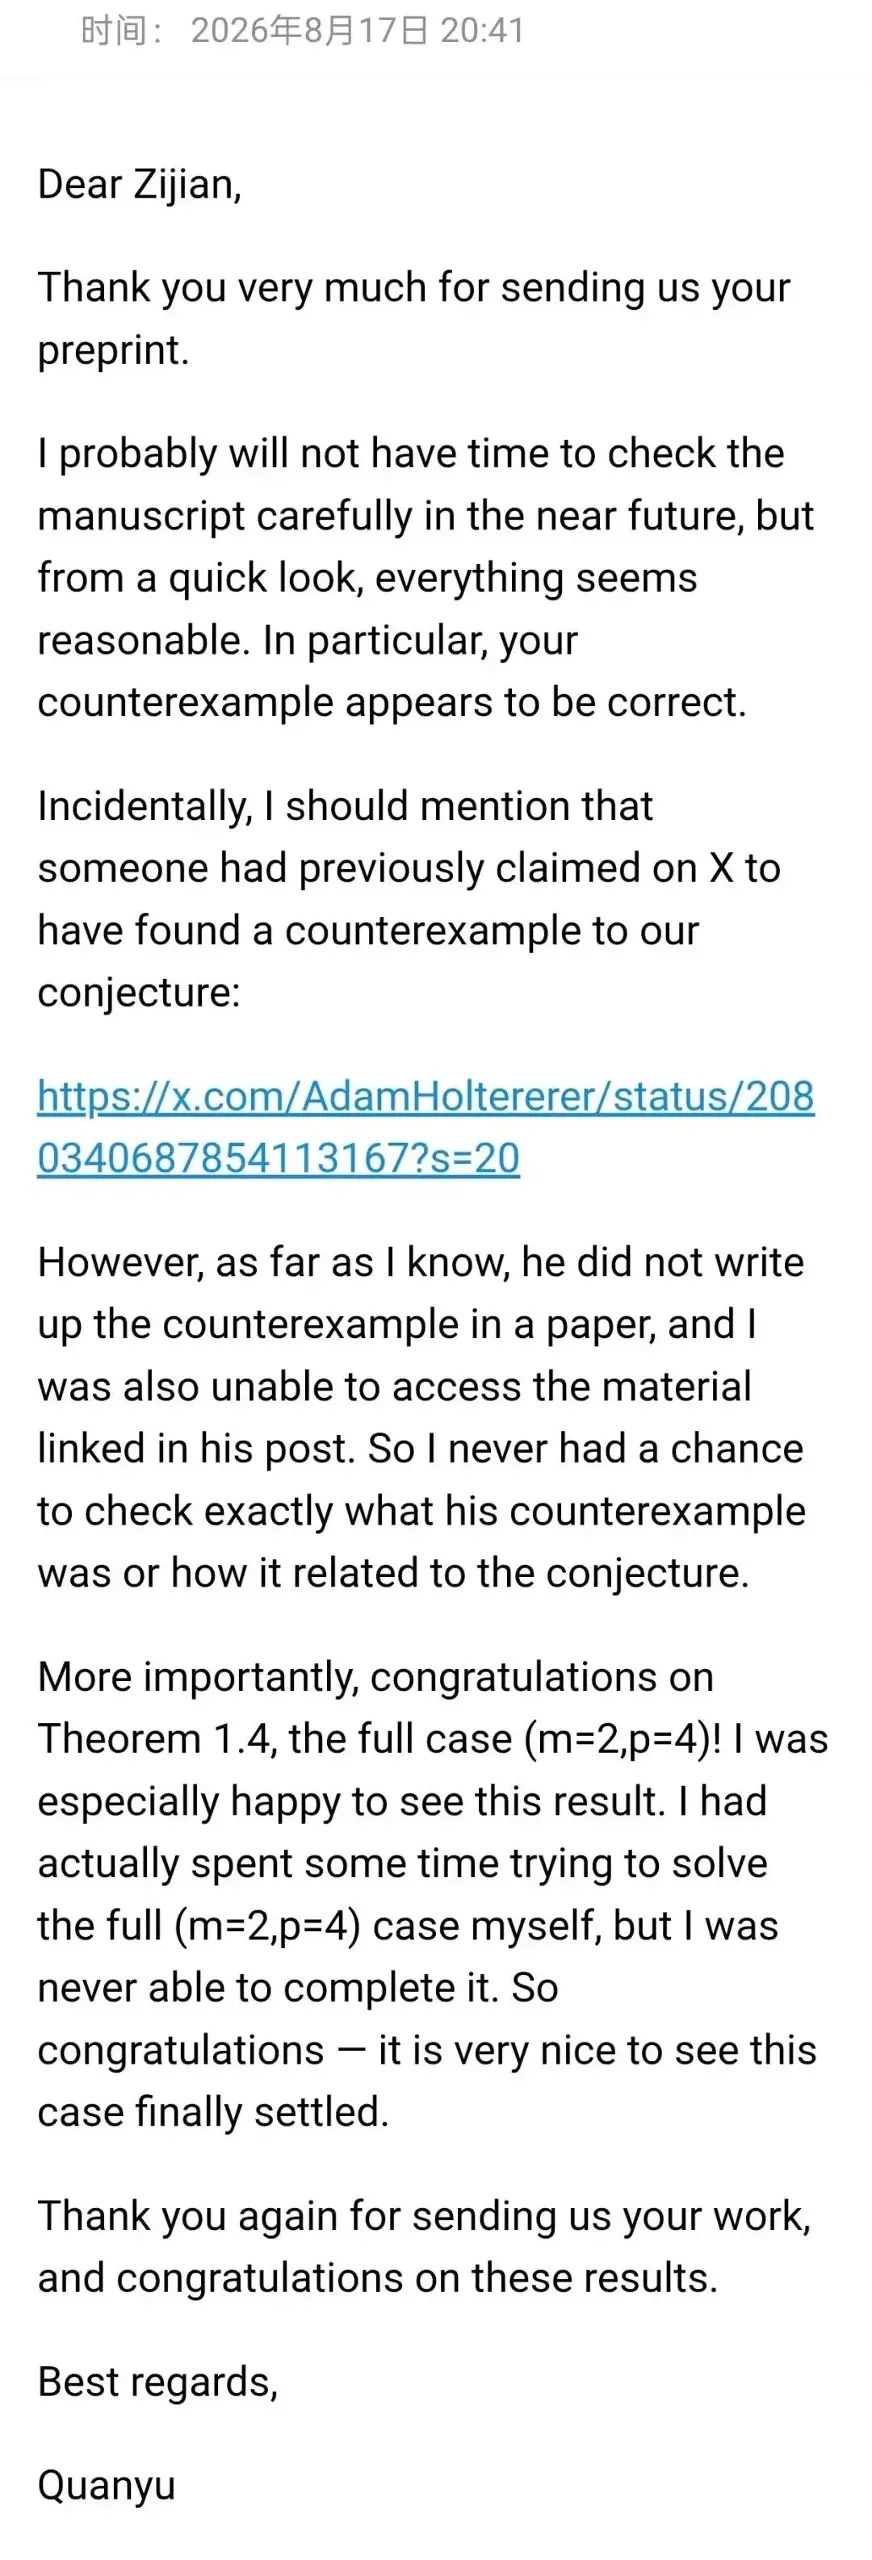
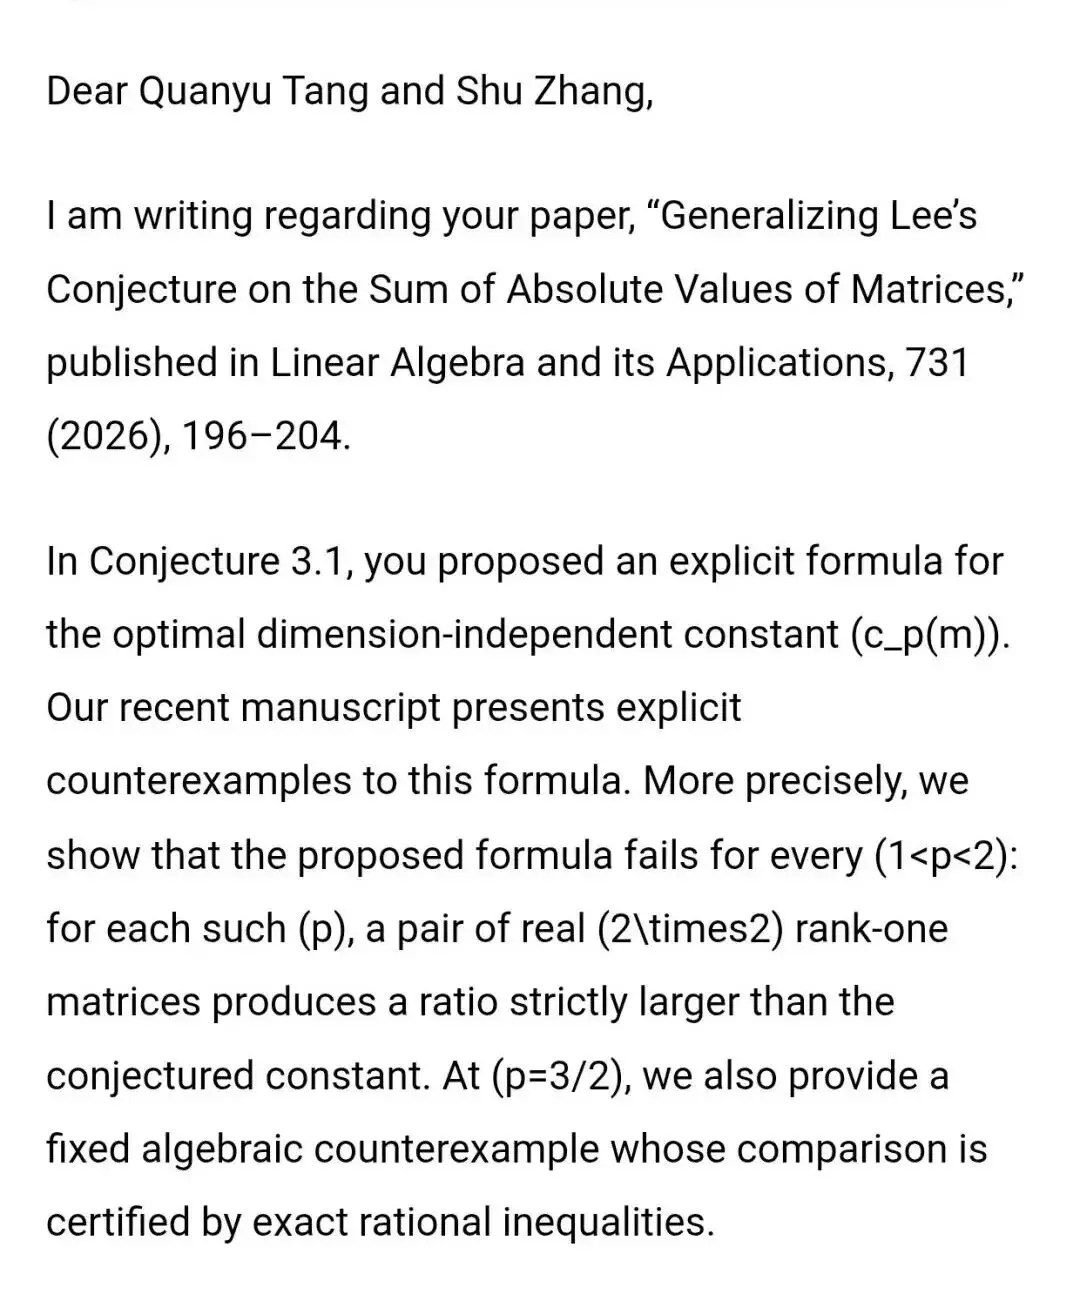
这封邮件改变的不是一个猜想,而是项目的尺度。如果AI不仅能复述已知知识、生成看起来像证明的文本,还能主动攻击论文中的新猜想,并找到一个经过原作者确认的反例,那么它就有机会真正进入「研究循环」。此后,曾仔健才开始把选题、证明、反例搜索、失败管理、独立审查和写作逐步Agent化,并让不同机器长期并行推进。
真正的变化,不是「写了多少篇」
单看数量,453份手稿已经足够吸睛。但如果只把这个项目理解成「AI批量写数学论文」,反而错过了最值得注意的部分。
项目自己反复强调:453是「research manuscripts」的数量,不等于453个原始开放问题全部被解决。产物包括完整证明、反例、局部结果、有限计算证书、结构化约化,以及提出新猜想的论文。AI内部审查也不等于外部同行评审。
真正的变化发生在研究链条上。传统AI benchmark往往从「题目已经给定」开始:人类负责选题,AI负责求解,最后得到成功或失败。AI Has Taste则把流程向前和向后都拉长——AI可以筛选候选问题、比较路线、主动找反例;一条路线失败后,还可以分析失败结构、修改命题,并把新的数学对象交给另一个独立Agent继续攻击。
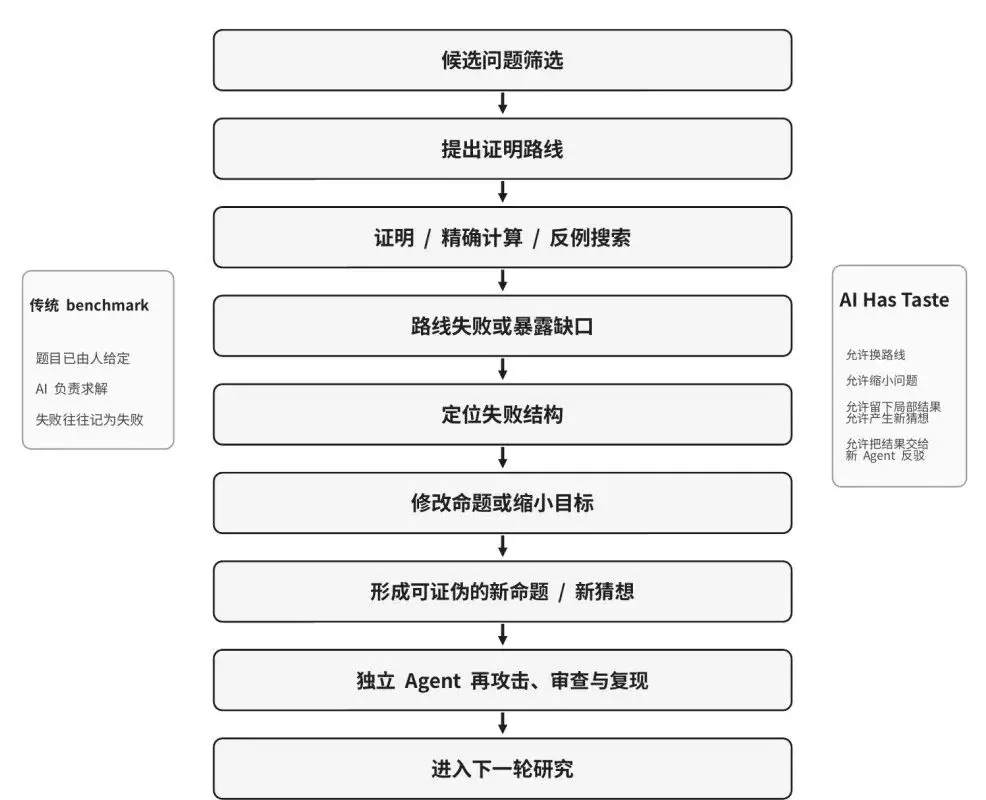
AI Has Taste的关键不是「更多Prompt」,而是把失败也变成下一轮研究输入。
选题、证明、挑错、写作Agent
这套系统并不是「一个模型在一个对话框里自问自答」。公开README把Agent角色拆成了四层:
Supervisor / Screener负责选择候选、比较附近结果并找最便宜的决定性实验;
Researcher负责证明、反例和精确计算;
Fresh-context Reviewer在新的上下文里专门攻击冻结后的命题、关键引理和证书;
Writer / Release Checker负责把最终接受的范围写清楚,并检查引用、构建和发布材料。
曾仔健进一步把工作流部署成多机协作:不同机器可以分别推进证明、搜索反例、跑精确计算、做独立审稿。共享的是冻结命题、实验记录、失败原因、代码和证据,而不是让一个Agent一边生成结果、一边给自己盖章。
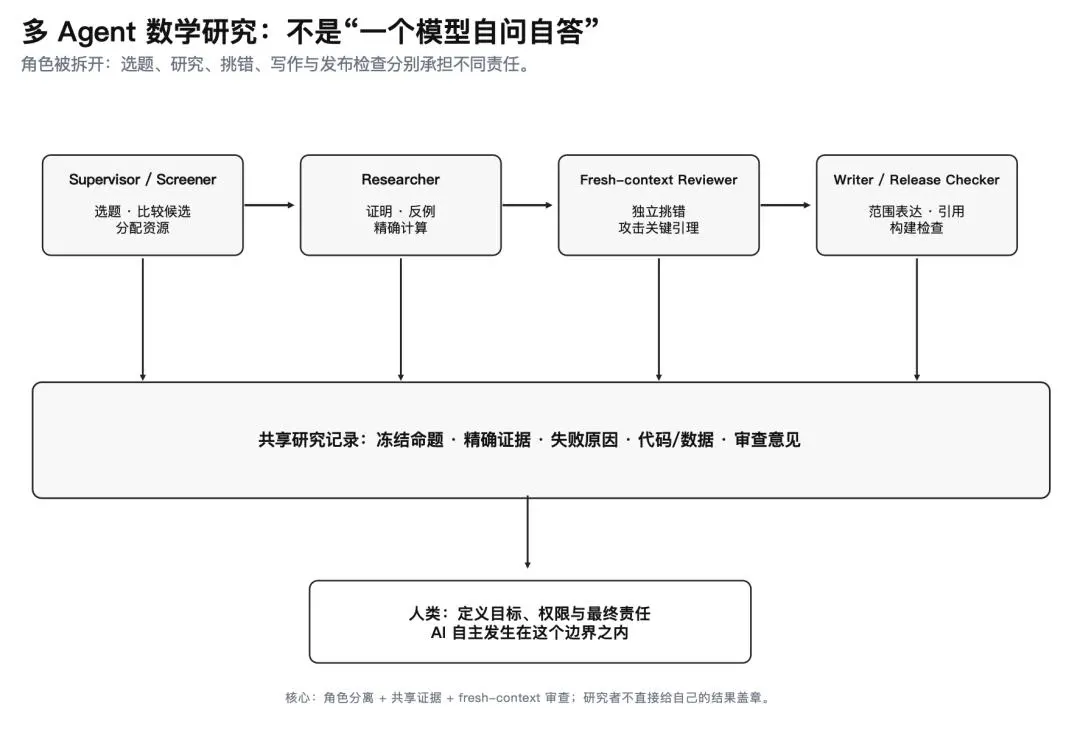
多Agent的核心设计:角色分离 + 共享证据 + fresh-context审查。
仓库里有一句话很能概括这种设计:Criticism is part of the engine, not an afterword。批评不是论文写完之后才补的一道手续,而是研究发动机的一部分。
数学家、机器人学者和自动化学者进入验证链
当研究手稿从几十份增长到数百份,另一个问题随之变得尖锐:谁来判断这些Agent产物不是系统性幻觉?
AI Has Taste内部用fresh-context Reviewer把「研究」和「挑错」拆开,但项目并没有把AI自审当作终点。
随着工作推进,曾仔健也开始邀请不同领域的真实学者参与部分结果的验证、复核和学术讨论。
据项目方介绍,参与部分工作的合作者与审核者包括:马来西亚科学院院士、马来亚大学数学科学研究所荣誉教授Ong Seng Huat;马来西亚科学院院士、马来亚大学数学科学研究所荣誉教授Kurunathan Ratnavelu;以及中国地质大学(武汉)人工智能与自动化学院熊永华教授。
这里需要区分「参与验证」与「为全部结果背书」:上述学者并非对453份手稿逐篇签字认证,而是对其中部分问题、证明、计算结果或研究方向进行过验证、审核或讨论。
对一个高度自动化的科研系统而言,这种「机器内部红队 + 人类专家抽检/复核」的组合,反而比把所有审查都交给同一套Agent更关键。
AI负责把研究速度推到极限;人类专家负责在关键节点把「看起来成立」重新拉回到「值得相信」。
失败以后,换了一个更好的问题
项目最能体现「研究品味」的案例,恰恰不是一次漂亮的成功,而是一次失败。
在 fractional Gaussian trace 问题上,系统最初尝试单调性和单侧配对路线,但精确反例不断出现。普通benchmark到这里通常只会留下一个标签:FAILED。
但这套工作流没有停。Agent继续追问:反例到底破坏了什么?失败有没有稳定结构?最后研究把注意力转向一个固定的负向缺陷,构造出十项修正结构,并提出一个新的统一有界性猜想。更关键的是,新猜想随后又被另一轮精确计算和独立审查反过来攻击。公开归档扫描到index 1004;这个统一界至今仍未证明。
这件事的意义并不是「AI又证明了一个大定理」——事实上它没有。意义在于:原问题没有解决,但失败路线被压缩成了一个更清楚、更可证伪、而且一旦成立就能重新连接原问题的新命题。研究没有在失败处终止,而是在失败里长出了下一道题。
过去:人类出题,AI答题。现在:AI答题,也开始参与决定「下一道题是什么」。
6篇AI新猜想
截至当前公开快照,仓库把6篇论文单独归入「AI-Proposed Conjectures」。这些工作横跨组合、图论、数论与分析型问题,包括A182510三个子序列的无限binary-kernel矩阵非奇异性、Young图形的CDS-colorability、最大度不超过6的无三角图分解、18-colored generalized Frobenius partitions的unary-theta同余公式、reciprocal-subsum denominators在dyadic stages上的Newton系数非负性,以及前述fractional Gaussian trace固定缺陷猜想。
真正值得关注的不是AI能不能「脑洞一个猜想」。随口猜一句并不难。难的是把猜想写成精确定义,说明它从哪里来、什么证据支持、什么反例能推翻、如果成立会导向什么结果,并把计算和源码一起留给后续复核。
这也是为什么项目把「提出猜想」看作比「生成答案」更高一级的研究动作:证明回答的是已有问题,猜想则会改变之后的研究资源投向。
453份手稿背后,是一种「Agent规模化科研」的雏形
AI Has Taste目前公开了453份research manuscripts,总计2312页;其中BigWIN2一套工作流就对应223份手稿,并为这223份工作提供配对的LaTeX/复现材料包。
这类规模最反直觉的地方,不是「AI打字快」。数学研究真正昂贵的是上下文切换:这一题需要图论,下一题要数论,再下一题可能要SAT、穷举、精确有理数运算或者矩阵计算。一个人类研究者不可能同时维持几百条完全不同的思路,但Agent系统可以把它们拆成独立任务,把失败路线、局部定理和可复现实验都保存下来。
于是,个人研究者的角色正在发生变化:不是每一步都亲自推,而更像一个PI——设定研究边界、选择问题池、决定哪些结果值得继续投入、什么时候应该停止,以及哪些结论有资格被公开。
为什么叫「AI Has Taste」?
「AI有品味」听起来很拟人化,但项目README特意给出了边界:这里的taste不是意识或主观体验,而是「通过研究决策表现出来的数学判断」。
比如:两个问题都能做,先做哪个?一条路线已经有局部进展,但边际收益越来越低,要不要停?一个反例是把命题判死刑,还是说明真正的定理应该换一种表述?一个小结果够不够独立成篇?这些决定过去通常隐含在研究者经验里,很难被标准benchmark测量。
AI Has Taste试图把这些决定留下可检查的轨迹:选了哪个问题、为什么换路线、失败留下了什么结构、下一步命题从哪里来,以及新结论如何被独立上下文再次攻击。
离「自主数学家」还有多远?
这个项目最容易被夸大的地方,同样需要说清楚。453份手稿不是453篇经过正式同行评审的期刊论文;Agent内部review不等于数学共同体的独立审稿;有限计算覆盖的范围也不能自动推广到无限情形。仓库本身明确写出了这些限制。
但如果只因为这些结果尚未全部完成外部验证,就忽略它的研究组织方式,也会错过另一个变化:AI的能力边界正从「执行一个给定任务」,移动到「参与设计下一个任务」。
数学研究真正稀缺的资源,从来不只有算力和推理长度,还包括:什么问题值得花时间,什么失败值得保留,什么时候应该换题。
当AI开始进入这些环节,「AI for Math」的竞争就不再只是「谁更会证明」,而会逐渐变成:谁拥有更好的研究闭环,谁能在大量失败中提炼出更值得继续追的方向。
One More Thing
过去的AI科研叙事,很像一个超级学生:老师出题,它负责解。
而AI Has Taste想做的,更像一个研究组:人类给出边界和价值判断,Agent去找题、试题、做错、推翻自己、留下局部结果,再提出下一题。
如果这条路线继续成立,未来基础研究里最重要的人机分工,也许会从「人类负责想,AI负责算」变成更复杂的结构:人类负责目标、价值与最终责任;AI承担大规模搜索、验证、失败管理和候选研究方向生成;形式化工具与公开证据负责让结果可复核。
AI会做题之后,下一关,可能真的是:AI会不会选题。
本文来自微信公众号“新智元”,作者:新智元,36氪经授权发布。