仅时隔一周,Anthropic 又发布了 Claude 5.5 系列的第二款模型——Claude Sonnet 5.5。
与几天前发布、定位更高的 Claude Opus 5.5 不同,Sonnet 5.5 没有把重点放在最复杂的任务上,而是更侧重日常开发、代码修复,以及文档、PPT、表格等工作,核心卖点是速度更快、成本更低。
从 Sonnet 5 到 5.5,最大的变化是“少花 Token,把事情做完”
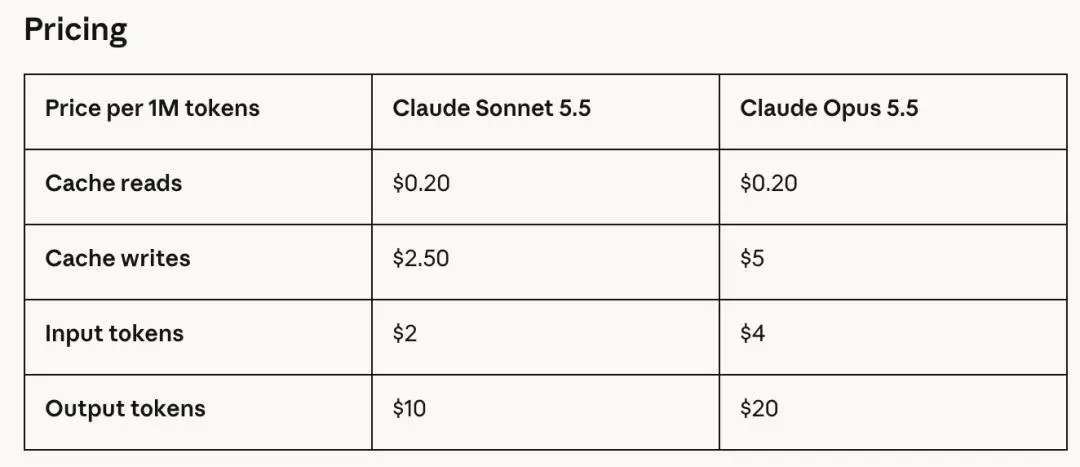
如果只看模型价格,Sonnet 5.5 和上一代的 Sonnet 5 几乎没有区别。Sonnet 5.5 的 API 输入价格仍为每百万 Token 2 美元,输出为 10 美元,缓存读取则是 0.2 美元。
真正发生变化的是完成任务所需要的计算量。
Anthropic 表示,Sonnet 5.5 在不少测试中可以用更少的 Token 和更少的工具调用完成相同工作。根据其内部测试显示,单项任务的成本最高可以比 Sonnet 5 降低 30%。
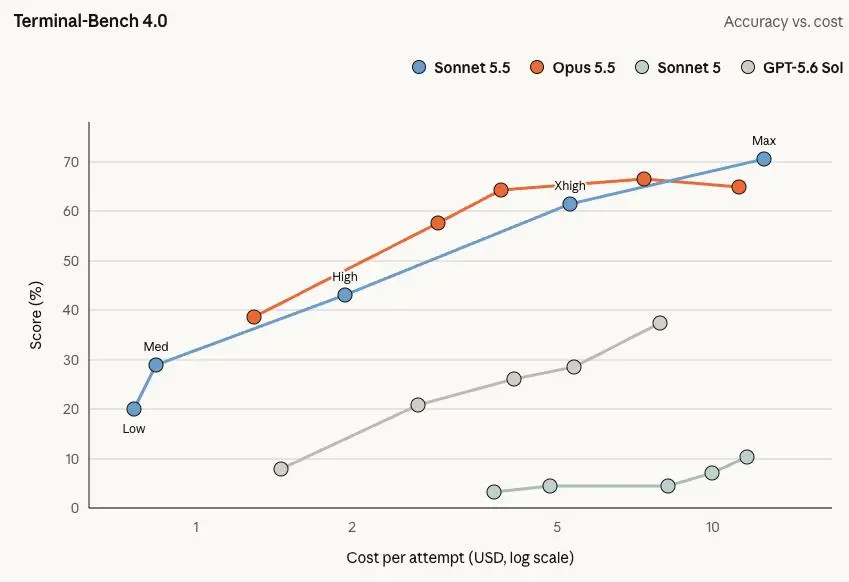
与此同时,Sonnet 5.5 的输出速度提升了超过 30%,也是目前速度最快的 Sonnet 模型。
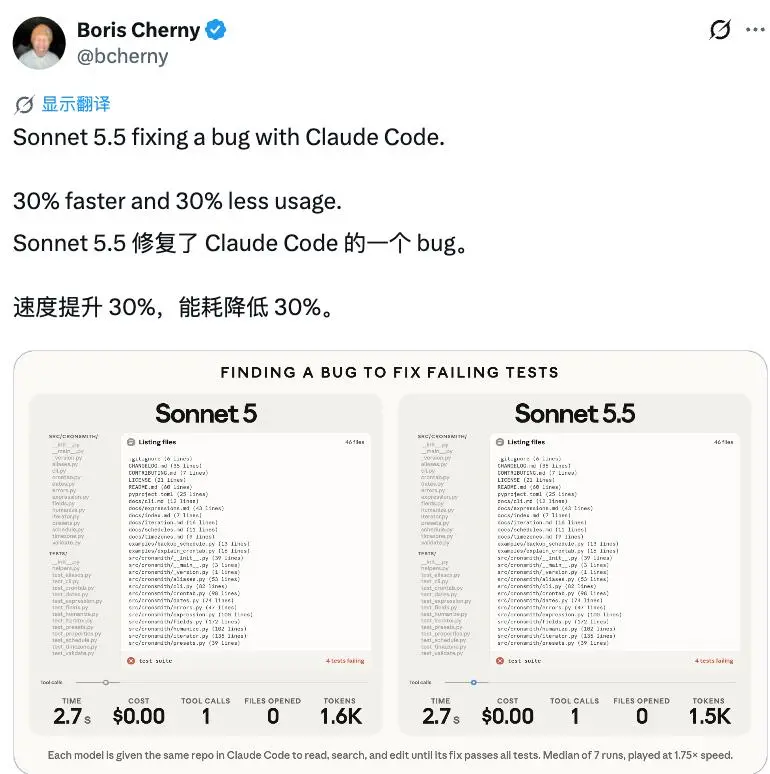
在 Coding 场景中,这一点尤其明显:早期测试者发现,新模型对代码库的理解更快,而且能够更多地批量处理工具调用,从而减少完成一个任务所需要的步骤。
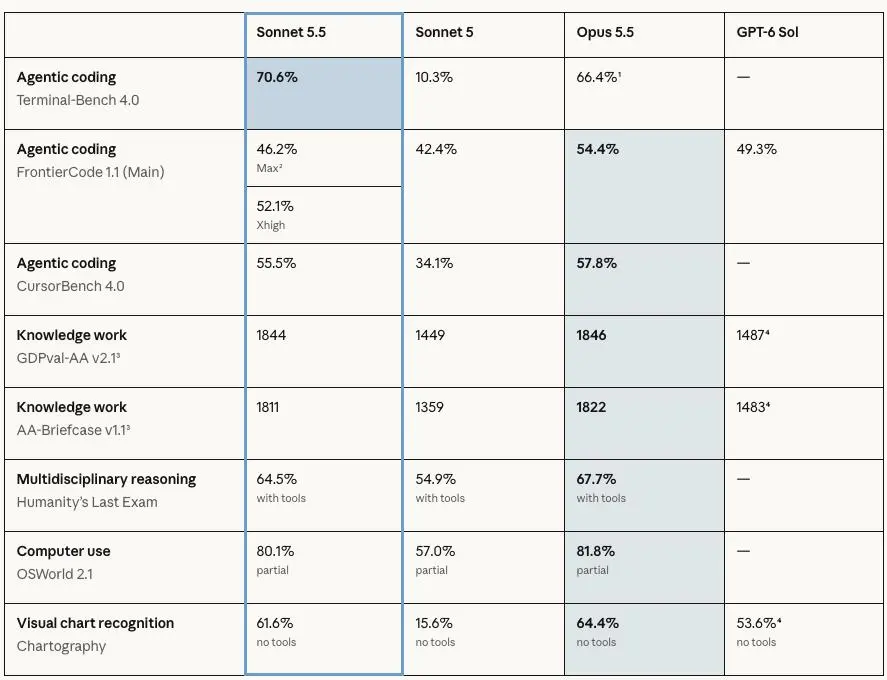
例如在智能体代码评测基准 Terminal-Bench 4.0 中,Sonnet 5.5 得分 70.6%,而 Sonnet 5 仅为 10.3%。
在 FrontierCode 1.1 的测试中,Sonnet 5.5 在最高 Max effort 下得分 46.2%,Sonnet 5 为 42.4%。
在基于真实 Cursor 代码会话任务开展测试 CursorBench 4.0 上,Sonnet 5.5 达到 55.5%,Sonnet 5 为 34.1%。
Anthropic 还表示,在 FrontierCode 高算力档位下,新模型的得分比同档位 Sonnet 5 高出 10 分,单次任务成本仅约后者的十五分之一。
从 Anthropic 公布的案例来看,Sonnet 5.5 这次更新的重点,也主要落在了代码维度。
Anthropic 提到,Sonnet 5.5 在理解代码库、使用工具以及处理多步骤任务方面都有改进。部分早期测试者也发现,与此前的模型相比,新模型对提示词的要求没那么细,面对复杂的工程任务时,不需要把每一步都交代得很具体。
Base44 做了一组比较直接的测试:让不同模型完成 118 次真实应用构建。Anthropic 公布的测试结果显示,Sonnet 5.5 最终生成的应用质量与 Opus 5 接近,但平均每个项目只需要 3.6 次迭代,Opus 5 则需要 7.7 次。
Unity 也对 Sonnet 5.5 进行了测试,任务涉及 Unity Editor 操作和编码等多个步骤。按照 Anthropic 公布的数据,Sonnet 5.5 完成了其中 90% 的任务。
和 Opus 5.5 有什么区别?
Anthropic 这次对 Claude Sonnet 5.5 系列的定位其实已经比较清楚。
Opus 5.5 是目前更高阶的模型,主要面向复杂、开放式、需要长时间保持判断能力的任务,比如大型代码库迁移、复杂研究和知识工作。
Sonnet 5.5 则更像一个速度更快、成本更低的工作型模型,适合明确的开发任务以及大量需要快速迭代的日常工作。
从价格上看,两者也正好拉开一档:Sonnet 5.5 的输入和输出价格分别是每百万 Token 2 美元和 10 美元;Opus 5.5 则是 4 美元和 20 美元。两款模型的缓存读取价格都是 0.2 美元。
有意思的是,在部分测试中,Sonnet 5.5 已经非常接近 Opus 5.5。
比如在 CursorBench 4.0 基准测试中,Sonnet 5.5 得分为 55.5%,Opus 5.5 为 57.8%;GDPval-AA v2.1 这一面向真实职业任务的测试中,两者分别为 1844 和 1846,几乎处于同一水平。
但在更复杂的开放式工作上,两者依然存在定位上的差别。Anthropic 表示,在自己的测试以及外部测试中,Opus 5.5 在需要持续判断的复杂任务上仍然明显更强。
和 GPT-6 Sol 相比,Sonnet 5.5 的重点也不太一样
除了和自家的模型做对比之外,Anthropic 也在测评列表中放入了 OpenAI GPT-6 Sol 的对比数据。
在 FrontierCode 1.1 上,Sonnet 5.5 在高算力档位下为 46.2%,GPT-6 Sol 为 49.3%。
在知识工作方面,差距则更加明显。在横跨 44 个职业、9 大行业、测试真实业务任务的 GDPval-AA v2.1 基准测试中,Sonnet 5.5 得分为 1844,GPT-6 Sol 为 1487;AA-Briefcase v1.1 中,两者分别为 1811 和 1483。
Anthropic 因此强调,Sonnet 5.5 在长周期知识工作上的表现已经明显超过 GPT-6 Sol。
安全能力也跟着往上走
Sonnet 5.5 这次还有一个变化:Anthropic 首次把 Sonnet 系列纳入了接近旗舰模型级别的网络安全防护体系。
Anthropic 的说法是,Sonnet 5.5 的网络安全能力已经接近此前的 Opus 5,因此在处理高风险网络安全任务时,会采用与 Opus 5.5 类似的安全措施;如果风险进一步升高,系统还会回退到 Sonnet 5。
生物安全方面,Sonnet 5.5 延续了 Sonnet 5 的相关防护。Anthropic 表示,这些措施不会影响常规软件开发,以及大多数生命科学领域的工作。
另外,Anthropic 还专门针对模型蒸馏增加了一层防护。由于 Sonnet 5.5 的能力相比上一代有明显提升,它也成为首个在发布时就加入相关安全分类器的 Sonnet 模型,用来阻止大规模提取模型推理能力的行为。
Claude 5.5 系列还差一款 Haiku
随着 Sonnet 5.5 上线,Claude 5.5 系列目前已经有 Opus 5.5 和 Sonnet 5.5 两款模型。
正如上文所提到的,两款模型的定位也比较明确。Opus 5.5 面向更复杂、开放性更高的任务;Sonnet 5.5 则更多承担日常开发、Coding 和知识工作。
至于面向高并发、成本敏感场景的 Haiku 5.5,目前还没有发布。Anthropic 表示,这款模型将在未来几周加入 Claude 5.5 系列。
本文来自微信公众号“CSDN”,整理:屠敏,36氪经授权发布。