文婷 发自 凹非寺
量子位 | 公众号QbitAI
别眨眼。
星空下,一辆白橙色的反重力赛车如利刃出鞘,猛地切进弯道,丝滑拐弯,在赛道上拖拽出一道道冰蓝光带,溅起金黄色的摩擦星火,直至冲线。
这可不是好莱坞特技大片,而是我用IQuest-Q1模型搓出来的沉浸式反重力竞速游戏。
它既能凭一句Prompt原地打造一款炫酷游戏,也能把十万步三体方程解成克林姆特笔下流淌的金色丝线,甚至还能从RL训练数据里揪出隐藏空格bug,让模型重回训练正轨。
△数值求解三体问题运动方程实测(10万步以内)
从Benchmark的表现来看,IQuest-Q1也交出了一份相当能打的成绩单。
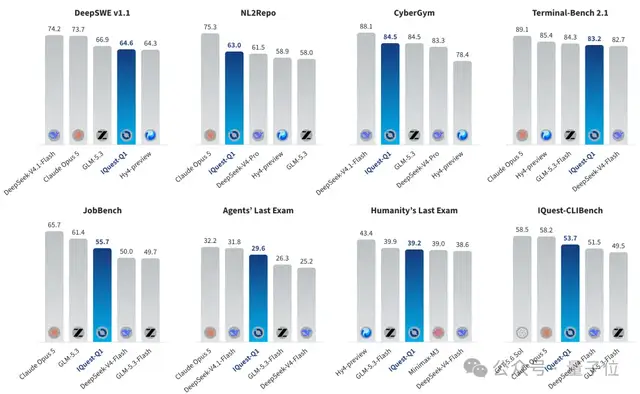
它在仓库级代码生成NL2Repo、网络安全基准CyberGym、终端Terminal-Bench 2.1、代码长程任务DeepSWE v1.1、办公场景JobBench等复杂任务评测中均表现不俗。
这么看,在同参数量模型中,它的表现是相当可圈可点的。
那么IQuest-Q1究竟是一款怎样的模型?它具体能帮我们做些什么?它诞生的研究土壤是怎样的?
看完你就懂了~
320B参数只激活15B:模型正在尝试自己“跑”完研发闭环
首先,让咱们来扒一扒IQuest-Q1的底层框架。(doge)
IQuest-Q1采用了decoder-only Transformer主干,配稀疏MoE架构,总参数约320B,激活参数约15B。
这意味着,它虽然体量看起来像个“沉睡的绿巨人”,但稀疏激活一上线,便能立马化身“精准点穴的叶问”,每一分算力都点在关键的穴位上,一点都不带浪费。
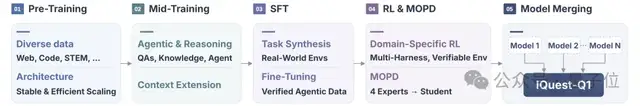
更有意思的是,我们从IQuest-Q1官宣的少量文字中察觉到,模型亲自参与了自身的研发迭代。
一旦它提出的研发方案被人类研究者们拍板通过,那么验证过的模型更新、训练资产和研究流程,便会直接流进下一轮迭代,被后续版本接着用。
而每一轮攒下来的数据流程、训练配置、评估方法和工具,也会像滚雪球一样越滚越大,直接转化为后续版本可复用的研发资产。
看着挺厉害,那么问题来了,它到干活的时候真的好使吗?
光说不练假把式,接下来,咱们直接来两道实测题,看看它到底能不能打。
从国庆宅家打怪,到揪出一个空格引发的RL训练故障
实测一:《国庆卧室保卫战》小游戏
第一题,我直接让IQuest-Q1给国庆不想出门人挤人、SAN值狂掉的我,搓个《国庆卧室保卫战》小游戏。
这个游戏妙就妙在,虽然我们明明早就决定好了不出门旅游,想在家养精蓄锐、回回血;
可一刷朋友圈,九宫格一个比一个精致,心里又忍不住冒出点遗憾和苦恼,更别提每天早上爬起来,还得纠结半天今天到底干点啥了…
我就想看看,咱们能不能顺手把这个烦恼也外包出去

:
结果相当美妙。
我只丢给它一段200字左右的提示词,外加摸鱼三分钟,它就交给我一个能在竖屏手机上直接玩的HTML游戏。
更绝的是,它还给各位“小情绪怪”配好了独一无二又精准的NPC设定和血条。
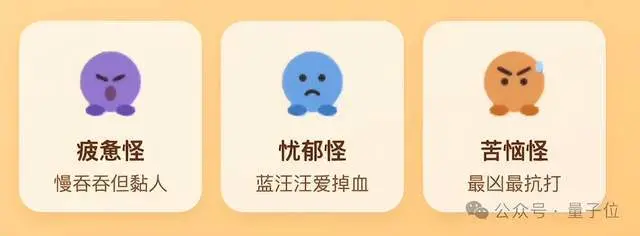
游戏里,我可以尽情把枕头当武器,指哪打哪,专治各种坏情绪。
同时,要是咱们玩嗨了,被怪兽击中要回血,那也可以直接回床上躺平,血条蹭蹭往上涨。
游戏结束后,它还会从奶茶、炸鸡、看电影、逛超市、附近散步里随机掉落一个“今日目标小彩蛋”,让咱们在不知道干啥的时候直接抄作业。
而且战果还能一键保存,发朋友圈就一句话:
这个国庆,我的松弛感满级了。
游戏玩完后,让咱们回到代码现场来测点烧脑的。
毕竟光会做游戏顶多算个气氛组,真本事还得看硬核活儿。
来,直接上强度——揪出那个让RL训练翻车的空格错误。
实测二:把RL训练中,那个导致故障的空格错误揪出来
这次就不是模拟题了,而是一个真实RL训练里常踩到的坑。
让我们来看一个官方Blog里的实测案例吧。
故事始于一条不太对劲的Reward曲线。
当时,一场RL训练中突然发现,Reward曲线没有按照预期爬升,像被什么看不见的东西卡住了一样,非常不对劲。
然后,研究人员们试着把这个问题交给IQuest-Q1,并让它基于Claude Code CLI框架分析训练日志、训练中的落盘轨迹,并从代码库中反向追查故障原因。
最终,问题被定位到RL框架接入Scaffold时的文本回传与轨迹拼接环节——推理服务在文本解码时额外插入了一个空格。
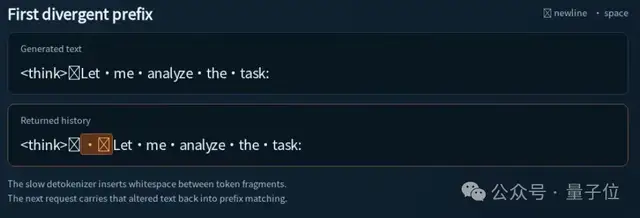
这个空格看似微不足道,却足以让模型生成文本与回传历史错位,导致前缀匹配断裂、多轮生成中断、RL训练前几轮的读代码、跑命令、改代码全白跑了,只练了最后一轮回答。
好在IQuest-Q1及时发现并修复了这个Bug,才让训练得以正常进行。
△修复后的Reward曲线,实测源自官方Blog
从创意生成到工程排错,两场实测看下来,我能明显感觉到IQuest-Q1不只是能答,更能稳稳交付经得起查验的成果。
而要理解IQuest-Q1为什么如此重视交付,咱们不妨扒一扒它的研发团队至知创新研究院IQuest Research。
把时间往前拨,我们就可以看到这个团队在短短时间内成果频出。
模型不一定追“高”,各种能力夯扎实
从今年7月底到8月,团队逐步把研究扎进模型训练的核心环节,并相继提出了MuonH优化、UBio-MolFM和稀疏权重分解等研究成果,为模型训练打下了坚实的基础。
再到本月16号,IQuest Research参与提出的ModularRSI自进化框架登上了Hugging Face日榜第二。
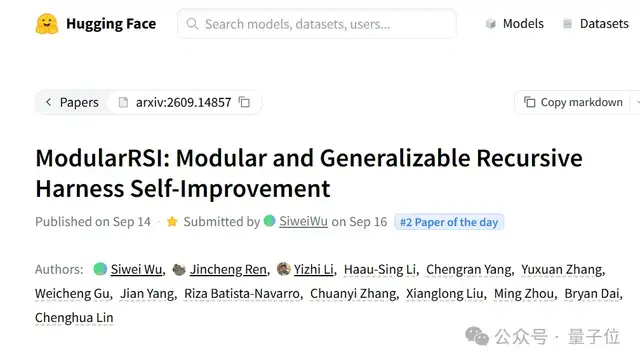
它不仅将Agent在Terminal-Bench 2.0和SWE-Bench Verified的准确率分别从47.57%、73.40%提升至52.43%、76.45%;
更能让Agent把习得的执行能力跨任务、跨模型直接复用,有效解决了自改进中信用分配与泛化的难题。
如今,IQuest-Q1的出现,似乎让一切顺理成章。
无论是实测中赛车能不能开、游戏能不能玩、训练中出现Bug能不能及时找到根因;
还是团队从堵住Agent搜索时的偷懒捷径,到让模型参与下一轮研发,IQuest Research团队追问的始终是同一件事:
AI能不能把复杂任务做对、做完,并让每一次交付都成为下一次进化的起点。
别眨眼,新故事已经开始了。
你准备好了吗?
感兴趣的小伙伴们可以点进文末链接查看更多模型信息呀:
参考链接:
[1]GitHub:
https://github.com/IQuestLab/IQuest-Q1
[2]Hugging Face:
https://huggingface.co/IQuestLab/IQuest-Q1
[3]Blog:
https://iquestlab.github.io/
一键三连「点赞」「转发」「小心心」
欢迎在评论区留下你的想法!
— 完 —
点亮星标
科技前沿进展每日见