机器人要想真正走进普通家庭,训练和评测就不能一直受制于现实世界的数据采集效率。仿真环境因此成了绕不开的一环。但现有仿真环境大多家具稀疏、陈设单调,而真实房间恰恰是又挤又乱,物体相互支撑、遮挡。
目前有两条主线可以批量的生成这种房间,一条是智能体来通过文本生成场景,一条是通过参数化的方式通过图片来生成场景。但是这两条主流路线都撞了墙。
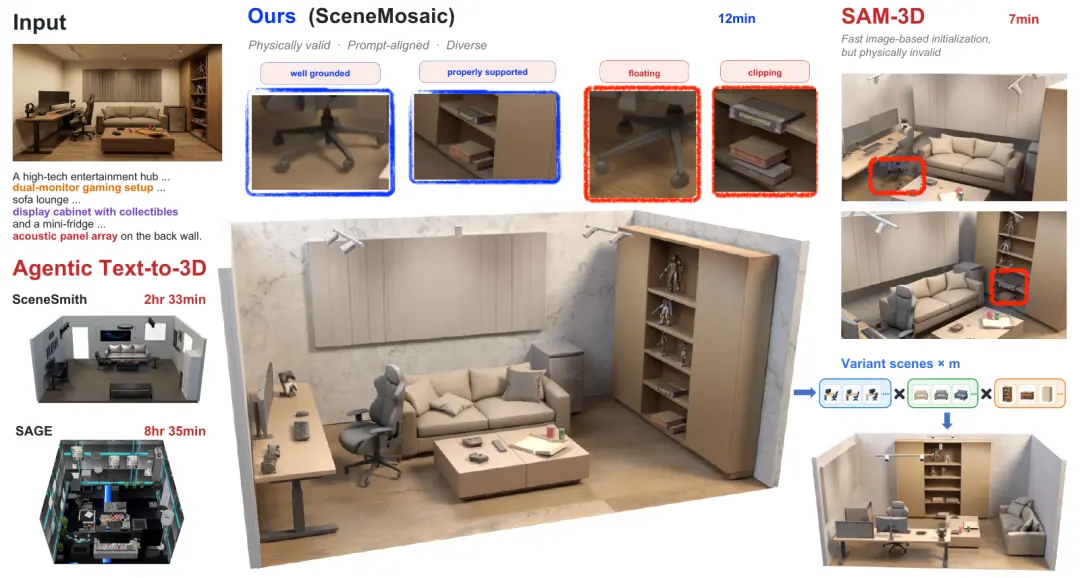
智能体文生 3D 让视觉语言模型(VLM)像室内设计师那样反复提出物体、摆放、检查、再调整,能产出高质量、物理上站得住脚的场景,代价是慢:SAGE 在实验中生成单个场景耗时 7.56 小时,比人工手动摆一遍还慢。
参数化图生 3D 把场景构建拆成"逐物体资产生成 + 6D 位姿估计",借助真实图像自带的布局先验,十几分钟就能还原整个场景,代价是不准:直接回归的位姿经常物理上站不住,经常产生椅子悬空、书本穿模进隔板的现象,碰撞率高达 20%~26%。
还有一个问题,是两条路线都没有真正解决的:不够"活"。 现有方法对一个输入只给一个确定性布局。但真实房间会随着人的活动不断变化的同时,比如椅子被拉开、书被换到别的位置,整体功能和物理关系依然却成立。仿真需要的,正是这种保持场景连贯性的结构化重排,而不是现有方法反复采样后往往只能得到的、原布局附近的小幅变化。
为此,来自香港大学等机构的戴勃老师团队提出了 SceneMosaic。Mosaic(马赛克)正是它的核心隐喻:一个场景不是固定不动的整体,而是由一块块可以独立替换的"局部拼片"拼成的。
-
论文标题:SceneMosaic: Efficient and Diverse Simulation-Ready Scene Generation via Hybrid Agentic Layout Evolution
-
作者:Xingjian Ran*, Xiaoye Mo*, Sihao Liu, Jianyu Zhang, Li Luo, Bo Dai
-
论文地址:https://arxiv.org/abs/2609.05594
-
项目主页:https://rxjfighting.github.io/SceneMosaic
-
代码链接:https://github.com/rxjfighting/SceneMosaic
SceneMosaic 是如何实现的?
SceneMosaic 的整体流程分为三个阶段:场景重建与结构化 → 智能体布局演化 → 多样性驱动的场景组合。
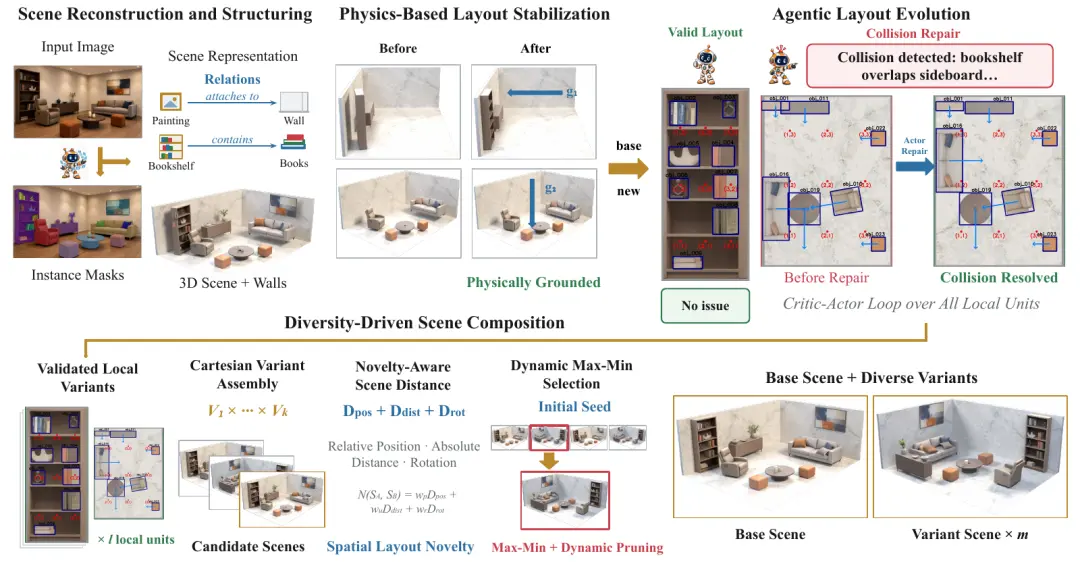
第一步:把一张图变成一棵"场景树"。 感知智能体先完成实例级物体登记, 接着SAM3 分割、SAM3D 独立重建出每个物体的网格与初始位姿;再通过一张有向无环图(DAG)调度专职子智能体,推断房间边界与物体间的 attach(支撑)和 contain(容纳)依赖,把场景组织成层级化的场景树。
真正关键的是“局部单元”的定义:一个非叶节点作为锚点,与它直接承载的子节点共同构成一个局部单元,比如书架和架上的书是一个单元,桌子和桌上的显示器、键盘是另一个。这也是 SceneMosaic 的核心:局部单元之间基本相互独立,可以各自演化。 少量跨局部单元的功能性关系(椅子应面朝书桌)被显式抽取为约束,以免约束本身反过来限制场景多样性。
第二步:先让物理定律说话,再让智能体动手。 因为对这些场景来说,最重要的特性就是要满足真实世界的物理规律。智能体介入前,先做容纳修正与重力仿真,让物体自行解开碰撞、消除悬空。重力方向依锚点而定:地面锚定用向下重力,天花板锚定用反向重力,墙面锚定则沿墙面外法线,这样吸附类物体才会自然"沉"到支撑面上。
随后进入 Critic-Actor 循环:Critic 读取正交渲染图、碰撞报告与历史记忆,输出不含坐标的定性建议("把椅子往桌子方向挪一点"),避免被不可靠的数值估计带偏;Actor 把建议翻译成引用当前布局状态的符号化位姿表达式,由沙箱求值器解析,让对齐、对称间距这类调整精确而非近似。为防止智能体陷入死锁,研究团队还做了三层防护:上下文严格限域、把 3D 位姿调整降维成正交 2D 平移与旋转、以及记录重复失败模式的显式布局记忆。
第三步:一次演化,组合出海量的候选场景。 由于局部布局在各自锚点的坐标系下表达,子单元的任意变体都能组合到父单元的任意变体之下,沿场景树取笛卡尔积即可得到庞大的候选池,一次演化的成本换来大量候选场景,这正是变体比基础场景还便宜的原因。最后,算法结合同时考虑相对位置、绝对距离和旋转差异的新颖性距离,配合动态 Max-Min 贪心搜索,从庞大的候选池中筛出一组紧凑而多样的代表场景,而这些变体场景恰恰能反映真实世界中的布局变化。
实验结果
研究团队在 SceneEval-100 上进行评测,核验物体位置(POS)与朝向(ROT)的语义合理性,用可导航性(NAV)、碰撞率(COL)、出界率(OOB)衡量物理有效性。

SceneMosaic 在语义质量上与最强基线持平(POS 84.3 对 83.5,甚至略胜),大幅减少了物理违规,同时相比 SceneSmith 提速 24 倍。生成一个变体场景只需要 0.03 小时,比所有基线方法都快。
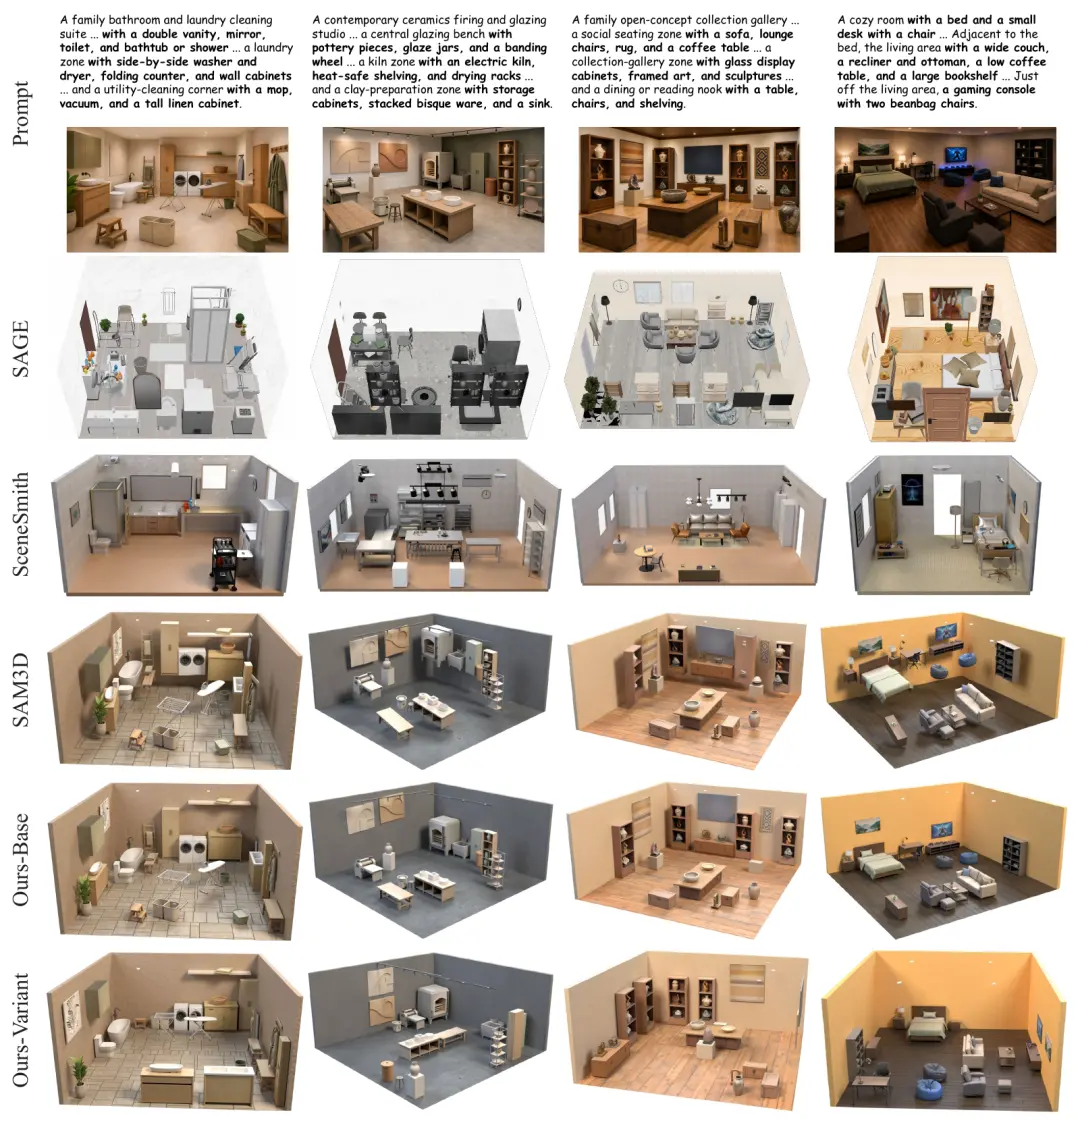
定性对比更直观:SAM3D 借助视觉先验初始化很快,但物体位姿经常不符合物理常识。SceneMosaic 则先保留图像中的整体空间结构,再通过布局演化改善物体关系,让椅子脚踏实地、书本被隔板正确支撑。而在基线结果中,悬空和穿模依然很常见。

消融实验说明,这些设计并不是可有可无:去掉图像先验,耗时从 0.14 小时涨到 1.25 小时;移除物理处理,碰撞率从 0.0 飙升至 18.9%;改用透视 3D 表示,推理时间翻倍且质量下降。最关键的是,局部分解一旦改为全局演化,变体生成几乎失去了原本的效率优势——生成一个变体的时间是 SceneMosaic 的 21 倍。
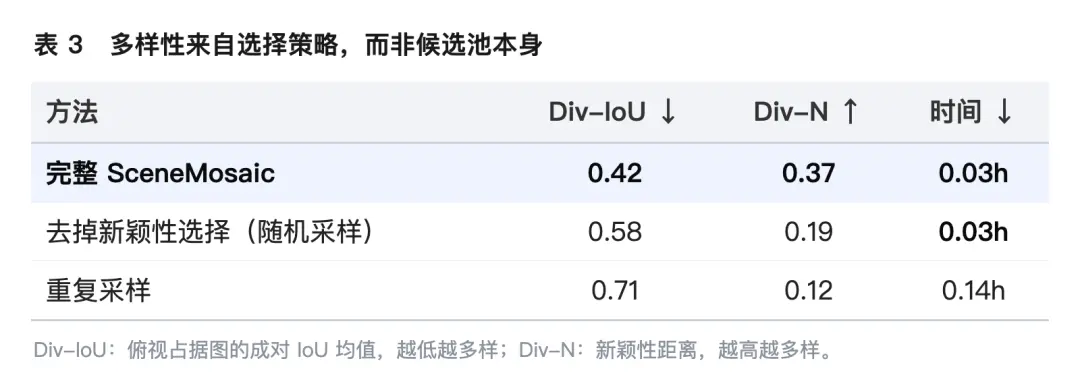
多样性方面,把贪心搜索换成随机采样后,选出的布局明显更相似,而重复采样最不多样也最耗时。
那么,这种多样性会不会只是把原来的布局打乱了?研究团队用高斯扰动做了对照:
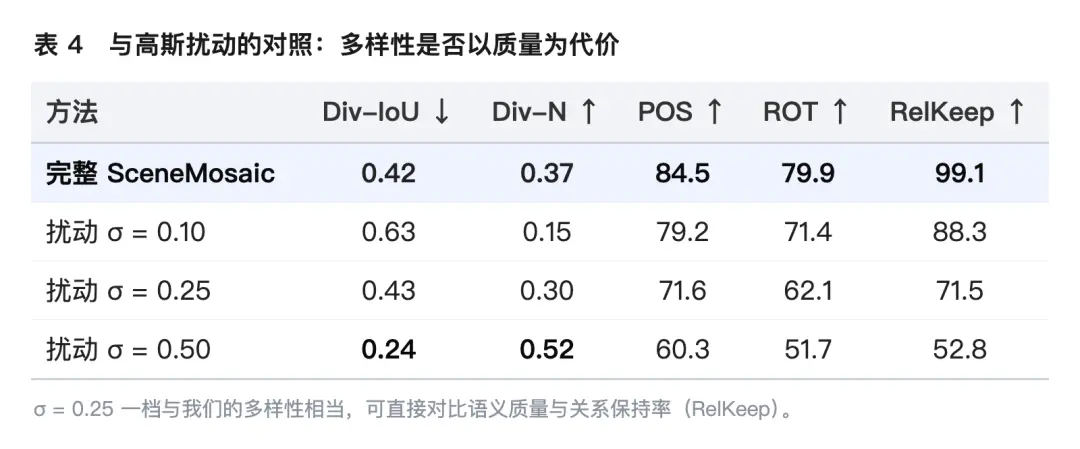
扰动强度增加,布局之间的差异确实变大了,但语义质量和结构连贯性也随之明显下降。在与 SceneMosaic 多样性相当的 σ = 0.25 一档, SceneMosaic 的语义位置分是 84.5 对 71.6,关系保持率 99.1% 对 71.5%。这种多样性并非以牺牲布局有效性为代价。
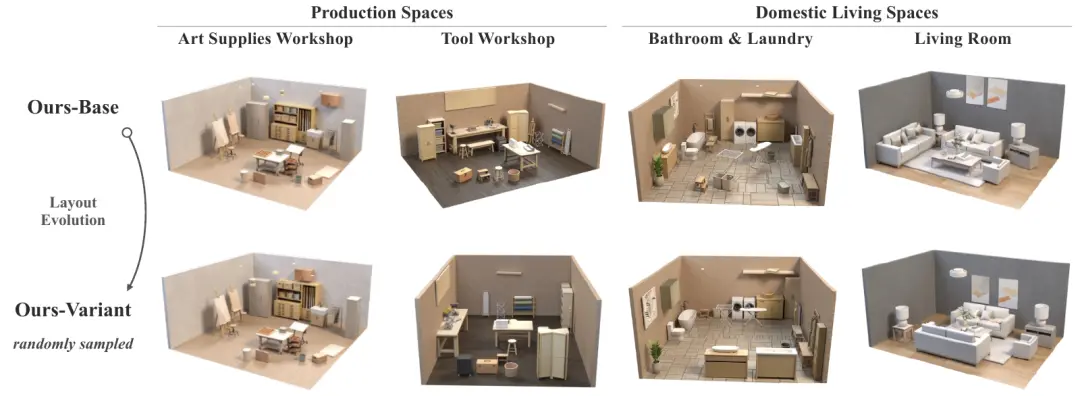
48 名参与者的用户研究也给出了相同结论:SceneMosaic 在语义合理性(4.33)与物理合理性(4.47)上均获最高分,且标准差最低。

局限性与未来展望
SceneMosaic 依赖单张图像初始化,因此也继承了图生 3D 的天然限制:一张图像通常只能刻画一个房间,因此它目前还停留在房间尺度,还不能直接扩展到完整住宅。把房间级结果组合成连贯的住宅尺度环境,是一个很有价值的方向。
研究团队认为,"图像先验负责快、智能体演化负责准、局部分解负责多样"这套分工,对于大规模仿真环境的构建是一条值得继续走下去的路。SceneMosaic 已经开源,欢迎大家讨论和改进。

© THE END
转载请联系本公众号获得授权
投稿或寻求报道:liyazhou@jiqizhixin.com