新智元报道
新智元报道

大模型的推理能力越来越强,但到了真正需要「看图推理」的任务上,一个核心问题依然没有被彻底解决:
模型究竟是在「看着图推理」,还是把图看了一遍之后,主要靠文本链条继续猜?
针对这一问题,来自美国埃默里大学的研究团队提出了Decompose, Look, and Reason(DLR),并被EMNLP 2026 Main Conference接收。
论文地址: https://arxiv.org/pdf/2604.07518
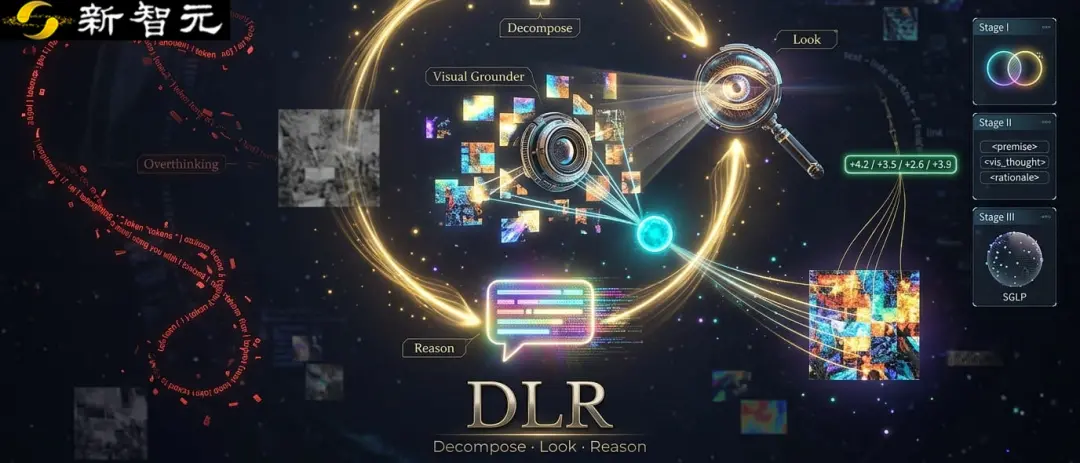
DLR目标是缓解多模态Chain-of-Thought中「文本推理不断延长,但视觉证据逐步弱化」的问题。它的核心思想很直观:让视觉语言模型像人一样,在复杂问题中不断执行:
Decompose → Look → Reason
也就是:先拆解问题,再针对当前子问题「看」图,最后基于刚刚获得的视觉证据进行推理。
视觉语言模型(VLM)已经能够在视觉问答、数学图表理解和跨学科多模态任务中执行较长的推理链。
然而,与纯文本推理不同,多模态推理需要在离散语言序列与高维连续视觉表示之间反复交互。
一个关键问题是:当模型进入较长的语言CoT之后,后续推理是否仍然由充分、准确的视觉证据支撑。
已有方法大致沿三条路线发展。第一类text-only multimodal CoT将视觉信息压缩为文本描述,然后主要在语言空间中继续推理;这会产生不可避免的信息损失。
第二类interleaved CoT或「thinking with images」方法在中间步骤引入图像patch、bounding box、crop、zoom或外部视觉工具,能够增强显式grounding,但也引入额外工具调用成本,并受预定义操作空间限制。
第三类latent visual reasoning将中间视觉信息投影到连续嵌入空间,但现有方法常依赖局部ROI / patch,或仅在整个reasoning chain中注入一次视觉latent。
论文指出,局部ROI并不总能与「当前推理步骤真正需要的语义证据」一致:它可能包含过多无关上下文,也可能无法覆盖跨区域关系、全局布局或抽象视觉概念。与此同时,多步推理往往要求模型在不同阶段检查不同证据,因此单次视觉注入难以支撑完整的推理轨迹。
DLR将一个复杂视觉推理过程表示为由多个中间步骤组成的轨迹。第t步包含文本premise p⁽ᵗ⁾、连续视觉latent z⁽ᵗ⁾和基于该视觉证据生成的rationale r⁽ᵗ⁾,最终得到答案a。其核心是把「提出需要验证的问题」和「从图像中提取对应证据」显式耦合起来。
Decompose:动态生成需要视觉验证的premise:VLM根据当前推理上下文决定下一步需要确认的视觉事实,并生成一个明确的premise或sub-question。该步骤回答的是「接下来需要验证什么」。
Look:提取premise-conditioned visual latents:visual grounder以premise结束位置的hidden state为条件,对图像特征执行cross-attention,输出一组连续视觉latent。与固定ROI或单一patch不同,这些latent可以编码局部细节、跨区域关系以及非局部视觉语义。
Reason:基于视觉latent生成grounded rationale:VLM在注入视觉latent后生成当前步骤的rationale,并据此继续下一轮decomposition,直至得到最终答案。由此,视觉证据不再只是推理开始时的一次性输入,而成为整个reasoning trajectory中可动态更新的条件。
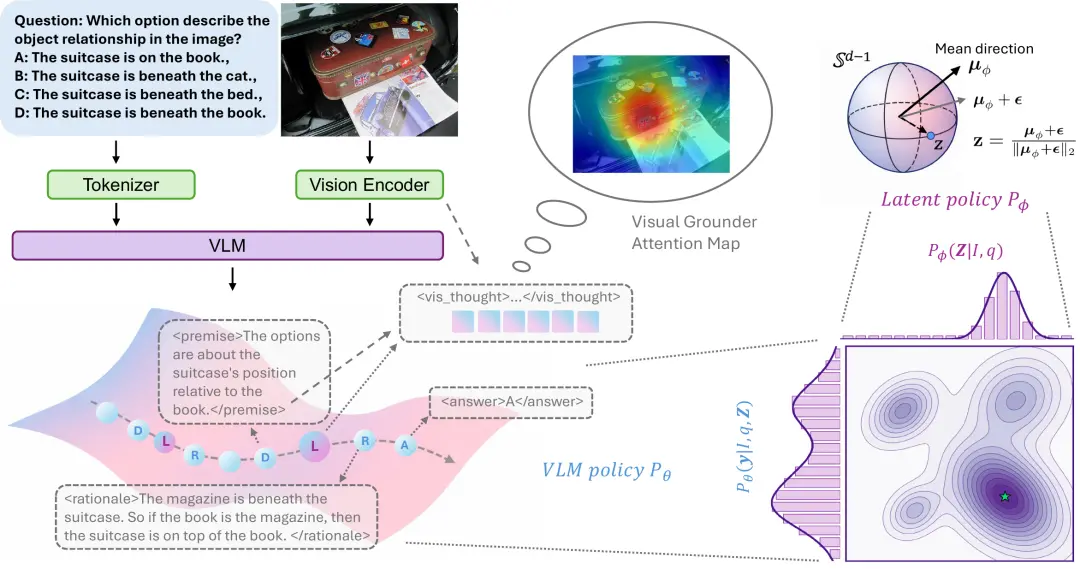
图1:DLR总体框架。VLM文本策略负责生成premise与rationale;visual grounder根据premise提取连续视觉latent。训练阶段联合优化文本策略Pθ与视觉latent策略Pϕ。
从概率建模角度,DLR将文本生成策略Pθ与视觉latent策略Pϕ共同纳入推理过程。
更准确的textual decomposition可以为visual grounder提供更明确的条件,而更具任务相关性的视觉latent又能够反过来改善后续rationale,因此二者形成相互依赖的联合优化过程。
第一阶段冻结预训练VLM主干,训练轻量visual grounder。模型使用一组learnable latent queries对图像特征进行条件化提取,并通过双向InfoNCE对比学习,使聚合后的visual latent与目标答案的文本语义对齐。
该阶段的作用是建立稳定的跨模态初始化,使latent能够在给定文本条件时提取对应视觉语义。
第二阶段通过监督微调学习结构化的DLR轨迹。训练样本显式包含<premise>、<vis_thought>、<rationale>与<answer>等结构。
VLM学习何时提出新的视觉premise;visual grounder则根据premise hidden state生成连续latent,并通过后续rationale与答案的语言建模损失获得梯度。
SFT能够使模型内化DLR格式,但latent提取仍主要是deterministic feature extraction,缺乏显式探索。
第三阶段进一步将强化学习从离散文本token扩展到连续视觉latent。
标准GRPO可以直接优化文本token的离散策略,但对连续latent缺少天然的token-level probability distribution。DLR因此构造了一个可显式计算策略密度与importance ratio的视觉latent policy,并与文本policy联合优化。
视觉-语言表示通常采用cosine similarity衡量语义相似性,因此语义信息往往更多编码在向量方向而非模长中。论文据此将视觉表示视为近似位于unit hypersphere上的语义流形,并提出Spherical Gaussian Latent Policy (SGLP)。
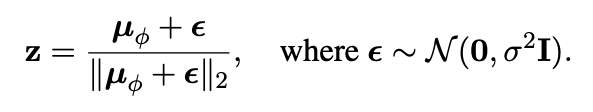
visual grounder首先预测L2-normalized mean direction μϕ,在其附近加入高斯扰动,再将采样结果重新投影到unit hypersphere。这样可以将探索重点放在语义方向上,从而减少将语义变化与magnitude variation混合在一起的风险。
在强化学习阶段,DLR基于Dr. GRPO的group-relative advantage,同时优化文本策略与latent policy。
实验以Qwen3-VL-8B-Thinking为backbone,评测覆盖四个以视觉为中心的benchmark:V* Bench(细粒度属性与空间关系)、MathVista(视觉数学推理)、MMMU-Pro(跨学科多模态推理)和MMStar(综合多模态能力)。
为保证比较公平,ICoT、LVR与PixelReasoner等开源方法均适配到同一Qwen3-VL-8B-Thinking backbone。
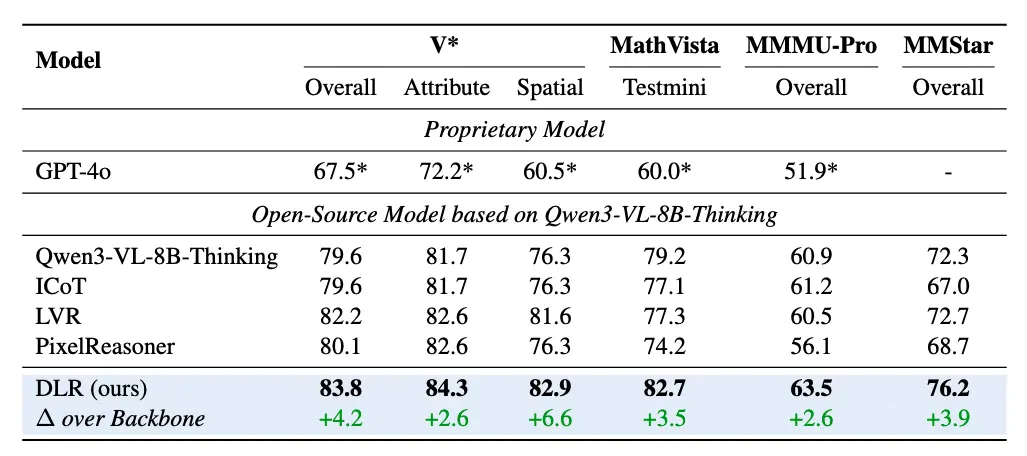
表1:测评主要结果。
DLR在V*、MathVista、MMMU-Pro和MMStar上分别达到83.8、82.7、63.5和76.2。
相较Qwen3-VL-8B-Thinkingbackbone,对应提升为+4.2、+3.5、+2.6和+3.9个百分点。
在MathVista上,DLR相比LVR从77.3提升至82.7。论文将这一优势归因于多步premise-conditioned visual grounding:数学视觉推理往往需要模型反复检查图表、几何关系或局部细节,并在多步过程中累积证据,而不是依赖一次性latent表示。
整体结果表明,在相同backbone下,将视觉grounding显式嵌入多步reasoning trajectory能够稳定改善多类视觉推理任务。
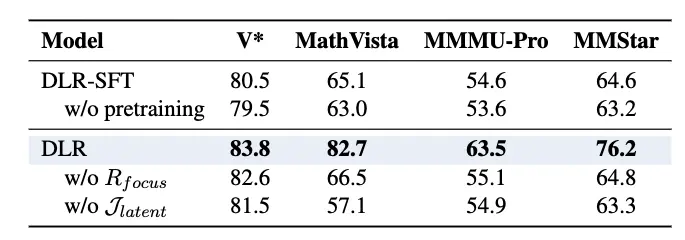
表2:DLR主要组件消融。
消融结果显示,pretraining、focus reward与latent policy optimization均对最终性能有贡献。其中最显著的是latent policy objective:移除Jlatent后,MathVista从82.7降至57.1,V*也从83.8降至81.5。
该结果说明,仅依赖SFT学习deterministic visual representation难以充分发挥隐空间推理能力,显式的continuous latent exploration是该框架的重要组成部分。
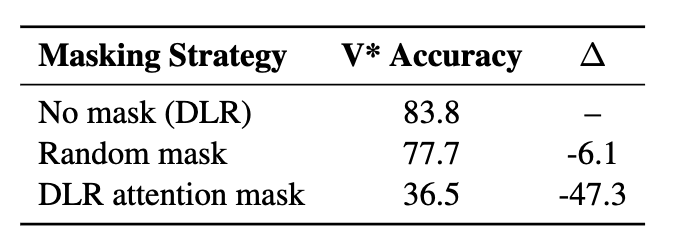
表3:V*Bench上的quantitative faithfulness analysis。
随机遮挡同等数量区域时,V*准确率从83.8降至77.7;遮挡DLR attention最高的区域时,准确率降至36.5,即下降47.3个百分点。
该干预结果为visual grounder所识别区域与模型预测之间的功能相关性提供了定量证据,而不仅是「看起来合理」的可视化。
论文中的案例进一步说明了weak visual grounding可能导致的overthinking。
在一个图形规律题中,Qwen3-VL-8B-Thinking baseline反复尝试计数绿色扇区、检查角度关系和行列规律,并多次修改假设;
最终生成15,177 tokens后仍给出错误答案。
DLR则先明确需要验证「绿色扇区的相对位置规律」,再根据该premise获取视觉latent,并据此生成grounded rationale。
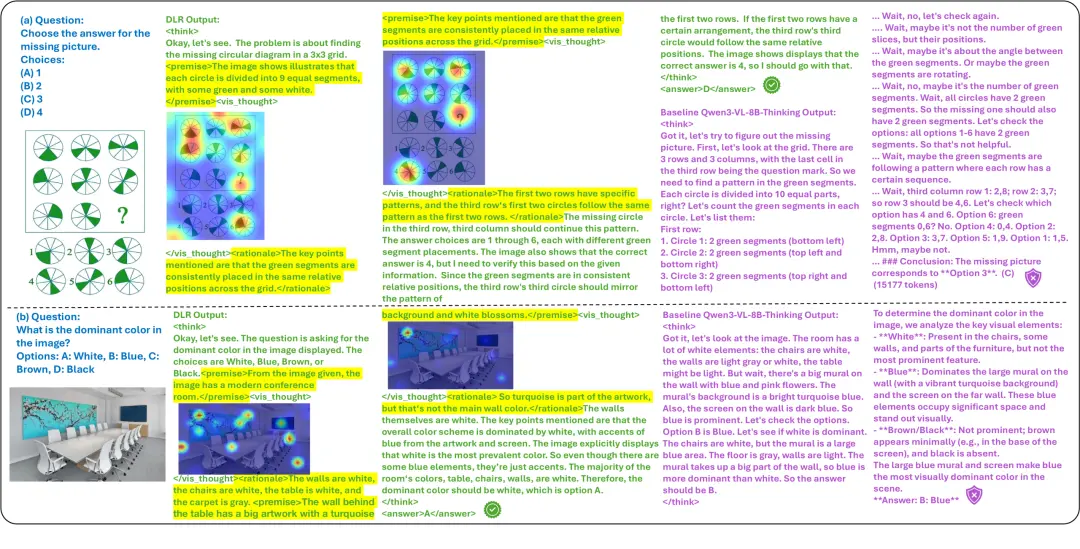
图2:DLR与Qwen3-VL-8B-Thinkingbackbone的案例比较。上例展示图形规律推理,下例展示主色判断;热力图对应premise-conditioned visual grounding。
另一个主要颜色判断案例中,baseline受到大面积蓝色壁画的显著性影响,将房间主色判断为蓝色;DLR的分步grounding则综合墙壁、桌椅与整体布局,最终判断白色为主色。论文展示的cross-attention heat map会随premise改变关注区域,这与DLR「每一步重新获取任务相关视觉证据」的设计一致。
-
提出Decompose–Look–Reason多步视觉推理框架,在每一步动态生成premise,并提取对应的premise-conditioned visual latents。
-
提出三阶段训练流程,将visual grounding的跨模态对齐预训练、结构化SFT与强化学习结合起来。
-
提出Spherical Gaussian Latent Policy,使强化学习能够直接优化连续视觉latent,并与文本策略联合更新。
-
在V*、MathVista、MMMU-Pro与MMStar上进行系统评测,并通过消融、case study与faithfulness analysis分析各组件作用。
参考资料:
https://arxiv.org/pdf/2604.07518
编辑:LRST